Abstract
Video LLM은 단일 frame 안의 captioning이나 recognition은 잘하지만 temporal reasoning에는 자주 실패한다. 연속 동작, 방향, 속도, 사건 순서, object가 시간에 따라 변하는 방식 같은 것들이다. 기존 해법은 video encoder나 LLM의 순서 민감도를 개선하며, 모두 training data와 compute가 필요하다. 한 architecture에서 얻은 발견이 다른 architecture로 항상 옮겨가는 것도 아니다.
이 논문은 model 내부 대신 model의 행동을 본다. Video LLM이 temporal 질문을 틀릴 때는 language prior(text만으로 짐작되는 답)나 “image” prior(정지된 frame 하나로 짐작되는 답)를 따르는 경우가 많다. 방법은 이를 뒤집어 이용한다. Temporal cue는 지우되 오해를 부르는 static content는 남긴, temporally distorted video 사본을 만들고, 그 사본에 대한 model의 답을 contrastive decoding의 negative로 쓴다. 논문은 방법에 이름을 붙이지 않는다. Distribution을 \(p_{\text{vtd}}\)로 쓰고 distortion 단계를 Video Temporal Distortion이라 부르므로, 이 리뷰에서는 VTD라 부른다. 학습은 필요 없다.
Motivation
저자들은 먼저 language prior가 video에서도 문제가 되는지 확인한다. LLaVA-Video-7B-Qwen2와 Video-LLaVA가 틀린 TempCompass 질문 200개를 골라, 같은 질문을 video 없이 LLM backbone에 묻는다. 틀린 예측 중 46.7%(LLaVA-Video)와 38.9%(Video-LLaVA)가 blind LLM의 답과 일치하며, 이는 우연보다 훨씬 높다.
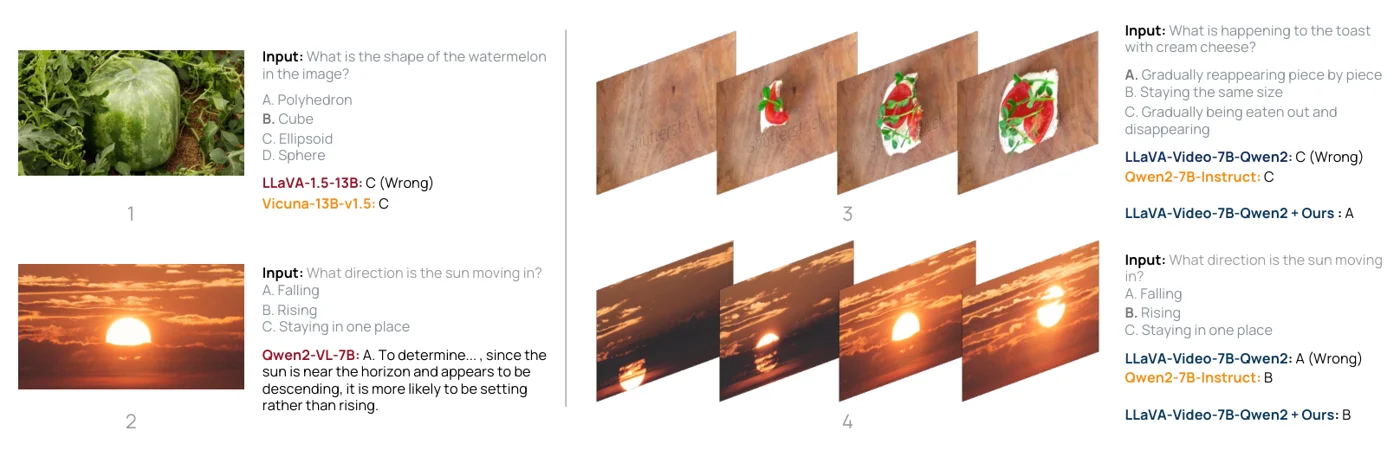 (1) LLaVA-1.5는 정육면체 수박을 ellipsoid라고 답하는데, 이는 image 없이 LLM이 내는 답과 같다. (3) LLaVA-Video는 toast가 먹히고 있다고 답하며 blind LLM과 일치하지만, video는 그 반대를 보여준다. (4) 떠오르는 해에 대해 blind LLM은 맞게(“Rising”) 답하지만 LLaVA-Video는 “Falling”이라 답한다. (2) 가운데 frame 하나를 Qwen2-VL에 넣으면 일몰처럼 보여 역시 “Falling”이 나오며, 이것이 “image” prior를 드러낸다. VTD는 (3)과 (4)를 모두 바로잡는다. 논문 Figure.
새로운 부분은 (4)이다. Language prior는 맞았는데도, 정지된 frame이 일몰처럼 보여서 model이 틀렸다. 저자들은 이것을 “image” prior라 부른다. Temporal 정보는 없지만 temporal dynamics에 대해 model을 오도하는 static visual feature이다. 따라서 contrastive decoding의 좋은 negative는 이런 오해를 부르는 static cue는 남기고 temporal cue만 지워야 한다. Video 전체를 masking하는 것으로는 부족하다. (4)에서 video 없는 model은 정답을 내며, 정답을 negative로 쓰면 출력을 정답에서 멀어지게 만든다.
단순한 distortion(feature noise, frame shuffling, frame dropping)도 LLaVA-Video-7B로 EventHallusion에서 도움은 되지만, distortion이 앞쪽 절반 frame에 걸리느냐 뒤쪽 절반에 걸리느냐에 따라 이득이 달라진다. 이 불안정성이 adaptive distortion의 동기이다.
Method
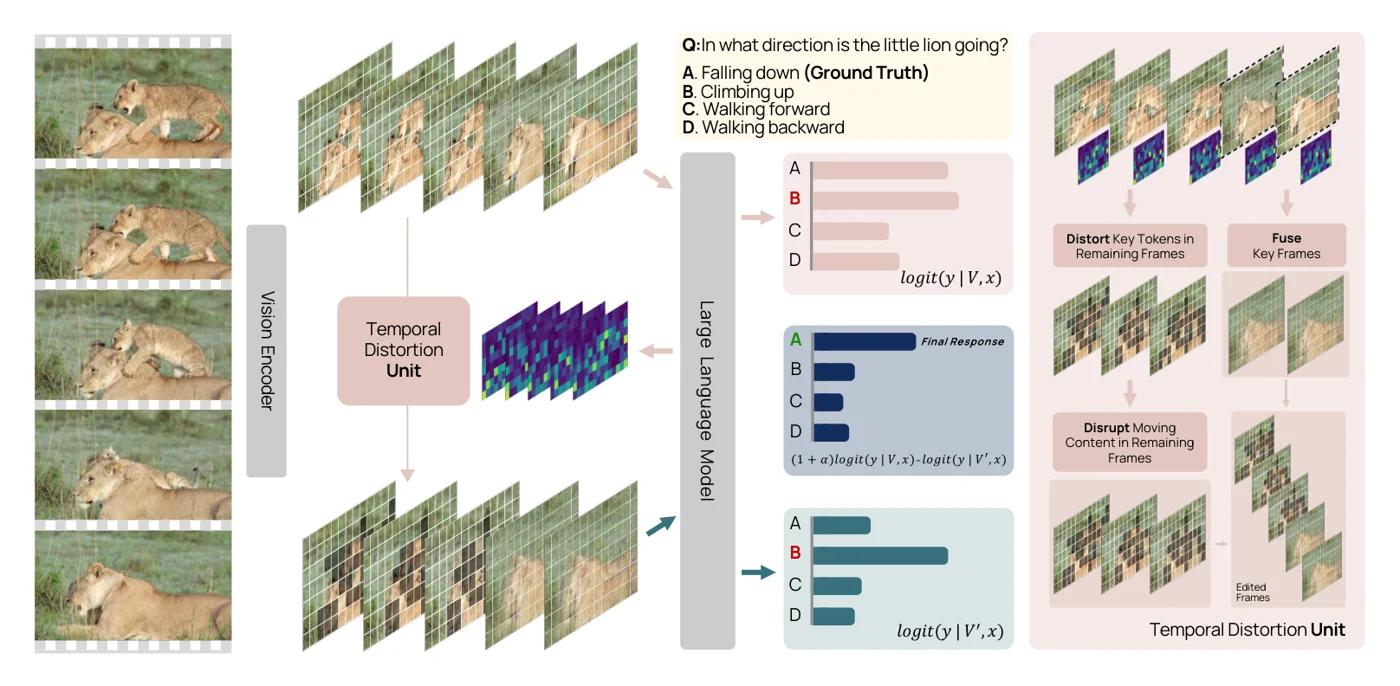 왼쪽: 원본 video embedding \(V\)를 LLM에 넣어 \(\mathrm{logit}(y \mid V, x)\)를 얻는다. 이 pass의 attention map이 Temporal Distortion Unit을 안내하여 \(V'\)를 만든다. 오답 “B”(climbing up)가 \(V'\)에서 높은 점수를 받으므로, contrast 후에는 정답 “A”(falling down)가 남는다. 오른쪽: Temporal Distortion Unit은 key frame을 fuse하고, 나머지 frame의 key token을 distort하고, 움직이는 content를 흐트러뜨린다. 논문 Figure.
Contrastive decoding
Decoding 규칙은 VCD 형태를 video에 적용한 것이다.
\[p_{\text{vtd}}(y \mid V, V', x) = \mathrm{softmax}\big[(1+\alpha)\,\mathrm{logit}_\theta(y \mid V, x) - \alpha\,\mathrm{logit}_\theta(y \mid V', x)\big]\]여기에 Li et al.의 adaptive plausibility constraint를 더해, 최고 확률의 \(\beta\)배 이상인 token만 남긴다. 기본값은 \(\alpha = 1\), \(\beta = 0.2\)이다. 핵심은 모두 \(V'\)를 어떻게 만드느냐에 있다. 저자들은 세 기준을 든다. Temporal 정보를 지울 것, 오해를 부를 만한 prior(두드러진 static feature)를 남길 것, 무작위가 아니라 video마다 adaptive하게 distort할 것.
Token과 frame importance
첫 번째 forward pass에서 각 layer마다 마지막 query 위치가 각 visual token에 주는 attention을 head 평균하여 \(S_l\)을 얻는다. 마지막 layer에만 의존하지 않도록 layer를 따라 momentum으로 누적한다.
\[\tilde S_l = w_m \tilde S_{l-1} + (1 - w_m) S_l\]Frame importance는 그 frame 안 token importance의 합이다.
세 가지 distortion
- Key frame fusion. 가장 중요한 상위 \(w_{fdr}\) frame을 각각 그 frame들의 평균으로 바꾸고, 약간의 Gaussian noise(weight \(w_{fpr}\))를 더한다. 그들 사이의 temporal 순서는 사라지지만 대략적인 장면은 남는다. Mean pooling은 dropping보다 혼란을 주는 context를 더 많이 남기고, shuffling보다 안정적이다.
- Key token distortion. 나머지 각 frame에서 가장 중요한 상위 \(w_{tdr}\) token을 masking한다. 나머지 frame까지 fuse하면 너무 많이 지워져 오해를 부르는 prior가 사라지므로, 여기서는 token 단위로 distort한다.
- Moving content disruption. Attention이 항상 믿을 만하지는 않으므로 이 단계는 visual similarity를 쓴다. Frame을 크기 \(w_{ws}\)의 겹치지 않는 window로 묶고, token을 \(w_{bs} \times w_{bs}\) block 안에서 평균한다. Block의 similarity는 window 안 다른 frame의 같은 위치 block과의 평균 cosine similarity이다. 가장 덜 비슷한 \(w_{cfr}\) 비율의 block을 dynamic으로 표시하고, 같은 위치의 dynamic block들은 frame 간 평균으로 바꾼다.
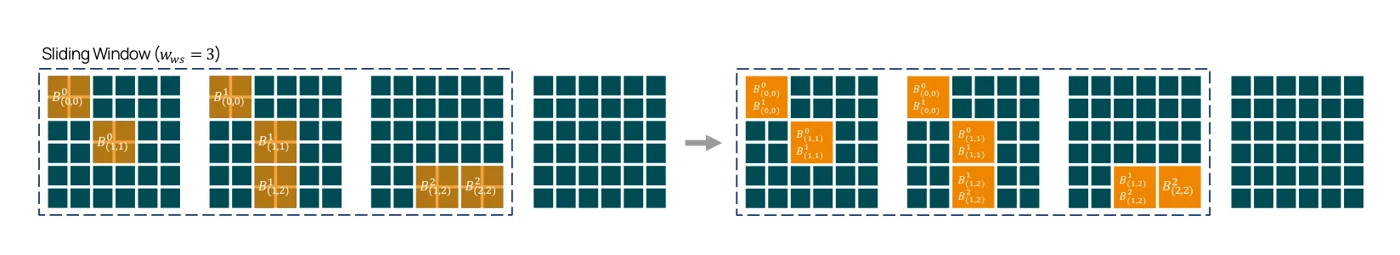 Window size 3에서의 moving content disruption. 왼쪽: 각 frame에서 dynamic으로 표시된 block(주황). 오른쪽: 같은 위치의 dynamic block들을 frame 간 평균하여 움직임은 흐리고 static context는 남긴다. 논문 Figure.
Distort된 key frame과 distort된 나머지 frame을 합친 것이 \(V'\)이다.
Main Experiments
Backbone은 Video-LLaVA(8 frame)와 LLaVA-Video-7B-Qwen2(32 frame)이다. Baseline은 video에 적용한 image-level contrastive decoding 방법(VCD, SID)과 frame을 무작위로 drop하는 TCD이다. TempCompass는 네 가지 답변 형식에 대한 accuracy를 보고한다.
| Model | Multi-Choice | Yes/No | Matching | Generation | Overall |
|---|---|---|---|---|---|
| Video-LLaVA | 45.5 | 56.3 | 63.3 | 34.8 | 49.8 |
| + VCD | 46.5 | 57.1 | 64.1 | 35.3 | 50.4 |
| + SID | 46.6 | 57.1 | 64.3 | 35.4 | 50.5 |
| + TCD | 46.8 | 57.2 | 64.3 | 35.4 | 50.6 |
| + VTD | 48.1 | 58.3 | 66.4 | 36.9 | 52.1 |
| LLaVA-Video-7B | 65.8 | 66.8 | 71.8 | 55.8 | 65.0 |
| + VCD | 66.1 | 67.4 | 73.1 | 56.5 | 65.7 |
| + SID | 66.2 | 67.5 | 73.2 | 56.4 | 65.8 |
| + TCD | 66.1 | 67.4 | 73.2 | 56.5 | 65.7 |
| + VTD | 68.0 | 69.4 | 75.2 | 57.8 | 67.5 |
EventHallusion(연속 사건, accuracy)과 Video-MME(accuracy), 모두 LLaVA-Video-7B-Qwen2 기준:
| Model | EH Entire | EH Interleave | EH Misleading | EH Overall | MME Temp. Perception | MME Temp. Reasoning | MME Overall |
|---|---|---|---|---|---|---|---|
| LLaVA-Video-7B | 52.1 | 60.3 | 82.5 | 63.5 | 61.1 | 54.3 | 59.8 |
| + VCD | 53.4 | 65.7 | 82.8 | 66.5 | 75.4 | 55.3 | 60.0 |
| + SID | 53.3 | 65.4 | 82.9 | 66.4 | 75.3 | 55.4 | 59.9 |
| + TCD | 53.6 | 66.8 | 83.3 | 67.2 | 75.9 | 55.8 | 59.8 |
| + VTD | 55.3 | 75.6 | 84.2 | 72.1 | 84.1 | 57.8 | 61.6 |
- VTD는 두 backbone 모두에서 모든 TempCompass 형식에 대해 모든 contrastive decoding baseline을 앞서며, base model 대비 +2.0에서 +3.4 point이다. Category별 최대 상승은 matching의 event order로, LLaVA-Video에서 +9.0이다.
- EventHallusion에서는 이득이 interleaved event(60.3 → 75.6)에 집중되며, overall 상승(+8.6)이 VCD(+3.0)보다 훨씬 크다.
- MLVU에서 overall은 67.4 → 68.5로 오르며 action count(41.8 → 44.1)와 action order(57.9 → 62.6)가 이를 이끈다. 반면 anomaly recognition(67.8 → 65.7)과 topic reasoning(84.5 → 83.8)은 떨어진다. 저자들은 이를 temporal 이해와 static 이해 사이의 trade-off로 해석한다.
LLaVA-Video에서의 ablation은 모든 구성 요소가 중요함을 보인다. 전체 방법은 TempCompass 67.5, EventHallusion 72.1이다. Attention guidance를 빼면 65.7 / 67.1, key frame fusion을 빼면 66.1 / 66.3, key token distortion을 빼면 66.5 / 68.3, moving content disruption을 빼면 66.9 / 69.7이다.
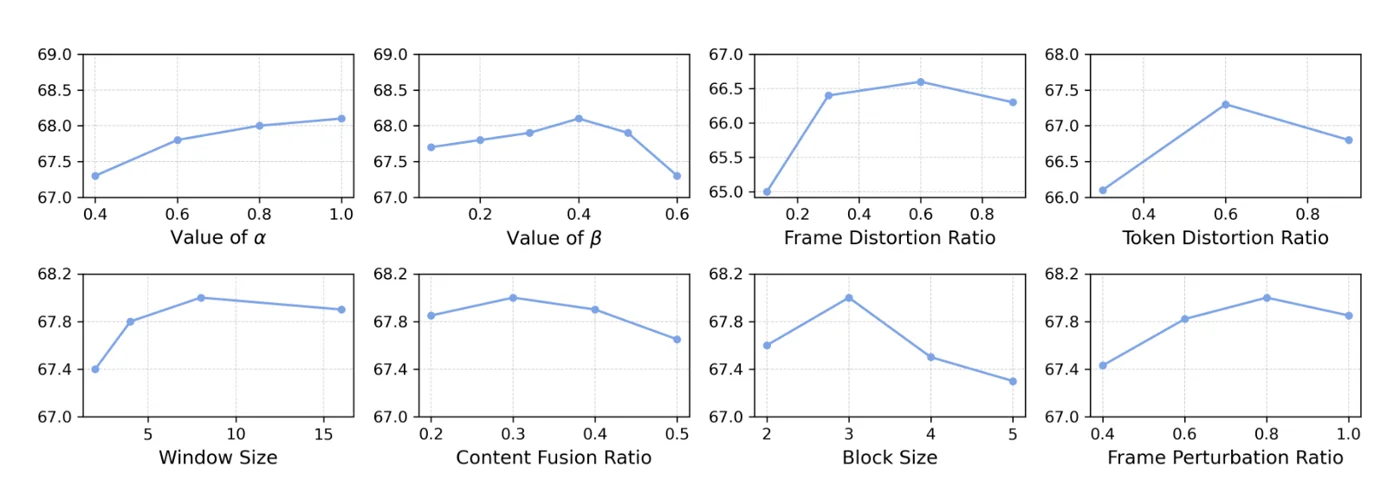 각 hyperparameter를 바꿀 때 LLaVA-Video-7B-Qwen2의 TempCompass accuracy. Distortion 강도를 정하는 값들(frame distortion ratio, token distortion ratio, content fusion ratio, block size)은 중간 값에서 최고이고 distortion이 너무 강하면 떨어진다. 논문 Figure.
Sensitivity plot은 핵심 주장을 뒷받침한다. Distortion이 너무 약하면 temporal cue가 남고, 너무 강하면 negative branch가 무작위가 되며, 적당한 distortion만이 빼기에 유용한 “가장 그럴듯한 실수”를 만든다.
Limitations
- Attention에 의존하는 guide. 저자들은 attention map이 실제 token importance를 항상 반영하지는 않으며 대략적인 추정만 준다고 말한다.
- Visual만 다룬다. 많은 video에 자막이 있지만 자막은 distort하지 않는다.
- 비용. Token마다 forward pass가 두 번 필요하고, 첫 pass는 중간 layer의 attention map을 돌려줘야 한다. Appendix는 CD 기반 방법이 느리다는 점을 인정하고, 두 pass를 병렬 CUDA stream으로 돌리면 peak memory는 늘지만 vanilla 속도와 같아진다고 제안한다. 시간 측정 표는 없으며, \(V'\)가 첫 pass의 attention에 의존하므로 두 pass가 완전히 독립일 수는 없다.
- 많은 hyperparameter, benchmark별 tuning. Momentum 외에도 knob이 여덟 개(\(\alpha\), \(\beta\), \(w_{fdr}\), \(w_{tdr}\), \(w_{ws}\), \(w_{cfr}\), \(w_{bs}\), \(w_{fpr}\))이며, appendix는 TempCompass, EventHallusion, Video-MME/MLVU에 서로 다른 값을 쓴다.
- Static 이해가 손해를 볼 수 있다. MLVU의 anomaly recognition과 topic reasoning이 떨어지므로, 질문이 temporal하다는 것을 알 때 쓰는 편이 낫다.
- 이상한 baseline 상승. Video-MME temporal perception에서 VCD만으로도 LLaVA-Video가 61.1에서 75.4로 오른다. 따라서 이 subset의 이득 상당 부분은 temporal distortion이 아니라 contrastive decoding 일반에서 온다.