Abstract
Large vision-language model(LVLM)은 object hallucination을 겪는다. Image에 없는 object를 묘사하는 현상이다. 논문은 기존 연구에서 이미 지목된 두 원인을 짚는다. 하나는 training data에서 오는 statistical bias(자주 등장하거나 실제 object와 함께 자주 등장하는 object)이고, 다른 하나는 LLM decoder의 language prior(어떤 대상에 대해 text가 보통 하는 말)이다. 기존 해법은 hallucination 전용 fine-tuning data, 별도로 학습한 post-hoc revisor, factually augmented RLHF처럼 추가 비용이 든다.
VCD는 학습도 외부 model도 필요 없다. Token마다 LVLM을 두 번 실행한다. 한 번은 원본 image로, 한 번은 Gaussian noise를 더한 image로 실행하고, 두 번째 logit을 첫 번째에서 뺀다. Noise image를 받은 model은 prior와 bias에 기대게 되므로, 이 뺄셈은 image가 뒷받침하지 않는 token을 정확히 걸러낸다. Adaptive plausibility constraint는 이 뺄셈이 말이 안 되는 token을 끌어올리지 않도록 막는다.
Motivation
핵심 주장은 visual uncertainty가 hallucination의 두 원인을 증폭한다는 것이다. 저자들은 forward diffusion process(Gaussian noise를 \(T\) step 동안 더함)로 image를 흐리게 만들고, next-token distribution이 어떻게 바뀌는지 관찰한다.
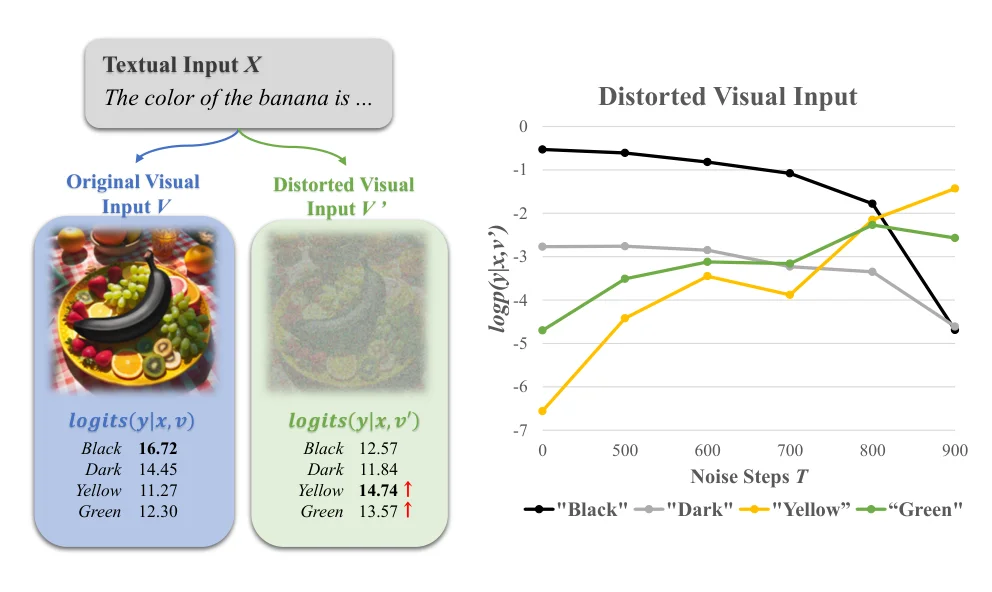 검은 바나나 image와 “The color of the banana is …” prompt. 원본 image에서는 “Black”의 logit이 가장 높다(16.72). Distorted image에서는 “Yellow”(14.74)와 “Green”(13.57)이 앞선다. 오른쪽 그래프는 noise step이 늘어날 때의 \(\log p(y \mid x, v')\)로, “Black”은 무너지고 흔한 색들이 올라간다. 논문 Figure.
Language prior가 한 축이라면 statistical bias는 다른 축이다. 대부분의 vision-language pretraining data는 MSCOCO에서 오며, object 분포가 불균형하고 co-occurrence가 편향되어 있다. Distorted input을 받으면 LLaVA-1.5는 원본 image일 때보다 자주 등장하는 object(person, dining table, car)와 “dining table”과 함께 등장하는 object(person, cup, bottle)를 더 많이 hallucinate한다.
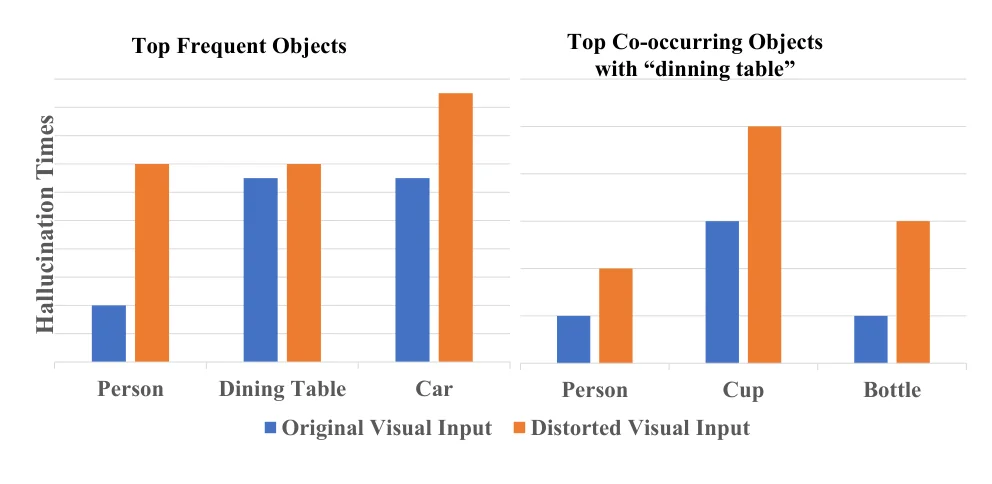 왼쪽: MSCOCO에서 가장 빈번한 object들은 visual input이 distort될 때 더 자주 hallucinate된다. 오른쪽: “dining table”과 자주 함께 나오는 object들도 마찬가지이다. 논문 Figure.
POPE에서 직접 보면, LLaVA-1.5의 regular decoding은 noise가 커질수록 꾸준히 나빠진다. Accuracy와 F1이 모두 떨어지며, \(T\)가 500을 넘으면 F1이 더 빠르게 떨어진다. 따라서 noise input은 원본보다 더 hallucination이 심한 distribution을 만드는 믿을 만한 방법이고, VCD는 이것을 negative로 사용한다.
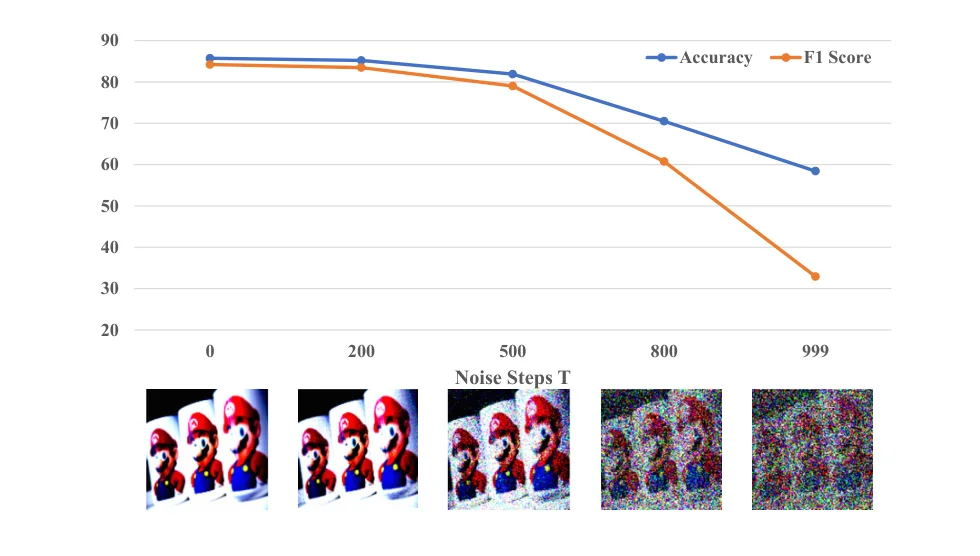 Noise step \(T\)가 늘어날 때 regular decoding에서 LLaVA-1.5의 POPE accuracy와 F1, 아래는 해당 noise image. 논문 Figure.
Method
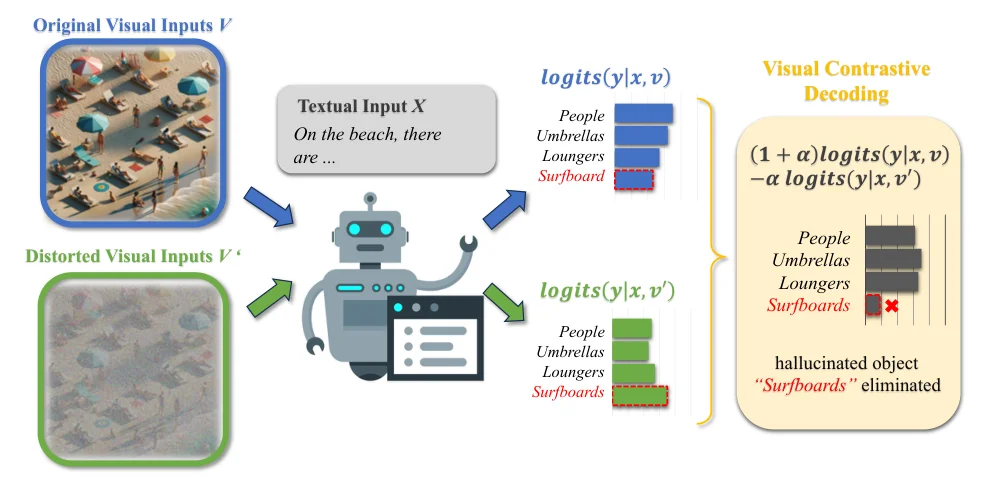 해변 image에 대한 VCD. 원본 image \(v\)와 distorted image \(v'\)가 각각 다음 object에 대한 logit을 낸다. “Surfboards”는 \(v\)에서는 약하지만 \(v'\)에서는 강하므로 contrast로 제거된다. 논문 Figure.
Visual uncertainty
Distorted image \(v'\)는 forward diffusion process로 만든다.
\[q(v_t \mid v_{t-1}) = \mathcal{N}\big(v_t;\ \sqrt{1-\gamma}\, v_{t-1},\ \gamma I\big), \qquad q(v_T \mid v_0) = \prod_{t=1}^{T} q(v_t \mid v_{t-1})\]\(\gamma = 0.1\)이다. POPE에는 \(T = 999\), MME와 LLaVA-Bench에는 \(T = 500\)을 쓴다.
Contrastive distribution
Query \(x\)가 주어지면 VCD는 \(v\)와 \(v'\) 각각으로 logit을 계산하고 다음 distribution에서 sampling한다.
\[p_{\text{vcd}}(y \mid v, v', x) = \mathrm{softmax}\big[(1+\alpha)\,\mathrm{logit}_\theta(y \mid v, x) - \alpha\,\mathrm{logit}_\theta(y \mid v', x)\big]\]\(\alpha = 0\)이면 regular decoding이고, 논문은 \(\alpha = 1\)을 쓴다. 저자들은 diffusion model의 classifier-free guidance \((1+\alpha)\epsilon_\theta(x, c) - \alpha \epsilon_\theta(x)\)와의 유사성을 언급한다. 여기서 “unconditional” branch는 흐린 image를 받은 model이다.
Adaptive plausibility constraint
Distorted distribution 전체를 빼는 것은 지나치다. Distorted branch도 문법과 상식은 여전히 알고 있기 때문이다. LLM용 contrastive decoding(Li et al.)을 따라, VCD는 원본 image에서 이미 그럴듯한 token만 남긴다.
\[\mathcal{V}_{\text{head}}(y_{<t}) = \big\{ y_t \in \mathcal{V} : p_\theta(y_t \mid v, x, y_{<t}) \ge \beta \max_w p_\theta(w \mid v, x, y_{<t}) \big\}\]이 집합 밖에서는 \(p_{\text{vcd}} = 0\)으로 두며, \(\beta = 0.1\)이다. Model이 확신할 때는 이 집합에 token이 하나만 남는 경우가 많아, VCD는 쉬운 결정을 바꾸지 않는다.
Main Experiments
모든 실험은 direct sampling을 baseline(“Regular”)으로 쓰고 5회 평균을 보고한다. MSCOCO 기반 POPE(object 존재 여부를 묻는 Yes/No 질문, accuracy / F1):
| Setting | Model | Regular Acc | VCD Acc | Regular F1 | VCD F1 |
|---|---|---|---|---|---|
| Random | LLaVA-1.5 | 83.29 | 87.73 | 81.33 | 87.16 |
| Random | Qwen-VL | 84.73 | 88.63 | 82.67 | 87.81 |
| Random | InstructBLIP | 80.71 | 84.53 | 80.41 | 83.68 |
| Popular | LLaVA-1.5 | 81.88 | 85.38 | 80.06 | 85.06 |
| Popular | Qwen-VL | 84.13 | 87.12 | 82.06 | 86.40 |
| Popular | InstructBLIP | 78.22 | 81.47 | 78.36 | 81.07 |
| Adversarial | LLaVA-1.5 | 78.96 | 80.88 | 77.57 | 81.33 |
| Adversarial | Qwen-VL | 82.26 | 84.26 | 80.37 | 83.90 |
| Adversarial | InstructBLIP | 75.84 | 79.56 | 76.59 | 79.52 |
MME hallucination subset(object-level: existence, count; attribute-level: position, color; subtask당 최대 200점):
| Model | Decoding | Existence | Count | Position | Color | Total |
|---|---|---|---|---|---|---|
| LLaVA-1.5 | Regular | 175.67 | 124.67 | 114.00 | 151.00 | 565.33 |
| LLaVA-1.5 | VCD | 184.66 | 138.33 | 128.67 | 153.00 | 604.66 |
| Qwen-VL | Regular | 155.00 | 127.67 | 131.67 | 173.00 | 587.33 |
| Qwen-VL | VCD | 156.00 | 131.00 | 128.00 | 181.67 | 596.67 |
| InstructBLIP | Regular | 141.00 | 75.33 | 66.67 | 97.33 | 380.33 |
| InstructBLIP | VCD | 168.33 | 92.33 | 64.00 | 123.00 | 447.67 |
- VCD는 모든 model의 모든 POPE setting을 개선하며, 최대 +5.8 accuracy, +7.4 F1이다. LLaVA-1.5와 Qwen-VL에서는 F1 상승이 주로 recall(최대 약 +10 point)에서 오고 precision은 약간 떨어진다. InstructBLIP에서는 precision에서 온다.
- MME에서 object-level 점수는 모든 model에서 오른다. Position은 거의 움직이지 않고 Qwen-VL과 InstructBLIP에서는 오히려 떨어지는데, 저자들은 LVLM이 애초에 position reasoning에 약하다고 해석한다.
- LLaVA-Bench에서 GPT-4V를 judge로 쓰면(10점 만점), accuracy는 3.23 → 4.15(LLaVA-1.5), 3.84 → 4.23(InstructBLIP), 4.76 → 6.69(Qwen-VL)로 오르고 detailedness도 오른다.
LLaVA-1.5의 MME 전체에서 VCD는 모든 perception subtask를 올린다. Recognition은 거의 그대로이며 numerical calculation과 text translation에서 소폭 떨어진다.
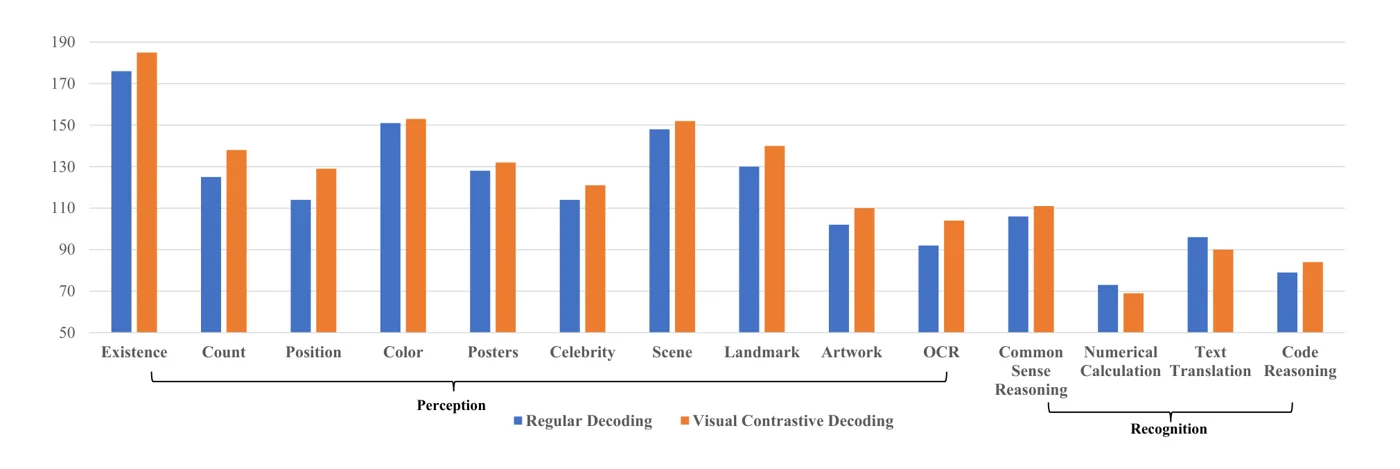 LLaVA-1.5의 MME 전체 결과. VCD(주황)는 열 개 perception subtask 모두에서 regular decoding(파랑)을 앞선다. 네 개 recognition subtask에서는 엇갈린다. 논문 Figure.
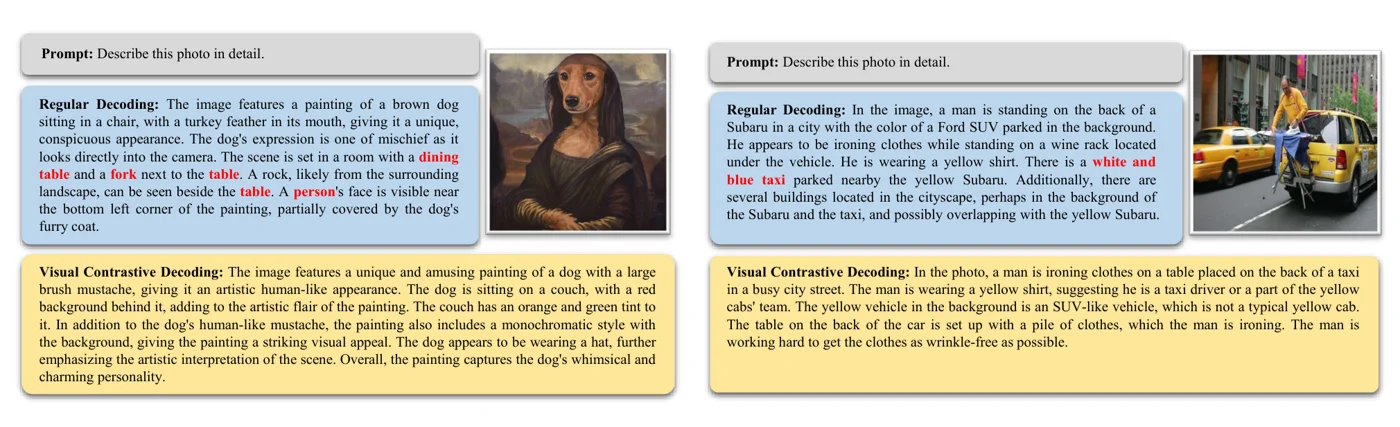 LLaVA-Bench의 두 사례. Regular decoding은 장면과 함께 자주 등장하는 object(“dining table”, “fork”, “white and blue taxi”, 빨간색)를 더한다. VCD는 개 그림과 taxi 위에서 다림질하는 남자를 이들 없이 묘사한다. 논문 Figure.
Limitations
- 두 배의 forward 비용. Token마다 distorted image로 한 번 더 forward pass가 필요하다.
- 거친 distortion. 저자들 스스로 Gaussian noise는 가장 기본적인 선택이며 object-level blurring 같은 더 정교한 distortion이 나을 수 있다고 말한다. 연구 범위도 image에 한정되고 video는 다루지 않는다.
- 약한 baseline. Regular decoding은 softmax에서 바로 sampling하는 방식이다. Greedy나 beam search 대비 이득은 supplement에서 POPE-Random에 대해서만 보인다.
- \(\beta\)에 민감하다. Supplement에서 \(\beta\)를 0.1에서 0.5로 올리면 LLaVA-1.5의 MME hallucination subset이 591.67에서 635.00으로 오른다. Plausibility constraint가 상당 부분을 담당하며, 기본 설정은 tuning된 값이 아니다.
- Precision이 떨어질 수 있다. POPE에서 LLaVA-1.5와 Qwen-VL은 VCD를 쓰면 precision이 떨어진다(예: LLaVA-1.5, MSCOCO adversarial에서 83.06 → 79.45). 즉 model이 “yes”를 더 자주 말한다. F1 상승 뒤에 yes/no 균형의 이동이 숨어 있다.