- 선형대수 강의 01–07강 정리
- KAIST DAVIAN Lab 기초 과목 스터디의 선형대수 강의다
스칼라, 벡터, 행렬
스칼라(scalar)는 숫자 하나다. 벡터(vector)는 숫자 여러 개를 순서대로 나열한 것이고, 기하학적으로는 크기와 방향을 가진 화살표다. 행렬(matrix)은 숫자를 2차원으로 배열한 것이다.
벡터와 \(\mathbb{R}^n\)
벡터는 기본적으로 세로로 쓴다. 이를 열 벡터(column vector)라 한다.
\[\mathbf{x} = \begin{bmatrix} 1 \\ 6 \\ 2 \end{bmatrix} \in \mathbb{R}^3 .\]\(\mathbb{R}\)은 실수 전체의 집합이고, \(\mathbb{R}^3\)은 실수 3개를 순서대로 묶은 것 전체의 집합이다. 따라서 \(\mathbf{x} \in \mathbb{R}^3\)은 \(\mathbf{x}\)가 가능한 모든 3차원 실수 벡터의 집합에 속한 원소 하나라는 뜻이다. 일반적으로 \(\mathbb{R}^n\)은 실수 성분이 \(n\)개인 벡터 전체의 집합이다.
\(\mathbb{R}^n\)의 열 벡터는 \(n \times 1\) 행렬로 볼 수도 있다. 가로로 쓴 벡터는 행 벡터(row vector)이고 \(1 \times n\) 행렬이다. 행 벡터는 항상 열 벡터의 전치로 나타낸다. 예를 들어 \(\mathbf{x}^T = \begin{bmatrix} 1 & 6 & 2 \end{bmatrix}\)이다.
행렬의 크기, 행과 열
행렬의 크기는 (행의 개수) \(\times\) (열의 개수)로 나타낸다. 행(row)은 가로 줄이고, 열(column)은 세로 줄이다. 영어 column은 건물의 기둥이라는 뜻도 있어서, 세로로 선 것이 열이라고 기억하면 된다. 예를 들어
\[A = \begin{bmatrix} 1 & 6 \\ 3 & 4 \\ 5 & 2 \end{bmatrix} \in \mathbb{R}^{3 \times 2}\]는 행이 3개, 열이 2개인 \(3 \times 2\) 행렬이다. 각 행은 \(\mathbb{R}^2\)의 행 벡터이고, 각 열은 \(\mathbb{R}^3\)의 열 벡터이다.
행과 열의 개수가 같은 \(n \times n\) 행렬을 정사각 행렬(square matrix), 다른 행렬을 직사각 행렬(rectangular matrix)이라 한다.
전치
전치(transpose) \(A^T\)는 행렬을 주대각선을 축으로 뒤집은 것이다. \(A\)의 \(i\)번째 행이 \(A^T\)의 \(i\)번째 열이 된다. 따라서 \(m \times n\) 행렬은 \(n \times m\) 행렬이 된다.
\[A = \begin{bmatrix} 1 & 6 \\ 3 & 4 \\ 5 & 2 \end{bmatrix} \quad\Longrightarrow\quad A^T = \begin{bmatrix} 1 & 3 & 5 \\ 6 & 4 & 2 \end{bmatrix}.\]열 벡터를 전치하면 행 벡터가 되고, 행 벡터를 전치하면 열 벡터가 된다.
성분, 행, 열의 표기
\(A_{ij}\) (또는 \(a_{ij}\))는 \(i\)번째 행, \(j\)번째 열의 성분이다. 위 행렬에서 \(A_{21} = 3\)이다. 두 번째 행을 고른 뒤 그 행의 첫 번째 성분을 고른 것이다.
콜론(:)은 해당 인덱스 전체를 뜻한다.
- \(A_{i,:}\)는 \(i\)번째 행 전체다. 여기서 \(A_{2,:} = \begin{bmatrix} 3 & 4 \end{bmatrix}\)이다.
- \(A_{:,j}\)는 \(j\)번째 열 전체다. 여기서 \(A_{:,2} = \begin{bmatrix} 6 \\ 4 \\ 2 \end{bmatrix}\)이다.
벡터와 행렬의 연산
벡터나 행렬 사이의 나눗셈은 정의되지 않는다. 덧셈, 뺄셈, 그리고 몇 가지 곱셈이 정의된다.
덧셈과 스칼라 곱
덧셈은 같은 위치의 성분끼리 더한다. 따라서 두 피연산자의 크기가 정확히 같아야 한다.
\[\begin{bmatrix} 1 \\ 0 \\ 2 \end{bmatrix} + \begin{bmatrix} 2 \\ 3 \\ 4 \end{bmatrix} = \begin{bmatrix} 3 \\ 3 \\ 6 \end{bmatrix}.\]뺄셈은 두 번째 피연산자에 \(-1\)을 곱해 더하는 것이다. 스칼라 곱(scalar multiplication)은 모든 성분에 그 스칼라를 곱한다. 예를 들어 \(2 \begin{bmatrix} 1 & 3 \end{bmatrix} = \begin{bmatrix} 2 & 6 \end{bmatrix}\)이다. 행렬에도 같은 규칙이 적용된다.
표기 관례. 대문자(\(A\), \(B\))는 행렬, 소문자 일반체(\(a\), \(c\))는 스칼라, 소문자 굵은 글씨(\(\mathbf{x}\), \(\mathbf{b}\))는 벡터를 나타낸다. 대부분의 교재와 논문이 이 관례를 따른다.
행렬 곱셈
\(AB\)의 \((i, j)\) 성분은 \(A\)의 \(i\)번째 행과 \(B\)의 \(j\)번째 열의 내적(inner product)이다. 대응하는 성분끼리 곱한 뒤 모두 더한다.
\[\begin{bmatrix} 1 & 6 \\ 3 & 4 \\ 5 & 2 \end{bmatrix} \begin{bmatrix} 2 & -1 \\ 1 & 5 \end{bmatrix} = \begin{bmatrix} 1\cdot 2 + 6 \cdot 1 & 1 \cdot (-1) + 6 \cdot 5 \\ 3 \cdot 2 + 4 \cdot 1 & 3 \cdot (-1) + 4 \cdot 5 \\ 5 \cdot 2 + 2 \cdot 1 & 5 \cdot (-1) + 2 \cdot 5 \end{bmatrix} = \begin{bmatrix} 8 & 29 \\ 10 & 17 \\ 12 & 5 \end{bmatrix}.\]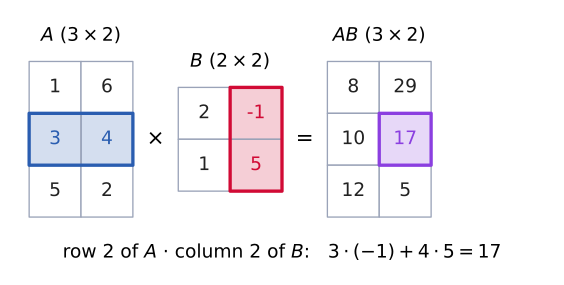 \(AB\)의 \((2, 2)\) 성분은 \(A\)의 2행과 \(B\)의 2열의 내적이다.
그림에서 파란 테두리는 \(A\)의 두 번째 행 \((3, 4)\), 빨간 테두리는 \(B\)의 두 번째 열 \((-1, 5)\)이다. 두 벡터의 성분을 순서대로 곱해 더한 \(3 \cdot (-1) + 4 \cdot 5 = 17\)이 결과 행렬의 보라색 칸, 즉 2행 2열에 들어간다. 행의 번호가 결과의 행 번호를, 열의 번호가 결과의 열 번호를 정한다. 나머지 다섯 칸도 같은 방식으로 행 하나와 열 하나를 짝지어 채운다.
내적이 가능하려면 \(A\)의 행과 \(B\)의 열의 길이가 같아야 한다. 따라서 \(A\)가 \(m \times n\)이면 \(B\)는 \(n \times p\)여야 하고, 가운데의 \(n\)이 내적으로 사라진다.
\[(m \times n)(n \times p) = (m \times p).\]내적과 외적
벡터도 행렬의 특수한 경우이므로 같은 규칙으로 곱한다. \(\mathbf{u} = (1, 2, 3)\), \(\mathbf{v} = (4, 5, 6)\)이라 하자.
- 내적 \(\mathbf{u}^T \mathbf{v}\): \((1 \times 3)(3 \times 1)\) 곱이므로 결과는 \(1 \times 1\), 즉 스칼라다.
- 외적(outer product) \(\mathbf{u} \mathbf{v}^T\): \((3 \times 1)(1 \times 3)\) 곱이므로 결과는 \(3 \times 3\) 행렬이다. 이때 각 “내적”에는 곱할 쌍이 하나뿐이어서, 각 성분은 곱 \(u_i v_j\) 하나다.
얇은 벡터 두 개로 큰 행렬이 만들어진다.
성질
교환 법칙이 성립하지 않는다. 일반적으로 \(AB \neq BA\)이다. 정사각 행렬이어도 결과가 다르다.
\[\begin{bmatrix} 1 & 2 \\ 3 & 4 \end{bmatrix} \begin{bmatrix} 5 & 6 \\ 7 & 8 \end{bmatrix} = \begin{bmatrix} 19 & 22 \\ 43 & 50 \end{bmatrix}, \qquad \begin{bmatrix} 5 & 6 \\ 7 & 8 \end{bmatrix} \begin{bmatrix} 1 & 2 \\ 3 & 4 \end{bmatrix} = \begin{bmatrix} 23 & 34 \\ 31 & 46 \end{bmatrix}.\]직사각 행렬은 순서를 바꾸면 곱셈 자체가 정의되지 않을 수 있다. \(A\)가 \(3 \times 2\), \(B\)가 \(2 \times 5\)이면 \(AB\)는 \(3 \times 5\)이지만, \(BA\)는 \((2 \times 5)(3 \times 2)\)가 되어 가운데 크기 5와 3이 맞지 않는다.
분배 법칙: \(A(B + C) = AB + AC\), \((B + C)A = BA + CA\).
결합 법칙: \((AB)C = A(BC)\). 인수의 순서만 유지하면 어느 곱을 먼저 계산해도 된다. 크기는 징검다리처럼 맞물린다. \(A \in \mathbb{R}^{3 \times 2}\), \(B \in \mathbb{R}^{2 \times 5}\), \(C \in \mathbb{R}^{5 \times 4}\)이면 \(ABC\)는 \(3 \times 4\)이다.
곱의 전치는 순서가 뒤집힌다.
\[(AB)^T = B^T A^T, \qquad (ABC)^T = C^T B^T A^T.\]크기를 확인하면 순서가 뒤집혀야 하는 이유가 보인다. \((ABC)^T\)는 \(4 \times 3\)이다. 우변에서 \(C^T\)는 \(4 \times 5\), \(B^T\)는 \(5 \times 2\), \(A^T\)는 \(2 \times 3\)이므로 가운데 크기가 모두 맞고 결과는 \(4 \times 3\)이다. 원래 순서대로 \(A^T B^T C^T\)를 쓰면 \((2 \times 3)(5 \times 2)(4 \times 5)\)가 되어 곱셈이 정의되지 않는다. 증명은 아니지만, 순서를 뒤집어야만 크기가 맞는다는 것을 알 수 있다.
선형 방정식
선형 시스템(linear system)은 우리말로 연립방정식이다. 연립방정식을 푼다는 것은 여러 방정식을 동시에 만족하는 변수 값을 찾는 것이다. 먼저 방정식 하나, 즉 선형 방정식을 살펴본다.
선형 방정식의 조건
변수 \(x_1, \dots, x_n\)에 대한 선형 방정식(linear equation)은 다음 꼴이다.
\[a_1 x_1 + a_2 x_2 + \cdots + a_n x_n = b\]계수 \(a_1, \dots, a_n\)과 \(b\)는 실수다(복소수도 가능하지만 이 강의에서는 실수만 다룬다). 모든 항의 차수가 1이어야 한다. 항의 차수는 그 항에서 변수가 몇 번 곱해졌는지를 센 것이다.
- \(3x + y = 5\)는 선형이다. 미지수는 2개이고 각 항의 차수는 1이다.
- \(x^2 + y = 1\)은 선형이 아니다. \(x^2\)의 차수가 2다.
- \(x^2 + y^2 = 5\)는 선형이 아니다. 원의 방정식이다.
- \(x + 2y + 3xy = 5\)는 선형이 아니다. \(xy\)는 변수 두 개를 곱한 항이라 차수가 2다.
미지수가 몇 개뿐이면 \(x, y, z\)로 쓰면 된다. 머신러닝에서는 미지수가 수천, 수백만 개가 될 수 있으므로 \(x_1, x_2, \dots, x_n\)처럼 번호를 붙인다.
선형 방정식을 내적으로 쓰기
계수를 \(\mathbf{a}\)에, 미지수를 \(\mathbf{x}\)에 모은다.
\[\mathbf{a} = \begin{bmatrix} a_1 \\ \vdots \\ a_n \end{bmatrix}, \qquad \mathbf{x} = \begin{bmatrix} x_1 \\ \vdots \\ x_n \end{bmatrix}\]그러면 좌변은 내적 하나가 되고, 방정식은 다음과 같다.
\[\mathbf{a}^T \mathbf{x} = b\]\(3x + y = 5\)라면 \(\mathbf{a} = (3, 1)\), \(\mathbf{x} = (x_1, x_2)\)이다. 내적은 순서를 바꿔도 같으므로 \(\mathbf{a}^T \mathbf{x} = \mathbf{x}^T \mathbf{a}\)이고, 방정식을 \(\mathbf{x}^T \mathbf{a} = b\)로 써도 된다. 이 간단한 성질은 머신러닝의 식 유도에서 자주 쓰인다. 긴 합을 짧은 벡터·행렬 식으로 쓰는 것이 선형대수의 기본 기술이다.
선형 시스템과 항등 행렬
같은 변수에 대한 선형 방정식 여러 개의 묶음을 선형 방정식계(system of linear equations), 줄여서 선형 시스템이라 한다.
예시: 수명 예측
머신러닝의 주된 과제 중 하나는 예측(prediction)이다. 몸무게(kg), 키(ft), 흡연 여부(1 = 흡연, 0 = 비흡연)로 사람의 수명을 예측하는 문제를 생각한다. 학습 데이터는 과거 기록이다.
| 사람 | 몸무게 | 키 | 흡연 | 수명 |
|---|---|---|---|---|
| 1 | 60 | 5.5 | 1 | 66 |
| 2 | 65 | 5.0 | 0 | 74 |
| 3 | 55 | 6.0 | 1 | 78 |
선형 모델은 수명을 특징들의 가중합으로 나타낸다. 가중치 \(x_1, x_2, x_3\)는 모든 사람에게 같다.
\[\begin{aligned} 60 x_1 + 5.5 x_2 + 1 \cdot x_3 &= 66 \\ 65 x_1 + 5.0 x_2 + 0 \cdot x_3 &= 74 \\ 55 x_1 + 6.0 x_2 + 1 \cdot x_3 &= 78 \end{aligned}\]이 방정식을 풀어 \(x_1, x_2, x_3\)를 구하면, 수명이 세 특징에 어떻게 의존하는지 알게 된다. 새로운 사람(예: 70 kg, 6.55 ft, 비흡연)이 오면 \(70 x_1 + 6.55 x_2 + 0 \cdot x_3\)로 수명을 예측한다. 연립방정식을 푸는 일이 곧 예측 모델을 만드는 일이 된다.
행렬 형태 \(A\mathbf{x} = \mathbf{b}\)
각 방정식은 내적 \(\mathbf{a}_i^T \mathbf{x} = b_i\)이다. 여기서 \(\mathbf{a}_i^T\)는 \(i\)번째 사람의 특징 값을 모은 행이다. 행들을 쌓아 행렬 \(A\)를, 목표 값을 모아 \(\mathbf{b}\)를 만든다.
\[A = \begin{bmatrix} 60 & 5.5 & 1 \\ 65 & 5.0 & 0 \\ 55 & 6.0 & 1 \end{bmatrix}, \quad \mathbf{x} = \begin{bmatrix} x_1 \\ x_2 \\ x_3 \end{bmatrix}, \quad \mathbf{b} = \begin{bmatrix} 66 \\ 74 \\ 78 \end{bmatrix}\]그러면 연립방정식 전체가 식 하나가 된다.
\[A\mathbf{x} = \mathbf{b}\]\(A\mathbf{x}\)의 \(i\)번째 성분은 \(A\)의 \(i\)번째 행과 \(\mathbf{x}\)의 내적이고, 이것이 \(b_i\)와 같아야 한다. 바로 \(i\)번째 방정식이다.
항등 행렬
\(A\mathbf{x} = \mathbf{b}\)를 풀려면 먼저 항등 행렬(identity matrix) \(I_n\)이 필요하다. 주대각선 성분은 1이고 나머지는 모두 0인 \(n \times n\) 정사각 행렬이다.
\[I_3 = \begin{bmatrix} 1 & 0 & 0 \\ 0 & 1 & 0 \\ 0 & 0 & 1 \end{bmatrix}\]항등 행렬을 곱해도 벡터는 그대로다.
\[I_n \mathbf{x} = \mathbf{x} \quad \text{for all } \mathbf{x} \in \mathbb{R}^n\]첫 번째 행 \((1, 0, 0)\)은 \(x_1\)만 남기고, 두 번째 행은 \(x_2\)만 남기는 식이다. 마찬가지로 임의의 \(m \times n\) 행렬 \(A\)에 대해 \(I_m A = A I_n = A\)이다.
역행렬
정의
\(n \times n\) 정사각 행렬 \(A\)의 역행렬(inverse matrix) \(A^{-1}\)은 다음을 만족하는 \(n \times n\) 행렬이다.
\[A^{-1} A = A A^{-1} = I_n\]왼쪽에 곱하든 오른쪽에 곱하든 항등 행렬이 된다. 일반적으로 \(AB \neq BA\)이지만, 행렬과 그 역행렬은 순서가 상관없는 특수한 경우다.
\(2 \times 2\) 역행렬 공식
\(A = \begin{bmatrix} a & b \\ c & d \end{bmatrix}\)이고 \(ad - bc \neq 0\)이면
\[A^{-1} = \frac{1}{ad - bc} \begin{bmatrix} d & -b \\ -c & a \end{bmatrix}.\]대각 성분은 서로 바꾸고, 비대각 성분은 부호를 바꾼 뒤, \(ad - bc\)로 나눈다. 예를 들어
\[\begin{bmatrix} 1 & 2 \\ 3 & 4 \end{bmatrix}^{-1} = \frac{1}{1 \cdot 4 - 2 \cdot 3} \begin{bmatrix} 4 & -2 \\ -3 & 1 \end{bmatrix} = \begin{bmatrix} -2 & 1 \\ 1.5 & -0.5 \end{bmatrix}.\]\(3 \times 3\) 이상의 역행렬은 보통 소프트웨어로 계산한다(예: NumPy나 MATLAB의 inv 함수).
역행렬은 정사각 행렬에만 있다
직사각 행렬은 역행렬이 없다. \(A\)가 \(3 \times 2\)라고 하자. \(A^{-1}A\)와 \(AA^{-1}\)이 모두 정의되려면 \(A^{-1}\)은 \(2 \times 3\)이어야 한다. 그러면 \(A^{-1}A\)는 \(2 \times 2\), \(AA^{-1}\)은 \(3 \times 3\)이 되어 같은 항등 행렬이 될 수 없다. 따라서 역행렬은 정사각 행렬에 대해서만 다룬다.
\(A\mathbf{x} = \mathbf{b}\) 풀기
\(A^{-1}\)이 존재하면 \(A\mathbf{x} = \mathbf{b}\)의 양변 왼쪽에 \(A^{-1}\)을 곱한다.
\[A^{-1}A\mathbf{x} = A^{-1}\mathbf{b} \;\Longrightarrow\; I_n \mathbf{x} = A^{-1}\mathbf{b} \;\Longrightarrow\; \mathbf{x} = A^{-1}\mathbf{b}\]수명 예측 시스템에서 \(A^{-1}\)을 컴퓨터로 구해 곱하면
\[\mathbf{x} = A^{-1}\mathbf{b} = \begin{bmatrix} -0.4 \\ 20 \\ -20 \end{bmatrix}\]이다. 첫 번째 사람으로 검산하면 \(60(-0.4) + 5.5(20) + 1(-20) = -24 + 110 - 20 = 66\)이다. 몸무게를 \(w\), 키를 \(h\), 흡연 여부를 \(s\)라 하면 예측 수명은
\[-0.4\,w + 20\,h - 20\,s\]이다. 가중치는 쉽게 해석된다. 키가 1 ft 클수록 수명이 20년 늘고, 몸무게가 1 kg 늘수록 0.4년 줄며, 흡연하면 20년 준다. (설명을 위한 가상의 예시이고 의학적 주장이 아니다.)
역행렬이 없는 행렬
역행렬은 언제 존재하지 않는가
\(2 \times 2\) 공식은 \(ad - bc\)로 나누므로 \(ad - bc = 0\)이면 쓸 수 없다. 예를 들어
\[A = \begin{bmatrix} 1 & 2 \\ 3 & 6 \end{bmatrix}, \qquad ad - bc = 1 \cdot 6 - 2 \cdot 3 = 0.\]두 행의 비율이 같다. 두 번째 행이 첫 번째 행의 3배다. 이런 행렬을 특이 행렬(singular matrix), 즉 역행렬이 없는 행렬이라 한다.
\(ad - bc\)를 행렬식(determinant) \(\det A\)라 한다. 이름 그대로 역행렬의 존재를 결정한다. \(\det A \neq 0\)일 때, 그리고 그때에만 \(A\)는 역행렬을 갖는다. \(3 \times 3\) 행렬의 행렬식은 사루스 법칙(rule of Sarrus)으로 구할 수 있다. 오른쪽 아래로 내려가는 세 대각선의 곱을 더하고, 반대 방향 세 대각선의 곱을 뺀다.
\[\det \begin{bmatrix} a & b & c \\ d & e & f \\ g & h & i \end{bmatrix} = aei + bfg + cdh - ceg - bdi - afh\]행렬식의 의미는 뒤에서 다룬다. 지금은 역행렬이 있는지 판별하는 식으로 보면 된다.
해는 어떻게 되는가
\(A\)가 역행렬을 가지면 \(A\mathbf{x} = \mathbf{b}\)는 해가 정확히 하나, \(\mathbf{x} = A^{-1}\mathbf{b}\)이다. \(A\)가 역행렬을 갖지 않으면 해가 유일하지 않다. 해가 없거나, 해가 무수히 많다.
미지수가 2개인 방정식 하나는 평면 위의 직선이고, 해는 두 직선 위에 동시에 있는 점이다. 위의 특이 행렬로 예를 든다.
- \(x + 2y = 4\), \(3x + 6y = 12\). 두 번째 식은 첫 번째 식의 3배이므로 두 직선이 완전히 겹친다. 직선 위의 모든 점이 해다. 해가 무수히 많다.
- \(x + 2y = 4\), \(3x + 6y = 10\). 좌변의 비율은 3배인데 우변은 3배가 아니다. 두 직선이 평행해서 만나지 않는다. 해가 없다.
역행렬이 있는 경우, 예를 들어 \(x + 2y = 4\), \(3x + 4y = 10\)은 기울기가 다른 두 직선이 한 점 \((x, y) = (2, 1)\)에서 만난다.
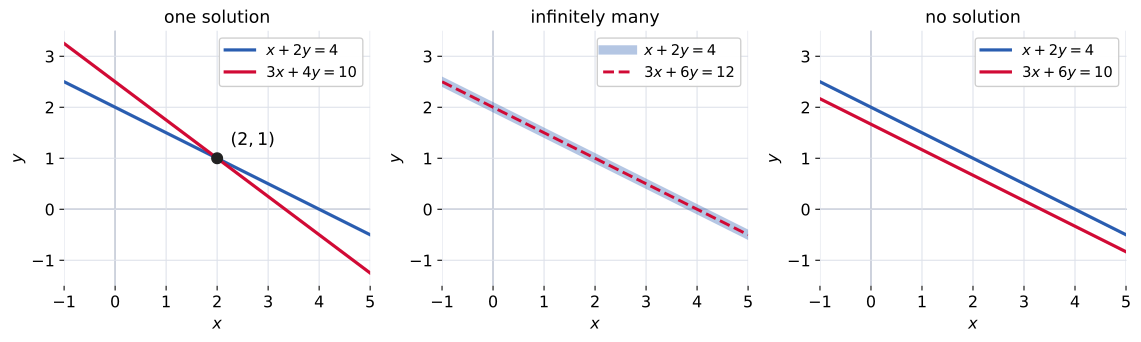 미지수 2개인 연립방정식의 세 경우. 한 점에서 만나거나(해 1개), 겹치거나(해 무수히 많음), 평행하다(해 없음).
세 그림 모두 파란 직선은 \(x + 2y = 4\)로 같고, 빨간 직선만 다르다. 왼쪽은 역행렬이 있는 경우로, 두 직선의 기울기가 달라 반드시 한 점에서 만난다. 가운데와 오른쪽은 계수 행렬이 같은 특이 행렬 \(\begin{bmatrix} 1 & 2 \\ 3 & 6 \end{bmatrix}\)이다. 좌변의 비율이 같으므로 두 직선의 기울기가 같고, 우변까지 같은 비율이면 직선이 겹치며(가운데), 우변의 비율이 다르면 평행하게 떨어진다(오른쪽).
따라서 특이 행렬에서는 기울기가 같다는 사실만 정해지고, 겹치는지 떨어지는지는 \(\mathbf{b}\)가 결정한다. 어느 쪽이든 “정확히 한 점”은 나올 수 없다.
직사각 행렬
행은 샘플, 열은 특징
지금까지 \(A\)는 정사각 행렬이었다. 수명 예측 예시에서
- 행(방정식)의 개수는 데이터 샘플(사람)의 수이고,
- 열(미지수)의 개수는 입력 특징(몸무게, 키, 흡연 여부)의 수이다.
실제로는 두 수가 거의 같지 않다. 그래서 \(A\)는 대개 직사각 행렬이고, \(A^{-1}\)은 존재하지 않는다.
미지수가 방정식보다 많을 때
네 번째 특징으로, 예를 들어 미세먼지가 많은 지역에 사는지를 추가했는데 사람은 여전히 3명이라고 하자. 방정식은 3개, 미지수는 4개다. 이런 시스템을 과소결정(underdetermined) 시스템이라 한다. 일반적으로 (해가 있다면) 해가 무수히 많다. 맞춰야 할 조건보다 조절할 수 있는 손잡이가 더 많기 때문이다.
구체적으로, 세 사람의 미세먼지 값이 마침 \((1, 0, 1)\)이라고 하자.
\[\begin{bmatrix} 60 & 5.5 & 1 & 1 \\ 65 & 5.0 & 0 & 0 \\ 55 & 6.0 & 1 & 1 \end{bmatrix} \begin{bmatrix} x_1 \\ x_2 \\ x_3 \\ x_4 \end{bmatrix} = \begin{bmatrix} 66 \\ 74 \\ 78 \end{bmatrix}\]여기서는 합 \(x_3 + x_4\)만 의미가 있고, 그 값은 \(-20\)이어야 한다. 따라서
\[\mathbf{x} = \begin{bmatrix} -0.4 \\ 20 \\ -20 - t \\ t \end{bmatrix}, \qquad t \in \mathbb{R}\]꼴의 벡터는 모두 해다. 예를 들어 \((-0.4, 20, -20, 0)\), \((-0.4, 20, -10, -10)\), \((-0.4, 20, -50, 30)\)이 모두 해다. 셋 다 학습 데이터를 완벽히 맞추지만, 흡연 여부와 미세먼지 값이 다른 새로운 사람에 대해서는 서로 다른 예측을 낸다. 예측 모델로는 어느 것을 써야 하는가?
방정식이 미지수보다 많을 때
이번에는 특징은 3개로 두고 100명의 데이터를 모았다고 하자. 방정식은 100개, 미지수는 3개다. 이런 시스템을 과잉결정(overdetermined) 시스템이라 한다. 일반적으로 해가 없다. 100개의 방정식을 모두 정확히 만족하는 가중치가 존재하지 않는다.
각 경우의 대처
두 경우 모두 포기할 이유는 없다.
- 해가 없을 때(과잉결정). 방정식을 근사적으로라도 최대한 만족하는 가중치를 찾는다. 1번 사람의 실제 수명이 74세인데 모델이 72.5세로 예측하면 오차는 1.5다. 모든 방정식에 대한 오차의 합이 가장 작아지도록 가중치를 고른다. 이것이 최소제곱법(least squares)이며, Linear Algebra 5에서 다룬다.
- 해가 무수히 많을 때(과소결정). 해 하나를 고르는 추가 기준을 둔다. 흔한 방법이 정규화(regularization)로, 가중치가 가장 작은 해를 선호한다.
왜 작은 가중치를 선호하는가? \((-0.4, 20, -10, -10)\)과 \((-0.4, 20, -50, 30)\)을 비교해 보자. 두 번째 해는 흡연과 미세먼지 특징에 큰 가중치를 준다. 새로운 사람의 특징이 학습 데이터와 조금만 달라도 예측이 크게 흔들린다. 가중치가 작을수록 모델이 안정적이다. 일종의 위험 관리(risk management)다. 주식 추천이 세 번 연속 맞은 사람이 있어도 전 재산을 그 사람 말에 거는 것은 위험하다. 신뢰를 한곳에 몰지 않고 조심스럽게 나누는 것과 같다.
이 예시에서 모든 해 중 \(x_3^2 + x_4^2\)이 가장 작은 해는 \(t = -10\)일 때의 \((-0.4, 20, -10, -10)\)이다. 완전히 같은 두 특징에 가중치를 똑같이 나눈 해다.
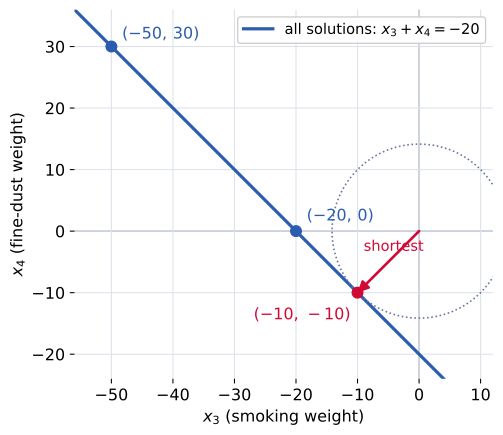 \((x_3, x_4)\) 평면에서 본 해 집합. 모든 해가 직선 \(x_3 + x_4 = -20\) 위에 있고, 원점에 가장 가까운 점이 \((-10, -10)\)이다.
\(x_1 = -0.4\), \(x_2 = 20\)은 모든 해에서 같으므로, 해의 차이는 \((x_3, x_4)\) 두 성분에만 있다. 그 두 성분을 평면에 찍으면 파란 직선이 된다. 본문의 세 해 \((-20, 0)\), \((-10, -10)\), \((-50, 30)\)이 모두 이 직선 위에 있다.
\(x_3^2 + x_4^2\)은 원점에서의 거리의 제곱이다. 원점을 중심으로 원을 키워 가다 직선에 처음 닿는 점이 가장 작은 해이고, 원점에서 그 점으로 가는 빨간 화살표는 직선과 수직이다. 직선의 방향이 \((-1, 1)\)이므로 수직 방향은 \((1, 1)\) 쪽이고, 그래서 두 성분이 같은 \((-10, -10)\)이 답이 된다.
정리
- 벡터는 기본적으로 열 벡터이고, \(\mathbb{R}^n\)은 실수 \(n\)개로 된 벡터 전체의 집합이다. \(m \times n\) 행렬은 행이 \(m\)개, 열이 \(n\)개이며, 전치는 행과 열을 맞바꾼다.
- 행렬 곱셈은 \(A\)의 행과 \(B\)의 열의 내적으로 계산한다. \((m \times n)(n \times p)\)의 크기가 맞아야 하고 결과는 \(m \times p\)이다. 결합·분배 법칙은 성립하지만 교환 법칙은 성립하지 않으며, \((AB)^T = B^T A^T\)이다.
- 선형 방정식은 \(\mathbf{a}^T\mathbf{x} = b\), 선형 시스템은 \(A\mathbf{x} = \mathbf{b}\)로 쓴다. 예측 문제에서 행은 샘플, 열은 특징이다.
- 항등 행렬은 \(I_n\mathbf{x} = \mathbf{x}\)를 만족한다. 정사각 행렬 \(A\)가 \(A^{-1}A = AA^{-1} = I_n\)인 역행렬을 가지면 \(\mathbf{x} = A^{-1}\mathbf{b}\)가 유일한 해다.
- 정사각 행렬은 \(\det A \neq 0\)일 때만 역행렬을 갖는다(\(2 \times 2\)에서는 \(ad - bc \neq 0\)). 그렇지 않으면 해가 없거나 무수히 많다.
- 실제 문제의 행렬은 대개 직사각 행렬이다. 과잉결정 시스템은 보통 해가 없으므로 최소제곱법을 쓰고, 과소결정 시스템은 보통 해가 무수히 많으므로 정규화로 작은 가중치를 선호한다.