- 선형대수 강의 15–18강 정리
- KAIST DAVIAN Lab 기초 과목 스터디의 선형대수 강의다
선형변환
지금까지 \(A\mathbf{x} = \mathbf{b}\)는 풀어야 할 연립방정식이었다. 이번 섹션에서는 이 식을 다르게 읽는다. \(\mathbf{b}\)를 지우고 행렬 \(A\)를 고정한 뒤, \(\mathbf{x}\)를 자유롭게 바뀌는 입력으로 본다. 그러면
\[\mathbf{y} = A\mathbf{x}\]는 입력 벡터를 출력 벡터로 바꾸는 함수가 된다. \(A\)가 \(5 \times 3\)이면 입력 \(\mathbf{x}\)는 3차원, 출력 \(\mathbf{y}\)는 5차원 벡터다. 이런 벡터에서 벡터로 가는 함수를 변환(transformation) 또는 사상(mapping)이라 한다.
함수: 정의역, 공역, 치역, 상
선형성을 붙이기 전에 함수의 정의를 다시 본다. 함수 \(f : X \to Y\)는 \(X\)의 각 원소에 \(Y\)의 원소를 정확히 하나 대응시킨다.
- 정의역(domain): 가능한 모든 입력의 집합 \(X\).
- 공역(codomain): 출력이 놓일 수 있는 집합 \(Y\).
- \(x\)의 상(image): 출력값 \(f(x)\).
- 치역(range): 모든 상의 집합 \(\{ f(x) : x \in X \}\). 공역의 부분집합이며, 공역보다 작을 수 있다.
정의역에서 공역으로 화살표를 그린다고 생각하면 된다. 정의역의 어떤 원소에서 화살표가 나가지 않거나, 한 원소에서 서로 다른 두 출력으로 화살표가 나가면 함수가 아니다. 서로 다른 두 입력이 같은 출력으로 가는 것은 괜찮다.
선형성 조건
변환 \(T\)가 정의역의 모든 벡터 \(\mathbf{u}, \mathbf{v}\)와 모든 스칼라 \(c, d\)에 대해
\[T(c\mathbf{u} + d\mathbf{v}) = cT(\mathbf{u}) + dT(\mathbf{v})\]를 만족하면 \(T\)를 선형(linear)이라 한다. 즉 입력을 먼저 선형결합한 뒤 \(T\)를 적용한 결과와, 각 입력에 \(T\)를 먼저 적용한 뒤 같은 가중치로 결합한 결과가 같다. 이 조건 하나에 \(T(\mathbf{u}+\mathbf{v}) = T(\mathbf{u}) + T(\mathbf{v})\)와 \(T(c\mathbf{u}) = cT(\mathbf{u})\)가 모두 들어 있다.
예: \(f(x) = 3x\)는 선형이다. 입력 \(4\)와 \(2\), 가중치 \(2\)와 \(3\)을 쓴다.
- 먼저 결합: \(2 \cdot 4 + 3 \cdot 2 = 14\), 그다음 \(f(14) = 42\).
- 먼저 적용: \(f(4) = 12\), \(f(2) = 6\), 그다음 \(2 \cdot 12 + 3 \cdot 6 = 42\).
두 결과가 같고, 어떤 입력과 가중치에 대해서도 같다.
예: \(f(x) = 3x + 1\)은 선형이 아니다. 같은 입력과 가중치로 계산하면
- 먼저 결합: \(f(14) = 43\).
- 먼저 적용: \(f(4) = 13\), \(f(2) = 7\), \(2 \cdot 13 + 3 \cdot 7 = 47\).
상수항이 선형성을 깨뜨린다. 따라서 \(b \neq 0\)인 직선의 방정식 \(y = ax + b\)는 이 의미에서 선형 함수가 아니다. 원점을 지나는 직선만 선형이다.
좌표 하나를 추가해 \(ax + b\)를 선형으로 만들기
자주 쓰는 방법이 있다. 입력 끝에 상수 \(1\)을 붙여
\[f(x) = 3x + 1 = \begin{bmatrix} 3 & 1 \end{bmatrix} \begin{bmatrix} x \\ 1 \end{bmatrix}\]로 쓴다. 이제 이 함수를 벡터 \((x, 1)\) 전체를 입력으로 받는 \(\mathbb{R}^2 \to \mathbb{R}\) 함수로 보면, 행벡터와 벡터의 곱이므로 선형이다. 입력 \((4, 1)\), \((2, 1)\)과 가중치 \(2, 3\)으로 확인하면, 결합한 입력은 \((14, 5)\)이고 \(3 \cdot 14 + 1 \cdot 5 = 47\)로 \(2 \cdot 13 + 3 \cdot 7 = 47\)과 같다.
앞서 다룬 수명 예측 예제와 연결된다. 몸무게, 키, 흡연 여부의 가중합으로 수명을 예측하는 모델에는 상수항이 없으므로, 그 “직선”은 원점을 지나야 한다. 절편(intercept)을 허용하려면 항상 \(1\)인 특성(feature)을 하나 추가한다. 행렬에 열이 하나 늘고, 그 열에 붙는 가중치가 절편 역할을 한다. 확장된 입력에 대해 모델은 다시 선형이 되고, 절편도 다른 가중치처럼 학습된다.
선형변환의 행렬
이제 정의역과 공역이 벡터의 집합인 \(T : \mathbb{R}^n \to \mathbb{R}^m\)을 생각한다. 정의역은 모든 \(n\)차원 벡터, 공역은 모든 \(m\)차원 벡터다.
몇 개의 상만으로 선형변환이 결정된다
\(T : \mathbb{R}^2 \to \mathbb{R}^3\)이 선형이고, 다음 두 가지 사실만 알려져 있다고 하자.
\[T\left(\begin{bmatrix} 1 \\ 0 \end{bmatrix}\right) = \begin{bmatrix} 2 \\ -1 \\ 1 \end{bmatrix}, \qquad T\left(\begin{bmatrix} 0 \\ 1 \end{bmatrix}\right) = \begin{bmatrix} 0 \\ 1 \\ 2 \end{bmatrix}.\]이것만으로 \(T\)를 완전히 복원할 수 있다. 임의의 \(\mathbf{x} = (x_1, x_2)\)는 위 두 벡터의 선형결합이다.
\[\mathbf{x} = x_1 \begin{bmatrix} 1 \\ 0 \end{bmatrix} + x_2 \begin{bmatrix} 0 \\ 1 \end{bmatrix}.\]선형성에 의해 각 조각에 먼저 \(T\)를 적용해도 된다.
\[T(\mathbf{x}) = x_1 \begin{bmatrix} 2 \\ -1 \\ 1 \end{bmatrix} + x_2 \begin{bmatrix} 0 \\ 1 \\ 2 \end{bmatrix} = \begin{bmatrix} 2 & 0 \\ -1 & 1 \\ 1 & 2 \end{bmatrix} \begin{bmatrix} x_1 \\ x_2 \end{bmatrix}.\]마지막 단계는 행렬-벡터 곱의 열 관점, 즉 열들의 선형결합이다. 무수히 많은 입력-출력 쌍 가운데 두 쌍과 선형성이라는 사실만으로 함수 전체가 정해진다.
선형대수가 왜 벡터와 행렬을 다루는지도 여기서 드러난다. \(\mathbb{R}^n \to \mathbb{R}^m\)의 선형변환은 언제나 행렬과 입력 벡터의 곱으로 쓸 수 있다.
표준기저와 표준행렬
다음 벡터들
\[\mathbf{e}_1 = \begin{bmatrix} 1 \\ 0 \\ \vdots \\ 0 \end{bmatrix}, \quad \mathbf{e}_2 = \begin{bmatrix} 0 \\ 1 \\ \vdots \\ 0 \end{bmatrix}, \quad \dots, \quad \mathbf{e}_n = \begin{bmatrix} 0 \\ 0 \\ \vdots \\ 1 \end{bmatrix}\]은 \(\mathbb{R}^n\)의 가장 단순한 기저이며, 표준기저(standard basis)라 한다.
정리. \(T : \mathbb{R}^n \to \mathbb{R}^m\)이 선형이면, 모든 \(\mathbf{x}\)에 대해 \(T(\mathbf{x}) = A\mathbf{x}\)인 \(m \times n\) 행렬 \(A\)가 유일하게 존재하며
\[A = \begin{bmatrix} T(\mathbf{e}_1) & T(\mathbf{e}_2) & \cdots & T(\mathbf{e}_n) \end{bmatrix}\]이다. 이 \(A\)를 \(T\)의 표준행렬(standard matrix)이라 한다. \(j\)번째 열은 \(j\)번째 표준기저 벡터의 상이다.
예 (\(\mathbb{R}^3 \to \mathbb{R}^2\)). \(T(\mathbf{e}_1) = (1, 2)\), \(T(\mathbf{e}_2) = (3, 4)\), \(T(\mathbf{e}_3) = (5, 6)\)이면
\[A = \begin{bmatrix} 1 & 3 & 5 \\ 2 & 4 & 6 \end{bmatrix}, \qquad T\left(\begin{bmatrix} 1 \\ 1 \\ 1 \end{bmatrix}\right) = \begin{bmatrix} 9 \\ 12 \end{bmatrix}.\]기하학적 그림: 격자가 평행사변형 격자로
\(T(\mathbf{e}_1) = (3, 1)\), \(T(\mathbf{e}_2) = (1, 2)\)인 \(T : \mathbb{R}^2 \to \mathbb{R}^2\)를 보자.
\[A = \begin{bmatrix} 3 & 1 \\ 1 & 2 \end{bmatrix}.\]정의역과 공역을 서로 다른 두 평면으로 그린다. 정의역에서 \(\mathbf{x} = (2, 3)\)은 \(2\mathbf{e}_1\)과 \(3\mathbf{e}_2\)로 만든 평행사변형의 꼭짓점이다. 변환은 \(\mathbf{e}_1\)을 \((3,1)\)로, \(\mathbf{e}_2\)를 \((1,2)\)로 옮기지만 가중치 \(2\)와 \(3\)은 그대로 유지한다.
\[T(\mathbf{x}) = 2\begin{bmatrix} 3 \\ 1 \end{bmatrix} + 3\begin{bmatrix} 1 \\ 2 \end{bmatrix} = \begin{bmatrix} 9 \\ 8 \end{bmatrix}.\]따라서 \(\mathbf{e}_1\), \(\mathbf{e}_2\) 방향의 단위 걸음으로 만든 정의역의 정사각형 격자는, \((3,1)\)과 \((1,2)\) 방향의 걸음으로 만든 똑같은 평행사변형들의 격자로 옮겨진다. 직선은 직선으로, 평행선은 평행선으로 가고, 원점은 고정된다.
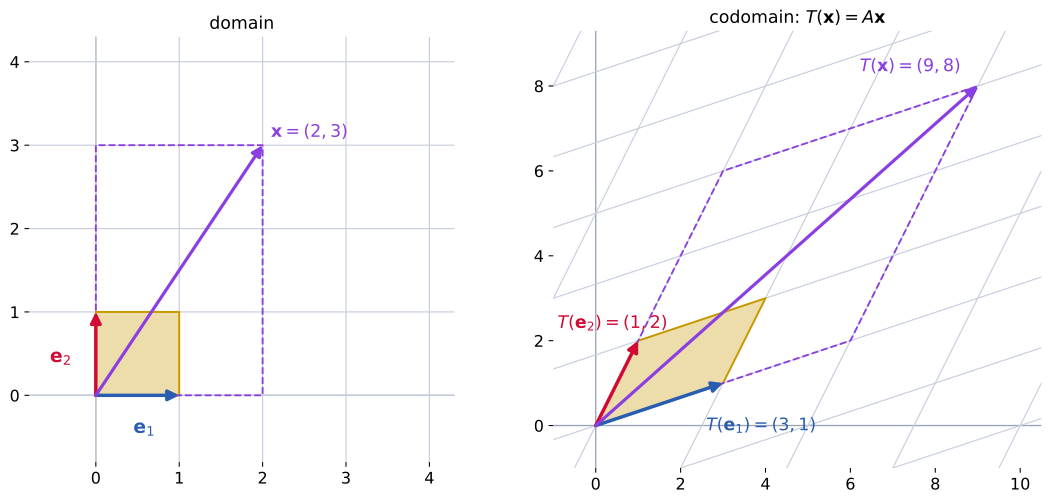 왼쪽 정의역의 정사각형 격자가 오른쪽 공역에서 \((3, 1)\), \((1, 2)\) 방향의 평행사변형 격자가 된다. \(\mathbf{x} = (2, 3)\)은 \((9, 8)\)로 간다.
왼쪽의 노란 단위 정사각형은 \(\mathbf{e}_1\), \(\mathbf{e}_2\)를 두 변으로 한다. 변환 후에는 두 변이 \(A\)의 두 열 \(T(\mathbf{e}_1) = (3, 1)\), \(T(\mathbf{e}_2) = (1, 2)\)로 바뀌고, 정사각형은 오른쪽의 노란 평행사변형이 된다. 나머지 격자 칸도 모두 이 평행사변형과 똑같은 모양으로 옮겨진다.
보라색 점선은 \(\mathbf{x} = 2\mathbf{e}_1 + 3\mathbf{e}_2\)를 만드는 직사각형이다. 오른쪽에서도 같은 가중치 2와 3을 써서 \(T(\mathbf{e}_1)\) 방향으로 두 칸, \(T(\mathbf{e}_2)\) 방향으로 세 칸 가면 \((9, 8)\)에 닿는다. 격자에서 칸 수를 세는 방식이 변환 전후로 그대로 유지된다는 것이 선형성의 기하학적 의미다.
신경망 관점
입력 노드 2개와 출력 노드 2개가 완전히 연결된 레이어는 바로 이런 \(\mathbb{R}^2 \to \mathbb{R}^2\) 사상을 계산한다. 신경망 레이어를 시각화한 잘 알려진 그림들은 정사각형 격자가 레이어를 통과하며 어떻게 변하는지 보여 준다. 행렬 곱은 위와 같이 격자를 평행사변형 격자로 바꾼다. 편향(bias)은 격자 전체를 원점에서 평행이동시킨다. 격자선을 곡선으로 휘게 하는 것은 비선형 활성화 함수(activation function)뿐이다. 선형 부분만으로는 격자를 휠 수 없다.
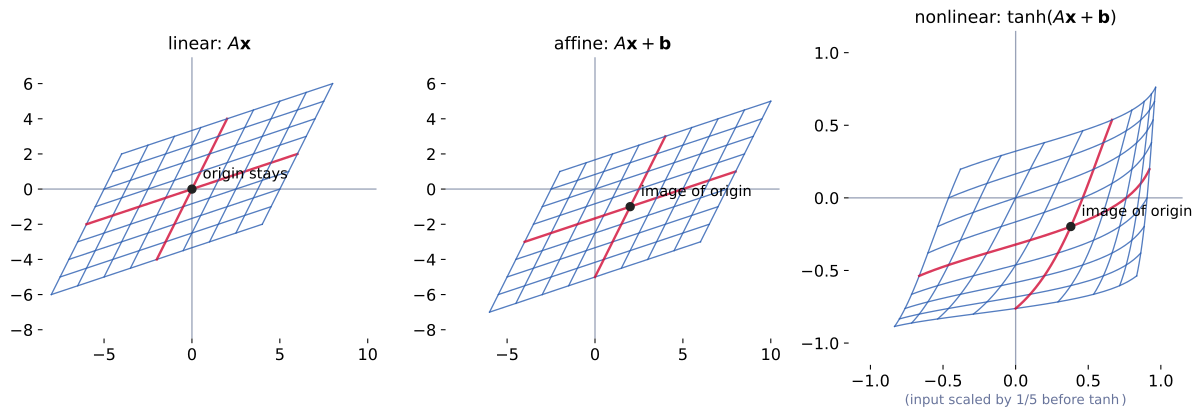 같은 격자(\(-2 \le x_1, x_2 \le 2\))에 같은 \(A\)를 적용한 결과. 편향 \(\mathbf{b} = (2, -1)\)은 격자를 평행이동시키고, \(\tanh\)만 격자를 휜다.
빨간 선은 정의역의 두 좌표축이 옮겨 간 모습이다. 왼쪽의 선형변환에서는 두 축이 원점에서 만나고, 모든 격자선이 곧고 간격이 일정하다. 가운데는 같은 격자를 통째로 \(\mathbf{b} = (2, -1)\)만큼 밀어 놓은 것으로, 모양은 왼쪽과 똑같지만 원점의 상이 \((2, -1)\)로 옮겨졌다.
오른쪽은 가운데 결과의 각 성분에 \(\tanh\)를 적용한 것이다(곡선이 잘 보이도록 먼저 5로 나눴다). 큰 값일수록 \(\pm 1\) 쪽으로 눌리므로 격자선이 곡선이 되고, 가장자리 칸이 안쪽 칸보다 훨씬 작아진다. 행렬 곱과 편향을 아무리 여러 번 겹쳐도 왼쪽이나 가운데 같은 모양만 나오므로, 신경망이 곡선 경계를 만들 수 있는 것은 이 활성화 함수 덕분이다.
신경망의 선형변환
신경망의 기본 레이어는 선형변환(에 편향을 더한 것)이다. 강의는 작은 이미지 분류기로 이를 보여 준다.
작은 분류기
이미지가 \(2 \times 2 = 4\)개의 픽셀만 가진다고 하자. 픽셀 격자를 행 단위로 잘라 한 줄로 이어 붙이면, 이미지 하나가 입력 벡터 \(\mathbf{x} \in \mathbb{R}^4\)가 된다. 사람을 몸무게, 키, 흡연 여부로 나타냈던 것과 같고, 특성이 픽셀값일 뿐이다.
네트워크는 고양이, 강아지, 배 세 클래스 각각의 점수를 출력해야 한다. \(\mathbb{R}^4\)를 \(\mathbb{R}^3\)으로 보내는 레이어 하나는
\[\mathbf{s} = W\mathbf{x} + \mathbf{b}, \qquad W \in \mathbb{R}^{3 \times 4}, \ \mathbf{b} \in \mathbb{R}^{3}\]이다. \(W\)의 각 행과 \(\mathbf{b}\)의 한 성분이 클래스 점수 하나를 만든다. 예를 들어
\[W = \begin{bmatrix} 0.2 & -0.5 & 0.1 & 2.0 \\ 1.5 & 1.3 & 2.1 & 0.0 \\ 0 & 0.25 & 0.2 & -0.3 \end{bmatrix}, \quad \mathbf{x} = \begin{bmatrix} 56 \\ 231 \\ 24 \\ 2 \end{bmatrix}, \quad \mathbf{b} = \begin{bmatrix} 1.1 \\ 3.2 \\ -1.2 \end{bmatrix}\]이면 점수는
\[\mathbf{s} = \begin{bmatrix} -96.8 \\ 437.9 \\ 60.75 \end{bmatrix}\]이다. 이미지가 고양이라면 나쁜 가중치다. 고양이 점수는 매우 낮고 강아지 점수가 가장 높다. 학습은 고양이 이미지에서 고양이 점수가 크고 나머지는 작아지도록 \(W\)와 \(\mathbf{b}\)를 조정한다. 학습 방법(소프트맥스 같은 손실 함수, 경사하강법)은 머신러닝 과목의 내용이다. 여기서 중요한 것은 레이어가 계산하는 함수의 종류다. 각 출력 노드는 입력의 독자적인 선형결합에 상수를 더한 것이고, 각 행은 따로 학습된다.
편향을 추가 열로
앞의 방법으로 편향을 행렬 안에 넣을 수 있다. 입력 끝에 \(1\)을 붙이고 편향 벡터를 마지막 열로 붙인다.
\[W\mathbf{x} + \mathbf{b} = \begin{bmatrix} W & \mathbf{b} \end{bmatrix} \begin{bmatrix} \mathbf{x} \\ 1 \end{bmatrix}.\]엄밀히 말하면 \(\mathbf{b} \neq \mathbf{0}\)일 때 \(\mathbf{x} \mapsto W\mathbf{x} + \mathbf{b}\)는 선형이 아니라 아핀(affine) 사상이다. 이런 레이어를 “선형” 레이어라 부르는 것은 느슨한 표현이다. 상수 특성을 붙이면 같은 계산이 확장된 입력에 대한 진짜 선형 사상이 된다. 어느 쪽이든 레이어는 행렬과 벡터의 곱이고, 학습은 그 행렬의 최적 성분을 찾는 일이다.
전사와 일대일
정의
\(T : \mathbb{R}^n \to \mathbb{R}^m\)에 대해
- 모든 \(\mathbf{b} \in \mathbb{R}^m\)이 적어도 하나의 \(\mathbf{x}\)의 상이면 \(T\)를 \(\mathbb{R}^m\) 위로의 전사(onto)라 한다. 치역이 공역과 같다는 뜻이다. 공역의 모든 원소가 화살을 한 번 이상 맞는다.
- 모든 \(\mathbf{b} \in \mathbb{R}^m\)이 많아야 하나의 \(\mathbf{x}\)의 상이면 \(T\)를 일대일(one-to-one)이라 한다. 화살을 맞지 않은 원소는 상관없다. 화살을 맞은 원소는 정확히 한 번만 맞는다.
원소 개수로 세어 보면 직관이 생긴다. 정의역 원소가 5개, 공역 원소가 8개면 화살은 5개뿐이므로 전사일 수 없다. 정의역 원소가 8개, 공역 원소가 5개면 비둘기집 원리에 의해 어떤 출력은 화살을 두 번 이상 맞으므로 일대일일 수 없다.
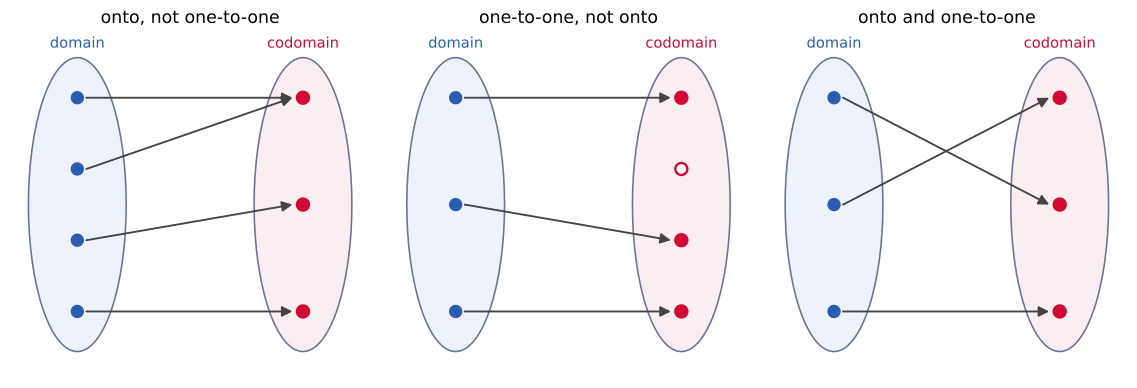 왼쪽: 전사이지만 일대일이 아니다. 가운데: 일대일이지만 전사가 아니다. 오른쪽: 둘 다다.
빨간 점은 화살을 맞은 공역 원소, 속이 빈 점은 맞지 않은 원소다. 왼쪽은 정의역 원소 4개가 공역 원소 3개로 가므로 모든 점이 맞지만, 맨 위 점은 화살을 두 번 맞는다. 가운데는 정의역 원소 3개가 서로 다른 점으로 가서 두 번 맞는 점은 없지만, 공역의 두 번째 점은 한 번도 맞지 않는다.
오른쪽처럼 두 집합의 크기가 같을 때에만 모든 점이 정확히 한 번씩 맞는 대응이 가능하다. 아래의 행렬 판정 조건에서 정사각 행렬만 전사와 일대일을 동시에 만족할 수 있는 것과 같은 이유다.
신경망이 일대일을 원하지 않는 이유
몸무게, 키, 흡연 여부로 수명을 예측하는 문제로 돌아간다. 은닉 노드 하나가 “과체중” 점수
\[h = 2 \cdot \text{weight} - \text{height} + 30\]을 계산한다고 하자. 몸무게 70 kg, 키 170 cm인 사람은 \(h = 140 - 170 + 30 = 0\)이다. 몸무게 80 kg, 키 190 cm인 사람도 \(h = 160 - 190 + 30 = 0\)이다. 서로 다른 두 입력이 같은 값으로 가므로 이 사상은 일대일이 아니다. 그리고 그것이 의도한 바다. 수명 예측에서 중요한 것은 몸무게와 키의 숫자 자체가 아니라 둘의 상대적 균형이다. 마찬가지로 다양한 픽셀 패턴의 고양이 사진은 모두 같은 “고양이” 출력으로 가야 한다. 학습은 같게 취급해야 할 입력들을 의도적으로 한 점으로 모은다.
신경망이 전사를 원하지 않는 이유
학습 데이터의 수명이 모두 대략 55세에서 80세 사이라고 하자. 출력이 모든 실수(음수 나이, 300세)가 될 수 있는 모델은 불가능한 값에 표현력을 낭비한다. 치역이 그럴듯한 구간으로 제한된 모델은 실수 전체 위로의 전사가 아니지만, 그래도 괜찮다. 쓸모 있는 치역은 공역 전체가 아니라 학습 데이터가 정한다.
행렬 변환의 판정 조건
\(A\)가 \(m \times n\) 행렬일 때 \(T(\mathbf{x}) = A\mathbf{x}\)에 대해
- \(T\)가 \(\mathbb{R}^m\) 위로의 전사인 것은 \(A\)의 열들이 \(\mathbb{R}^m\)을 생성(span)하는 것과 동치다.
- \(T\)가 일대일인 것은 \(A\)의 열들이 선형독립인 것, 즉 \(A\mathbf{x} = \mathbf{0}\)이 자명해만 가지는 것과 동치다.
두 번째 조건은 앞 강의들에서 바로 나온다. \(A\mathbf{x} = \mathbf{b}\)를 만족하는 \(\mathbf{x}\)가 몇 개인지 묻는 것은, \(\mathbf{b}\)를 열들의 선형결합으로 쓰는 방법이 몇 가지인지 묻는 것이다. 열들이 선형종속이면 어떤 해에든 \(A\mathbf{x} = \mathbf{0}\)의 비자명해를 더할 수 있으므로 해가 무수히 많고, 사상은 다대일이 된다.
예 (\(\mathbb{R}^2 \to \mathbb{R}^3\)).
\[A = \begin{bmatrix} 2 & 0 \\ -1 & 1 \\ 1 & 2 \end{bmatrix}.\]\(\mathbb{R}^3\)의 벡터 두 개는 많아야 평면을 생성하므로, 치역은 원점을 지나는 평면이고 \(\mathbb{R}^3\) 전체가 아니다. \(T\)는 전사가 아니다. 두 열은 서로의 스칼라배가 아니므로 선형독립이고, 그 평면의 각 점에는 정확히 하나의 \(\mathbf{x}\)가 대응한다. \(T\)는 일대일이다.
예 (\(\mathbb{R}^3 \to \mathbb{R}^2\)).
\[A = \begin{bmatrix} 1 & 4 & 5 \\ 1 & 3 & 6 \end{bmatrix}.\]처음 두 열 \((1,1)\)과 \((4,3)\)은 평행하지 않으므로 이미 \(\mathbb{R}^2\)를 생성한다. \(T\)는 전사다. 그러나 \(\mathbb{R}^2\)의 벡터 세 개는 항상 선형종속이고, 세 번째 열은 새로운 방향을 더하지 못한다. 따라서 각 출력에 무수히 많은 입력이 대응하고, \(T\)는 일대일이 아니다.
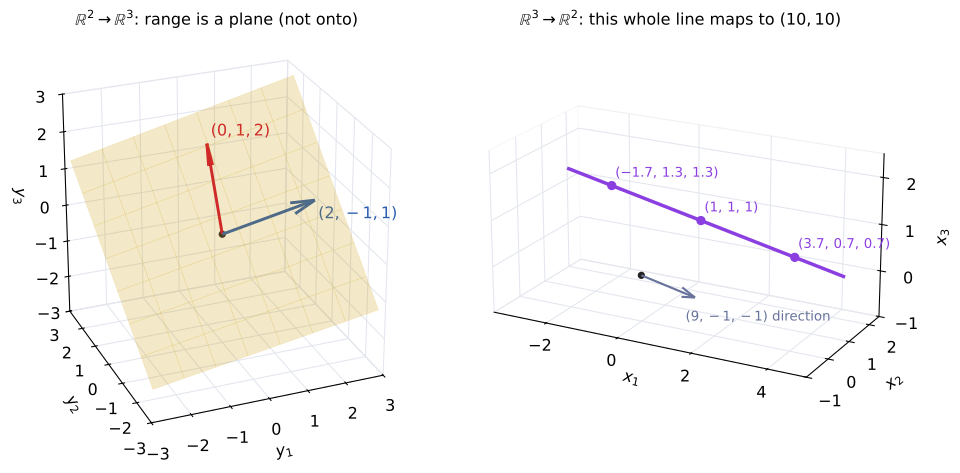 왼쪽: \(\mathbb{R}^2 \to \mathbb{R}^3\) 예의 치역은 두 열이 만드는 평면이다. 오른쪽: \(\mathbb{R}^3 \to \mathbb{R}^2\) 예에서 보라색 직선 위의 모든 점이 \((10, 10)\)으로 간다.
왼쪽 그림의 노란 평면이 \(A\mathbf{x}\)가 닿을 수 있는 전부다. 평면 밖의 \(\mathbb{R}^3\) 점은 화살을 맞지 않으므로 전사가 아니고, 평면 위의 각 점은 두 열 \((2, -1, 1)\), \((0, 1, 2)\)의 유일한 결합이므로 일대일이다.
오른쪽 그림에서 \((1, 1, 1)\)을 넣으면 \(A\mathbf{x} = (1 + 4 + 5,\ 1 + 3 + 6) = (10, 10)\)이다. \(A(9, -1, -1) = (9 - 4 - 5,\ 9 - 3 - 6) = (0, 0)\)이므로, \((1, 1, 1)\)에 \((9, -1, -1)\)의 스칼라배를 더한 점은 모두 같은 출력 \((10, 10)\)을 준다. 그림의 \((-1.7, 1.3, 1.3)\)과 \((3.7, 0.7, 0.7)\)은 각각 \(t = -0.3\), \(t = 0.3\)인 점이다. 3차원의 직선 하나가 2차원의 점 하나로 눌리는 것이 “일대일이 아니다”의 모습이다.
일반적인 패턴은 다음과 같다.
| \(A\)의 모양 | 전사 가능? | 일대일 가능? |
|---|---|---|
| \(m > n\) (세로로 긴) | 불가능 | 열이 독립이면 가능 |
| \(m < n\) (가로로 긴) | 열이 \(\mathbb{R}^m\)을 생성하면 가능 | 불가능 |
| \(m = n\) (정사각) | 가능 | 가능하며, 이때 둘은 함께 성립 |
정리
- 함수는 각 입력에 정확히 하나의 출력을 대응시킨다. 실제로 맞는 출력의 집합인 치역은 공역보다 작을 수 있다.
- \(T(c\mathbf{u} + d\mathbf{v}) = cT(\mathbf{u}) + dT(\mathbf{v})\)이면 \(T\)는 선형이다. \(ax + b\)의 상수항은 선형성을 깨뜨리지만, 상수 특성 \(1\)을 덧붙이면 확장된 입력에 대해 다시 선형이 된다.
- 모든 선형변환 \(T : \mathbb{R}^n \to \mathbb{R}^m\)은 표준행렬 \(A = [T(\mathbf{e}_1) \cdots T(\mathbf{e}_n)]\)에 대해 \(\mathbf{x} \mapsto A\mathbf{x}\)이다. 표준기저 벡터의 상만으로 \(T\)가 완전히 정해진다.
- 평면의 선형변환은 정사각형 격자를 평행사변형 격자로 보낸다. 편향은 격자를 평행이동시키고, 비선형 활성화 함수만이 격자를 휜다.
- 완전연결 레이어는 \(W\mathbf{x} + \mathbf{b}\)를 계산한다. 각 출력 노드는 입력의 선형결합을 따로 학습한다.
- \(A\mathbf{x}\)가 전사인 것은 \(A\)의 열이 \(\mathbb{R}^m\)을 생성하는 것과, 일대일인 것은 열이 선형독립인 것과 동치다.
- 학습된 사상은 의도적으로 일대일이 아니거나(비슷한 입력이 같은 출력으로) 전사가 아닐(출력이 그럴듯한 범위에 머묾) 때가 많다.