- 파이토치 한번에 끝내기 (이수안컴퓨터연구소) 2편 정리
- Colab 노트북
- 코드: 노트북의 각 실습 설명에 맞춰 작성
이 글의 코드는 노트북의 빈 실습 셀 앞에 적힌 설명에 맞춰 작성하고 PyTorch 2.x(CPU)에서 실행한 것이다. 모든 코드는 import torch 이후에 실행한다고 가정한다.
Autograd(자동미분)
torch.autograd 패키지는 텐서의 모든 연산에 대해 자동 미분을 제공한다. PyTorch는 코드가 실행되는 순간 연산 그래프를 만드는 define-by-run 방식이므로, 코드를 어떻게 작성해 실행하느냐에 따라 역전파 경로가 정해진다. 역전파(backpropagation)에 필요한 미분값은 이 그래프를 따라 자동으로 계산된다.
텐서의 requires_grad 속성을 True로 설정하면 그 텐서에서 이루어지는 모든 연산을 추적하기 시작한다. 추적을 중단하려면 .detach()를 호출해 연산 기록으로부터 분리한다.
torch.manual_seed(42)
a = torch.randn(3, 3)
a = a * 3
print(a)
print(a.requires_grad)
tensor([[ 1.0101,  0.3864,  0.7034],
        [ 0.6910, -3.3686, -0.5590],
        [ 6.6246, -1.9140,  1.3850]])
False
직접 만든 텐서는 기본적으로 requires_grad=False이므로 연산이 기록되지 않는다.
requires_grad_(...)는 기존 텐서의 requires_grad 값을 그 자리에서(in-place) 바꾼다. grad_fn에는 이 텐서를 만든 연산, 즉 역전파 때 어떤 함수의 미분을 계산해야 하는지에 대한 정보가 저장된다.
a.requires_grad_(True)
print(a.requires_grad)

b = (a * a).sum()
print(b)
print(b.grad_fn)
True
tensor(63.2684, grad_fn=<SumBackward0>)
<SumBackward0 object at 0x0000029A88090370>
b는 마지막에 sum()으로 만들어졌으므로 grad_fn이 SumBackward0이다. 객체 주소는 실행할 때마다 다르다.
기울기(Gradient)
모든 원소가 1이고 연산을 추적하는 3×3 텐서에서 시작한다.
x = torch.ones(3, 3, requires_grad=True)
print(x)
tensor([[1., 1., 1.],
        [1., 1., 1.],
        [1., 1., 1.]], requires_grad=True)
y = x + 5
print(y)
print(y.grad_fn)
tensor([[6., 6., 6.],
        [6., 6., 6.],
        [6., 6., 6.]], grad_fn=<AddBackward0>)
<AddBackward0 object at 0x0000029A87FEFB50>
y는 연산의 결과로 만들어졌으므로 grad_fn을 갖는다.
z = y * y
out = z.mean()
print(z)
print(out)
tensor([[36., 36., 36.],
        [36., 36., 36.],
        [36., 36., 36.]], grad_fn=<MulBackward0>)
tensor(36., grad_fn=<MeanBackward0>)
계산이 끝난 뒤 .backward()를 호출하면 역전파가 자동으로 계산되고, 그 결과가 각 잎(leaf) 텐서의 .grad 속성에 누적된다.
print(out)
out.backward()
tensor(36., grad_fn=<MeanBackward0>)
grad에는 데이터가 거쳐 온 연산(층)들에 대한 미분값이 저장된다.
print(x)
print(x.grad)
tensor([[1., 1., 1.],
        [1., 1., 1.],
        [1., 1., 1.]], requires_grad=True)
tensor([[1.3333, 1.3333, 1.3333],
        [1.3333, 1.3333, 1.3333],
        [1.3333, 1.3333, 1.3333]])
\(out = \frac{1}{9}\sum_i (x_i + 5)^2\)이므로 \(\frac{\partial out}{\partial x_i} = \frac{2}{9}(x_i + 5)\)이고, \(x_i = 1\)을 넣으면 \(\frac{12}{9} \approx 1.3333\)이다.
출력이 스칼라가 아닐 때는 backward()에 출력과 같은 모양의 벡터 \(v\)를 넘겨야 한다. 이때 계산되는 것은 야코비안(Jacobian) 행렬 \(J\) 전체가 아니라 벡터-야코비안 곱 \(v^T J\)다.
torch.manual_seed(0)
x = torch.randn(3, requires_grad=True)
y = x * 2
while y.norm() < 1000:
    y = y * 2
print(y)
tensor([ 788.9900, -150.2356, -1115.5402], grad_fn=<MulBackward0>)
y의 크기(노름)가 1000을 넘을 때까지 2를 곱했으므로 y는 x에 2의 거듭제곱을 곱한 값이다.
v = torch.tensor([0.1, 1.0, 0.0001], dtype=torch.float)
y.backward(v)
print(x.grad)
tensor([5.1200e+01, 5.1200e+02, 5.1200e-02])
print(x.grad / v)
tensor([512., 512., 512.])
x.grad를 v로 나누면 모두 512가 나온다. 즉 이번 실행에서는 \(y = 512x\)였고, 각 원소의 미분값 512에 v의 가중치가 곱해진 것이다.
with torch.no_grad()로 코드 블록을 감싸면 그 안에서는 연산 기록을 추적하지 않아 기울기가 계산되지 않는다. 기울기 계산은 필요 없지만 requires_grad=True인 학습 가능한 매개변수를 가진 모델을 평가(evaluate)할 때 유용하다.
print(x.requires_grad)
print((x ** 2).requires_grad)

with torch.no_grad():
    print((x ** 2).requires_grad)
True
True
False
같은 연산이라도 no_grad 블록 안에서는 결과가 requires_grad=False가 된다. 기록을 남기지 않으므로 메모리와 계산 시간도 줄어든다.
detach()는 내용물(content)은 같지만 requires_grad가 다른 새 텐서를 가져올 때 쓴다.
print(x.requires_grad)
y = x.detach()
print(y.requires_grad)
print(x.eq(y).all())
True
False
tensor(True)
y는 x와 값이 모두 같지만 연산 그래프에서 떨어져 나왔으므로 이후의 연산이 x의 기울기에 영향을 주지 않는다. y는 x와 메모리를 공유한다는 점도 기억해 둔다.
자동 미분 흐름 예제
계산 흐름이 \(a \rightarrow b \rightarrow c \rightarrow out\)일 때 \(\frac{\partial out}{\partial a}\)를 구한다. backward()로 \(a \leftarrow b \leftarrow c \leftarrow out\) 방향의 역전파를 계산하면 \(\frac{\partial out}{\partial a}\) 값이 a.grad에 채워진다.
a = torch.ones(2, 2)
print(a)
tensor([[1., 1.],
        [1., 1.]])
a = torch.ones(2, 2, requires_grad=True)
print(a)
tensor([[1., 1.],
        [1., 1.]], requires_grad=True)
requires_grad=True로 만들어야 이후 연산이 추적된다.
print(a.data)
print(a.grad)
print(a.grad_fn)
tensor([[1., 1.],
        [1., 1.]])
None
None
아직 backward()를 호출하지 않았으므로 grad는 None이다.
b = a + 2
print(b)
tensor([[3., 3.],
        [3., 3.]], grad_fn=<AddBackward0>)
c = b ** 2
print(c)
tensor([[9., 9.],
        [9., 9.]], grad_fn=<PowBackward0>)
out = c.sum()
print(out)
tensor(36., grad_fn=<SumBackward0>)
out.backward()
print(a.data)
print(a.grad)
print(a.grad_fn)
tensor([[1., 1.],
        [1., 1.]])
tensor([[6., 6.],
        [6., 6.]])
None
연쇄 법칙으로 \(\frac{\partial out}{\partial a} = \frac{\partial out}{\partial c} \cdot \frac{\partial c}{\partial b} \cdot \frac{\partial b}{\partial a} = 1 \cdot 2b \cdot 1 = 2(a + 2) = 6\)이다. a의 grad_fn이 None인 이유는 a가 다른 연산의 결과가 아니라 사용자가 직접 만든 잎 텐서이기 때문이다.
print(b.data)
print(b.grad)
print(b.grad_fn)
tensor([[3., 3.],
        [3., 3.]])
None
<AddBackward0 object at 0x0000029A87075FF0>
b는 중간 결과(잎이 아닌 텐서)이므로 기본적으로 grad가 저장되지 않아 None이며, 이때 PyTorch는 잎이 아닌 텐서의 .grad에 접근했다는 UserWarning도 함께 출력한다. 중간 텐서의 기울기가 필요하면 backward() 전에 b.retain_grad()를 호출한다.
print(c.data)
print(c.grad)
print(c.grad_fn)
tensor([[9., 9.],
        [9., 9.]])
None
<PowBackward0 object at 0x0000029A8977C940>
print(out.data)
print(out.grad)
print(out.grad_fn)
tensor(36.)
None
<SumBackward0 object at 0x0000029A86FF4BE0>
grad_fn을 따라가면 SumBackward0 → PowBackward0 → AddBackward0으로, 순전파의 역순인 역전파 경로가 기록되어 있음을 알 수 있다.
데이터 준비
PyTorch에서는 데이터 준비를 위해 torch.utils.data의 Dataset과 DataLoader를 사용한다.
Dataset으로 다양한 데이터셋(MNIST, FashionMNIST, CIFAR10 등)을 쓸 수 있다.- Vision Dataset: https://pytorch.org/vision/stable/datasets.html
- Text Dataset: https://pytorch.org/text/stable/datasets.html
- Audio Dataset: https://pytorch.org/audio/stable/datasets.html
Dataset과DataLoader에batch_size,train여부,transform등을 인자로 넣어 데이터를 어떻게 불러올지 정한다.
from torch.utils.data import Dataset, DataLoader
토치비전(torchvision)은 PyTorch에서 제공하는 비전용 데이터셋, 모델, 변환이 모여 있는 패키지다. transforms는 전처리에 쓰는 클래스들을 제공하며(문서), 여기서 제공하지 않는 전처리는 보통 클래스를 따로 만들어 진행한다.
import torchvision.transforms as transforms
from torchvision import datasets
DataLoader에 넘길 데이터셋의 transform은 미리 정의해 둘 수 있으며, Compose로 리스트 안의 전처리를 순서대로 적용한다.
ToTensor()가 필요한 이유는 torchvision 데이터셋이 이미지를 PIL Image 형태로 돌려주기 때문이다. ToTensor()는 PIL Image(또는 NumPy 배열)를 (C, H, W) 모양의 float32 텐서로 바꾸고 픽셀 값을 \([0, 255]\)에서 \([0, 1]\)로 조정한다. 이어지는 Normalize(mean, std)는 각 채널에 \((x - mean) / std\)를 적용한다.
mnist_transform = transforms.Compose([
    transforms.ToTensor(),
    transforms.Normalize(mean=(0.5,), std=(1.0,))
])
trainset = datasets.MNIST(root="./data", train=True, download=True, transform=mnist_transform)
testset = datasets.MNIST(root="./data", train=False, download=True, transform=mnist_transform)
print(len(trainset), len(testset))
60000 10000
MNIST는 28×28 흑백 손글씨 숫자 이미지로, 학습용 60,000장과 테스트용 10,000장으로 나뉜다. train 인자로 어느 쪽을 받을지 정한다.
DataLoader는 데이터 전체를 보관했다가 실제로 모델을 학습할 때 batch_size 크기만큼씩 데이터를 꺼내 준다.
train_loader = DataLoader(trainset, batch_size=8, shuffle=True, num_workers=2)
test_loader = DataLoader(testset, batch_size=8, shuffle=False, num_workers=2)
학습 데이터는 에포크마다 순서를 섞고(shuffle=True), 테스트 데이터는 섞지 않는다. num_workers는 데이터를 불러오는 보조 프로세스 수다.
torch.manual_seed(42)
dataiter = iter(train_loader)
images, labels = next(dataiter)
print(images.shape)
print(labels.shape)
print(labels)
torch.Size([8, 1, 28, 28])
torch.Size([8])
tensor([1, 2, 8, 5, 2, 6, 9, 9])
배치 하나는 (배치 크기, 채널, 높이, 너비) = (8, 1, 28, 28) 모양의 이미지와 8개의 정답 레이블로 이루어진다. 섞기 때문에 레이블은 실행할 때마다 달라진다.
torch_image = torch.squeeze(images[0])
print(torch_image.shape)
print(torch_image.min(), torch_image.max())
torch.Size([28, 28])
tensor(-0.5000) tensor(0.4961)
채널 축을 squeeze로 없애 2차원 이미지로 만들었다. Normalize(mean=0.5, std=1.0) 때문에 값의 범위가 \([0, 1]\)에서 \([-0.5, 0.5]\)로 옮겨졌다.
import matplotlib.pyplot as plt

figure = plt.figure(figsize=(12, 3))
for i in range(8):
    figure.add_subplot(1, 8, i + 1)
    plt.title(labels[i].item())
    plt.axis("off")
    plt.imshow(images[i].squeeze(), cmap="gray")
plt.show()
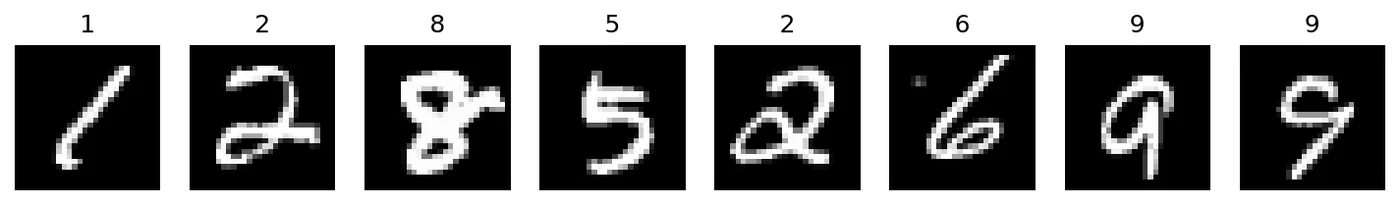 위 코드로 그린 첫 번째 배치의 이미지 8장과 레이블(1, 2, 8, 5, 2, 6, 9, 9). 코드 실행 결과.
신경망 구성
- 레이어(layer): 신경망의 핵심 데이터 구조로, 하나 이상의 텐서를 입력받아 하나 이상의 텐서를 출력한다.
- 모듈(module): 한 개 이상의 층이 모여 구성된다.
- 모델(model): 한 개 이상의 모듈이 모여 구성된다.
torch.nn 패키지
torch.nn은 가중치(weight)와 편향(bias)이 내부에서 자동으로 생성되는 층들을 쓸 때 사용한다. 가중치를 직접 선언할 필요가 없다.
import torch.nn as nn
nn.Linear 층 예제다. 입력의 마지막 차원이 in_features와 같아야 하며, 출력의 마지막 차원은 out_features가 된다.
input = torch.randn(128, 20)
m = nn.Linear(20, 30)
output = m(input)
print(output.size())
torch.Size([128, 30])
nn.Conv2d 층 예시다. 입력은 (N, C, H, W) = (20, 16, 50, 100)이고, 커널 크기, 스트라이드, 패딩, 팽창(dilation)에 따라 출력의 높이와 너비가 달라진다.
input = torch.randn(20, 16, 50, 100)
m = nn.Conv2d(16, 33, 3, stride=2)
print(m(input).shape)
torch.Size([20, 33, 24, 49])
m = nn.Conv2d(16, 33, (3, 5), stride=(2, 1), padding=(4, 2))
print(m(input).shape)
torch.Size([20, 33, 28, 100])
m = nn.Conv2d(16, 33, (3, 5), stride=(2, 1), padding=(4, 2), dilation=(3, 1))
print(m(input).shape)
torch.Size([20, 33, 26, 100])
출력 크기는 각 축마다 \(\lfloor (H + 2P - D(K - 1) - 1) / S \rfloor + 1\)로 계산된다. 예를 들어 첫 번째 예의 높이는 \(\lfloor (50 - 2 - 1)/2 \rfloor + 1 = 24\)이고, 세 번째 예의 높이는 \(\lfloor (50 + 8 - 6 - 1)/2 \rfloor + 1 = 26\)이다.
컨볼루션 레이어(Convolution Layers)
nn.Conv2d의 주요 인자는 다음과 같다.
in_channels: 입력 채널의 개수out_channels: 출력 채널의 개수(필터 수)kernel_size: 커널(필터) 크기
print(nn.Conv2d(in_channels=1, out_channels=20, kernel_size=5, stride=1))
Conv2d(1, 20, kernel_size=(5, 5), stride=(1, 1))
torch.manual_seed(42)
layer = nn.Conv2d(1, 20, 5, 1).to(torch.device("cpu"))
print(layer)
Conv2d(1, 20, kernel_size=(5, 5), stride=(1, 1))
인자 이름을 생략하면 in_channels, out_channels, kernel_size, stride 순서로 해석된다.
weight를 확인한다.
weight = layer.weight
print(weight.shape)
torch.Size([20, 1, 5, 5])
가중치의 모양은 (out_channels, in_channels, kernel_h, kernel_w)이다. 1채널 입력에 대한 5×5 필터가 20개 있다.
weight는 학습 대상이라 requires_grad=True이므로, detach()로 연산 그래프에서 떼어 내야 numpy()로 변환할 수 있다.
weight.numpy()
RuntimeError: Can't call numpy() on Tensor that requires grad. Use tensor.detach().numpy() instead.
weight = weight.detach().numpy()
print(weight.shape)
(20, 1, 5, 5)
앞에서 불러온 MNIST 배치의 첫 이미지에 이 층을 적용한다. 층은 배치 차원이 있는 4차원 입력을 받으므로 unsqueeze로 차원을 하나 추가한다.
print(images.shape)
input_image = torch.unsqueeze(images[0], dim=0)
print(input_image.shape)
torch.Size([8, 1, 28, 28])
torch.Size([1, 1, 28, 28])
output_data = layer(input_image)
print(output_data.shape)
torch.Size([1, 20, 24, 24])
패딩 없이 5×5 필터를 적용했으므로 28×28이 \(28 - 5 + 1 = 24\), 즉 24×24가 되고, 필터 20개가 20개의 채널(특성 맵)을 만든다.
output = output_data.data
output_arr = output.numpy()
print(output_arr.shape)
(1, 20, 24, 24)
.data는 그래프에서 떨어진 텐서를 돌려주므로 바로 numpy()로 바꿀 수 있다. 다만 현재는 같은 목적에 detach()를 쓰는 것이 권장된다.
풀링 레이어(Pooling layers)
함수형 F.max_pool2d는 kernel_size와 stride를 받아 영역마다 최댓값만 남긴다. 같은 기능의 층 클래스 torch.nn.MaxPool2d도 많이 쓴다.
import torch.nn.functional as F
pool = F.max_pool2d(output, 2, 2)
print(pool.shape)
torch.Size([1, 20, 12, 12])
2×2 영역을 2칸씩 이동하며 최댓값을 뽑으므로 24×24가 12×12로 절반이 된다. 채널 수는 그대로다.
MaxPool 층은 학습할 가중치가 없으므로 결과를 바로 numpy()로 변환할 수 있다.
pool_arr = pool.numpy()
print(pool_arr.shape)
(1, 20, 12, 12)
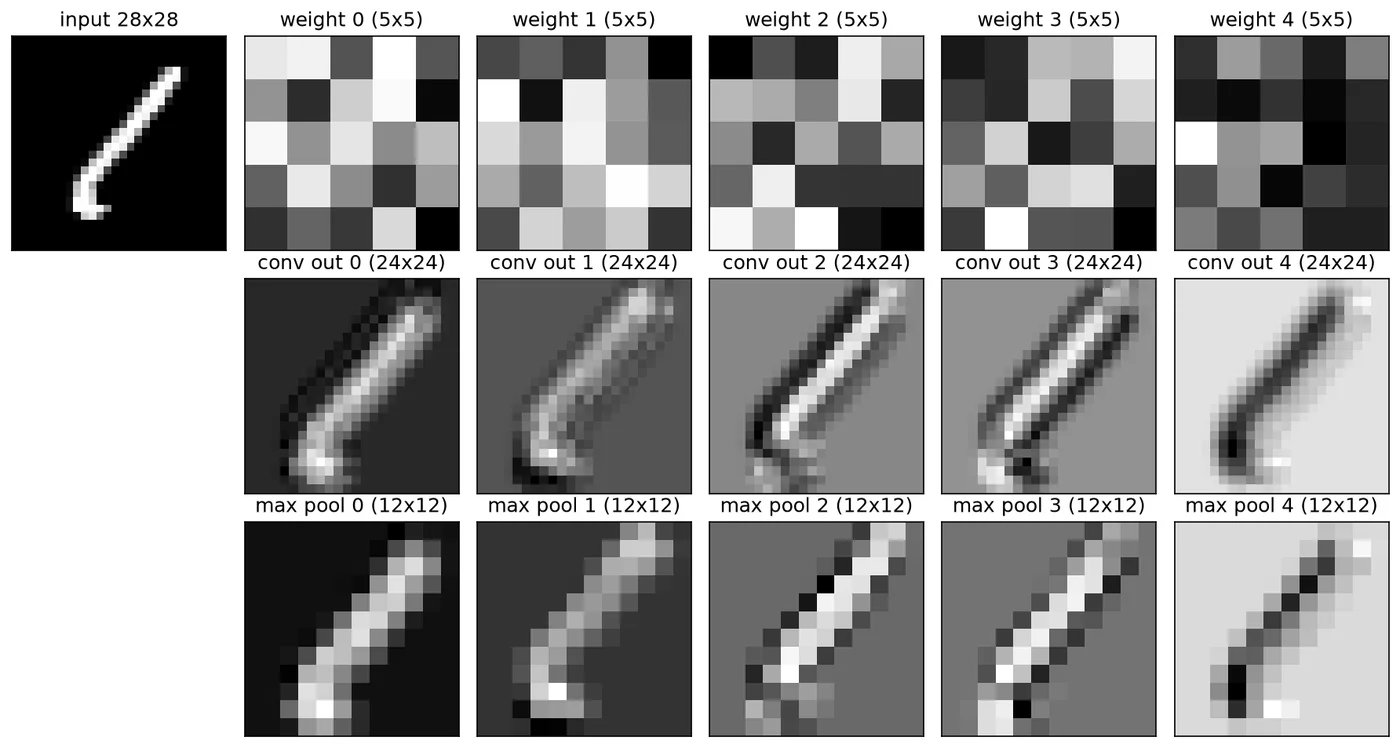 입력 이미지(숫자 1)와 무작위로 초기화된 5×5 필터 5개(첫 행), 각 필터의 합성곱 결과 24×24(둘째 행), 그 결과에 2×2 최대 풀링을 적용한 12×12(셋째 행). 위 코드의
weight, output_arr, pool_arr를 matplotlib으로 그렸다. 코드 실행 결과.
학습 전의 무작위 필터인데도 각 필터가 획의 서로 다른 가장자리나 방향에 반응하고, 풀링 후에도 숫자의 형태가 대략 유지된다.
선형 레이어(Linear layers)
선형 층은 마지막 차원에 대해 계산하므로, 이미지를 넣으려면 .view()로 1차원(배치 차원을 빼고)으로 펼쳐야 한다.
flatten = input_image.view(1, 28 * 28)
print(flatten.shape)
torch.Size([1, 784])
torch.manual_seed(42)
lin = nn.Linear(784, 10)(flatten)
print(lin.shape)
torch.Size([1, 10])
784개의 픽셀 값이 10개의 값으로 바뀌었다. MNIST의 10개 클래스 각각에 대한 점수로 쓸 수 있는 모양이다.
print(lin)
tensor([[ 0.2236, -0.0835, -0.0103, -0.0423,  0.5159, -0.0810, -0.6533, -0.2611,
         -0.3230,  0.2713]], grad_fn=<AddmmBackward0>)
층의 가중치가 학습 대상이므로 결과에 grad_fn이 붙는다. 이 상태에서 numpy()를 부르려면 역시 detach()가 필요하다.
비선형 활성화(Non-linear Activations)
F.softmax 같은 활성화 함수를 적용한다. 소프트맥스는 점수를 합이 1인 확률 분포로 바꾼다.
with torch.no_grad():
    flatten = input_image.view(1, 28 * 28)
    lin = nn.Linear(784, 10)(flatten)
    softmax = F.softmax(lin, dim=1)
print(softmax)
tensor([[0.0753, 0.0601, 0.1044, 0.1524, 0.0902, 0.1475, 0.0889, 0.0987, 0.1073,
         0.0751]])
import numpy as np
print(np.sum(softmax.numpy()))
1.0
no_grad 블록 안에서 계산했으므로 grad_fn이 없고 바로 numpy()로 바꿀 수 있다. 확률의 합이 1임을 확인할 수 있다.
F.relu는 ReLU 함수 \(\max(0, x)\)를 적용하며, 층 클래스 nn.ReLU로도 쓸 수 있다.
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
inputs = torch.randn(4, 3, 28, 28).to(device)
print(inputs.shape)
torch.Size([4, 3, 28, 28])
layer = nn.Conv2d(3, 20, 5, 1).to(device)
output = F.relu(layer(inputs))
print(output.shape)
print(output.min())
torch.Size([4, 20, 24, 24])
tensor(0., grad_fn=<MinBackward1>)
ReLU는 음수를 모두 0으로 바꾸므로 최솟값이 0이다. 모양은 바뀌지 않는다.
신경망 종류
노트북은 이 절에서 Asimov Institute의 “A mostly complete chart of Neural Networks”(Fjodor van Veen, Stefan Leijnen, 2019) 그림으로 다양한 신경망 구조를 소개한다. 퍼셉트론과 피드포워드 신경망(FF, DFF), 순환 신경망 계열(RNN, LSTM, GRU), 오토인코더 계열(AE, VAE, DAE, SAE), 합성곱 신경망(DCN)과 역합성곱 신경망(DN), 생성적 적대 신경망(GAN), 잔차 신경망(DRN), 어텐션 네트워크(AN) 등이 입력, 은닉, 출력, 순환, 메모리, 합성곱 셀의 연결 방식으로 그려져 있다. 원본은 The Neural Network Zoo에서 볼 수 있다.
정리
requires_grad=True인 텐서의 연산은 그래프로 기록되고,backward()를 호출하면 잎 텐서의.grad에 기울기가 누적된다. 중간 텐서는grad_fn만 갖는다.- 출력이 스칼라가 아니면
backward(v)로 벡터-야코비안 곱을 계산한다. - 평가 단계에서는
torch.no_grad()로 기록을 끄고, 값만 필요할 때는detach()로 그래프에서 분리한다. transforms.Compose로 전처리를 묶어Dataset에 넘기고,DataLoader가batch_size만큼 데이터를 꺼내 준다. MNIST 배치는(N, 1, 28, 28)모양이다.nn.Conv2d의 가중치는(out, in, kH, kW)모양이며, 출력 크기는 커널, 스트라이드, 패딩, 팽창으로 정해진다. 최대 풀링은 크기를 줄이고 채널은 유지한다.- 선형 층에 넣기 전에
view로 펼치고,softmax로 확률을,relu로 비선형성을 더한다.