- 파이토치 한번에 끝내기 (이수안컴퓨터연구소) 4편 정리
- Colab 노트북
- 코드: 노트북의 각 실습 설명에 맞춰 작성
이 글의 코드는 노트북의 빈 실습 셀 앞에 적힌 제목에 맞춰 작성하고 PyTorch 2.x(CPU)에서 실행한 것이다. 앞의 글에서 정리한 모델 정의, 손실 함수, 옵티마이저를 하나의 학습 과정으로 묶는다.
선형 회귀 모델(Linear Regression Model)
데이터 생성
\(y = x\) 직선 주변에 잡음을 더한 데이터 200개를 만든다.
import torch
import torch.nn as nn
import torch.optim as optim
import matplotlib.pyplot as plt

torch.manual_seed(42)
X = torch.randn(200, 1) * 10
y = X + 3 * torch.randn(200, 1)
print(X.shape, y.shape)
torch.Size([200, 1]) torch.Size([200, 1])
X는 표준편차 10인 정규분포에서 뽑고, y에는 표준편차 3인 잡음을 더했다. 따라서 모델이 찾아야 할 정답은 기울기 1, 절편 0에 가까운 직선이다. nn.Linear가 (샘플 수, 특성 수) 모양을 받으므로 (200, 1)로 만든다.
모델 정의 및 파라미터
class LinearRegressionModel(nn.Module):
    def __init__(self):
        super(LinearRegressionModel, self).__init__()
        self.linear = nn.Linear(1, 1)

    def forward(self, x):
        pred = self.linear(x)
        return pred
입력 하나, 출력 하나인 선형 층이 곧 \(\hat{y} = wx + b\)다.
torch.manual_seed(111)
model = LinearRegressionModel()
print(model)
print(list(model.parameters()))
LinearRegressionModel(
  (linear): Linear(in_features=1, out_features=1, bias=True)
)
[Parameter containing:
tensor([[0.4311]], requires_grad=True), Parameter containing:
tensor([0.8280], requires_grad=True)]
가중치 w와 편향 b가 무작위로 초기화되어 있으며, 둘 다 requires_grad=True인 Parameter다.
학습 전후를 비교하기 위해 파라미터를 파이썬 숫자로 꺼내는 함수를 만들고, 초기 모델의 직선을 계산해 둔다.
w, b = model.parameters()

def get_params():
    return w[0][0].item(), b[0].item()

w1, b1 = get_params()
print(w1, b1)
x1 = torch.linspace(-30, 30, 100)
init_line = w1 * x1 + b1
0.43113183975219727 0.8279852867126465
model.parameters()가 돌려주는 순서는 층에 정의된 순서(가중치, 편향)다. 가중치는 (1, 1), 편향은 (1,) 모양이므로 각각 w[0][0], b[0]으로 꺼낸다.
손실 함수 및 옵티마이저
criterion = nn.MSELoss()
optimizer = optim.SGD(model.parameters(), lr=0.001)
회귀 문제이므로 평균 제곱 오차(MSE)를 손실로, 확률적 경사 하강법(SGD)을 옵티마이저로 쓴다.
모델 학습
학습 루프는 매 에포크마다 기울기 초기화, 예측, 손실 계산, 역전파, 파라미터 갱신을 반복한다.
epochs = 100
losses = []
for epoch in range(epochs):
    optimizer.zero_grad()

    y_pred = model(X)
    loss = criterion(y_pred, y)
    losses.append(loss.item())
    loss.backward()

    optimizer.step()

    if (epoch + 1) % 10 == 0:
        print(f"epoch {epoch + 1:3d}  loss {loss.item():.4f}")
epoch  10  loss 8.3485
epoch  20  loss 7.6578
epoch  30  loss 7.6412
epoch  40  loss 7.6342
epoch  50  loss 7.6276
epoch  60  loss 7.6213
epoch  70  loss 7.6153
epoch  80  loss 7.6094
epoch  90  loss 7.6038
epoch 100  loss 7.5985
데이터 200개를 한 번에 넣는 전체 배치 학습이다. 손실은 처음 몇 에포크 동안 급격히 줄어든 뒤 약 7.6에서 거의 멈춘다. 잡음의 분산이 \(3^2 = 9\) 정도이므로 그 아래로는 크게 줄어들 수 없다.
w1, b1 = get_params()
print(w1, b1)
1.0127537250518799 0.7505325078964233
기울기는 정답인 1에 가깝게 학습되었다. 편향은 0.83에서 0.75로 조금만 움직였는데, x의 값이 커서 기울기에 대한 경사가 훨씬 크고 학습률이 작기 때문에 편향은 천천히 수렴한다.
fig, axes = plt.subplots(1, 2, figsize=(12, 4.5))
axes[0].scatter(X.numpy(), y.numpy(), s=10, alpha=0.6, label="data")
axes[0].plot(x1.numpy(), init_line.numpy(), "r--", label="initial model")
axes[0].plot(x1.numpy(), (w1 * x1 + b1).numpy(), "g-", label="trained model")
axes[0].legend()
axes[1].plot(range(epochs), losses)
axes[1].set_xlabel("epoch")
axes[1].set_ylabel("MSE loss")
plt.show()
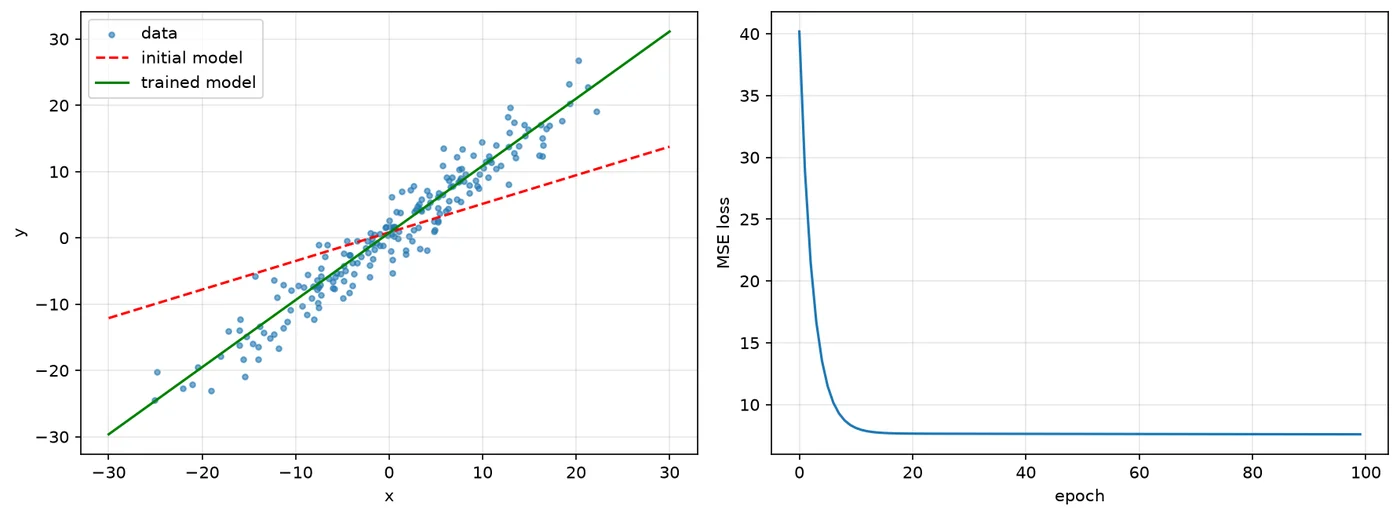 왼쪽: 데이터(파란 점), 학습 전 직선(빨간 점선, 기울기 0.43), 학습 후 직선(초록 실선, 기울기 1.01). 오른쪽: 에포크별 MSE 손실로, 약 40에서 시작해 20 에포크 안에 7.6 근처로 떨어진다. 코드 실행 결과.
FashionMNIST 분류 모델
GPU를 쓸 수 있으면 GPU를, 아니면 CPU를 쓰도록 설정한다.
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
print(device)
cpu
GPU가 있는 Colab에서는 cuda가 출력된다. 아래 결과는 CPU에서 실행한 것이다.
데이터 로드
from torch.utils.data import DataLoader
import torchvision.transforms as transforms
from torchvision import datasets
transform = transforms.Compose([
    transforms.ToTensor(),
    transforms.Normalize((0.5,), (0.5,))
])
ToTensor()로 \([0, 1]\) 범위가 된 픽셀 값을 Normalize((0.5,), (0.5,))가 \((x - 0.5)/0.5\)로 바꿔 \([-1, 1]\) 범위로 만든다.
trainset = datasets.FashionMNIST(root="./data", train=True, download=True, transform=transform)
testset = datasets.FashionMNIST(root="./data", train=False, download=True, transform=transform)
print(len(trainset), len(testset))
60000 10000
FashionMNIST는 MNIST와 같은 28×28 흑백, 학습 60,000장, 테스트 10,000장 구성이지만, 숫자 대신 옷, 신발, 가방 등 10가지 패션 상품 이미지로 이루어져 있어 MNIST보다 조금 어렵다.
torch.manual_seed(42)
train_loader = DataLoader(trainset, batch_size=128, shuffle=True, num_workers=2)
test_loader = DataLoader(testset, batch_size=128, shuffle=False, num_workers=2)
images, labels = next(iter(train_loader))
print(images.shape, labels.shape)
torch.Size([128, 1, 28, 28]) torch.Size([128])
labels_map = {
    0: "T-Shirt", 1: "Trouser", 2: "Pullover", 3: "Dress", 4: "Coat",
    5: "Sandal", 6: "Shirt", 7: "Sneaker", 8: "Bag", 9: "Ankle Boot",
}

figure = plt.figure(figsize=(12, 12))
cols, rows = 4, 4
for i in range(1, cols * rows + 1):
    image = images[i].squeeze()
    label_idx = labels[i].item()
    label = labels_map[label_idx]

    figure.add_subplot(rows, cols, i)
    plt.title(label)
    plt.axis("off")
    plt.imshow(image, cmap="gray")
plt.show()
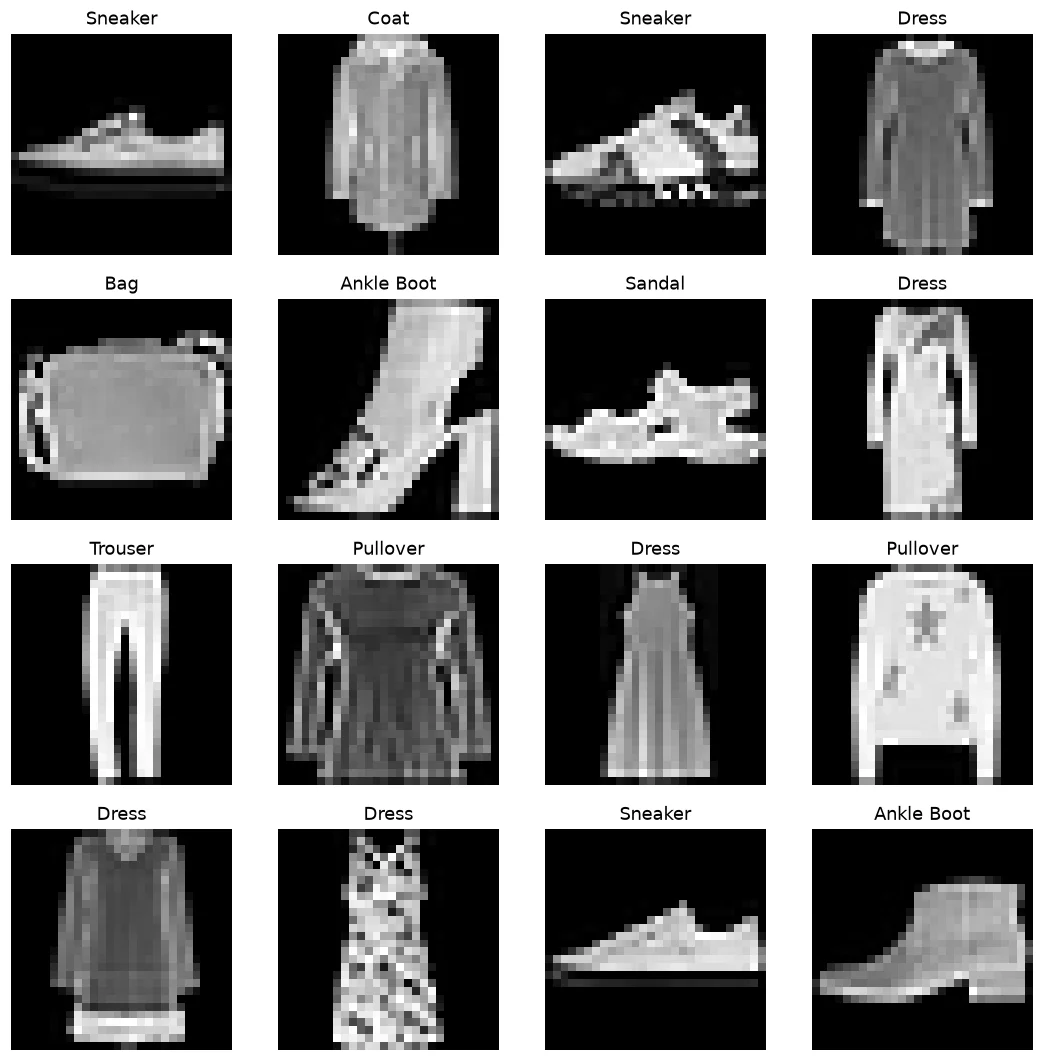 첫 번째 학습 배치에서 뽑은 16장과 레이블. 운동화(Sneaker), 코트(Coat), 드레스(Dress), 가방(Bag), 앵클 부츠(Ankle Boot), 샌들(Sandal), 바지(Trouser), 풀오버(Pullover)가 보인다. 코드 실행 결과.
레이블은 0부터 9까지의 정수이므로 labels_map으로 이름을 붙여 확인한다.
모델 정의 및 파라미터
합성곱 층 2개와 완전연결 층 3개로 이루어진 LeNet 형태의 작은 CNN이다.
import torch.nn.functional as F

class NeuralNet(nn.Module):
    def __init__(self):
        super(NeuralNet, self).__init__()
        self.conv1 = nn.Conv2d(1, 6, 3)
        self.conv2 = nn.Conv2d(6, 16, 3)
        self.fc1 = nn.Linear(16 * 5 * 5, 120)
        self.fc2 = nn.Linear(120, 84)
        self.fc3 = nn.Linear(84, 10)

    def forward(self, x):
        x = F.max_pool2d(F.relu(self.conv1(x)), (2, 2))
        x = F.max_pool2d(F.relu(self.conv2(x)), 2)
        x = x.view(-1, self.num_flat_features(x))
        x = F.relu(self.fc1(x))
        x = F.relu(self.fc2(x))
        x = self.fc3(x)
        return x

    def num_flat_features(self, x):
        size = x.size()[1:]
        num_features = 1
        for s in size:
            num_features *= s
        return num_features

torch.manual_seed(42)
net = NeuralNet().to(device)
print(net)
NeuralNet(
  (conv1): Conv2d(1, 6, kernel_size=(3, 3), stride=(1, 1))
  (conv2): Conv2d(6, 16, kernel_size=(3, 3), stride=(1, 1))
  (fc1): Linear(in_features=400, out_features=120, bias=True)
  (fc2): Linear(in_features=120, out_features=84, bias=True)
  (fc3): Linear(in_features=84, out_features=10, bias=True)
)
크기 변화는 28 → (3×3 합성곱) 26 → (풀링) 13 → (3×3 합성곱) 11 → (풀링) 5이므로, 펼친 특성 수는 \(16 \times 5 \times 5 = 400\)이다. num_flat_features()는 배치 차원을 뺀 나머지 차원의 크기를 곱해 이 값을 계산한다. 마지막 층은 활성화 없이 10개 클래스의 점수(logit)를 낸다.
params = list(net.parameters())
print(len(params))
print(params[0].size())
10
torch.Size([6, 1, 3, 3])
층 5개가 각각 가중치와 편향을 가지므로 파라미터 텐서는 10개다. 첫 번째는 conv1의 가중치로, 1채널 입력에 대한 3×3 필터 6개다.
input = torch.randn(1, 1, 28, 28).to(device)
out = net(input)
print(out)
tensor([[ 0.0531, -0.0757,  0.0993,  0.0926, -0.0763, -0.0470,  0.0306, -0.0319,
          0.0082, -0.0508]], grad_fn=<AddmmBackward0>)
무작위 입력 한 장으로 순전파가 오류 없이 동작하는지, 출력이 (1, 10)인지 확인했다. 학습 전이므로 점수들이 0 근처에 고르게 퍼져 있다.
손실함수와 옵티마이저
criterion = nn.CrossEntropyLoss()
optimizer = optim.SGD(net.parameters(), lr=0.001, momentum=0.9)
다중 클래스 분류이므로 CrossEntropyLoss를 쓰며, 모델 출력에 소프트맥스를 따로 적용하지 않는다. 옵티마이저는 모멘텀 0.9의 SGD다.
모델 학습
배치 수를 확인한다.
total_batch = len(train_loader)
print(total_batch)
469
60,000장을 128장씩 나누면 \(\lceil 60000 / 128 \rceil = 469\)개 배치가 된다. 마지막 배치는 96장이다.
for epoch in range(10):
    running_loss = 0.0
    for i, data in enumerate(train_loader, 0):
        inputs, labels = data
        inputs, labels = inputs.to(device), labels.to(device)

        optimizer.zero_grad()

        outputs = net(inputs)
        loss = criterion(outputs, labels)
        loss.backward()
        optimizer.step()

        running_loss += loss.item()
        if i % 100 == 99:
            print(f"Epoch: {epoch + 1}, Iter: {i + 1}, Loss: {running_loss / 100:.3f}")
            running_loss = 0.0
Epoch: 1, Iter: 100, Loss: 2.303
Epoch: 1, Iter: 200, Loss: 2.292
Epoch: 1, Iter: 300, Loss: 2.279
Epoch: 1, Iter: 400, Loss: 2.254
Epoch: 2, Iter: 100, Loss: 2.076
Epoch: 2, Iter: 200, Loss: 1.658
Epoch: 2, Iter: 300, Loss: 1.248
Epoch: 2, Iter: 400, Loss: 1.032
Epoch: 3, Iter: 100, Loss: 0.882
Epoch: 3, Iter: 200, Loss: 0.834
Epoch: 3, Iter: 300, Loss: 0.798
Epoch: 3, Iter: 400, Loss: 0.764
Epoch: 4, Iter: 100, Loss: 0.728
Epoch: 4, Iter: 200, Loss: 0.697
Epoch: 4, Iter: 300, Loss: 0.684
Epoch: 4, Iter: 400, Loss: 0.670
Epoch: 5, Iter: 100, Loss: 0.648
Epoch: 5, Iter: 200, Loss: 0.632
Epoch: 5, Iter: 300, Loss: 0.626
Epoch: 5, Iter: 400, Loss: 0.604
Epoch: 6, Iter: 100, Loss: 0.604
Epoch: 6, Iter: 200, Loss: 0.591
Epoch: 6, Iter: 300, Loss: 0.572
Epoch: 6, Iter: 400, Loss: 0.568
Epoch: 7, Iter: 100, Loss: 0.560
Epoch: 7, Iter: 200, Loss: 0.553
Epoch: 7, Iter: 300, Loss: 0.553
Epoch: 7, Iter: 400, Loss: 0.539
Epoch: 8, Iter: 100, Loss: 0.540
Epoch: 8, Iter: 200, Loss: 0.531
Epoch: 8, Iter: 300, Loss: 0.524
Epoch: 8, Iter: 400, Loss: 0.518
Epoch: 9, Iter: 100, Loss: 0.502
Epoch: 9, Iter: 200, Loss: 0.516
Epoch: 9, Iter: 300, Loss: 0.505
Epoch: 9, Iter: 400, Loss: 0.504
Epoch: 10, Iter: 100, Loss: 0.499
Epoch: 10, Iter: 200, Loss: 0.495
Epoch: 10, Iter: 300, Loss: 0.495
Epoch: 10, Iter: 400, Loss: 0.470
100개 배치마다 평균 손실을 출력했다. 첫 에포크의 손실 2.30은 10개 클래스를 무작위로 맞힐 때의 값 \(\ln 10 \approx 2.303\)과 같다. 학습률이 작아 첫 에포크에는 거의 줄지 않다가, 둘째 에포크부터 빠르게 줄어 10 에포크 후에는 약 0.47이 된다. CPU에서 10 에포크에 2분 정도 걸렸다.
모델의 저장 및 로드
torch.save:net.state_dict()를 저장한다.state_dict는 층 이름을 키로, 파라미터 텐서를 값으로 갖는 딕셔너리다.torch.load: 저장한 딕셔너리를 불러온 뒤, 모델의load_state_dict로 적용한다.
PATH = "./fashion_mnist.pth"
torch.save(net.state_dict(), PATH)
net = NeuralNet().to(device)
print(net.load_state_dict(torch.load(PATH, weights_only=True)))
<All keys matched successfully>
같은 구조의 모델을 새로 만든 뒤 저장된 가중치를 채워 넣었다. 저장된 키와 모델의 키가 모두 일치했다는 메시지가 나온다. weights_only=True는 텐서와 기본 자료형만 불러오도록 제한하는 안전한 방식으로, PyTorch 2.6부터 기본값이다.
print(net.parameters)
<bound method Module.parameters of NeuralNet(
  (conv1): Conv2d(1, 6, kernel_size=(3, 3), stride=(1, 1))
  (conv2): Conv2d(6, 16, kernel_size=(3, 3), stride=(1, 1))
  (fc1): Linear(in_features=400, out_features=120, bias=True)
  (fc2): Linear(in_features=120, out_features=84, bias=True)
  (fc3): Linear(in_features=84, out_features=10, bias=True)
)>
괄호 없이 parameters를 출력하면 메서드 객체가 표시되는데, 그 안에 모델 구조가 함께 나타난다.
모델 테스트
테스트 데이터의 첫 배치에서 이미지 6장을 확인한다. 정규화를 되돌리기 위해 image / 2 + 0.5로 \([-1, 1]\)을 \([0, 1]\)로 바꾸고, (C, H, W)를 matplotlib이 받는 (H, W, C)로 바꿔 그린다.
import numpy as np
import torchvision

def imshow(image):
    image = image / 2 + 0.5
    npimg = image.numpy()
    fig = plt.figure(figsize=(16, 8))
    plt.imshow(np.transpose(npimg, (1, 2, 0)))
    plt.axis("off")
    plt.show()

dataiter = iter(test_loader)
images, labels = next(dataiter)
imshow(torchvision.utils.make_grid(images[:6]))
print([labels_map[l.item()] for l in labels[:6]])
['Ankle Boot', 'Pullover', 'Trouser', 'Trouser', 'Shirt', 'Trouser']
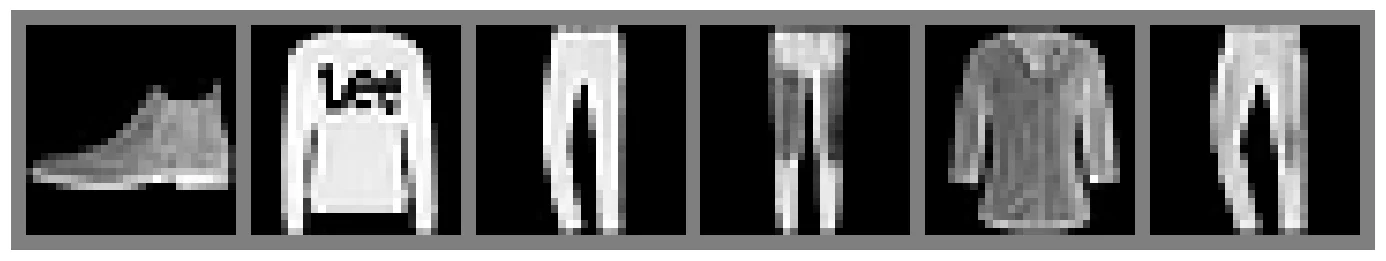 테스트 세트의 처음 6장. 왼쪽부터 앵클 부츠, 풀오버, 바지, 바지, 셔츠, 바지다. 코드 실행 결과.
net.eval()
with torch.no_grad():
    outputs = net(images.to(device))
_, predicted = torch.max(outputs, 1)
print(predicted[:6])
print("".join(f"{labels_map[predicted[j].item()]:>12}" for j in range(6)))
tensor([9, 2, 1, 1, 6, 1])
  Ankle Boot    Pullover     Trouser     Trouser       Shirt     Trouser
torch.max(outputs, 1)은 클래스 축에서 가장 큰 점수의 값과 인덱스를 돌려주며, 인덱스가 곧 예측 클래스다. 6장 모두 정답과 일치했다. net.eval()은 드롭아웃이나 배치 정규화가 있는 모델에서 평가 모드로 바꾸는 호출로, 이 모델에는 해당 층이 없지만 습관적으로 붙여 둔다.
테스트 이미지 전체에 대한 정확도를 계산한다.
correct = 0
total = 0

with torch.no_grad():
    for data in test_loader:
        images, labels = data
        images, labels = images.to(device), labels.to(device)
        outputs = net(images)
        _, predicted = torch.max(outputs.data, 1)
        total += labels.size(0)
        correct += (predicted == labels).sum().item()

print(f"{total}개 테스트 이미지에 대한 정확도: {100 * correct / total:.2f}%")
10000개 테스트 이미지에 대한 정확도: 81.21%
작은 CNN을 작은 학습률로 10 에포크만 학습했는데도 약 81%의 정확도가 나온다. 학습 손실이 아직 줄어드는 중이었으므로, 에포크를 늘리거나 학습률을 키우거나 Adam 같은 옵티마이저를 쓰면 더 높아질 여지가 있다.
정리
- 학습 루프의 기본형은
optimizer.zero_grad()→ 예측 →loss = criterion(pred, y)→loss.backward()→optimizer.step()이다. - 선형 회귀에서는
nn.Linear(1, 1)과MSELoss,SGD로 잡음이 섞인 데이터의 기울기를 1.01로 찾았고, 손실은 잡음 수준에서 멈췄다. - FashionMNIST는
ToTensor와Normalize로 전처리하고DataLoader로 128장씩 469개 배치로 나눴다. - 합성곱 2개와 완전연결 3개의 CNN은 펼친 특성 수(400)를 직접 계산해 맞추며,
CrossEntropyLoss에는 logit을 그대로 넘긴다. - 모델은
torch.save(net.state_dict(), PATH)로 저장하고, 같은 구조를 만든 뒤load_state_dict(torch.load(PATH))로 불러온다. - 평가 때는
net.eval()과torch.no_grad()를 쓰고,torch.max(outputs, 1)의 인덱스로 예측을 구해 정확도를 계산한다. 10 에포크 학습 후 테스트 정확도는 81.21%였다.