Abstract
Large vision-language model(LVLM)은 여전히 hallucination을 일으킨다. 즉 image에 없는 object나 attribute를 묘사한다. VCD, ICD 같은 training-free contrastive decoding(CD) 방법은 정상 출력과 왜곡된 입력(noise를 넣은 image나 변형된 instruction)에서의 출력을 대비시켜 이를 줄인다. 이 “hallucinatory” branch는 language prior에 대한 과의존을 잡아내지만, 저자들은 두 가지 다른 오류 원인을 놓친다고 주장한다. 하나는 spurious inter-modality correlation(image에 음식이 있으면 모델이 “dining table”이라고 말하는 것)이고, 다른 하나는 RoPE에서 오는 position bias로, text token이 주로 마지막 image token들에 attention을 주게 만든다.
CMAC(Cross-Modal Attention Calibration)는 왜곡이 일어나는 위치를 바꾼다. Inter-Modality Decoding(IMD) module은 decoder 내부에서 contrastive branch를 만든다. 가장 강한 text-to-image attention weight를 찾아 그 뒤의 value vector를 평균 vector로 바꾸므로, 이 branch에는 약한(spurious일 수 있는) 연결과 language prior만 남는다. Cross-Modal Position Calibration(CMPC) module은 text-to-image attention을 계산할 때 image token 사이의 RoPE position 간격을 줄인다. 두 module 모두 학습이 필요 없다.
Motivation
논문은 기존 CD 방법의 빈틈에서 출발한다. Image 전체를 왜곡하면 “선명한 image를 볼 수 없는” branch가 만들어지고, 이 branch는 language prior로 답한다. 이것이 첫 번째 실패 유형이다. 두 번째 유형은 모델이 image의 엉뚱한 부분을 보고 web data에서 학습한 피상적인 text-image 연관으로 답하는 경우이다. 전역적으로 왜곡된 image로는 이 두 번째 유형을 분리할 수 없으므로, contrast가 너무 거칠어 이를 제거하지 못한다.
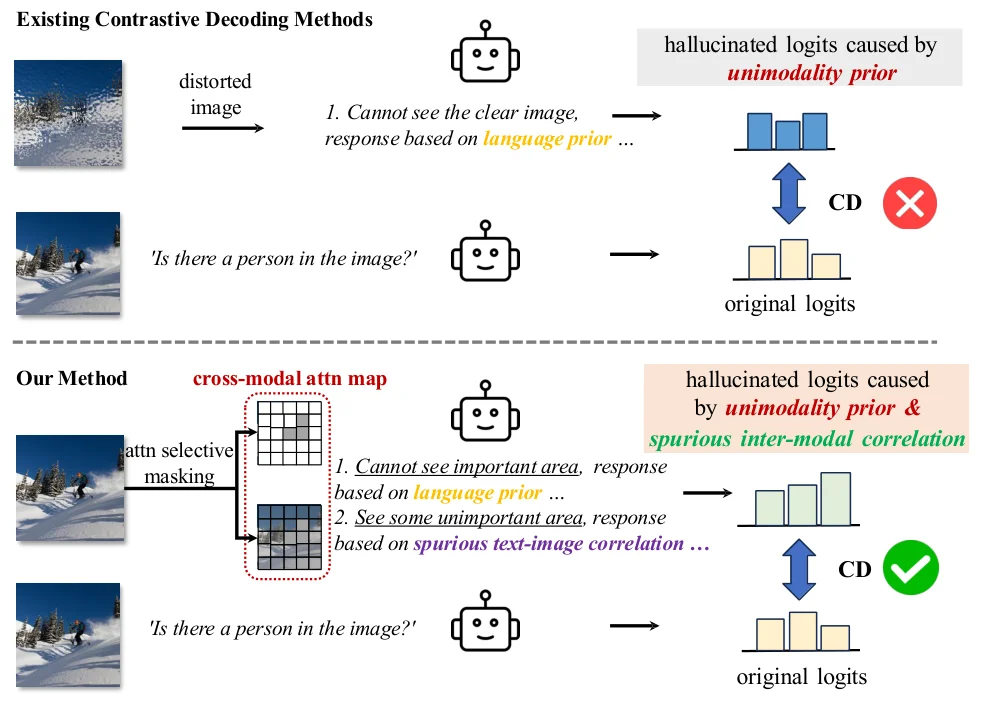 위: 기존 CD는 image 전체를 왜곡하므로 hallucinatory branch는 unimodal(language) prior만 반영한다. 아래: CMAC는 cross-modal attention map의 선택된 entry를 masking하므로, branch는 중요한 영역을 놓치고 중요하지 않은 영역에 계속 attention을 주어 language prior와 spurious text-image correlation을 모두 반영한다. 논문 Figure.
두 번째 관찰은 position에 관한 것이다. Text token이 각 image token에 주는 attention weight를 그려 보면, Qwen-VL과 LLaVA-1.5 모두 image sequence 끝으로 갈수록 급격히 커진다. 저자들은 원인을 RoPE에서 찾는다. Image token이 query 앞에 놓이므로 마지막 image token들이 text에 가장 가깝고 더 많은 attention을 받는다. Hallucination 통계도 같은 패턴을 따른다. Image token sequence의 head 부분에 해당하는 object는 0.28, middle은 0.21, tail은 0.15의 비율로 hallucination된다.
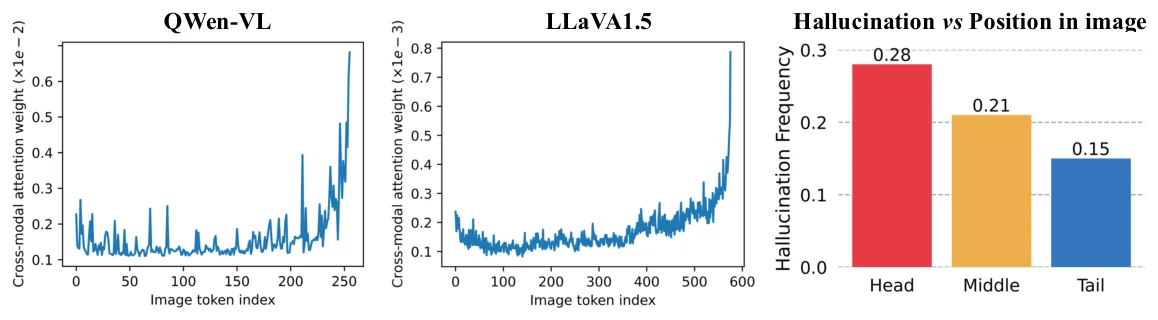 왼쪽과 가운데: Qwen-VL과 LLaVA-1.5에서 image token index에 따른 cross-modal attention weight. Tail에서 급격히 커진다. 오른쪽: object token의 image sequence 내 위치별 hallucination 빈도(head 0.28, middle 0.21, tail 0.15). 논문 Figure.
논문은 spurious correlation 주장도 LLaVA-1.5로 POPE에서 확인한다. 가장 자주 함께 등장하는 object가 image에 있는 경우, 그 object가 없는 경우보다 true-negative와 false-negative 오류율이 모두 뚜렷하게 높다(아래 Figure 5 참고).
Method
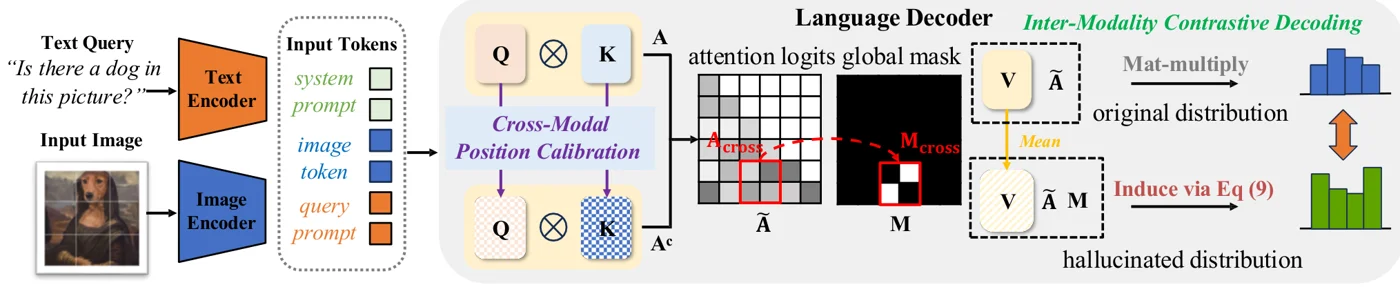 CMAC 개요. CMPC는 압축된 image position으로 text-to-image attention logit을 다시 계산한다. IMD는 가장 강한 cross-modal attention logit에 대한 global mask를 만들고, 해당 value vector를 평균으로 바꿔 hallucinated distribution을 유도한 뒤 원래 distribution과 대비시킨다. 논문 Figure.
입력 sequence는 \([T_{0:m_b}, X, T_{m_b+1:m}]\)이다. \(m_b\)개 token의 system prompt, \(n\)개의 image token, 그리고 query prompt 순서이다. 각 attention head에서 \(A^l = Q_p K_p^\top / \sqrt{d}\)가 attention logit, \(A = \mathrm{softmax}(A^l)\)이며, 출력은 \(O = AV\)이다.
Inter-Modality Decoding (IMD)
IMD는 logit의 cross-modal block, 즉 query prompt(및 생성된) token의 행과 image token의 열 \(A^l_{\text{cross}} = A^l[m_b{+}n : m{+}n,\ m_b : m_b{+}n]\)을 가져와, block 평균보다 큰 모든 entry를 표시한다.
\[M_{\text{cross}} = \mathbb{I}\big(A^l_{\text{cross}} > \mu(A^l_{\text{cross}})\big)\]\(M_{\text{cross}}\)는 zero-padding으로 전체 크기의 mask \(M\)이 된다. Attention weight는 그대로 둔다. 선택된 entry 뒤의 value vector만 평균 value vector \(\mu(V)\)로 바꾼다.
\[\tilde O = (M \odot A)\, \mu(V) + ((1 - M) \odot A)\, V\]따라서 왜곡된 branch는 강하고 정당한 text-image 연결만 정확히 잃고, 약한 연결, intra-modal attention, language prior는 유지한다. \(\tilde O\)로 decoder를 실행하면 logit \(\tilde l_t\)를 얻고, decoding은 표준 CD 규칙을 따른다.
\[p_\theta(Y_t \mid T, X) = \mathrm{softmax}\big((1 + \alpha)\, l_t - \alpha\, \tilde l_t\big)\]저자들은 두 가지 부수적 이점을 든다. Attention weight를 바꾸지 않으므로, attention masking이나 token pruning에서처럼 hallucinated branch가 특정 image 영역 쪽으로 과대 또는 과소 가중되지 않는다. 또한 attention의 visual 부분이 그대로이므로 key, value, attention weight를 원래 forward pass에서 재사용할 수 있어, 왜곡된 입력으로 두 번째 전체 forward pass를 돌리는 VCD와 ICD보다 IMD가 다소 빠르다.
Cross-Modal Position Calibration (CMPC)
CMPC는 image token을 인자 \(\gamma\)만큼 압축한 두 번째 position index 집합을 만든다.
\[P^c = \big[\{i\}_{i=1}^{m_b},\ \{m_b + i/\gamma\}_{i=1}^{n},\ \{i + n/\gamma\}_{i=m_b+1}^{m}\big]\]\(P^c\)로 RoPE를 적용해 logit \(A^c\)를 얻고, \(A^l\)의 text-to-image block만 \(A^c\)의 해당 entry로 교체한다. 나머지는 원래 position을 유지한다. Image token은 text에 대해 같은 위치에 있지만 첫 image token과 마지막 image token 사이의 거리가 줄어들어, image의 head 부분이 query로부터 멀리 밀려나지 않는다. 보정된 logit은 원래 branch와 왜곡된 branch 모두에, 그리고 IMD mask 계산에도 사용된다.
기본값은 \(\gamma = 2\), \(\alpha = 3\)이며 top-p는 1로 둔다.
Main Experiments
Backbone은 LLaVA-1.5, InstructBLIP, Qwen-VL이며 모두 7B language model을 쓴다. POPE는 accuracy와 F1을 COCO, A-OKVQA, GQA subset에 대해 평균해 보고한다. 아래 표는 nucleus sampling 설정이다.
| Model | Method | Random Acc | Random F1 | Popular Acc | Popular F1 | Adversarial Acc | Adversarial F1 |
|---|---|---|---|---|---|---|---|
| LLaVA-1.5 | Baseline | 83.49 | 82.28 | 79.98 | 79.34 | 76.03 | 76.26 |
| ICD | 85.70 | 84.43 | 81.61 | 81.46 | 78.66 | 78.57 | |
| VCD | 86.84 | 86.83 | 82.65 | 83.37 | 77.31 | 79.28 | |
| PAI | 87.73 | 87.65 | 83.45 | 84.21 | 78.36 | 78.53 | |
| CMAC | 89.10 | 88.60 | 86.00 | 85.70 | 81.41 | 81.84 | |
| InstructBLIP | Baseline | 80.41 | 80.94 | 76.09 | 77.65 | 72.37 | 75.42 |
| VCD | 84.11 | 84.13 | 79.96 | 80.80 | 76.32 | 78.08 | |
| PAI | 84.60 | 84.54 | 80.13 | 80.94 | 77.00 | 78.33 | |
| CMAC | 86.67 | 86.10 | 82.20 | 82.37 | 78.37 | 79.25 | |
| Qwen-VL | Baseline | 84.12 | 82.42 | 81.89 | 80.51 | 79.10 | 78.07 |
| VCD | 87.82 | 87.68 | 85.60 | 85.48 | 81.85 | 82.34 | |
| PAI | 88.15 | 87.94 | 85.73 | 85.51 | 81.98 | 82.23 | |
| CMAC | 88.61 | 88.26 | 86.67 | 86.34 | 82.68 | 83.05 |
MS-COCO validation image 500장에 “Please describe this image in detail” prompt로 측정한 CHAIR(nucleus sampling, \(C_i\)와 \(C_s\)는 낮을수록 좋음):
| Method | LLaVA-1.5 Ci ↓ | LLaVA-1.5 Cs ↓ | LLaVA-1.5 F1 ↑ | InstructBLIP Ci ↓ | InstructBLIP Cs ↓ | InstructBLIP F1 ↑ | Qwen-VL Ci ↓ | Qwen-VL Cs ↓ | Qwen-VL F1 ↑ |
|---|---|---|---|---|---|---|---|---|---|
| Sampling | 55.6 | 17.8 | 77.0 | 57.0 | 16.7 | 76.3 | 44.8 | 11.3 | 81.1 |
| VCD | 54.2 | 16.4 | 80.0 | 53.6 | 15.6 | 79.2 | 47.2 | 12.1 | 81.6 |
| ICD | 54.0 | 15.4 | 80.7 | 49.6 | 14.5 | 78.5 | 43.2 | 11.2 | 81.5 |
| CMAC | 47.0 | 12.7 | 81.0 | 50.6 | 13.2 | 79.7 | 41.2 | 10.6 | 81.8 |
- POPE 향상은 어려운 split에서 가장 크다. LLaVA-1.5에서 Popular accuracy는 79.98에서 86.00으로, Adversarial은 76.03에서 81.41로 오르며, 두 경우 모두 차순위 방법보다 2.5~3 point 높다.
- MME hallucination subset에서 LLaVA-1.5의 total은 566.67에서 612.49로 오르며(VCD 581.25, ICD 582.50), 가장 큰 향상은 Count(110.00 → 135.41)에서 나온다.
- LLaVA-1.5 ablation(POPE Popular)에서 IMD만 쓰면 accuracy 85.10, CHAIRs 13.6, CMPC만 쓰면 82.31과 16.2, 둘 다 쓰면 86.04와 12.7이다. Value를 평균으로 masking하는 방식(86.04)이 attention weight masking(84.92)과 value에 noise를 더하는 방식(85.72)보다 낫다.
Co-occurrence 분석은 IMD의 논리를 직접 뒷받침한다. LLaVA-1.5로 POPE에서, 질문한 object와 가장 자주 함께 나오는 object가 image에 있을 때, CMAC는 true-negative 오류율을 ICD 수준으로, baseline과 VCD보다 훨씬 낮게 떨어뜨리면서 false-negative 비율도 낮게 유지한다.
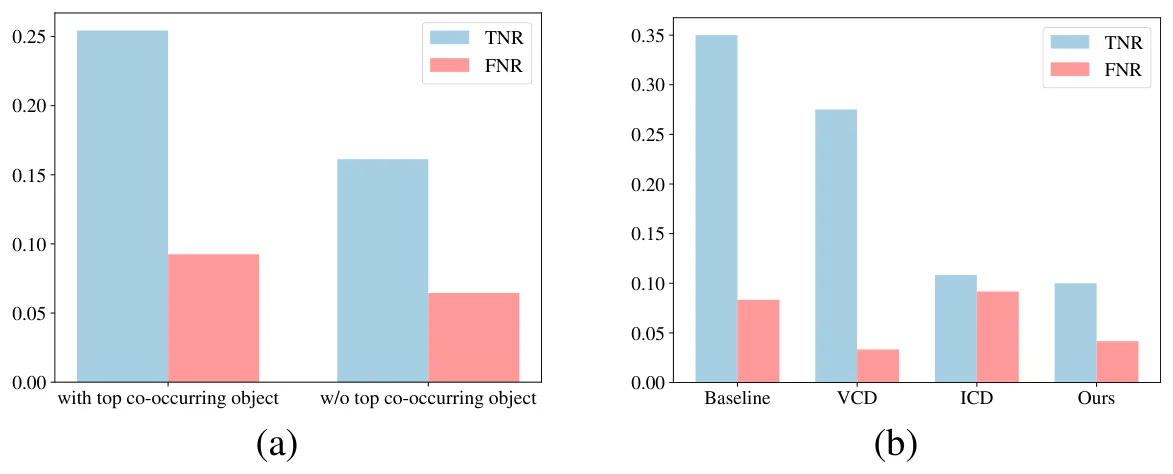 (a) POPE에서의 LLaVA-1.5: 질문한 object의 최다 co-occurring object가 image에 있을 때 TNR, FNR 오류가 더 높다. (b) Co-occurring 경우에 대한 Baseline, VCD, ICD, CMAC의 같은 오류율. 빈도가 높은 object 쌍 5개의 평균이다. 논문 Figure.
CMPC는 position 패턴도 평탄하게 만든다. CMAC를 쓰면 image token의 head, middle, tail 부분에서의 hallucination 빈도가 28% / 21% / 15%에서 11% / 13% / 10%로 떨어진다.
MME 전체 benchmark에서 CMAC는 14개 subtask 중 10개에서 비교 방법 중 가장 높은 점수를 얻으며, Posters, Celebrity, Scene, Landmark 같은 perception subtask에서 뚜렷하게 낫다. Image보다 language reasoning에 의존하는 Numerical calculation과 Text translation에서는 약하다.
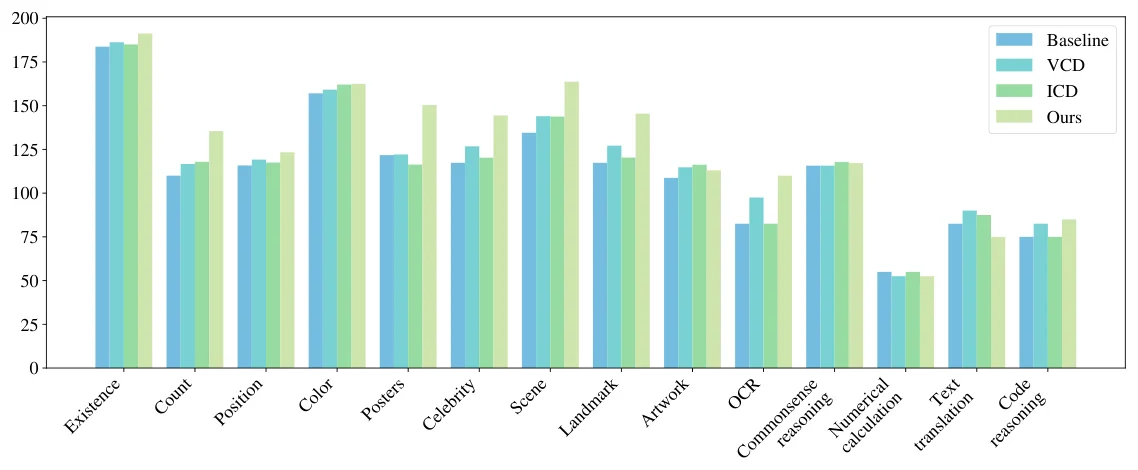 LLaVA-1.5에서 baseline, VCD, ICD, CMAC의 MME subtask별 점수. 논문 Figure.
Limitations
- Attention 크기는 proxy일 뿐이다. 논문도 attention weight가 크다고 해서 인과적으로 관련 있는 text-image 연결이라는 보장은 없다고 밝히며, 따라서 mask가 잘못된 entry를 고를 수 있다.
- Vision encoder에 묶여 있다. CMAC는 visual encoder가 추출하는 정보를 개선하지 않는다. Object가 image token에 표현되어 있지 않다면 어떤 re-weighting으로도 grounding할 수 없다(저자들도 언급).
- 여전히 두 branch decoder이다. Key와 value를 재사용해도 LLaVA-1.5의 POPE throughput은 12.93에서 7.75 tokens/s로 떨어진다(VCD 7.04, ICD 6.90).
- White-box 전용이다. 두 module 모두 attention 내부와 RoPE index를 수정하므로, decoder에 접근할 수 있어야 하고 system prompt, image, query token의 배치를 알아야 한다.
- Language 중심 task는 후퇴할 수 있다. MME에서 Text translation과 Numerical calculation은 baseline보다 약간 떨어진다.