Abstract
실제 센서에서 얻은 point cloud에는 noise, occlusion, density 변화, misalignment가 따른다. 깨끗한 point cloud로 학습한 classifier는 이런 데이터에서 accuracy를 크게 잃는다. 대부분의 test-time adaptation (TTA) 방법은 entropy minimization처럼 모델 자신의 예측을 이용해 model parameter를 update한다. Point cloud에서는 이 방식이 현실적인 설정에서 무너진다. Batch size가 1이거나, 테스트 스트림이 label 순으로 정렬되어 있거나, class imbalance가 있으면 TENT와 SHOT은 accuracy 약 4%로 붕괴한다. 2D 방법인 DDA는 대신 diffusion model로 입력을 adaptation한다. 이를 3D로 옮기면 point cloud의 기하 구조를 무시하게 되고, 전체 생성 과정을 실행하며 diffusion model을 통해 backpropagation하기 때문에 샘플당 약 23.6초가 걸린다.
CloudFixer도 한 번에 한 샘플씩 입력을 adaptation하지만, point cloud를 다시 생성하지는 않는다. 입력에 대한 작은 geometric transformation(rotation과 point별 displacement)을 최적화한다. 이 최적화의 목표는 고정된 source diffusion model이 내놓는 one-step denoising 추정치이다. Diffusion model은 forward pass만 수행한다. 선택적인 online 변형인 CloudFixer-O는 원래 입력에 대한 예측과 adaptation된 입력에 대한 예측이 일치하도록 classifier도 update한다.
Motivation
저자들은 먼저 표준 model update 방식의 TTA가 point cloud에서 얼마나 통하는지 확인한다. Figure 1은 ModelNet40-C와 Point2Vec에서 TENT의 batch size를 바꿔 본다. Test stream이 무작위 순서일 때 TENT는 unadapted 모델(약 62%)과 같아지려면 batch size가 약 8은 되어야 하고, batch size 64에서야 CloudFixer 수준에 도달한다. Batch size 1과 2에서는 몇 %로 붕괴한다. Class 순으로 정렬된 stream에서는 어떤 batch size에서도 약 13% 아래에 머문다. 논문은 이를 모델 자신의 불안정한 prediction에 크게 의존하기 때문이라고 본다. Batch가 아주 작거나 한 class만 담고 있으면 그 prediction이 편향된다.
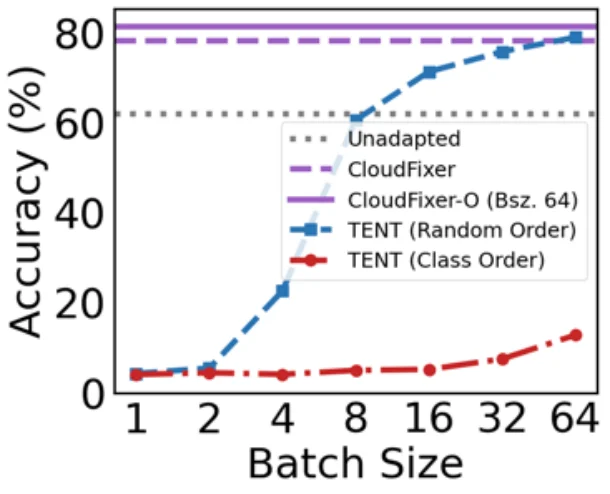 ModelNet40-C에서 batch size가 커질 때 무작위 순서와 class 순서 test stream에 대한 TENT의 accuracy를 unadapted 모델, CloudFixer와 비교. TENT는 작은 batch와 class 순서 stream에서 쓸모가 없지만, 샘플 단위로 동작하는 CloudFixer는 둘 다에 영향을 받지 않는다. 논문 Figure.
Input adaptation은 한 샘플에서 동작하고 pseudo-label을 믿지 않으므로 이 문제를 피한다. DDA가 2D에서 이를 보였지만, 그 방식(noise를 더한 뒤 전체 reverse diffusion을 돌려 입력을 다시 생성)은 image에는 맞아도 point cloud에는 맞지 않는다. 많은 3D corruption은 회전된 물체나 몇 개의 튀는 점처럼 geometric하므로, 모든 점을 다시 생성하는 것은 불필요하고 shape의 세부를 지울 수 있다. 또 diffusion model을 통한 backpropagation을 포함한 전체 reverse process는 샘플당 약 23.6 s가 든다. CloudFixer의 출발점은, 고정된 diffusion model의 one-step 추정치만으로도 입력이 어느 쪽으로 움직여야 하는지 알 수 있고, 그 움직임 자체는 새 sample이 아니라 작고 구조화된 transform(rotation과 regularization된 point별 offset)으로 충분하다는 점이다.
Method
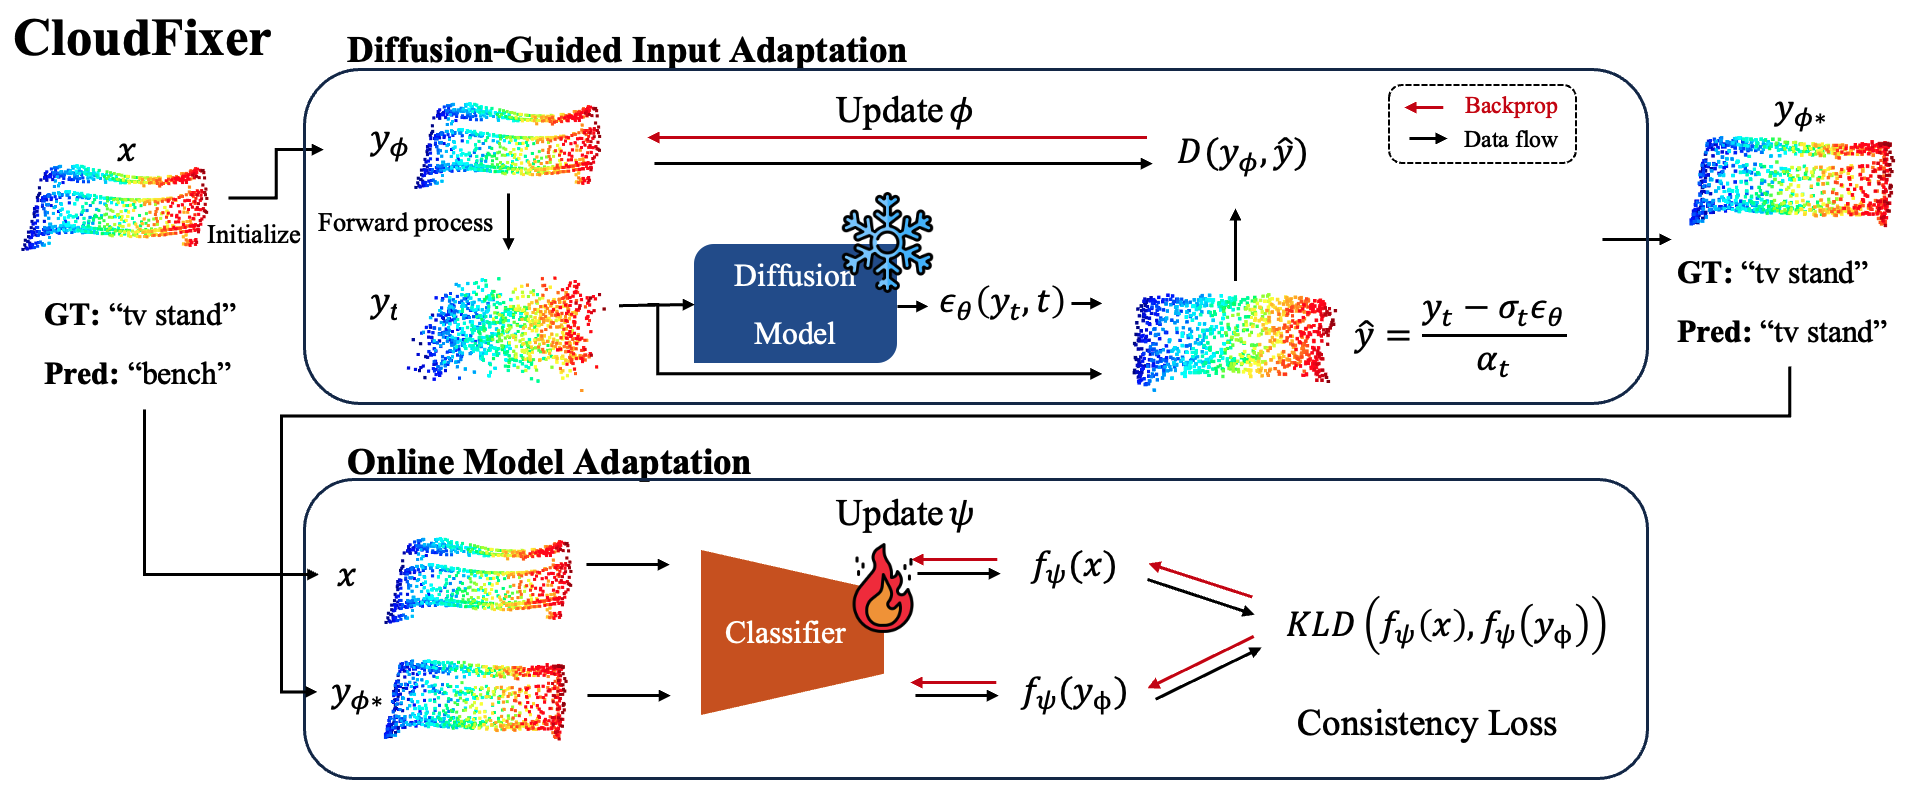 위: Diffusion 기반 input adaptation은 \(y_\phi\)가 diffusion model의 추정치 \(\hat y\) 쪽으로 이동하도록 transformation parameter \(\phi\)를 최적화한다. 아래: \(f_\psi(x)\)와 \(f_\psi(y_{\phi^*})\) 사이의 KL consistency loss를 사용하는 선택적 online model adaptation. 그림은 논문에서 가져왔다.
Setup
Classifier \(f_\psi\)는 source point cloud \(x \in \mathbb{R}^{N \times 3}\)로 학습된다. Diffusion model \(\epsilon_\theta\) 역시 \(x_t = \alpha_t x_0 + \sigma_t \epsilon\)로 source 데이터에서 학습된다. Noise가 섞인 입력으로부터 모델은 깨끗한 데이터의 one-step 추정치를 준다.
\[\hat{x}_0 = \frac{x_t - \sigma_t \epsilon_\theta(x_t, t)}{\alpha_t}\]\(x_0\)가 shift된 domain에서 왔다면, \(\hat x_0\)는 source domain에 더 가까운 곳에 놓이는 경향이 있다. CloudFixer는 이 차이를 학습 신호로 사용한다.
Geometric transformation \(y_\phi\)
테스트 입력 \(x\)(그림 왼쪽)는 다음과 같이 변환된다.
\[y_\phi(x) = (x + \Delta) R^\top, \qquad \phi = (R, \Delta)\]Misalignment는 흔한 corruption 유형이므로 \(R\)은 \(3 \times 3\) rotation matrix이다. \(\Delta \in \mathbb{R}^{N \times 3}\)는 유연한 local correction을 위해 점마다 displacement \(\delta_j\) 하나씩을 가진다. \(R\)은 6차원 벡터 \((a_1, a_2)\)로부터 Gram-Schmidt로 만들어지므로 항상 유효한 rotation으로 유지된다. \(\phi\)는 \(y_\phi(x) = x\)가 되도록 초기화된다.
Diffusion guidance (윗줄)
각 iteration은 세 단계로 이루어진다.
- \(t \sim U[t_{min}, t_{max}]\)를 샘플링하고 forward process를 실행한다: \(y_t = \alpha_t y_\phi + \sigma_t \epsilon\).
- 고정된 diffusion model을 한 번 실행해 \(\hat y = (y_t - \sigma_t \epsilon_\theta(y_t, t)) / \alpha_t\)를 얻는다.
- \(y_\phi\)가 \(\hat y\)에 가까워지도록 \(\phi\)를 이동시킨다.
\(\hat y\)는 고정된 target으로 취급된다(stop-gradient). 그림의 빨간 backpropagation 화살표는 \(D\)에서 \(\phi\)로만 가며, diffusion model을 통과하지 않는다. 이것이 DDA 대비 속도 향상의 주된 원천이다.
\(D\)로 squared \(\ell_2\)를 쓰면 이 update는 timestep별 scale을 제외하면 Score Distillation Sampling과 같다. 저자들은 이것이 불안정하다는 것을 발견했다. Point cloud는 순서가 없는 집합이므로, 대신 Chamfer distance를 사용한다.
\[D(x, y) = \frac{1}{|x|} \sum_{i} \min_j \| x(i) - y(j) \|_2^2 + \frac{1}{|y|} \sum_{j} \min_i \| x(i) - y(j) \|_2^2\]Timestep 범위는 \([0.02T, 0.12T]\)로 작다. \(t\)가 너무 작으면 두 domain이 충분히 가까워지지 않는다. \(t\)가 크면 class 정보가 씻겨 나간다.
Regularization. 큰 변화를 막기 위해 displacement에 point별 penalty를 준다.
\[\mathrm{Reg}(\Delta) = \sum_j w_j \| \delta_j \|_2^2\]\(w_j\)는 점 \(j\)에서 \(k\)개 nearest neighbor까지의 평균 거리의 역수이다. 고립된 noise 점은 weight가 작아 자유롭게 움직일 수 있다. 형상을 담고 있는 밀집 영역의 점들은 제자리에 붙잡혀 있다.
Voting. 이 과정은 stochastic하므로 \(K\)번 실행하면 변환된 입력 \(K\)개를 얻는다. 최종 예측은 이들의 class probability를 평균한 \(\sum_j f_\psi(y_{\phi_j}) / K\)이다.
기본값은 샘플당 AdaMax 30 step이며, \(k = 5\)이고 \(\lambda\)는 10에서 1로 점차 줄인다.
Online model adaptation (아랫줄, 선택 사항)
Batch가 크고 i.i.d.일 때, CloudFixer-O는 head를 제외한 classifier도 update한다. 원래 입력과 adaptation된 입력에 대한 예측 사이의 KL divergence를 최소화한다.
\[\min_\psi \sum_{j=1}^{K} KL\Big( f_\psi(x) \,\Big\|\, f_\psi\big(y_{\phi_j}(x)\big) \Big)\]Adaptation된 입력은 source domain에 더 가깝다. 두 예측을 맞추면 encoder가 distribution shift를 무시하도록 유도되며, 이는 pseudo-label에 의존하지 않는다.
Main Experiments
아래 표는 Point2Vec classifier로 측정한 15가지 ModelNet40-C corruption에 대한 평균 accuracy(%)이다. 논문은 corruption 유형별로 따로 보고하며, 여기에는 Table 1~3의 평균값만 실었다. “Label-sorted”는 클래스 순으로 정렬되어 시간적으로 상관된 스트림을 뜻한다. “Imbalanced”는 class imbalance ratio 100을 뜻하며, 그 지표는 accuracy가 아니라 macro-recall이다.
| Method | Batch size 1 | Label-sorted stream | Imbalanced (macro-recall) |
|---|---|---|---|
| Unadapted | 62.09 | 60.38 | 59.94 |
| PL | 56.53 | 19.00 | 65.82 |
| TENT | 4.29 | 12.80 | 58.49 |
| SHOT | 4.04 | 12.80 | 54.67 |
| SAR | 55.51 | 18.73 | 65.50 |
| DUA | 61.79 | 21.68 | 68.87 |
| LAME | 62.06 | 65.92 | 53.47 |
| MEMO | 70.75 | 61.75 | 59.13 |
| DDA | 74.37 | 74.37 | 71.30 |
| CloudFixer | 78.23 | 78.23 | 77.60 |
| CloudFixer + Voting (\(K=5\)) | 79.09 | - | - |
PointDA-10(sim-to-real의 natural distribution shift, DGCNN, accuracy %)의 결과로, Table 5에서 가져왔다. M = ModelNet, S = ShapeNet, S* = ScanNet이다. MEMO, DDA, CloudFixer를 제외한 모든 방법은 batch size 64를 사용하며, 여기에는 CloudFixer-O도 포함된다.
| Method | M→S | M→S* | S→M | S→S* | S*→M | S*→S | Avg |
|---|---|---|---|---|---|---|---|
| Unadapted | 81.38 | 52.23 | 77.10 | 44.83 | 62.03 | 64.69 | 63.71 |
| TENT | 76.77 | 52.63 | 65.07 | 49.46 | 57.59 | 59.31 | 60.14 |
| SHOT | 14.53 | 14.53 | 67.17 | 47.77 | 44.63 | 19.62 | 34.71 |
| LAME | 82.26 | 53.93 | 80.84 | 44.83 | 20.68 | 43.42 | 54.33 |
| MEMO | 75.84 | 47.26 | 73.25 | 50.99 | 47.90 | 60.27 | 59.25 |
| DDA | 82.46 | 51.89 | 80.72 | 44.77 | 65.42 | 66.85 | 65.35 |
| CloudFixer | 83.46 | 53.12 | 77.80 | 43.30 | 63.97 | 67.85 | 64.92 |
| CloudFixer + Voting (\(K=3\)) | 83.51 | 53.47 | 77.92 | 43.64 | 64.48 | 68.37 | 65.23 |
| CloudFixer-O | 80.42 | 53.08 | 75.00 | 51.55 | 66.00 | 69.02 | 65.85 |
정리:
- 어려운 설정에서 model update 방법들은 붕괴하거나(batch size 1에서 TENT와 SHOT이 약 4%) adaptation하지 않은 모델보다 낮아진다. CloudFixer는 unadapted 모델보다 약 16~18포인트 높게 유지된다. 가장 큰 향상은 background noise(37.68에서 75.49)와 rotation(47.04에서 81.04)에서 나오며, 이 항목들에서 DDA는 거의 도움이 되지 않는다.
- 일반적인 완만한 설정(batch size 64, i.i.d., Table 4)에서 CloudFixer-O는 평균 81.49에 도달한다. 최고 baseline인 TENT는 78.85이다.
- PointDA-10에서는 차이가 작다. 일반 CloudFixer(64.92)는 DDA(65.35)보다 약간 낮고, 평균 기준으로 가장 좋은 것은 CloudFixer-O뿐이다. CloudFixer는 RTX 3090에서 샘플당 0.93 s가 걸린다. DDA는 약 23.6 s가 걸린다.
정성적 예시는 transform이 실제로 무엇을 하는지 보여 준다. 회전되거나 distortion된 shape은 기준 자세로 돌아오며 매끈해지고, 흩어진 Gaussian noise 점들은 표면으로 끌려오며, 실제에서 합성으로 가는 PointDA shift(ScanNet에서 ModelNet)에서는 듬성듬성한 scan이 더 조밀하고 규칙적으로 바뀐다. Cutout의 구멍은 채워지지 않는데, 이는 아래 occlusion limitation과 맞는다.
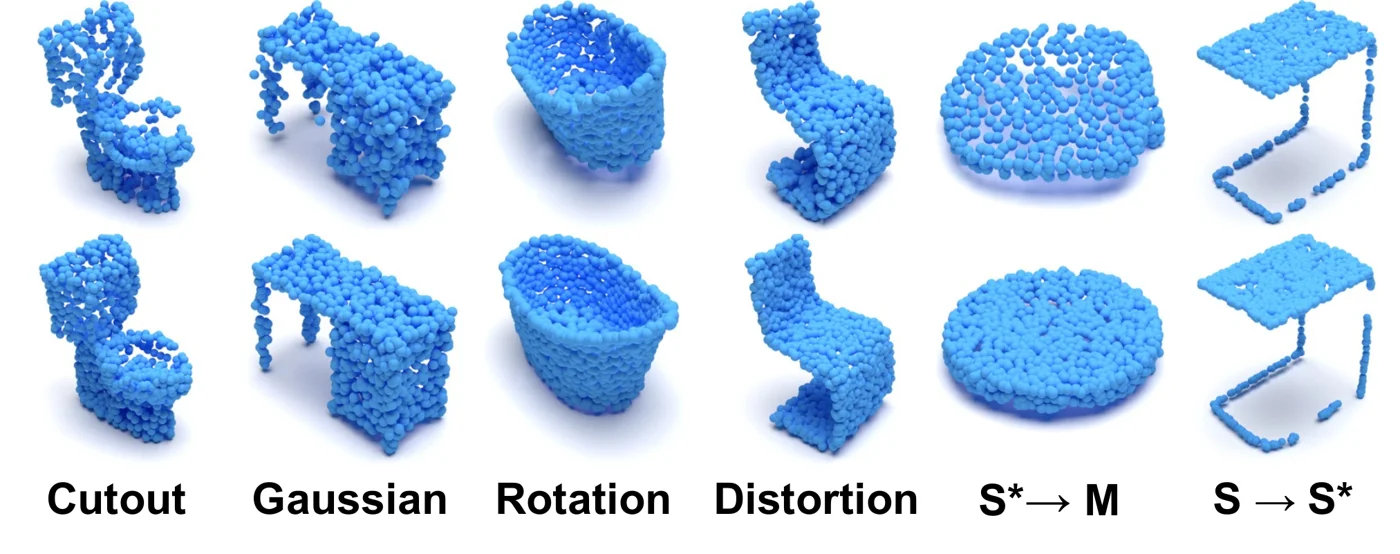 ModelNet40-C corruption 4종과 PointDA-10 shift 2종에 대해 corruption된 입력(위)과 CloudFixer 적용 후의 같은 point cloud(아래). Rotation과 noise는 대부분 되돌려지지만, cutout으로 빠진 영역은 그대로 비어 있다. 논문 Figure.
비용 plot은 속도 주장을 한 장으로 보여 준다. ModelNet40-C의 모든 corruption 평균으로 CloudFixer는 샘플당 0.93 s에 78.4% accuracy를 내고, DDA는 23.6 s가 필요하며, MEMO는 빠르지만 unadapted 모델보다 나을 것이 없다.
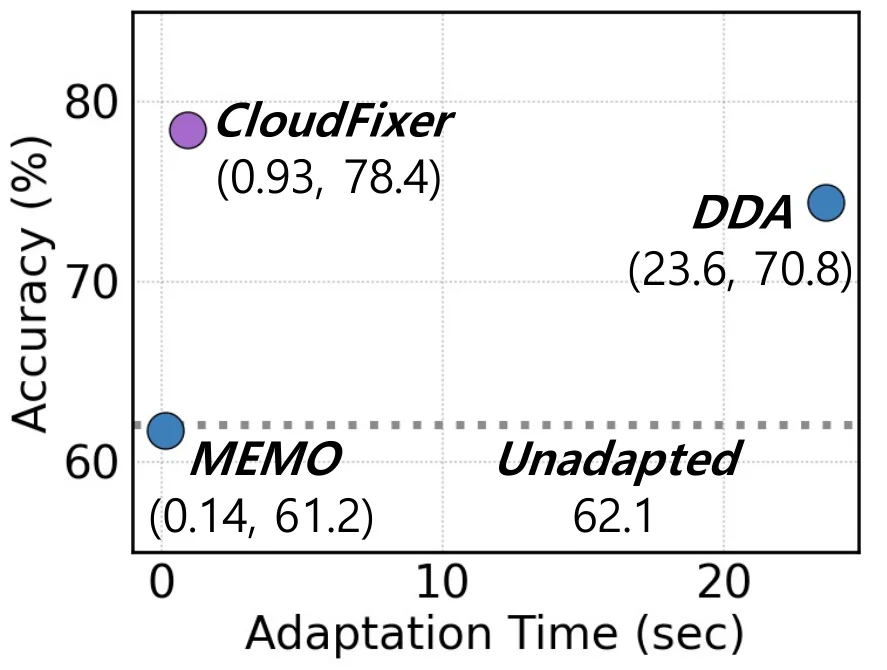 ModelNet40-C에서 샘플 단위 episodic 방법들의 샘플당 평균 adaptation 시간과 accuracy. CloudFixer는 DDA보다 약 25배 빠르면서 더 정확하다. 논문 Figure.
Backbone을 바꿔도(Point2Vec, PointMAE, PointMLP, PointNeXt, 완만한 설정) CloudFixer-O는 모든 경우에 최고이거나 최고와 비슷하다. 일반 CloudFixer는 4개 중 3개 backbone에서 batch size 64의 TENT보다 조금 낮은데(PointMAE에서는 TENT보다 높다), 이 쉬운 설정에서는 TENT가 강하므로 예상할 만한 결과이다.
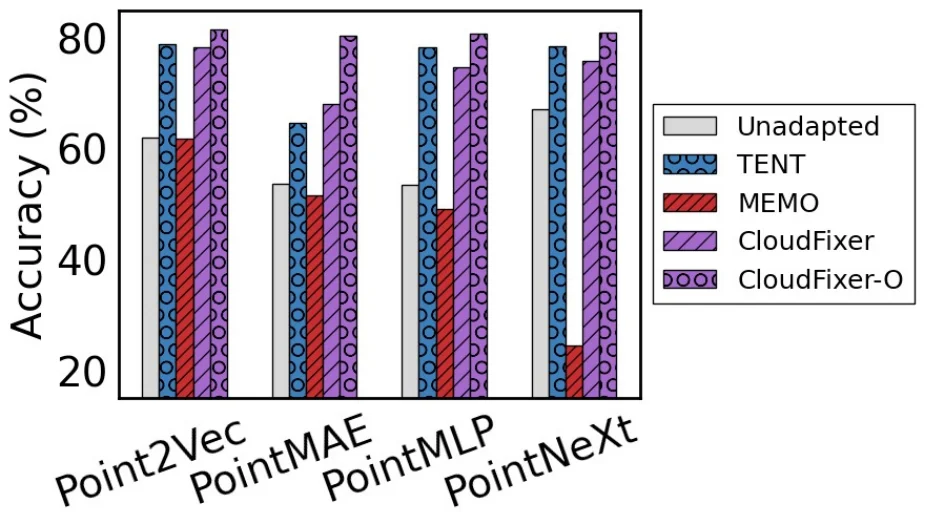 Classifier backbone 4종에서 ModelNet40-C 평균 accuracy. CloudFixer-O는 모든 backbone에서 최상위 또는 그 근처이며, MEMO는 PointNeXt에서 unadapted 모델보다 크게 떨어진다. 논문 Figure.
Limitations
- Occlusion. 저자들이 직접 언급한다. Diffusion model은 normalization된 point cloud에서 작동하므로, 심하게 가려진 형상은 크기가 다시 조정되고 위치가 이동된다. 이를 복구하려면 점을 크게 움직여야 하는데, regularization 항이 이를 억제한다. Table 1에서 OC accuracy는 41.00으로, unadapted의 41.09와 비슷하다.
- Density corruption에서의 소폭 손실. Batch size 1에서 DI(90.03에서 87.32)와 DD(86.51에서 80.27)는 unadapted 모델보다 약간 낮아진다.
- 샘플당 비용. 각 샘플마다 diffusion forward pass를 한 번씩 포함한 최적화 30 step이 필요하며, 이는 약 0.93 s이다. DDA보다 훨씬 빠르지만 classifier 한 번 통과와는 여전히 거리가 멀다. Voting은 작업량을 \(K\)배로 늘린다.
- Source diffusion model이 필요하다. 각 source 데이터셋마다 Point-E 모델을 5000 epoch 동안 학습한다. 따라서 이 방법은 배포 전에 source 데이터, 또는 그것으로 학습한 diffusion model에 접근할 수 있다고 가정한다.
- CloudFixer-O는 더 많은 것을 요구한다. 충분히 큰 i.i.d. batch와 classifier를 통한 추가 backpropagation이 필요하다. Batch size 1의 PointMAE 설정에서는 instance당 48개의 transformation을 사용한다.
- 좁은 sensitivity 검증. Hyperparameter sensitivity 연구는 단 하나의 corruption 유형(impulse noise)만 다룬다.