Abstract
Test-time prompt tuning (TPT)은 단일 테스트 이미지에 대한 CLIP의 accuracy를 높이지만 예측을 overconfident하게 만든다. 대부분의 해결책(C-TPT, O-TPT, A-TPT, SoC)은 prompt tuning 중 class text embedding을 서로 멀어지게 하는 regularization 항을 추가한다. 이들은 ECE를 낮추지만 TPT의 accuracy 향상 일부를, 때로는 거의 전부를 잃는다. 유일한 post-hoc 방법인 SaLS는 accuracy를 유지하지만 calibration error는 조금밖에 줄이지 못한다.
논문은 두 가지 사실에서 출발한다. Zero-shot CLIP은 이미 calibration이 잘 되어 있고, TPT는 accuracy를 조금만 바꾸므로, 늘어난 오차의 대부분은 부풀려진 confidence에서 나온다. 각 TPT 예측에 단순히 zero-shot confidence를 부여하는 예비 실험만으로도 ECE가 크게 낮아진다. CoTS(Confidence-based Temperature Scaling)는 이를 일관된 방식으로 만든다. TPT 이후, 테스트 이미지 자신의 augmented view에서 adaptation 후 confidence가 zero-shot confidence와 일치하도록 temperature를 학습한다. E-CoTS는 여기에 view에 대한 weak-strong ensemble을 더해 calibration을 유지하면서 accuracy를 높인다.
Motivation
논문은 먼저 기존 해결책들을 하나의 accuracy-ECE plot 위에 놓는다(Method 아래의 Figure 1). 두 가지가 눈에 띈다. 첫째, regularization 방법들(C-TPT, O-TPT, A-TPT, SoC)은 TPT의 ECE를 대략 zero-shot CLIP 수준까지만 낮추고 그보다 낮추지는 못하며, 그 과정에서 accuracy를 내준다. ViT-B/16의 ImageNet 변형에서 O-TPT는 57.51%로, TPT의 60.74%와 zero-shot의 57.22% 사이에서 TPT의 이득을 거의 다 잃는다. 둘째, post-hoc 방법인 SaLS는 TPT의 accuracy를 그대로 유지하지만 ECE는 10% 근처에 머문다. TPT의 accuracy를 지키면서 zero-shot 수준의 calibration에 도달하는 방법은 없다.
TPT는 accuracy를 조금만 바꾸는데 ECE는 두 배 이상 늘어나므로, 저자들은 손상이 주로 잘못된 예측이 아니라 confidence의 이동이라고 의심한다. 예비 실험인 Confidence Replacement(CoR)가 이를 직접 확인한다. TPT가 예측한 class는 유지하고, confidence로는 zero-shot CLIP의 최대 확률을 보고한다. 이것만으로 ECE가 약 6 point 줄고 SaLS와 C-TPT를 앞선다. CoR은 여전히 A-TPT와 SoC보다는 나쁘고, 한 분포의 class와 다른 분포의 confidence를 섞는다는 문제가 있다. CoTS의 출발점은 zero-shot confidence가 adaptation된 모델을 calibration하는 label 없는 target이라는 점이다. 그래서 그것을 그대로 복사하는 대신 그쪽으로 temperature를 맞춘다.
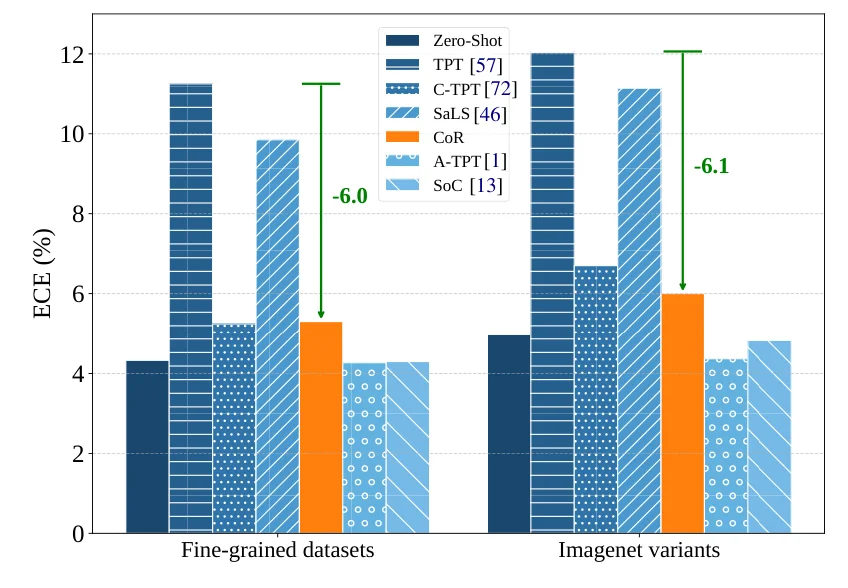 ViT-B/16에서 confidence replacement 예비 실험(CoR, 주황)의 평균 ECE를 zero-shot CLIP, TPT, 기존 calibration 방법들과 비교. Zero-shot confidence로 바꾸기만 해도 TPT의 ECE가 6.0(fine-grained), 6.1(ImageNet 변형) point 줄어 SaLS와 C-TPT보다 낮아지지만, A-TPT와 SoC는 여전히 더 낮다. 논문 Figure.
Method
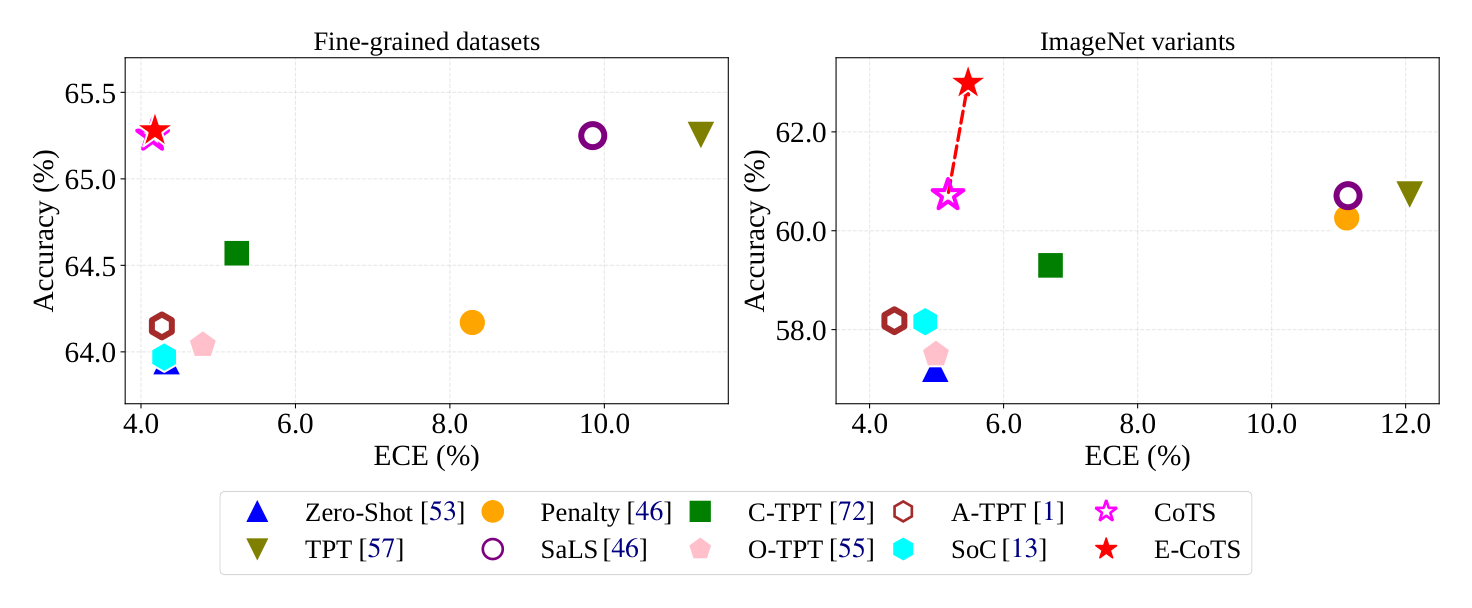 ViT-B/16으로 측정한 11개 fine-grained 데이터셋(왼쪽)과 4개 ImageNet 변형(오른쪽)에서의 평균 accuracy 대 ECE. Regularization 방법들은 왼쪽(낮은 ECE)으로 이동하지만 아래쪽(낮은 accuracy)으로도 이동한다. CoTS는 TPT의 accuracy를 유지한 채 왼쪽으로 이동하고, E-CoTS는 위쪽으로도 이동한다. 논문에는 별도의 파이프라인 그림이 없으며, 이것은 동기를 설명하는 Figure 1이다. 그림은 논문에서 가져왔다.
Setup
CLIP은 image embedding \(v\)와 class text embedding \(t_k\) 사이의 logit \(\textbf{z}_{k}=(v^{T} t_{k})/\tau_{\text{clip}}\)을 계산한다. TPT는 테스트 이미지의 64개 view를 만든다. Weak view \(\mathcal{A}_1(x)\)(원본 이미지)와 63개의 AugMix view이다. Confidence가 가장 높은 10%의 view를 남기고, 그 평균 예측의 entropy를 prompt에 대한 한 번의 gradient step으로 최소화한다. Tuning 후와 tuning 전의 logit을 각각 \(\textbf{z}^{tpt}\)와 \(\textbf{z}^{zs}\)라 하자.
Pilot study: confidence replacement
각 샘플에 대해 TPT의 예측 클래스는 유지하되, confidence로는 zero-shot 최대 확률을 보고한다. 이 “CoR”은 ECE를 SaLS와 C-TPT보다 낮추는데, 이는 TPT의 miscalibration이 주로 confidence 부풀림임을 시사한다. 하지만 이 경우 클래스와 confidence가 서로 다른 두 분포에서 나온다. CoTS는 temperature만 바꾸는 방식으로 이를 해결한다.
CoTS: temperature from the confidence gap
표준 temperature scaling은 label이 있는 validation set에서 NLL을 최소화해 \(\tau\)를 맞추는데, 테스트 시점에는 그런 set이 없다. CoTS는 대신 zero-shot confidence를 target으로 삼는다. Adaptation 후 entropy가 낮은 strong view \(\Omega\)(weak view를 제외한 상위 10%)를 고르고 다음을 맞춘다.
\[\tau^{*}=\arg\min_{\tau}\frac{1}{|\Omega|}\sum_{i\in\Omega}\left(\max_{k}\hat{\textbf{p}}^{tpt}_{k}(\mathcal{A}_{i}(x);\tau)-\max_{k}\textbf{p}_{k}^{zs}(\mathcal{A}_{i}(x))\right)^{2},\]여기서 \(\hat{\textbf{p}}^{tpt}(\cdot;\tau)\)는 \(\textbf{z}^{tpt}/\tau\)의 softmax이다. Temperature는 50 step 동안 학습된다. 출력은 맞춘 temperature에서의 weak view 예측 \(\hat{\textbf{p}}^{tpt}(\mathcal{A}_1(x);\tau^{*})\)이다. 양의 temperature 하나는 argmax를 바꾸지 않으므로 accuracy는 TPT와 정확히 같다. Weak view 하나 대신 여러 strong view로 맞추면 confidence에 더 많은 변화가 생긴다. Ablation은 weak view만으로 맞추면 CoR보다 나쁘다는 것을 보여 준다.
E-CoTS: weak-strong ensemble
Accuracy도 얻기 위해, E-CoTS는 weak view와 선택된 strong view들을 각각 맞춘 temperature에서 평균한다.
\[\hat{\textbf{p}}_{ens}=\alpha\cdot\hat{\textbf{p}}^{tpt}(\mathcal{A}_{1}(x);\tau^{*})+(1-\alpha)\cdot\frac{1}{|\Omega|}\sum_{i\in\Omega}\hat{\textbf{p}}^{tpt}(\mathcal{A}_{i}(x);\tau^{*}).\]Weight는 \(K\)개 text embedding의 평균 pairwise cosine similarity \(\alpha=\frac{1}{K(K-1)}\sum_{i\neq j}t_{i}^{T}t_{j}\)이다. Class text들이 서로 비슷하면 entropy 기반 view selection의 신뢰도가 떨어지므로, 원본 이미지에 더 큰 weight를 준다. 이 \(\alpha\)는 text 쪽에만 의존하므로 tuning 없이 task별로 정해진다. 논문은 ensemble만으로는 accuracy가 오르지만 calibration이 나빠진다고 보고하며, 그래서 ensemble 안에서 temperature를 적용한다.
CoTS와 E-CoTS는 모두 adaptation 이후에 실행되므로, 어떤 regularization 방법 위에도 쌓을 수 있다.
Main Experiments
Backbone은 ViT-B/16과 ResNet-50이며, single-sample episodic 방식의 TPT로 3개 seed의 평균을 냈다. 평가 지표는 11개 fine-grained 데이터셋과 ImageNet-A/V2/R/Sketch에 대한 평균 top-1 accuracy(%)와 ECE(%)이다. 표는 논문의 Table 6(Table 1, 2와 ResNet-50 부록 표들의 평균)이다. Penalty와 SaLS는 Murugesan et al.(ECCV 2024)의 방법이다.
| Method | ViT FG Acc | ViT FG ECE | ViT IN-var Acc | ViT IN-var ECE | RN50 FG Acc | RN50 FG ECE | RN50 IN-var Acc | RN50 IN-var ECE |
|---|---|---|---|---|---|---|---|---|
| Zero-shot | 63.95 | 4.33 | 57.22 | 4.98 | 56.04 | 5.38 | 40.70 | 7.09 |
| TPT | 65.19 | 11.30 | 60.74 | 11.90 | 58.06 | 11.31 | 43.83 | 17.55 |
| C-TPT | 64.57 | 5.23 | 59.25 | 6.67 | 57.69 | 6.44 | 42.75 | 13.14 |
| Penalty | 64.21 | 8.28 | 60.24 | 10.99 | 57.52 | 8.41 | 43.66 | 17.02 |
| SaLS | 65.20 | 9.94 | 60.74 | 10.98 | 58.06 | 9.31 | 43.83 | 15.37 |
| O-TPT | 64.05 | 4.77 | 57.51 | 4.97 | 57.36 | 5.67 | 40.82 | 6.46 |
| A-TPT | 64.12 | 4.33 | 58.20 | 4.34 | 57.30 | 4.55 | 41.94 | 7.76 |
| SoC | 63.95 | 4.31 | 58.12 | 4.87 | 56.19 | 5.50 | 41.61 | 7.52 |
| CoTS | 65.19 | 4.28 | 60.74 | 5.30 | 58.06 | 5.04 | 43.83 | 6.87 |
| E-CoTS | 65.22 | 4.31 | 62.95 | 5.38 | 57.72 | 5.04 | 45.39 | 7.24 |
다른 방법에 plug-in (ViT-B/16, Table 3에서 발췌). 각 base 방법과 E-CoTS를 추가한 후의 accuracy / ECE.
| Base method | FG base | FG + E-CoTS | IN-var base | IN-var + E-CoTS |
|---|---|---|---|---|
| C-TPT | 64.57 / 5.23 | 64.64 / 4.16 | 59.25 / 6.67 | 62.74 / 5.14 |
| Penalty | 64.21 / 8.28 | 65.25 / 3.86 | 60.24 / 10.99 | 62.65 / 5.39 |
| O-TPT | 64.05 / 4.77 | 64.93 / 4.30 | 57.51 / 4.97 | 62.01 / 4.55 |
| A-TPT | 64.12 / 4.33 | 65.07 / 3.85 | 58.20 / 4.34 | 62.32 / 4.87 |
| SoC | 63.95 / 4.31 | 65.01 / 4.20 | 58.12 / 4.87 | 61.84 / 4.58 |
CoTS는 구조상 TPT의 accuracy를 유지하며 ECE를 zero-shot 수준 가까이 낮춘다. ViT-B/16 fine-grained 설정에서는 표에서 가장 낮은 ECE를 기록한다. 하지만 모든 곳에서 ECE가 가장 좋은 것은 아니다. A-TPT는 ImageNet 변형(4.34 vs. 5.30)과 RN50 fine-grained 설정에서 더 낮고, O-TPT는 RN50 ImageNet 변형에서 더 낮다. E-CoTS는 ImageNet 변형에서 가장 큰 accuracy 향상을 보이며(ViT-B/16에서 TPT의 60.74 대비 62.95), 추가되는 모든 regularization 방법의 accuracy를 끌어올린다. 다만 ImageNet 변형에서 A-TPT의 ECE는 높인다(4.34에서 4.87).
Figure 3의 ablation은 temperature를 어떤 view에서 맞출지와 어떤 distance를 쓸지를 확인한다. Weak view 하나로만 맞추면 CoR보다 나을 것이 없고, 상위 6개 strong view를 쓰면 ECE가 가장 낮다. L1, L2, L-infinity distance 선택은 거의 차이가 없다. 이 ablation 수치는 논문의 ablation 실행에서 나온 것이라 main table과 조금 다르다.
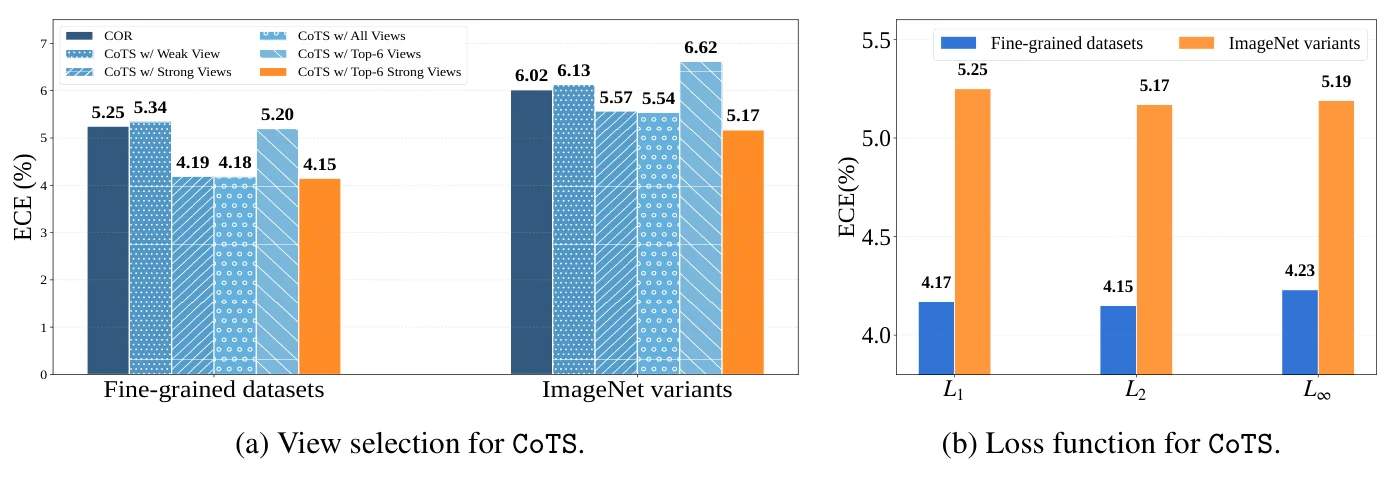 ViT-B/16에서 CoTS의 ablation. (a) temperature를 맞추는 view, (b) confidence matching loss에 쓰는 distance. 두 benchmark 모두에서 strong view(주황, 상위 6개)로 맞추는 쪽이 weak view와 CoR보다 낫고, loss 선택은 ECE를 0.1 point 미만으로만 바꾼다. 논문 Figure.
부록의 reliability diagram은 DTD, Flowers, Pets, ImageNet-V2에서 A-TPT와 CoTS, E-CoTS를 비교한다. CoTS와 E-CoTS는 TPT의 예측을 유지하면서도 A-TPT만큼 diagonal 가까이에 머물며, 남은 큰 gap은 대부분 sample이 적은 low-confidence bin에 있다.
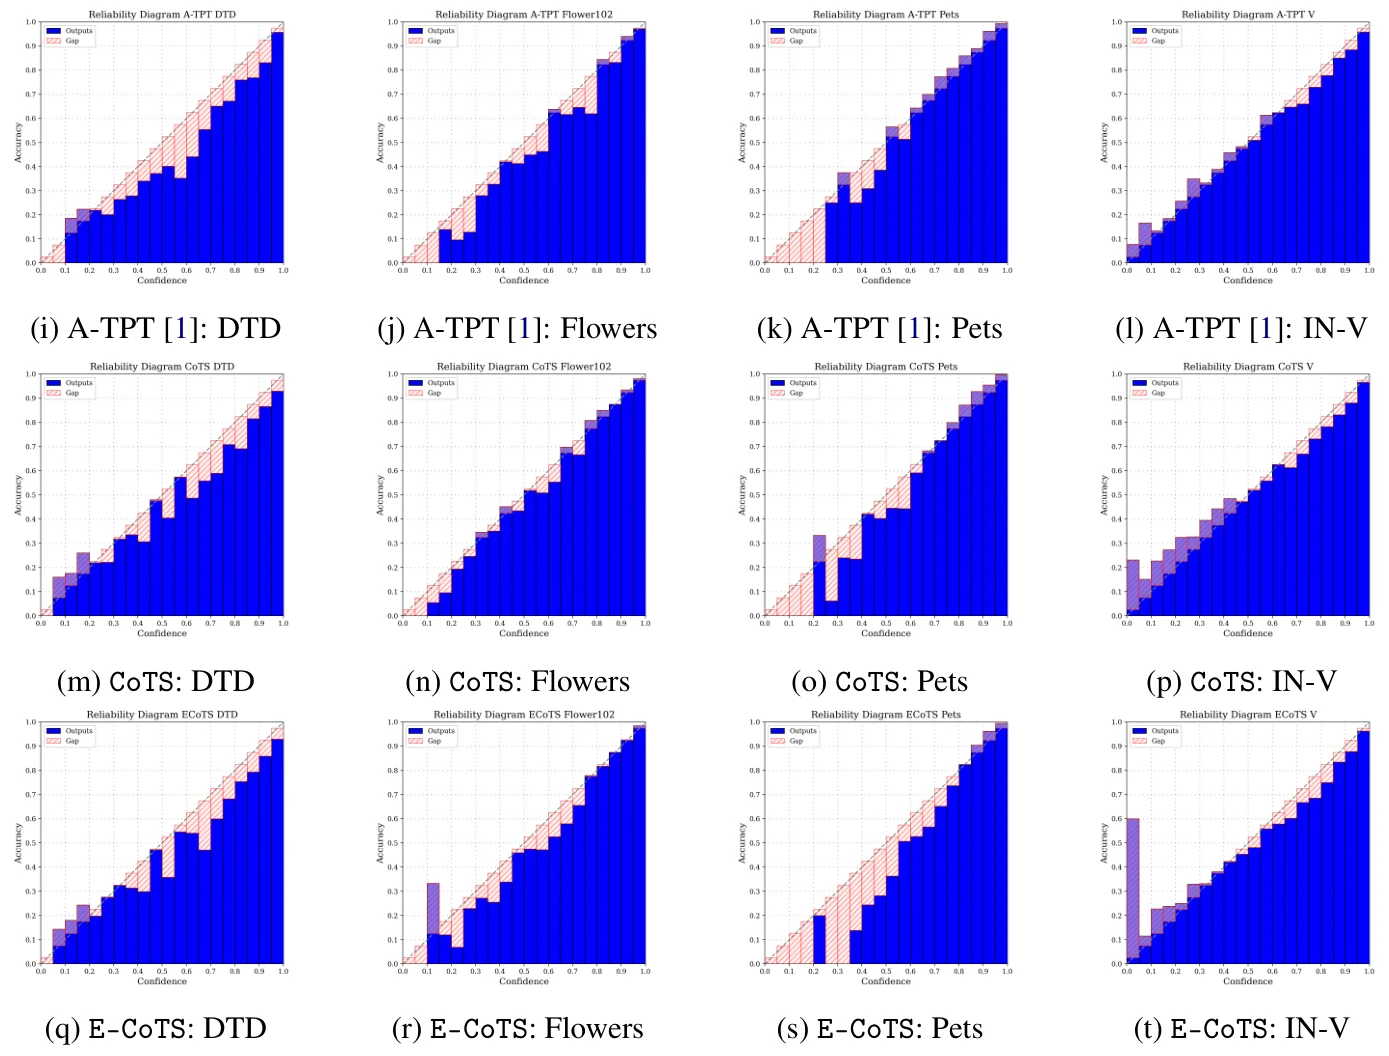 DTD, Flowers, Pets, ImageNet-V2에서 A-TPT(위), CoTS(가운데), E-CoTS(아래)의 reliability diagram. Bar가 diagonal에 가까울수록 confidence가 calibration된 것이다. 눈에 띄는 gap은 E-CoTS의 ImageNet-V2 첫 bin처럼 sample이 적은 low-confidence bin에 주로 있다. 논문 Figure.
Limitations
- 범위 (저자들이 직접 언급). Classification만 평가했다. Segmentation, detection, adversarial robustness는 열린 문제로 남아 있다.
- 추가 연산 (저자들이 직접 언급). Temperature fitting은 TPT의 0.19~0.22 s에 더해 샘플당 약 0.053~0.054 s를 추가하며(DTD와 ImageNet-A, ViT-B/16), 모든 view에 대한 zero-shot logit이 필요하다.
- Calibration이 zero-shot에 의해 제한된다. Target이 zero-shot confidence이므로, CoTS는 기껏해야 zero-shot CLIP의 calibration을 물려받을 수 있다. 표에서 CoTS의 ECE는 zero-shot ECE 근처에 머물며, ViT-B/16의 ImageNet 변형에서는 그보다 높다(5.30 vs. 4.98). 어떤 domain에서 zero-shot CLIP의 calibration이 나쁘다면, 이 방법에는 그것을 바로잡을 수단이 없다.
- CoTS만으로는 ranking이 개선되지 않는다. 샘플당 temperature 하나는 어떤 클래스를 예측하는지 바꾸지 않는다. Accuracy 향상은 모두 E-CoTS의 ensemble에서 나온다.
- E-CoTS는 calibration을 일부 되돌려 줄 수 있다. ViT-B/16의 ImageNet 변형에서 E-CoTS는 CoTS보다 ECE가 약간 높고(5.38 vs. 5.30), RN50 fine-grained 설정에서는 accuracy가 TPT보다 낮다(57.72 vs. 58.06).
- Preprint. 이 논문은 arXiv preprint이며 peer review를 거치지 않았다.