Abstract
Multimodal LLM이 이미지에 없는 object를 묘사할 때 가능한 설명은 두 가지이다. 모델이 이미지에 있는 것을 애초에 인식하지 못했거나, 인식했지만 그 정보가 이후에 덮어쓰였거나. 기존 training-free 해법(VCD, OPERA)은 language prior를 원인으로 가정하지만, network의 어디에서 visual 사실이 사라지는지는 확인하지 않는다. 또한 두 번째 forward pass나 비싼 beam 단위 penalty를 필요로 한다.
논문은 먼저 두 번째 설명이 흔하다는 것을 보인다. 중간 hidden state에 대한 probe는 object 존재 여부를 잘 맞히고, early exit으로 보면 올바른 token이 layer 20~28 근처에서 높은 확률을 가지다가 마지막 layer들에서 떨어지는 경우가 많다. DeCo(Dynamic Correction Decoding with preCeding-Layer Knowledge)는 이 점을 이용한다. 매 step마다 candidate token이 가장 확신하는 중간 layer를 고르고, 그 layer의 logit을 그 확신도로 scaling해 최종 logit에 더한다. 학습이 필요 없고, greedy, beam search, nucleus sampling 모두와 함께 쓸 수 있으며, latency는 약 1.2배 늘어난다.
Motivation
Finding 1: 모델은 object가 존재하는지 어느 정도 알고 있다. 저자들은 “Describe the image. ASSISTANT: The image contains obj.” prompt를 사용해, LLaVA-1.5(7B)의 32개 layer 각각에서 마지막 위치의 hidden state에 probe classifier를 학습한다. 학습 데이터는 MSCOCO로 만든 균형 잡힌 object/label 쌍 1,200개이다. 가장 좋은 probe는 AMBER caption과 POPE의 세 split에서 object 존재 여부를 잘 판별한다. 모델이 caption에서 존재하지 않는 object를 많이 언급하는데도, probe는 약 80% 이상의 accuracy를 유지한다. Probe accuracy는 중간 layer에서 가장 높고 출력 쪽으로 갈수록 떨어진다.
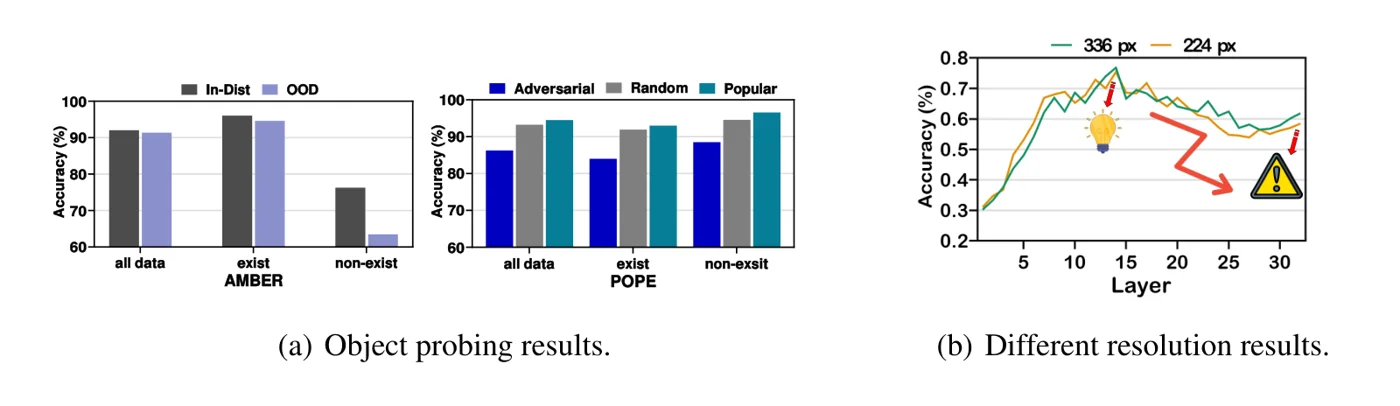 (a) AMBER(in-distribution과 OOD)와 POPE에서 가장 좋은 layer의 object 존재 probe accuracy. (b) 224 px와 336 px vision encoder에서 layer별 probe accuracy. Accuracy는 중간 layer에서 최고이고 마지막 layer로 갈수록 떨어진다. 논문 Figure.
Finding 2: language prior가 모델이 이미 본 것을 억누른다. 각 token을 early exit으로 layer를 따라가 보면 이 패턴이 직접 드러난다. 아래 예시에서 올바른 token(“people”, “left”)은 layer 18 근처에서 높은 확률에 도달해 유지된다. Hallucination인 “green”과 “bird”의 경우, ground-truth 대안(“blue”, “umbrella”)이 중간 layer(대략 layer 20~30)에서 높은 확률을 가지다가 layer 30부터 급격히 떨어지고, 마지막 layer에서는 hallucinated token이 이긴다.
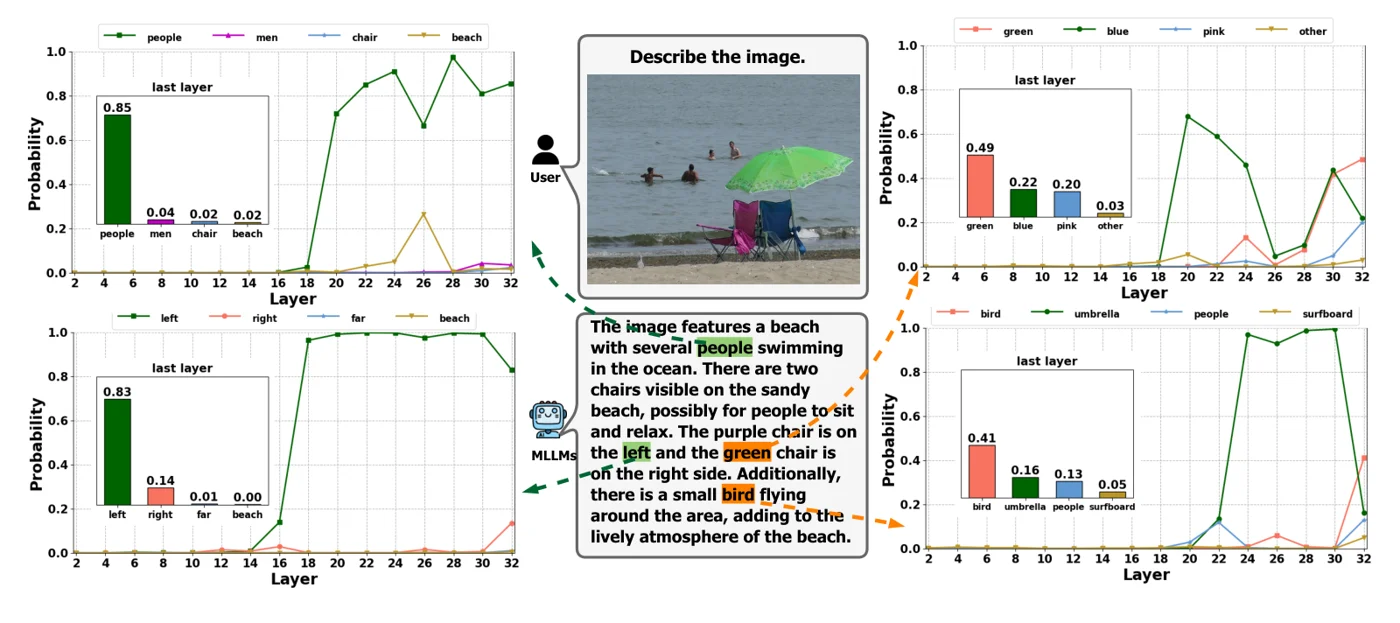 LLaVA caption의 네 위치에 대한 layer별 next-token 확률. 올바른 token(초록색, 왼쪽)은 중간 layer에서 확률이 올라 유지된다. Hallucinated token(주황색, 오른쪽)의 경우 ground-truth token(“blue”, “umbrella”)이 중간 layer에서 높다가 끝에서 떨어지고, “green”과 “bird”가 그 자리를 차지한다. 논문 Figure.
저자들은 이를 MSCOCO caption 500개로 정량화한다. 각 hallucinated object에 대해, candidate set의 ground-truth token이 앞선 어떤 layer에서 hallucinated token을 일정 margin 이상 앞서는지 확인한다. 이런 “activated” ground-truth token은 주로 layer 20~28 사이에 나타난다. 무엇이 이들을 끌어내리는지 보기 위해 이미지 없이 같은 prefix를 다시 넣으면, hallucinated token의 91.05%가 이미지 없이 만든 candidate set에도 들어 있다. 즉 hallucinated token은 대부분 language model이 어차피 말했을 token이다.
Method
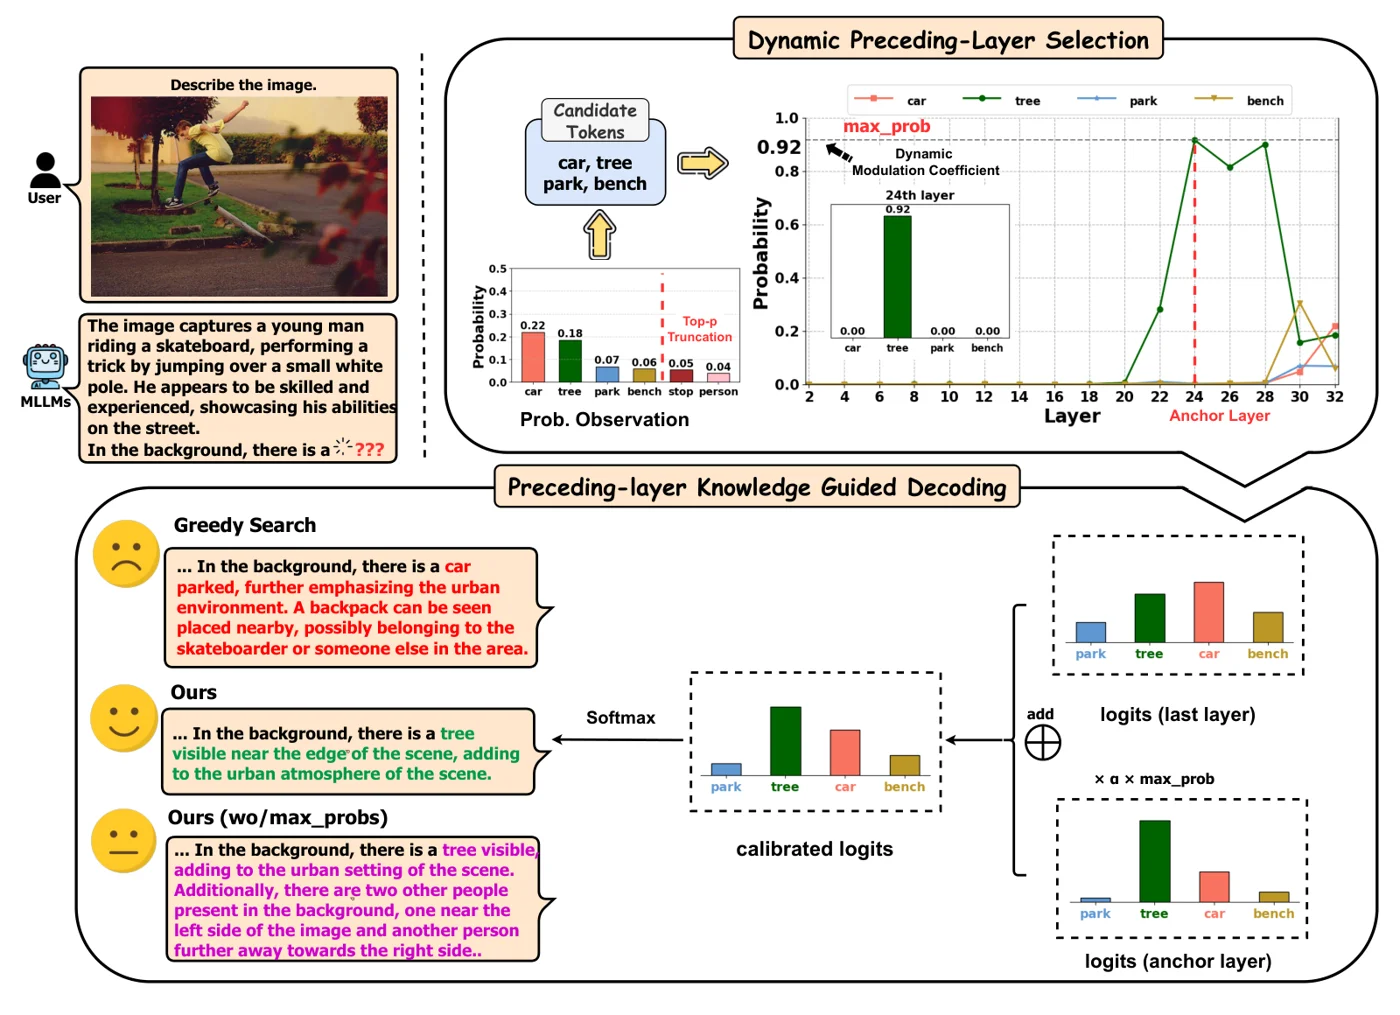 위: candidate token은 마지막 layer의 top-p truncation에서 오고, anchor layer는 candidate가 가장 높은 확률에 도달하는 앞선 layer이다(layer 24, “tree”, 0.92). 아래: \(\alpha\)와 max_prob로 scaling한 anchor layer의 logit을 최종 logit에 더한다. Plain greedy는 “car”라고 말하고 backpack까지 이어가지만, DeCo는 “tree”라고 말한다. Max_prob가 없으면 출력이 더 많은 hallucination으로 흘러간다. 논문 Figure.
Dynamic preceding-layer selection
탐색은 소수의 고품질 token으로 제한된다. Candidate set \(\mathcal{V}_{\text{candidate}}\)는 마지막 layer distribution의 top-p truncation이므로, 앞쪽 layer에서만 그럴듯하고 출력에서는 무의미한 token은 제외된다. Anchor layer는 고정된 범위 \([a, b]\) 안에서 어떤 candidate token이 가장 높은 확률을 가지는 layer이다.
\[A = \arg\max_{i \in [a, b]} \; \max_{x \in \mathcal{V}_{\text{candidate}}} \mathrm{softmax}\big(\phi(h^i_{T-1})\big)_x\]여기서 \(\phi\)는 early exit처럼 중간 hidden state에 적용한 LM head이다. 32-layer 7B 모델에서 \([a, b] = [20, 28]\)로 두면, 이렇게 고른 token이 ground-truth token일 비율(hit rate)은 61.69%이다(\([15, 28]\)에서는 71.14%).
Preceding-layer knowledge guided decoding
Anchor layer의 logit을 최종 logit에 더한다.
\[\mathrm{logits} = \phi(h^N_{T-1}) + \alpha \cdot \text{max\_prob} \cdot \phi(h^A_{T-1}), \qquad \text{max\_prob} = \max \mathrm{softmax}\big(\phi(h^A_{T-1})\big)\]\(\alpha\)(0.1~0.6)는 전체 강도를 정한다. Dynamic soft modulation 항인 max_prob는 anchor layer 자체가 확신하지 못할 때 보정을 약하게 만들어, candidate 사이의 근소한 차이가 logit의 급격한 변화로 이어지지 않게 한다. 보정된 logit은 어떤 decoding strategy에도 넘길 수 있다. Shallow semantics를 없애려고 앞쪽 layer를 빼는 DoLa와 달리, DeCo는 visual knowledge를 되살리려고 중간 layer를 더한다.
Main Experiments
MSCOCO val2014 이미지 500장, prompt “Please help me describe the image in detail.”에 대한 CHAIR(낮을수록 좋음). 모든 모델은 7B이다. 각 baseline은 자신의 decoding strategy 아래에서 비교한다.
| Decoding | Method | InstructBLIP CHAIRs | CHAIRi | MiniGPT-4 CHAIRs | CHAIRi | LLaVA-1.5 CHAIRs | CHAIRi | Qwen-VL CHAIRs | CHAIRi |
|---|---|---|---|---|---|---|---|---|---|
| Greedy | Vanilla | 58.8 | 23.7 | 31.8 | 9.9 | 45.0 | 14.7 | 46.0 | 12.5 |
| DoLa | 48.4 | 15.9 | 32.2 | 10.0 | 47.8 | 13.8 | 46.8 | 12.9 | |
| DeCo | 41.2 | 14.4 | 27.0 | 8.8 | 37.8 | 11.1 | 42.2 | 10.7 | |
| Beam Search | Vanilla | 55.6 | 15.8 | 30.6 | 9.5 | 48.8 | 13.9 | 41.8 | 10.8 |
| OPERA | 46.4 | 14.2 | 26.2 | 9.5 | 44.6 | 12.8 | 34.6 | 9.5 | |
| DeCo | 43.8 | 12.7 | 24.8 | 7.5 | 33.0 | 9.7 | 32.0 | 8.7 | |
| Nucleus | Vanilla | 54.6 | 24.8 | 32.6 | 10.7 | 48.8 | 14.2 | 49.2 | 13.1 |
| VCD | 58.0 | 17.0 | 33.8 | 11.1 | 54.0 | 16.0 | 46.4 | 11.9 | |
| DeCo | 43.6 | 12.9 | 30.8 | 9.5 | 42.8 | 13.2 | 43.8 | 11.8 |
POPE F1(높을수록 좋음):
| Decoding | Method | InstructBLIP | MiniGPT-4 | LLaVA-1.5 | Qwen-VL |
|---|---|---|---|---|---|
| Greedy | Vanilla | 80.0 | 58.5 | 82.2 | 85.2 |
| DoLa | 83.4 | 72.8 | 83.2 | 85.8 | |
| DeCo | 84.9 | 77.4 | 86.7 | 86.3 | |
| Beam Search | Vanilla | 84.4 | 70.3 | 84.9 | 85.3 |
| OPERA | 84.8 | 73.3 | 85.4 | 86.1 | |
| DeCo | 84.9 | 77.9 | 86.7 | 86.4 | |
| Nucleus | Vanilla | 79.8 | 52.8 | 83.1 | 84.5 |
| VCD | 79.9 | 56.0 | 83.1 | 84.7 | |
| DeCo | 81.8 | 63.8 | 85.4 | 85.2 |
- DeCo는 모든 모델과 decoding 설정에서 CHAIR를 낮추며, 평균 suppression은 약 10.8%이다. LLaVA-1.5에서 beam search를 쓰면 CHAIRs가 48.8에서 33.0으로 떨어지는데, OPERA는 44.6이다.
- 논문의 실험에서 VCD는 nucleus sampling 아래에서 CHAIRs를 오히려 높이는 경우가 많지만(예: LLaVA-1.5에서 48.8 → 54.0), DeCo는 낮춘다.
- COCO 이미지 100장에 대한 GPT-4o 평가에서 DeCo는 네 모델 모두 accuracy가 더 높다(LLaVA-1.5: 5.21 → 7.42). Detailedness와 coherence는 대체로 비슷하며 때로 약간 낮다. AMBER(LLaVA-1.5, greedy)에서는 CHAIR 8.2 → 6.6, Hal 34.3 → 28.1이고, Cover는 48.9 → 47.5이다.
- Max_prob를 빼면 CHAIRs가 LLaVA-1.5에서 37.8 → 41.2, Qwen-VL에서 42.2 → 45.8로 오른다. 선택된 layer를 최대 ±5만큼 무작위로 옮겨도 네 모델 모두에서 성능이 나빠진다.
DeCo는 forward pass가 이미 계산한 interval 내 9개 layer의 hidden state에 LM head만 적용하므로 비용이 낮다.
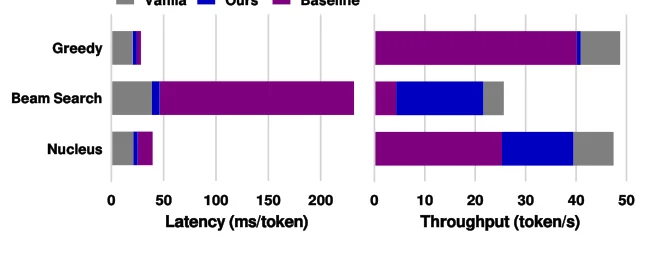 Vanilla decoding, DeCo, 그리고 대응하는 baseline(greedy는 DoLa, beam search는 OPERA, nucleus는 VCD)의 latency(ms/token)와 throughput(tokens/s). DeCo는 latency를 약 1.2배 늘리고, VCD는 1.8배, OPERA는 5.1배 늘린다. 논문 Figure.
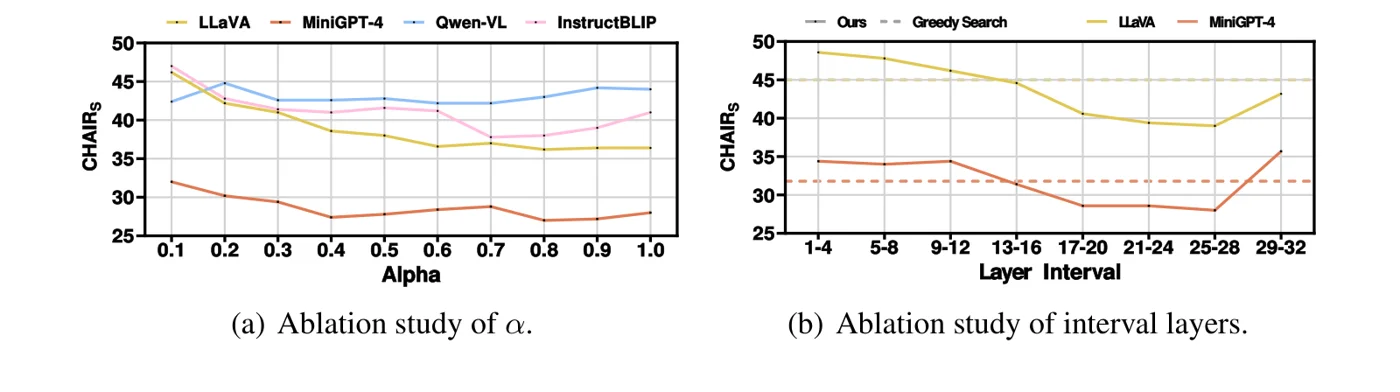 (a) 네 MLLM에서 \(\alpha\)에 따른 CHAIRs. \(\alpha\)가 커질수록 hallucination이 대체로 줄며, 논문은 0.6 근처에서 suppression이 가장 강하다고 보고한다. (b) Anchor layer를 서로 다른 4-layer interval에서 고를 때의 CHAIRs. Layer 1-16은 도움이 되지 않고, 17-28이 가장 도움이 되며, 29-32는 MiniGPT-4에서 greedy보다 나빠진다. 논문 Figure.
Limitations
- 고정된 layer interval. \([20, 28]\)은 7B, 32-layer 모델에 맞춰 고른 것이다. 저자들은 다른 계열이나 더 큰 모델은 실험으로 interval을 따로 찾아야 한다고 밝히며, 실험은 7B 모델에서만 이루어졌다.
- Hit rate가 높지 않다. Layer 20-28에서 anchor layer로 고른 token이 ground-truth일 비율은 61.69%뿐이다. 틀린 경우 DeCo는 logit을 틀린 token 쪽으로 밀며, max_prob scaling은 anchor layer가 확신하지 못할 때만 이를 완화한다.
- 반복과 detail. 저자들은 \(\alpha\)가 크면 단어가 반복되는 비정상적인 묘사가 나온다고 언급하며, DeCo는 GPT-4o 평가의 detailedness와 AMBER의 coverage를 약간 낮춘다.
- Contrastive가 아니라 additive. 중간 layer의 logit을 더하면 그 layer에 이미 있는 prior도 함께 더해진다. 이 방법은 prior를 직접 제거하는 것이 아니라, 그 layer들이 더 visual하다는 경험적 관찰에 기대고 있다.
- 평가 범위. 주된 평가는 caption의 object hallucination과 yes/no 형식의 POPE이다. 이미지 없는 candidate와의 91.05% overlap은 “language prior” 설명을 뒷받침하지만 상관관계에 그친다.