Abstract
AV-LLM은 audio와 video를 함께 decoder에 입력한다. Joint processing 덕분에 모델은 두 modality를 함께 추론할 수 있지만, 두 modality를 균형 있게 사용한다는 보장은 없다. 모델은 한 modality에 과도하게 의존할 수 있다(modality bias). Vanilla decoding에서는 video에 대한 attention이 audio에 대한 attention보다 훨씬 강하며, 이 불균형이 hallucination과 잘못된 추론으로 이어진다.
Fork-Merge Decoding(FMD)은 training-free 해결책이다. 입력을 video가 masking된 사본과 audio가 masking된 사본으로 fork하고, 각각을 처음 \(L_{\text{fork}}\)개 decoder layer에 독립적으로 통과시킨 뒤, hidden state를 merge하고 나머지 layer는 한 번만 실행한다. 초기 layer만 두 번 실행되므로 contrastive decoding보다 저렴하다.
Motivation
논문이 modality bias의 근거로 드는 것은 attention probe이다. 저자들은 100개의 AVHBench sample에서 VideoLLaMA2의 마지막 decoder layer를 읽어, 질문의 final token이 video token과 audio token에 각각 얼마나 attention을 주는지 본다. Vanilla decoding에서 video는 약 0.23, audio는 약 0.04의 attention을 받아 다섯 배 이상 차이가 난다. MLLM에 대한 기존 연구는 이런 불균형을 hallucination과 잘못된 reasoning에 연결하므로, 문제는 모델을 다시 학습하지 않고 약한 modality에 공정한 몫을 주는 방법이다.
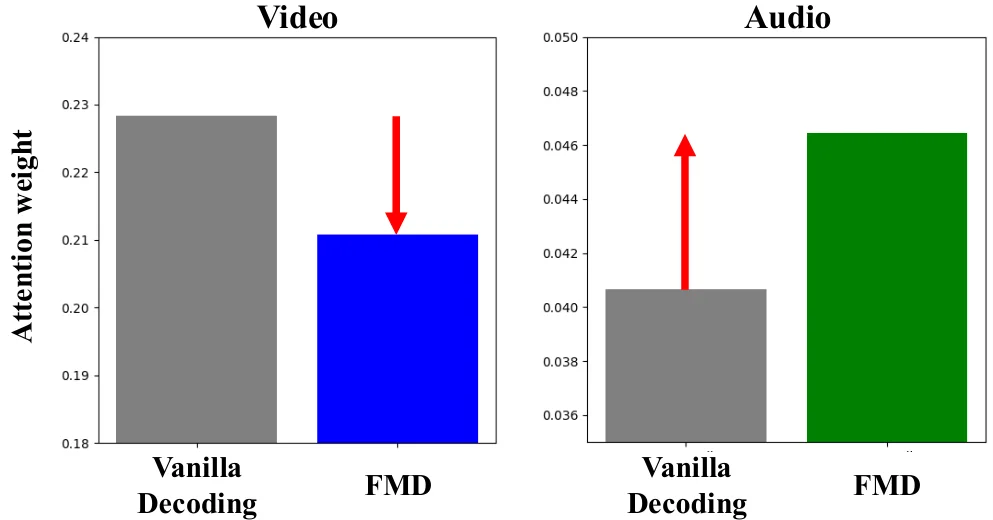 AVHBench 100개 sample에서 VideoLLaMA2의 final question token이 video(왼쪽)와 audio(오른쪽) token에 주는 마지막 layer attention. Vanilla decoding은 video를 크게 편애하고, FMD는 video attention을 낮추고 audio attention을 높인다. 두 y축의 범위가 다르다는 점에 주의. 논문 Figure.
두 번째 관찰은 어디서 나눌지를 정한다. LLM layer 구조에 대한 선행 연구를 따라, 저자들은 VideoLLaMA2의 모든 layer 쌍 사이 hidden state cosine similarity를 계산하고 같은 세 block을 찾는다. 작은 early block(layer 1~5), 큰 middle block, late block이다. Early layer에서는 각 modality의 feature가 정렬되고 따로 encoding되며, cross-modal fusion은 주로 middle에서 일어난다. 따라서 audio와 video가 early block을 따로 통과하게 하고 middle block 전에 합치면, 모델이 fusion하는 방식은 바꾸지 않으면서 각 modality 자체의 representation을 강화할 수 있다.
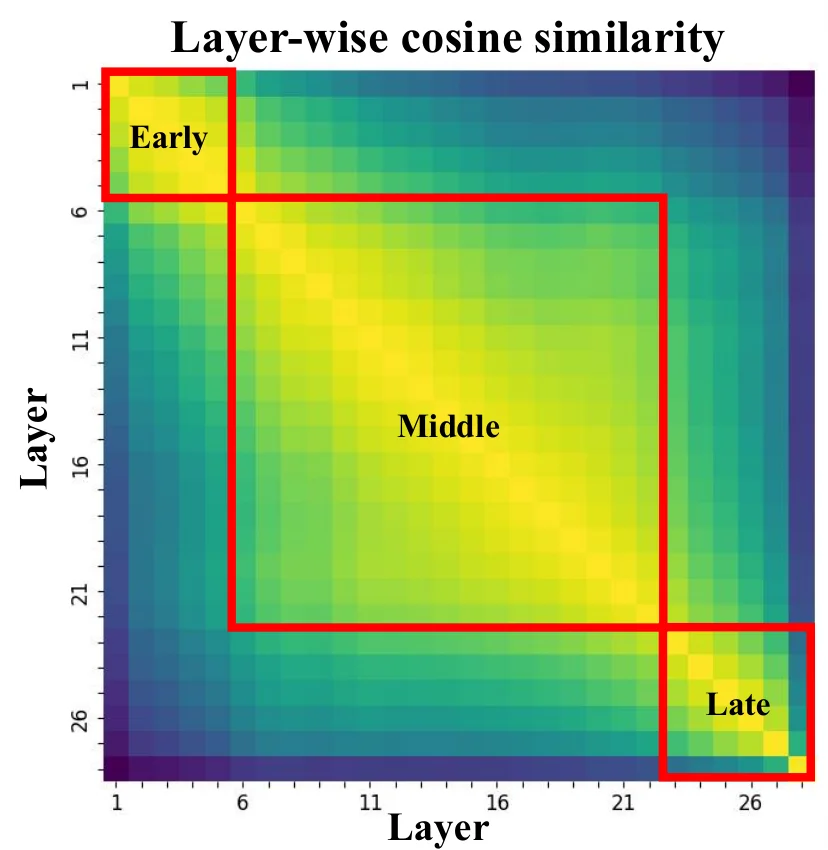 VideoLLaMA2의 모든 decoder layer 쌍 사이 hidden state cosine similarity. Layer들은 early, middle, late block으로 묶이며, FMD는 early block 안에서 fork depth를 고른다. 논문 Figure.
Method
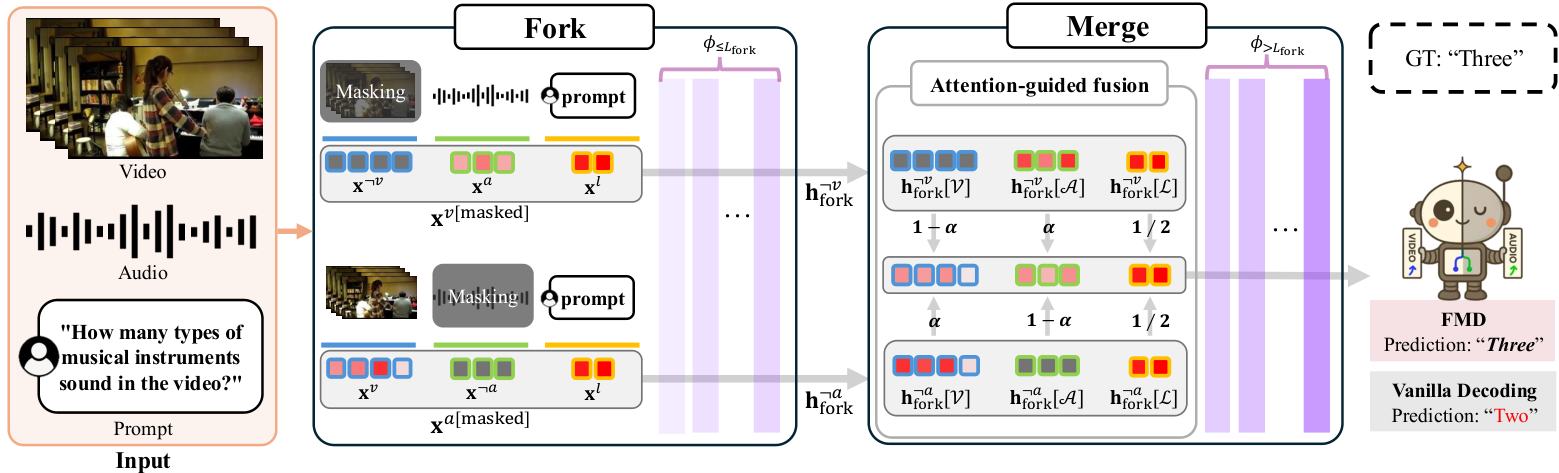 Fork: masking된 두 입력이 초기 decoder layer를 각각 따로 통과한다. Merge: 두 hidden state를 modality 영역별로 attention 기반 가중치로 융합하고, 나머지 decoder는 한 번만 실행한다. 그림은 논문에서 가져왔다.
Fork
입력의 각 사본은 한 modality가 masking되어 있고, 질문은 두 사본 모두에 그대로 남는다.
\[x_{v[\text{masked}]} = x^{\neg v} \oplus x^a \oplus x^l, \qquad x_{a[\text{masked}]} = x^v \oplus x^{\neg a} \oplus x^l\]Masking은 encoder에 들어가기 전에 원본 video frame이나 audio waveform을 0으로 만드는 방식이므로, sequence 형태와 position은 그대로 유지된다. Decoder \(\phi\)에 대해 각 사본은 처음 \(L_{\text{fork}}\)개 layer만 통과한다.
\[h^{\neg v}_{\text{fork}} = \phi_{\le L_{\text{fork}}}\big(x_{v[\text{masked}]}\big), \qquad h^{\neg a}_{\text{fork}} = \phi_{\le L_{\text{fork}}}\big(x_{a[\text{masked}]}\big)\]\(h^{\neg v}\)는 audio와 text를, \(h^{\neg a}\)는 video와 text를 담는다. 초기 layer에서 모델은 audio와 video를 동시에 보지 않으므로, 어느 쪽도 다른 쪽을 압도할 수 없다.
Merge
Hidden state는 video(\(\mathcal{V}\)), audio(\(\mathcal{A}\)), language(\(\mathcal{L}\)) token position별로 따로 merge된다.
\[\begin{aligned} h_{\text{merge}}[\mathcal{V}] &= (1-\alpha)\, h^{\neg v}_{\text{fork}}[\mathcal{V}] + \alpha\, h^{\neg a}_{\text{fork}}[\mathcal{V}] \\ h_{\text{merge}}[\mathcal{A}] &= \alpha\, h^{\neg v}_{\text{fork}}[\mathcal{A}] + (1-\alpha)\, h^{\neg a}_{\text{fork}}[\mathcal{A}] \\ h_{\text{merge}}[\mathcal{L}] &= \tfrac{1}{2}\big(h^{\neg v}_{\text{fork}}[\mathcal{L}] + h^{\neg a}_{\text{fork}}[\mathcal{L}]\big) \end{aligned}\]\(\alpha\)는 해당 position의 modality를 실제로 본 branch의 가중치이다. Language position은 두 branch 모두 text를 유지했으므로 평균을 취한다.
Attention-guided \(\alpha\). \(\alpha\)는 각 branch의 last-token attention 중 그 branch가 여전히 볼 수 있는 modality에 할당된 비율이다.
\[\alpha = \frac{\sum_{i \in \mathcal{A}} a^{v[\text{masked}]}_{\text{last}}[i] + \sum_{i \in \mathcal{V}} a^{a[\text{masked}]}_{\text{last}}[i]} {\sum_{i \in \mathcal{V} \cup \mathcal{A}} \big(a^{v[\text{masked}]}_{\text{last}}[i] + a^{a[\text{masked}]}_{\text{last}}[i]\big)}\]이후 나머지 layer는 merge된 state에 대해 한 번 실행된다: \(h_{\text{final}} = \phi_{> L_{\text{fork}}}(h_{\text{merge}})\).
Channel-wise 모델. 일부 AV-LLM은 video와 audio feature를 같은 token \([V;A]\)에 넣기 때문에, 가중치를 줄 별도의 영역이 없다. 이런 모델에 대해 FMD는 AV 영역에서는 두 branch를 더하고 text 영역에서는 평균을 취한다.
Main Experiments
FMD는 저자들이 실행할 수 있었던 모든 benchmark에서 세 backbone 모두를 향상시킨다. 정확도는 %이며, AV Cap.은 점수이다. Qwen2.5-Omni는 마지막 세 benchmark에서 out-of-memory가 발생했다.
| Model | Decoding | A→V | V→A | AV Mat. | AV Cap. | AVQA | MUSIC-AVQA | AVUT | WorldSense |
|---|---|---|---|---|---|---|---|---|---|
| VideoLLaMA2 | Vanilla | 80.02 | 77.03 | 57.75 | 2.84 | 60.23 | 81.30 | 44.44 | 29.41 |
| FMD | 80.45 | 77.52 | 59.01 | 2.95 | 61.46 | 81.50 | 45.13 | 29.91 | |
| video-SALMONN | Vanilla | 68.69 | 62.39 | 49.46 | 1.83 | 28.20 | 44.48 | 32.36 | 56.20 |
| FMD | 70.51 | 65.41 | 54.77 | 2.01 | 40.46 | 50.60 | 32.85 | 57.83 | |
| Qwen2.5-Omni | Vanilla | 80.77 | 71.20 | 77.45 | 3.25 | 86.49 | N/A | N/A | N/A |
| FMD | 81.30 | 71.77 | 78.22 | 3.36 | 86.61 | N/A | N/A | N/A |
VideoLLaMA2에서 training-free인 다른 decoding 방법들과 비교하면(AVHBench A→V / V→A / AV Mat.), LLM이나 VLM용으로 설계된 방법들은 모두 vanilla보다 낮다: DoLa 69.34 / 63.44 / 48.33, VCD 75.96 / 69.67 / 52.52, SID 78.53 / 72.82 / 53.52. FMD는 80.45 / 77.52 / 59.01을 기록한다.
| Decoding | Latency (s/token) | Relative |
|---|---|---|
| Vanilla | 0.34 | 1.00× |
| SID | 0.71 | 2.09× |
| VCD | 0.69 | 2.03× |
| DoLa | 0.54 | 1.59× |
| FMD | 0.43 | 1.26× |
- video-SALMONN에서는 향상 폭이 크지만(AVQA +12.3, MUSIC-AVQA +6.1), VideoLLaMA2와 Qwen2.5-Omni에서는 대부분 1.5점 미만이다.
- Merge 규칙이 중요하다. 단순 평균을 쓰면 V→A 정확도가 55.31로 무너진다.
아래 정성적 예시에서 vanilla decoding은 보이는 것만 묘사하지만, FMD는 개울 소리와 물 튀는 소리까지 말한다. Attention probe가 무시되고 있다고 시사한 바로 그런 audio 정보이다.
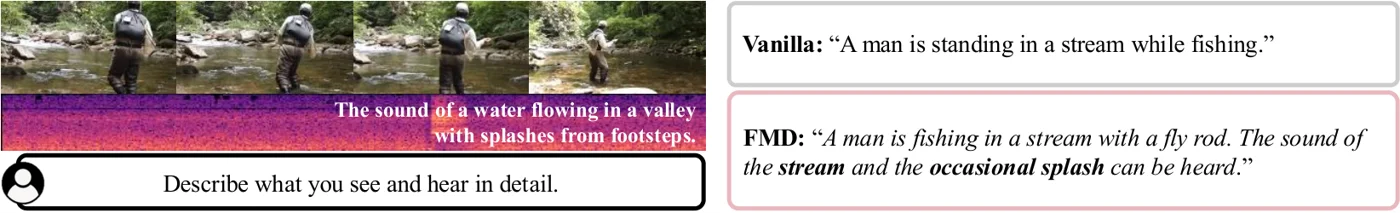 VideoLLaMA2의 audio-visual description 예시. Vanilla decoding은 video만 담은 caption을 내고, FMD는 audio 내용(개울 소리와 간간이 들리는 물 튀는 소리)을 더한다. 논문 Figure.
Task마다 AVHBench 200개 sample로 한 fork depth sweep은 선택된 \(L_{\text{fork}}\) 뒤의 trade-off를 보여 준다. 일찍 merge하면 A→V와 AV matching accuracy가 vanilla 이상으로 유지되고, 더 깊이 fork하면 V→A(audio 대상) 질문은 좋아지지만 나머지 둘은 약 layer 15 이후 크게 떨어진다.
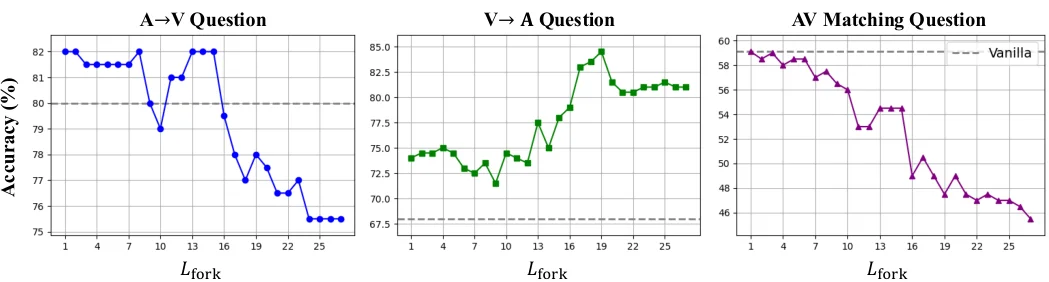 A→V, V→A, AV matching 질문에 대해 \(L_{\text{fork}}\)에 따른 FMD 적용 VideoLLaMA2의 accuracy(각 200개 AVHBench sample, 점선은 vanilla). 세 질문 모두에 최적인 depth는 없고, 논문은 early depth를 고른다. 논문 Figure.
Limitations
- Fork depth는 타협의 산물이다. \(L_{\text{fork}}\) sweep에서 A→V 질문은 일찍 merge할 때 가장 좋고, V→A 질문은 더 깊이 fork할수록 좋아지며, AV matching 정확도는 fork가 깊어질수록 떨어진다. 하나의 고정값이 모든 질문 유형에 최적일 수는 없다.
- 강한 backbone에서는 향상이 작다. VideoLLaMA2와 Qwen2.5-Omni에서는 대부분의 향상이 1.5점 미만이다.
- Hallucination이 아니라 불균형을 다룬다. FMD는 modality 사용의 균형을 다시 맞춘다. Contrastive 방법인 AVCD나 MAD와 달리, hallucination된 답을 억제하는 명시적 메커니즘은 없다.