Abstract
Test-time prompt tuning(TPT)은 augmented view들에 대한 prediction entropy를 최소화하여 CLIP의 text prompt를 각 test image에 맞게 조정한다. 이는 정확도를 높이지만 모델을 overconfident하게 만든다. C-TPT와 O-TPT는 class text feature를 서로 멀리 퍼뜨려(더 큰 dispersion, 또는 orthogonality) 이 문제의 일부를 해결한다. 이러한 diversity 기반 방법은 효과가 있지만 그 이유는 분명하지 않으며, 저자들은 text feature의 dispersion이 낮은데도 calibration이 좋은 사례를 보여준다.
이 논문은 대신 modality gap에 주목한다. CLIP에서 image feature와 text feature 사이의 gap은 modality마다 하나의 dominant dimension에 집중되어 있으며, 그 차원은 logit에 큰 영향을 미친다. Text-dominant dimension을 그 평균값으로 바꾸면 zero-shot CLIP과 TPT 모두에서 ECE가 낮아진다. D-TPT는 이를 loss로 바꾼다. 각 class text feature를 차원 위의 분포로 보고 이를 uniform distribution 쪽으로 밀어, 어느 한 차원도 지배하지 않도록 한다.
Motivation
C-TPT와 O-TPT는 class text feature가 더 퍼질수록(average text feature dispersion, ATFD가 클수록) ECE가 낮아진다는 경험적 관계에 기대고 있다. 논문의 첫 plot은 이 관계에 의문을 던진다. Zero-shot CLIP과 C-TPT는 ATFD가 높고, TPT는 ATFD가 낮으면서 ECE가 높은데, D-TPT는 ATFD가 TPT와 비슷하게 낮은데도 ECE가 낮다. 따라서 dispersion만으로는 설명이 되지 않고, 저자들은 confidence를 좌우하는 다른 요인을 찾는다.
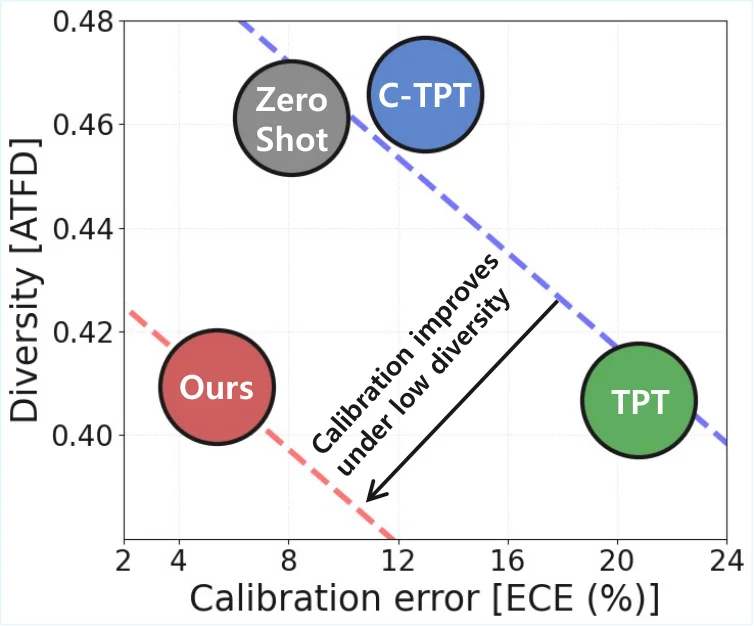 Zero-shot CLIP, TPT, C-TPT, D-TPT의 text feature diversity(ATFD)와 ECE. 파란 선을 따라서는 diversity가 클수록 ECE가 낮지만, D-TPT(“Ours”)는 TPT 정도의 diversity에서 calibration이 잘 되어 있어 diversity만으로는 calibration을 설명할 수 없다. 논문 Figure.
저자들이 지목하는 후보는 modality gap이다. Dimension별 feature 값을 그려 보면, CLIP text feature는 모든 class에서 값이 약 0.8인 dimension 하나(index 362)를 공유하고, image feature도 다른 index(442)에 자기만의 spike를 가진다. 이 spike는 class 사이에 공유되므로 class 정보보다는 두 modality 사이의 gap을 담고 있지만, logit을 만드는 dot product에서는 지배적인 역할을 한다. Text-dominant dimension을 masking하면 다른 어떤 dimension보다 prediction이 크게 바뀌고, 이를 평균값으로 바꾸기만 해도 accuracy는 거의 그대로인 채 TPT의 ECE가 12.34%에서 10.84%로 낮아진다. 이 예비 결과가 핵심 insight이다. Class들을 서로 밀어내지 않고도 dominant text dimension을 약하게 만들면 TPT를 calibration할 수 있다.
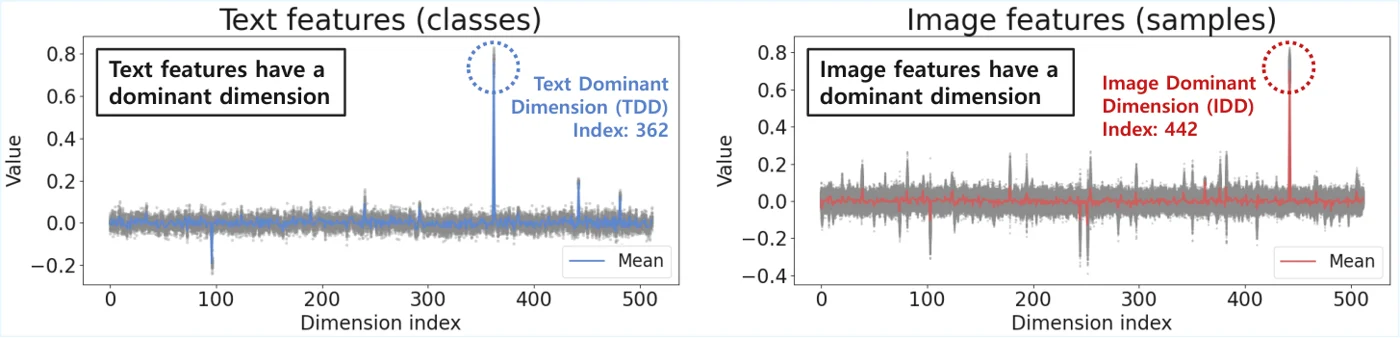 CLIP text feature(왼쪽, 모든 class)와 image feature(오른쪽, 모든 sample)의 dimension별 feature 값. 각 modality마다 나머지보다 훨씬 큰 dominant dimension이 하나 있고, 모든 class 또는 sample이 이를 공유한다. 논문 Figure.
Method
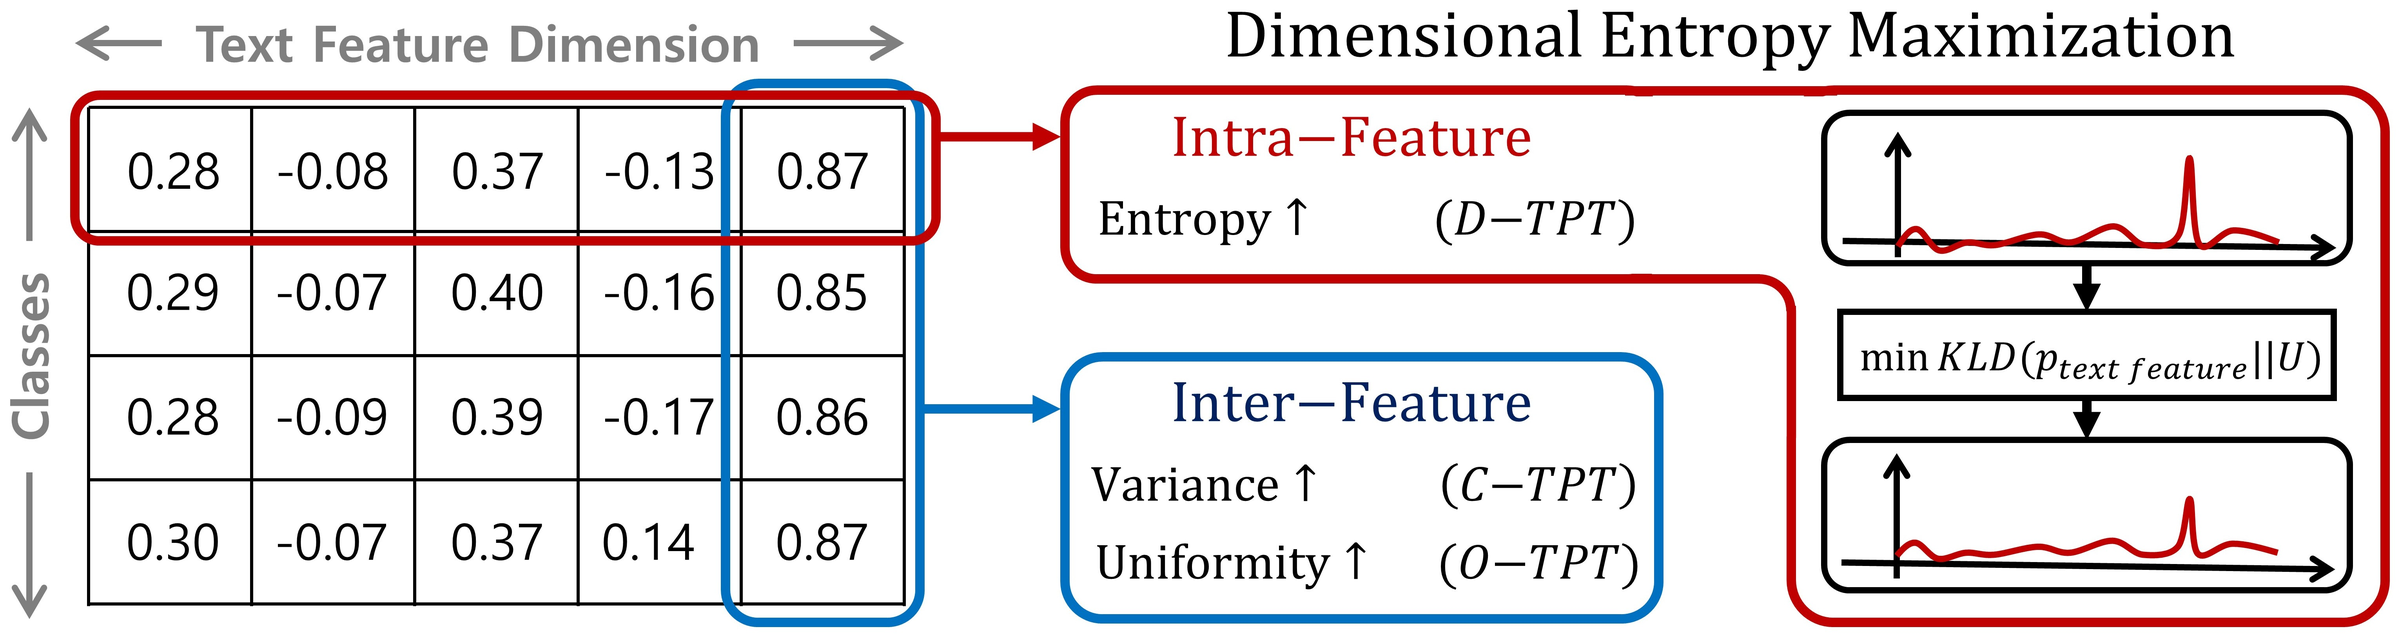 행은 class text feature, 열은 feature dimension이다. C-TPT와 O-TPT는 클래스들 사이에서(inter-feature) 작동한다. D-TPT는 각 text feature 내부에서(intra-feature) 작동하며 uniform distribution과의 KL divergence를 최소화하여 dominant dimension을 평탄하게 만든다. 그림은 논문에서 가져왔다.
Base: TPT
Feature \(v_i\)를 갖는 이미지 \(x_i\)와 prompt “a photo of a [class]”로부터 얻은 class text feature \(t_c\)에 대해 CLIP은 다음과 같이 예측한다.
\[p_{i,c}=\frac{\exp(\tau\cdot\cos(t_{c},v_{i}))}{\sum_{k=1}^{C}\exp(\tau\cdot\cos(t_{k},v_{i}))}.\]TPT는 test image의 augmented view \(N-1\)개를 만들고(총 64개 입력), confidence가 높은 것만 남긴 뒤 그 entropy를 최소화한다.
\[\mathcal{L}_{tpt}=\frac{1}{\rho N}\sum_{i=1}^{N}\mathbb{I}[H(p_{i})<\rho]\,H(p_{i}).\]Prompt token만 갱신된다. Test sample에 대한 예측이 끝나면 prompt는 초기화된다.
Dominant dimensions (left side of the figure)
그림의 표는 하나의 패턴을 보여준다. 한 열(마지막 열)이 모든 클래스에서 큰 값을 가진다. 저자들은 이를 text-dominant dimension(TDD)이라 부르고, image feature에서 이에 대응하는 것을 image-dominant dimension(IDD)이라 부른다. 각 차원 \(m\)의 sensitivity는 그 차원을 masking했을 때의 예측 \(p_m\)과 원래 예측 \(q\) 사이의 KL divergence로 측정한다.
\[s_{m}=KLD(p_{m}\,\|\,q).\]Dominant dimension의 sensitivity가 단연 가장 높다. TDD를 class-wise mean으로 대체하면 8개 데이터셋에서 TPT의 평균 ECE가 12.34%에서 10.84%로 떨어지며, 정확도는 거의 변하지 않는다(62.26%에서 62.19%). 반대로 IDD를 대체하면 ECE가 오히려 나빠진다(16.97%).
Dimensional entropy maximization (right side of the figure)
Dominant dimension을 직접 골라내지 않고 그 비중을 줄이기 위해, D-TPT는 normalize된 각 text feature \(\bar{t}_c\)의 차원들에 대해 softmax를 적용하고 그 분포를 uniform distribution \(U\) 쪽으로 끌어당긴다.
\[\mathcal{L}_{DEM}=\frac{1}{C}\sum_{c=1}^{C}KLD(\sigma(\bar{t}_{c})\,\|\,U).\]이 KL을 최소화하는 것은 \(\sigma(\bar{t}_c)\)의 entropy를 최대화하는 것과 같다. 전체 loss는 다음과 같다.
\[\mathcal{L}_{D\text{-}TPT}=\mathcal{L}_{TPT}+\lambda\cdot\mathcal{L}_{DEM},\]여기서 \(\lambda=10^{5}\)는 모든 데이터셋과 두 backbone에서 고정된다.
C-TPT, O-TPT와의 차이
그림의 왼쪽 아래 상자는 inter-feature 관점이다. C-TPT는 \(\frac{1}{C}\sum_{c}\lVert\bar{t}_{c}-\frac{1}{C}\sum_{j}\bar{t}_{j}\rVert_{2}\)를 더해 class feature를 centroid에서 멀어지게 한다. O-TPT는 \(\lVert TT^{\top}-I_{C}\rVert^{2}_{2}\)를 더해 feature들을 orthogonal하게 만든다. 둘 다 클래스들 사이에서 feature를 비교한다. D-TPT는 각 feature의 모양만 개별적으로 본다.
논문은 unit hypersphere 위에서의 기하학적 논증을 제시한다. TPT는 top-1 text feature를 tangent direction을 따라 이미지 쪽으로 옮기고 나머지는 밀어내는데, 이는 logit range를 넓혀 overconfidence를 일으킨다. D-TPT는 대신 질량을 다른 차원들로 분산시키며, 저자들은 이를 binormal direction이라고 설명한다. 실험적으로 D-TPT는 TPT와 비슷한 text dispersion(ATFD)을 유지하면서도 더 작은 logit range와 더 작은 modality gap을 보이며, logit range가 작을수록 softmax confidence가 낮아진다. 저자들은 이것이 완전한 이론이 아니라 기하학적 직관이라고 밝힌다.
Main Experiments
설정: CLIP ViT-B/16과 RN50, 63개 augmentation을 사용하는 single-sample TPT, lr 0.005의 AdamW. 수치는 11개 fine-grained 데이터셋(Table 1) 또는 4개 ImageNet variant A/V2/R/Sketch(Table 2)에 대한 평균이며, 각각 3개 seed의 평균이다. Standard deviation은 여기서 생략했다. ECE는 %, AURC는 \(\times 10^{3}\) 단위이며 둘 다 낮을수록 좋다. 논문은 AECE와 MCE도 보고하지만 여기서는 생략했다.
Fine-grained classification (11개 데이터셋 평균)
| Method | ViT-B/16 Acc. | ViT-B/16 ECE | ViT-B/16 AURC | RN50 Acc. | RN50 ECE | RN50 AURC |
|---|---|---|---|---|---|---|
| Zero-shot | 63.84 | 4.25 | 184.28 | 56.05 | 5.25 | 254.15 |
| TPT | 65.09 | 11.42 | 185.64 | 58.07 | 11.27 | 251.15 |
| C-TPT | 64.46 | 4.97 | 187.50 | 57.57 | 6.20 | 243.87 |
| O-TPT | 63.98 | 4.78 | 187.25 | 57.36 | 5.63 | 244.96 |
| D-TPT | 64.72 | 4.18 | 181.67 | 57.13 | 5.91 | 245.27 |
Natural distribution shift (ImageNet-A/V2/R/Sketch 평균)
| Method | ViT-B/16 Acc. | ViT-B/16 ECE | ViT-B/16 AURC | RN50 Acc. | RN50 ECE | RN50 AURC |
|---|---|---|---|---|---|---|
| Zero-shot | 57.19 | 4.93 | 216.23 | 40.66 | 7.19 | 395.77 |
| TPT | 60.24 | 11.77 | 211.24 | 43.35 | 17.06 | 383.07 |
| C-TPT | 58.33 | 5.42 | 210.52 | 41.76 | 8.99 | 390.19 |
| O-TPT | 58.48 | 5.14 | 209.91 | 41.74 | 8.97 | 390.24 |
| D-TPT | 57.87 | 3.83 | 211.31 | 42.92 | 8.05 | 379.73 |
(Zero-shot ECE는 굵은 표시에서 제외했다. Fine-grained RN50에서 zero-shot ECE 5.25는 tuning된 모든 방법보다 낮다.)
ViT-B/16에서 D-TPT는 두 benchmark 모두에서 tuning된 방법 중 가장 낮은 ECE를 기록하며, fine-grained 데이터셋에서는 정확도에서도 O-TPT를 앞선다(64.72 대 63.98). RN50 fine-grained에서는 C-TPT와 O-TPT 사이에 위치하며 최고가 아니고, 저자들도 이를 명시한다. D-TPT를 포함한 모든 calibration 방법은 여전히 TPT의 정확도 향상분 일부를 잃는다.
Reliability diagram은 ECE 개선이 어디서 오는지 보여 준다. DTD에서 TPT의 confidence histogram은 1.0 근처에 몰려 있고 모든 bin에서 gap이 크지만, D-TPT의 bar는 diagonal을 따라간다. 실패 사례인 Stanford Cars에서는 zero-shot CLIP이 이미 거의 calibration되어 있고 tuning된 방법들이 모두 비슷해서, D-TPT가 이길 여지가 없다.
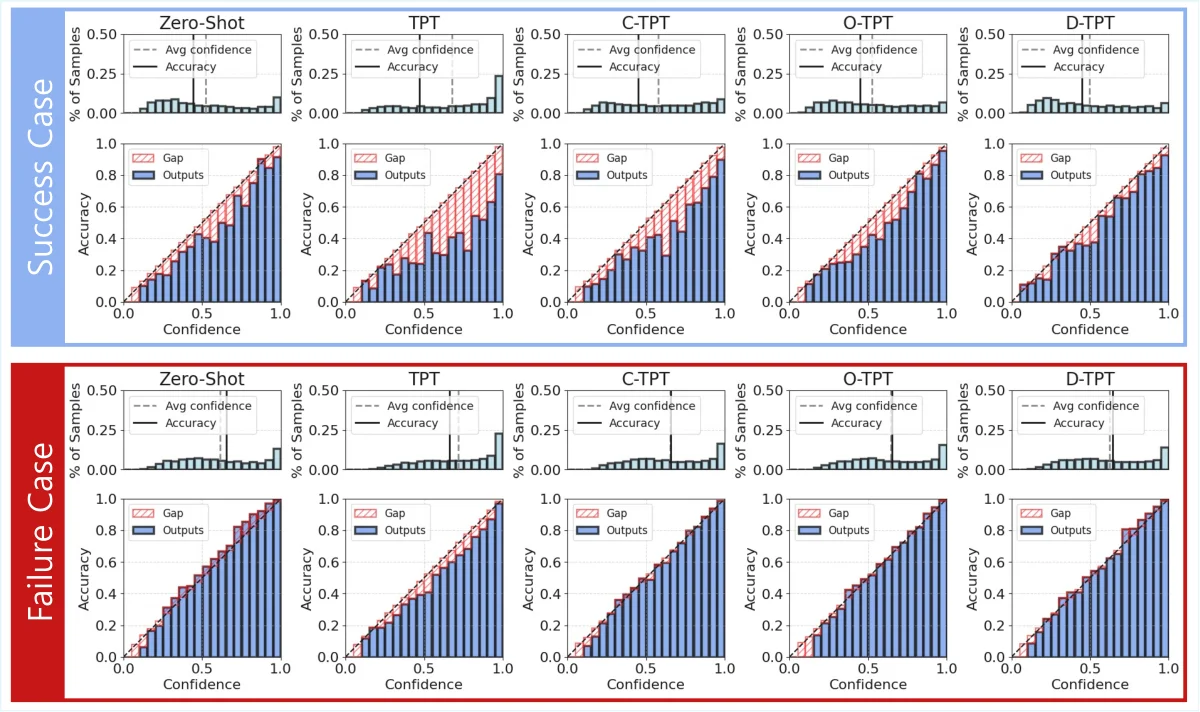 DTD(성공 사례, 위)와 Stanford Cars(실패 사례, 아래)에서 zero-shot CLIP, TPT, C-TPT, O-TPT, D-TPT의 confidence histogram과 reliability diagram. 빨간 빗금은 accuracy와 confidence의 gap이며, DTD에서 TPT의 gap이 크고 D-TPT의 gap이 가장 작다. 논문 Figure.
Pareto plot은 각 regularizer의 weight \(\lambda\)를 바꿔 가며 그린 것이다. DTD에서 D-TPT는 O-TPT가 가장 낮은 ECE일 때와 비슷한 accuracy에서 셋 중 가장 낮은 ECE(약 5.4%)에 도달하고, Flowers102에서는 O-TPT만큼 낮은 ECE를 유지하면서 accuracy가 확실히 높다(약 72% 대 69~70%).
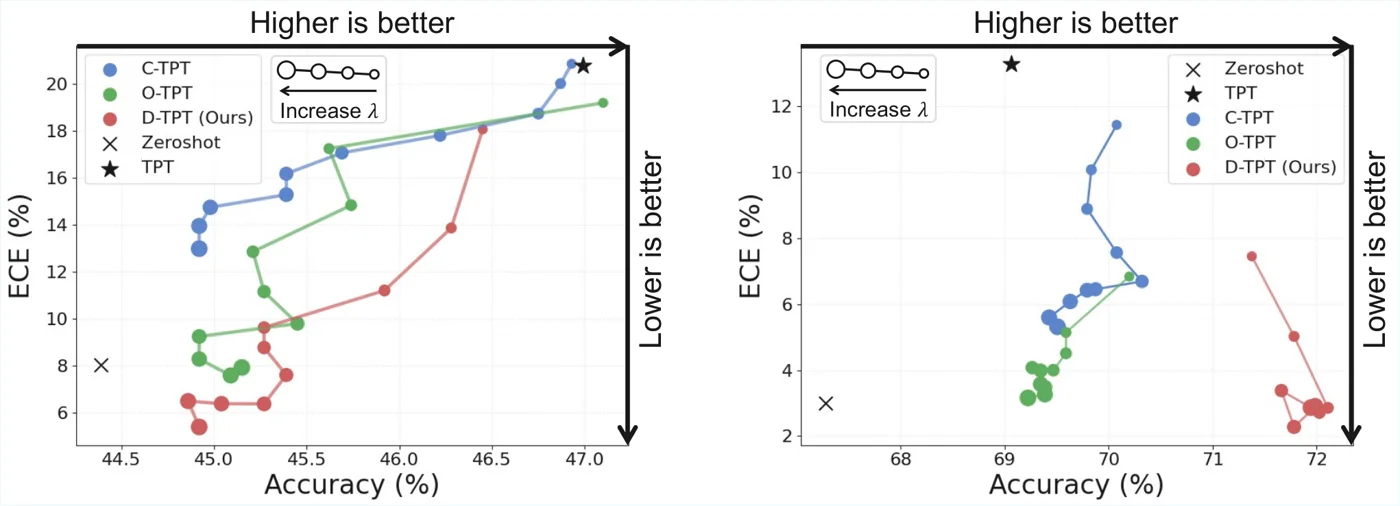 DTD(왼쪽)와 Flowers102(오른쪽)에서 \(\lambda\)가 커질 때(marker가 커질수록) C-TPT, O-TPT, D-TPT의 accuracy-ECE trade-off. 오른쪽 아래가 좋다. D-TPT는 inter-feature 방법들보다 accuracy를 덜 잃으면서 낮은 ECE에 도달한다. 논문 Figure.
Limitations
- 이론이 부분적이다 (저자들이 명시). 기하학적 논증은 text feature가 단일 image feature에 대해 움직이는 경우만 고려하지만, 실제 TPT는 여러 augmented view를 사용한다. Modality gap과 calibration 사이의 연결은 증명되지 않았다.
- RN50 fine-grained에서 최고가 아니다. 그 설정에서는 O-TPT의 ECE가, C-TPT의 AURC가 더 낮으며, D-TPT는 셋 중 정확도가 가장 낮다.
- 정확도 손실이 남아 있다. ViT-B/16의 ImageNet variant에서 D-TPT는 정확도가 O-TPT보다 0.61점, TPT보다 2.37점 낮다.
- MCE가 일관되게 좋지는 않다. Fine-grained ViT-B/16에서는 O-TPT의 MCE가 가장 좋으므로, calibration metric 전반에 걸쳐 향상이 균일하지 않다.
- 매우 크고 고정된 \(\lambda\). \(\lambda=10^{5}\)는 KL 항의 작은 크기를 반영한 값이다. 이는 모든 설정에서 고정되어 있으며, 그 영향은 DTD와 Flowers102에 대한 Pareto plot으로만 제시된다.
- Prompt initialization이 중요하다. CoOp으로 학습된 prompt로 초기화하면 D-TPT는 여전히 tuning된 방법 중 가장 낮은 ECE(6.96)를 보이지만, 그 설정에서 정확도(63.20)와 AURC(195.41)는 tuning된 네 방법 중 가장 나쁘다.
- CLIP에 특화된 전제. 이 방법은 CLIP feature에 하나의 dominant dimension이 있다는 관찰에 의존한다. 다른 contrastive VLM도 이 성질을 공유하는지는 검증되지 않았다.