Abstract
Point cloud classifier는 sensor noise, LiDAR artifact, 영역 누락 같은 corruption 앞에서 무너진다. 가능한 모든 distribution shift에 대비해 학습하는 것은 불가능하므로, 모델은 test time에 label 없이 online으로 적응해야 한다. 2D 이미지를 위한 test-time training(TTT) 방법은 존재하지만, 논문은 이를 point cloud로 옮기면 잘 작동하지 않음을 보인다. TENT와 SHOT 같은 entropy 방법은 한 번에 샘플 하나만 볼 때 붕괴하며, rotation prediction(TTT-Rot)은 평균적으로 적응하지 않은 모델보다도 낮다.
MATE는 3D point cloud를 위해 만들어진 최초의 TTT 방법이다. Self-supervised task로 masked autoencoding을 사용한다. 각 test point cloud에 대해 대부분의 token을 masking하고, 네트워크에게 전체 형상을 재구성하게 한 뒤, 그 reconstruction loss로 gradient step을 밟고, 갱신된 encoder로 샘플을 분류한다.
Motivation
논문은 두 가지 사실에서 출발한다. Jitter나 약간의 noise 같은 작은 perturbation만으로도 최신 3D recognition model이 흔들리며, 실제 sensor가 만드는 shift는 너무 다양해서 학습 단계에서 모두 대비할 수 없다. TTT가 자연스러운 답이지만, 당시 TTT 방법은 모두 2D 이미지에서 왔다: entropy minimization(TENT, SHOT), BN statistics 갱신(DUA), rotation prediction 같은 self-supervised auxiliary task(TTT-Rot). 저자들은 이 방법들을 point cloud에 그대로 적용하면 실패하며, 한 번에 샘플 하나만 보는 현실적인 online 상황에서 entropy 방법은 Source-Only 정확도의 절반 정도로 무너진다는 것을 보인다.
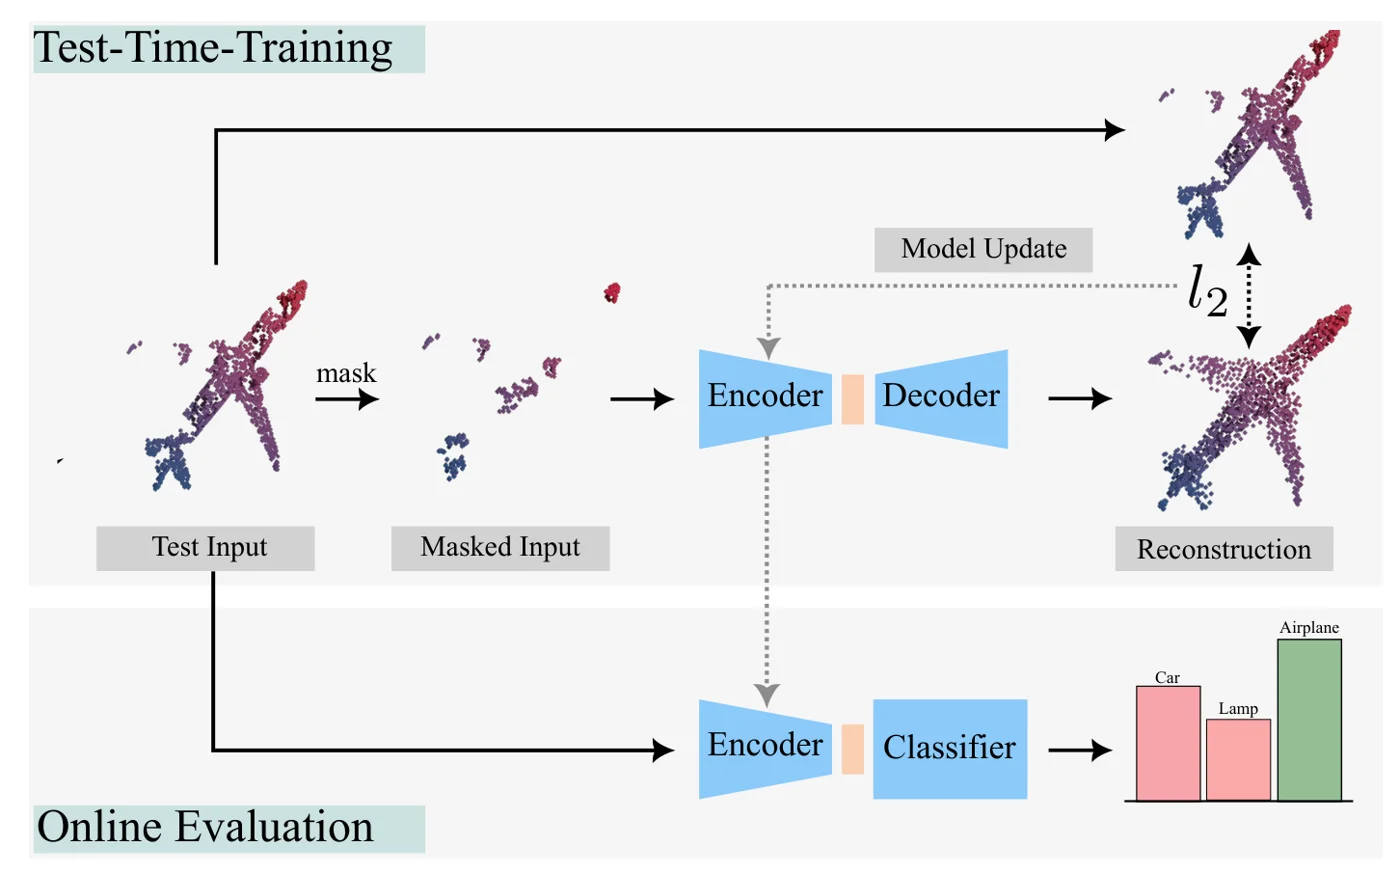 위: OOD test sample 하나를 masking하고 reconstruction한 뒤, reconstruction error(\(l_2\)로 표시)로 encoder를 갱신한다. 아래: 같은 샘플을 갱신된 encoder로 분류한다. 논문 Figure.
핵심 insight는 3D data에 맞는 self-supervised task가 이미 있다는 것이다. Masked autoencoding은 3D recognition network의 pretraining(Point-MAE)과 2D network의 corruption adaptation 모두에서 잘 작동하며, label이 필요 없다. Point cloud 대부분을 지우고 네트워크에게 다시 만들게 하면 된다. Classifier와 reconstruction head가 encoder를 공유한다면, corrupted test sample에 대한 reconstruction을 개선하는 것이 그 샘플을 더 잘 분류하는 feature 쪽으로 encoder를 옮길 것이다. 비용 면의 이점도 있다. Encoder는 보이는 token만 보므로, 90-95% masking에서는 각 갱신이 입력의 작은 일부만 다룬다.
Method
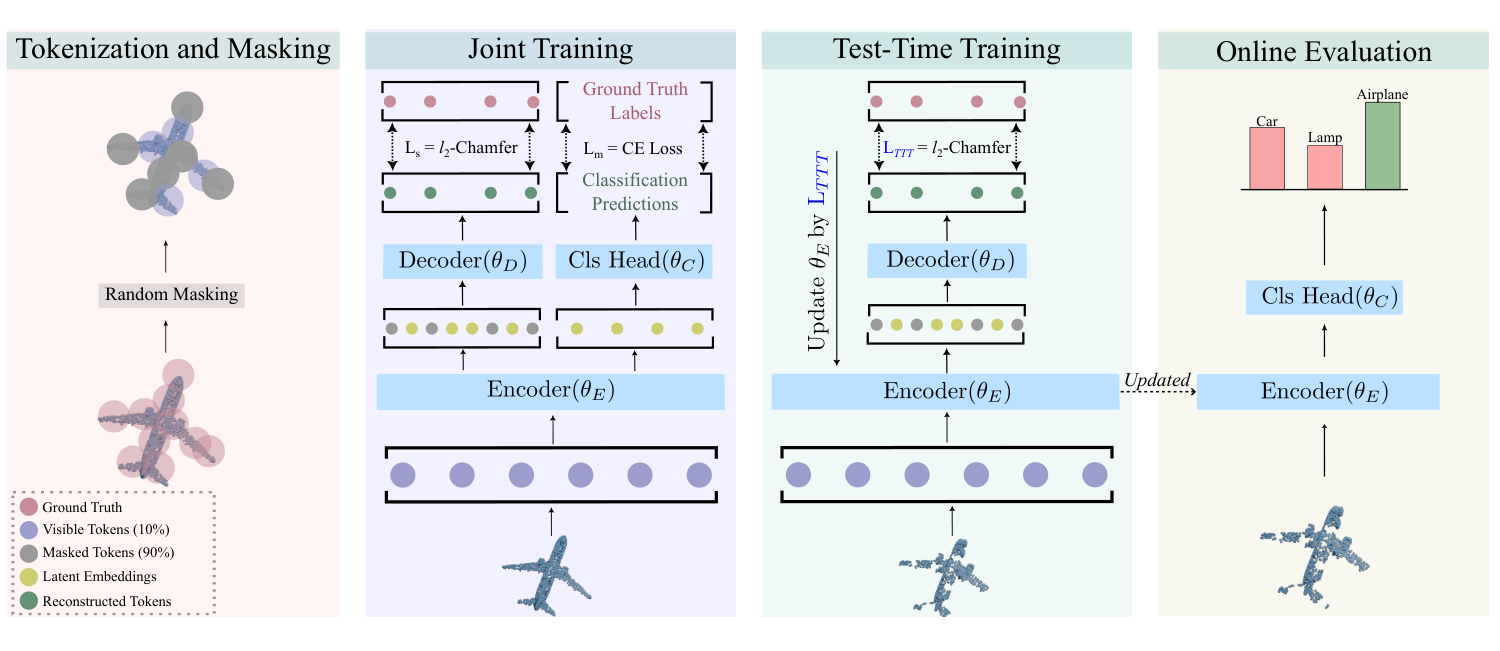 MATE의 네 단계: tokenization과 masking, classification과 reconstruction의 joint training, reconstruction loss만을 사용한 test-time training, 갱신된 encoder를 사용한 online evaluation. 그림은 논문에서 가져왔다.
Tokenization and masking
MATE는 Point-MAE를 기반으로 한다. Point cloud \(\mathcal{X}=\{\mathbf{p}_i\}_{i=1}^{N}\)는 token(farthest point sampling으로 뽑은 center 주변의 local patch)으로 묶인다. Token의 비율 \(m\)이 무작위로 masking된다. Masking된 token은 \(\mathcal{X}^{m}\), 보이는 token은 \(\mathcal{X}^{v}\)이다. MATE는 token의 90%를 masking하므로, encoder는 10%만 본다.
네트워크는 네 부분으로 이루어진다: 보이는 token만 보는 encoder \(E\)(Transformer block 12개), 가벼운 decoder \(D\)(block 4개), point 좌표를 출력하는 linear prediction head \(P\), 그리고 classifier head \(C\).
Joint training
Point-MAE는 보통 reconstruction으로 encoder를 pre-training한 다음 classifier를 fine-tuning한다. MATE는 대신 label이 있는 source data \(\mathcal{S}\)로 두 head를 함께 학습하여, encoder가 두 task 모두에 쓸모 있는 feature를 배우게 한다.
\[\min_{\theta_E,\theta_D,\theta_P,\theta_C} \mathbb{E}_{(\mathcal{X},\mathcal{Y})\in\mathcal{S}} \big[ L_c(\mathcal{X},\mathcal{Y};\theta_E,\theta_C) + \lambda \cdot L_s(\mathcal{X};\theta_E,\theta_D,\theta_P) \big]\]여기서 \(\lambda=1\)이다. Classification loss는 보이는 token에 대한 cross entropy이고, self-supervised loss는 재구성 결과와 입력 사이의 Chamfer distance이다.
\[L_c = CE\big(C\circ E(\mathcal{X}^{v}), \mathcal{Y}\big), \qquad L_s = CD\big(P\circ D\circ E(\mathcal{X}^{v}), \mathcal{X}\big)\]Test-time training
Test time에 MATE는 label 없는 corrupted point cloud \(\tilde{\mathcal{X}}\) 하나를 받는다. 샘플을 masking하고 재구성한 뒤, reconstruction loss만 최소화한다.
\[L_{TTT} = \min_{\theta_E,\theta_D,\theta_P} L_s(\tilde{\mathcal{X}};\theta_E,\theta_D,\theta_P)\]Classifier head \(C\)는 고정된다. 샘플 하나로 쓸 만한 loss를 얻기 위해, MATE는 샘플을 48개로 복사해 batch를 만들고 각 사본을 서로 다르게 masking한다. Random masking이 augmentation 역할을 하므로 다른 test-time augmentation은 쓰지 않는다.
Online evaluation
갱신 후에는 전체 point cloud(모든 token, masking 없음)를 갱신된 encoder와 고정된 classifier에 통과시킨다. 두 가지 변형이 있다.
- MATE-Standard: 샘플마다 gradient step 20번을 밟고, 다음 샘플 전에 모든 weight를 초기화한다.
- MATE-Online: 샘플마다 gradient step 1번을 밟고, 갱신이 test stream에 걸쳐 누적된다.
Encoder는 보이는 token만 처리하므로, 높은 mask ratio가 test-time 비용을 낮게 유지시킨다. 논문은 token의 95%를 masking해도 90%와 거의 비슷하게 작동한다고 보고한다.
Main Experiments
Backbone: Point-MAE. 지표: 각 benchmark의 15개 corruption에 대해 평균한 top-1 accuracy(%). 모든 방법은 batch size 1(한 번에 test sample 하나)로 적응한다. 논문은 corruption별 수치를 보고하지만, 이 표는 Table 1, 3, 4의 평균 열만 보여준다.
| Method | ModelNet-40C | ShapeNet-C | ScanObjectNN-C |
|---|---|---|---|
| Source-Only | 53.9 | 57.6 | 45.7 |
| Joint-Training | 57.6 | 59.3 | 45.6 |
| DUA | 54.7 | 60.8 | 46.0 |
| TTT-Rot | 53.0 | 60.9 | 46.1 |
| SHOT | 26.6 | 36.2 | 38.3 |
| T3A | 55.7 | 54.4 | 40.3 |
| TENT | 26.5 | 37.4 | – |
| MATE-Standard | 64.3 | 63.1 | 47.0 |
| MATE-Online | 71.3 | 69.1 | 48.5 |
2D baseline에 더 공정한 기회를 주기 위해 ModelNet-40C에서 batch size 128을 사용한 경우(Table 2, mean accuracy %):
| Source | TENT | SHOT | T3A | MATE-Online |
|---|---|---|---|---|
| 53.9 | 65.6 | 63.8 | 55.9 | 74.5 |
ModelNet-40C의 corruption별 표를 보면 MATE-Online이 거의 모든 열에서 이기며, 예외는 TTT-Rot(34.5)과 T3A(33.4)가 앞서는 background이다.
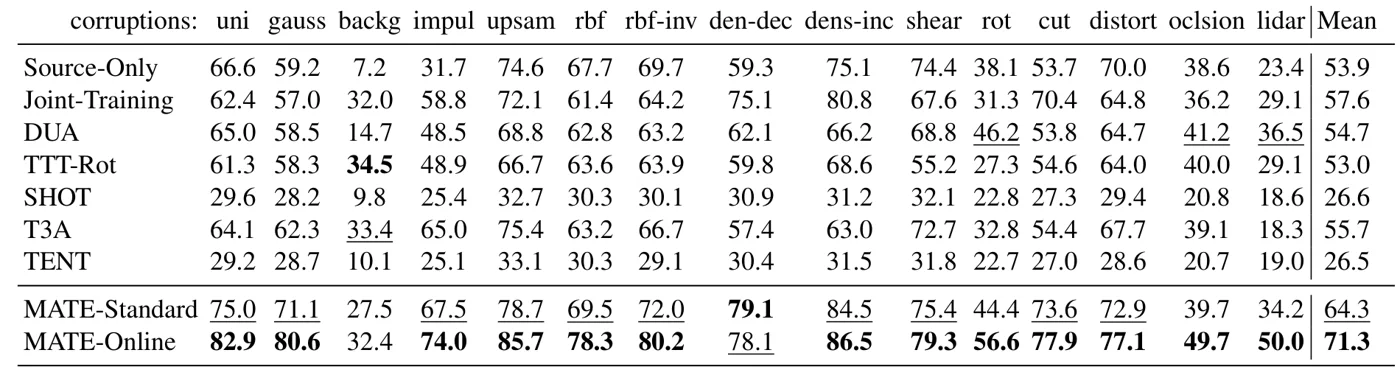 논문의 Table 1: batch size 1에서 ModelNet-40C의 모든 corruption에 대한 top-1 accuracy(%). SHOT과 TENT는 평균 약 26%로 떨어지는 반면 MATE-Online은 71.3%에 이른다. Background 열(Source-Only 7.2)은 MATE가 고치지 못하는 부분이다. 논문 Figure.
두 MATE 변형 모두 세 benchmark에서 모든 baseline을 앞선다. Entropy 기반 방법(TENT, SHOT)은 단일 샘플에서 크게 실패하며, 큰 batch에서도 일부만 회복한다. Real-world 데이터인 ScanObjectNN-C에서의 향상(MATE-Online이 Source-Only 대비 +2.8점)은 synthetic benchmark보다 훨씬 작다. 5번째 샘플마다 한 번만 적응해도 정확도는 매 샘플 적응 대비 약 3점 이내로 유지되며, ShapeNet-C에서 20 FPS로 동작한다(RTX 3090).
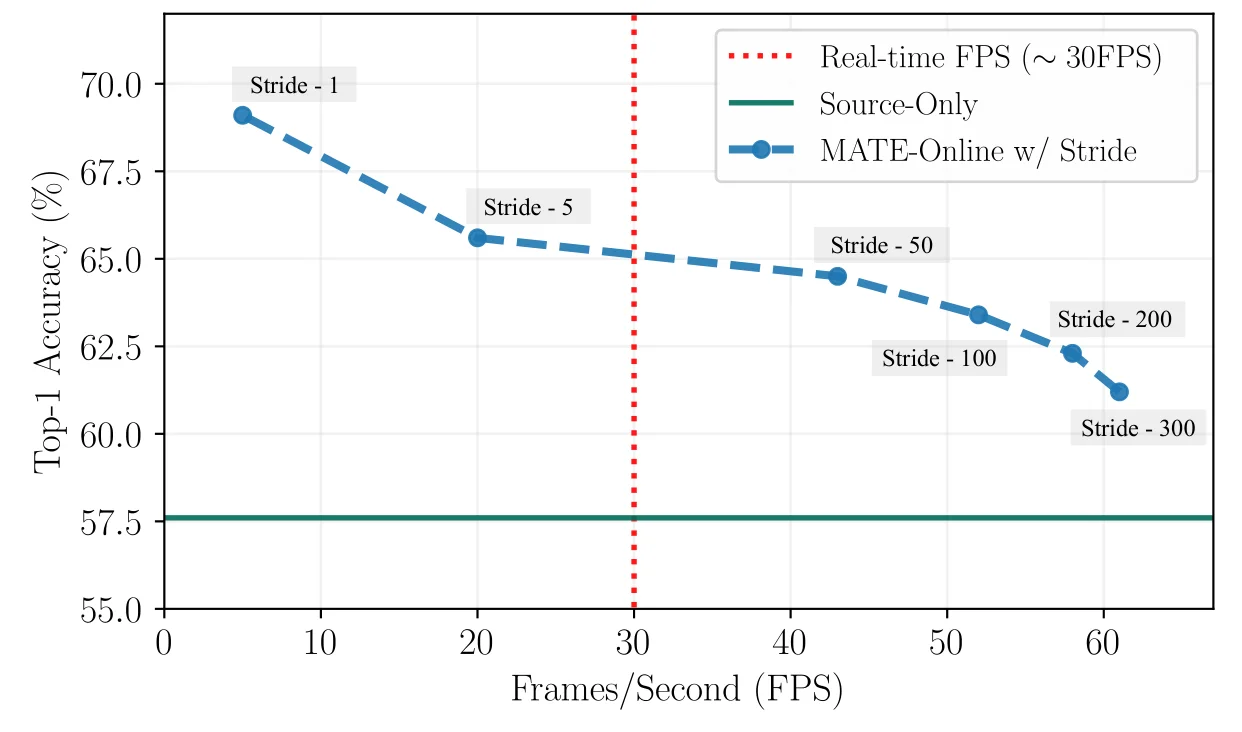 MATE-Online이 \(k\)번째 샘플마다만 적응할 때 FPS에 따른 ShapeNet-C 평균 accuracy. Stride 1은 약 5 FPS에서 약 69%, stride 5는 20 FPS에서 약 65.6%이며, stride 300(약 61 FPS)도 Source-Only(57.6%)보다 높다. 논문 Figure.
Supplement는 MATE-Standard step 20번 후 네트워크가 무엇을 reconstruction하는지 보여주며, background가 왜 약점인지 살펴본다.
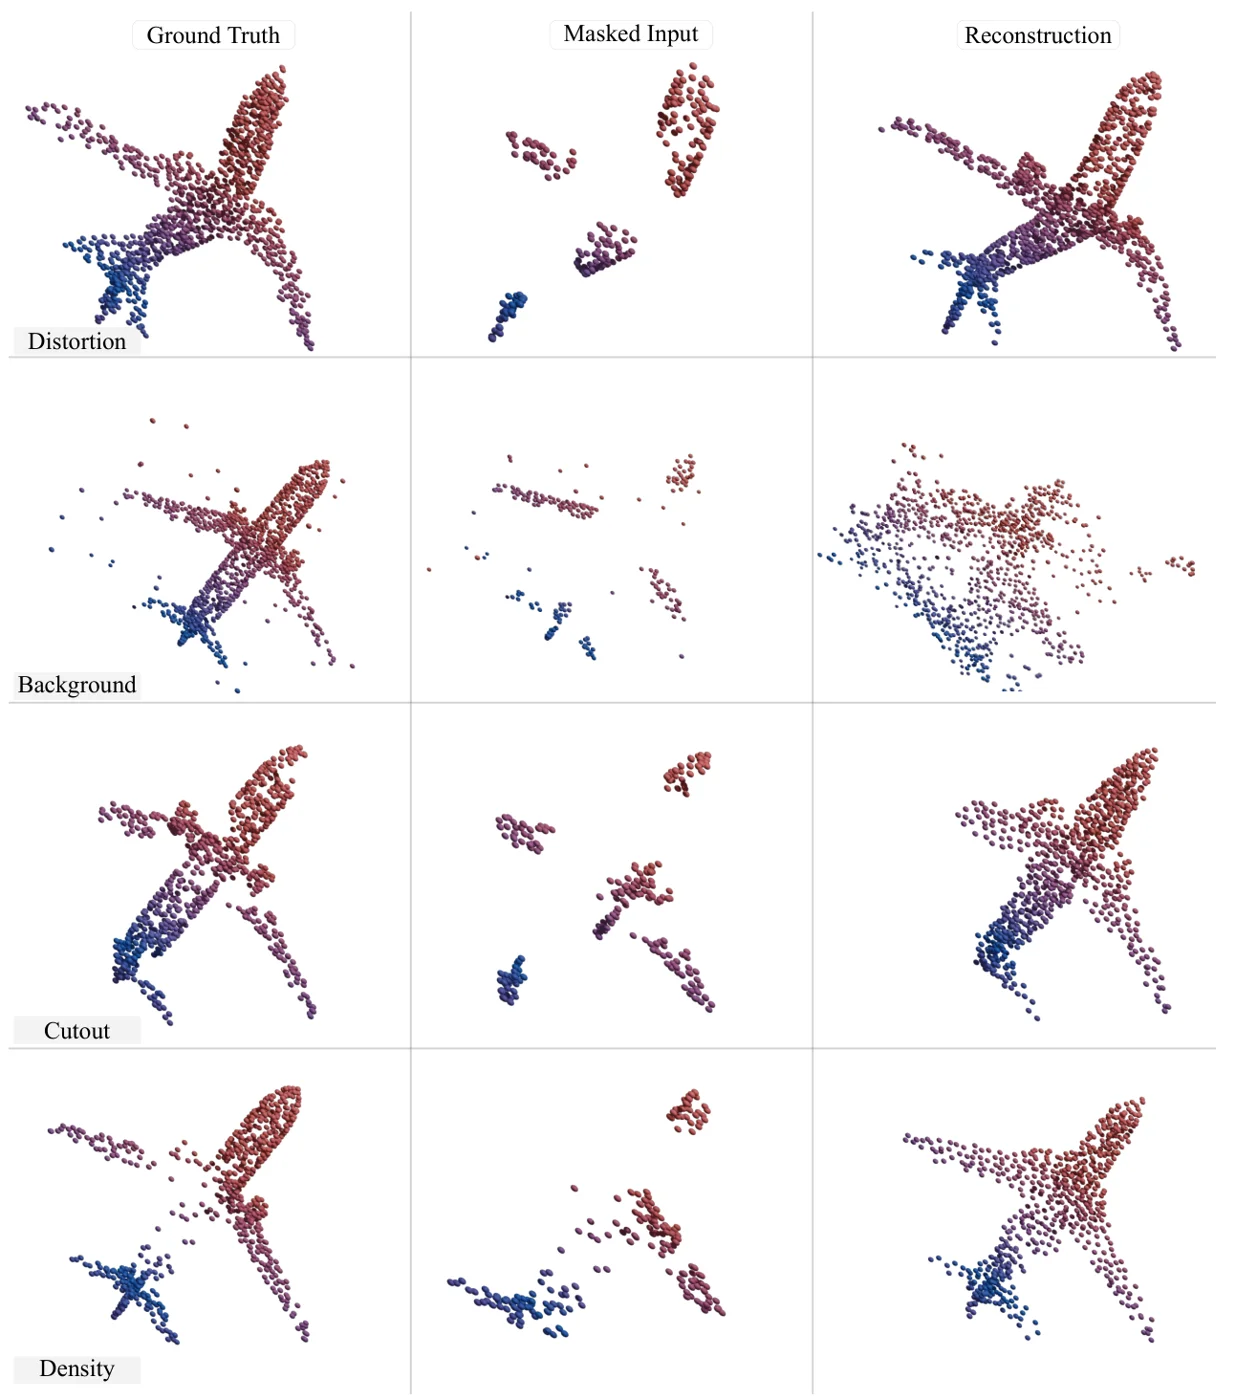 ModelNet-40C에서 corrupted input(왼쪽), 보이는 10% token(가운데), reconstruction(오른쪽). Distortion, cutout, density는 깨끗한 비행기로 복원되지만, background noise에서는 reconstruction이 흩어진 구름이 된다. 논문 Figure(supplement).
Limitations
- 논문이 직접 밝힌 한계: point cloud classification만 다룬다. Segmentation이나 detection 같은 다른 task는 향후 과제로 남겨둔다.
- 특수한 학습 단계가 필요하다. Source model은 reconstruction branch와 함께 joint training되어야 하므로, MATE는 임의의 off-the-shelf classifier를 적응시킬 수 없다.
- 각 adaptation step은 샘플의 masking된 사본 48개로 이루어진 batch에 대해 forward pass와 backward pass를 필요로 한다. MATE-Standard는 샘플마다 이런 step을 20번 밟으므로 실시간과는 거리가 멀다. 속도 향상은 샘플을 건너뛰는 것(stride)에서 오며, 정확도를 어느 정도 희생한다.
- 사본 batch가 중요하다. Batch size 1에서는 MATE-Online이 ModelNet-40C에서 43.1%로 떨어져, 적응하지 않은 모델보다도 낮다(Table 6).
- Masked autoencoder Transformer(Point-MAE)에 묶여 있다. 논문은 다른 backbone을 검증하지 않는다.
- 재구성하기 어려운 corruption에는 reconstruction이 도움이 되지 않는다. Background noise에서 MATE-Standard는 ModelNet-40C에서 27.5%(TTT-Rot는 34.5%), ShapeNet-C에서 4.3%로 Source-Only(10.3%)보다 낮다.
- MATE-Online의 가장 큰 향상은 하나의 corruption 유형만 담긴 stream에서 갱신을 누적하는 데서 나온다. 논문은 distribution shift가 계속 바뀌는 stream을 다루지 않지만, 샘플마다 두 corruption을 결합한 test set은 검증한다(Table 7).