Abstract
LVLM은 object hallucination(OH), 즉 이미지에 없는 object를 묘사하는 문제를 겪는다. 기존 해법은 두 갈래이다. Fine-tuning 방법(robust instruction tuning, preference alignment)은 정제된 데이터와 많은 compute가 필요하다. VCD, OPERA, HALC 같은 post-hoc decoding 방법은 학습이 필요 없지만 inference 절차 자체를 바꾼다. 추가 forward pass, beam search, 여러 adaptive branch가 들어가므로 생성되는 token마다 느려진다.
Nullu는 세 번째 길인 weight editing을 택한다. 같은 이미지에 truthful caption과 hallucinated caption을 붙인 입력 쌍을 모델에 넣고 두 hidden feature를 모은다. 그 차이의 상위 singular vector를 low-rank HalluSpace로 잡고, 선택한 layer의 MLP weight를 이 subspace의 null space로 projection한다. 편집된 weight가 원래 weight를 대체하므로 모델은 이전과 똑같이 돌아가고, inference 비용은 늘지 않는다. 저자들은 HalluSpace가 바탕 LLM의 language prior와 겹친다는 것도 보인다. 이로써 Nullu는 같은 prior를 decoding 단계에서 제거하려는 VCD 같은 contrastive decoding 방법과 연결된다.
Motivation
논문의 출발점은 하나의 공백이다. OH를 완화하는 방법은 많지만, hallucination이 모델의 feature 내부에서 어디에 있는지 살펴본 연구는 드물다. Truthful 응답과 hallucinated 응답이 feature space에서 몇 개의 일관된 방향으로 다르다면, inference 때 token마다 보정할 필요 없이 그 방향들을 offline에서 한 번에 제거할 수 있다.
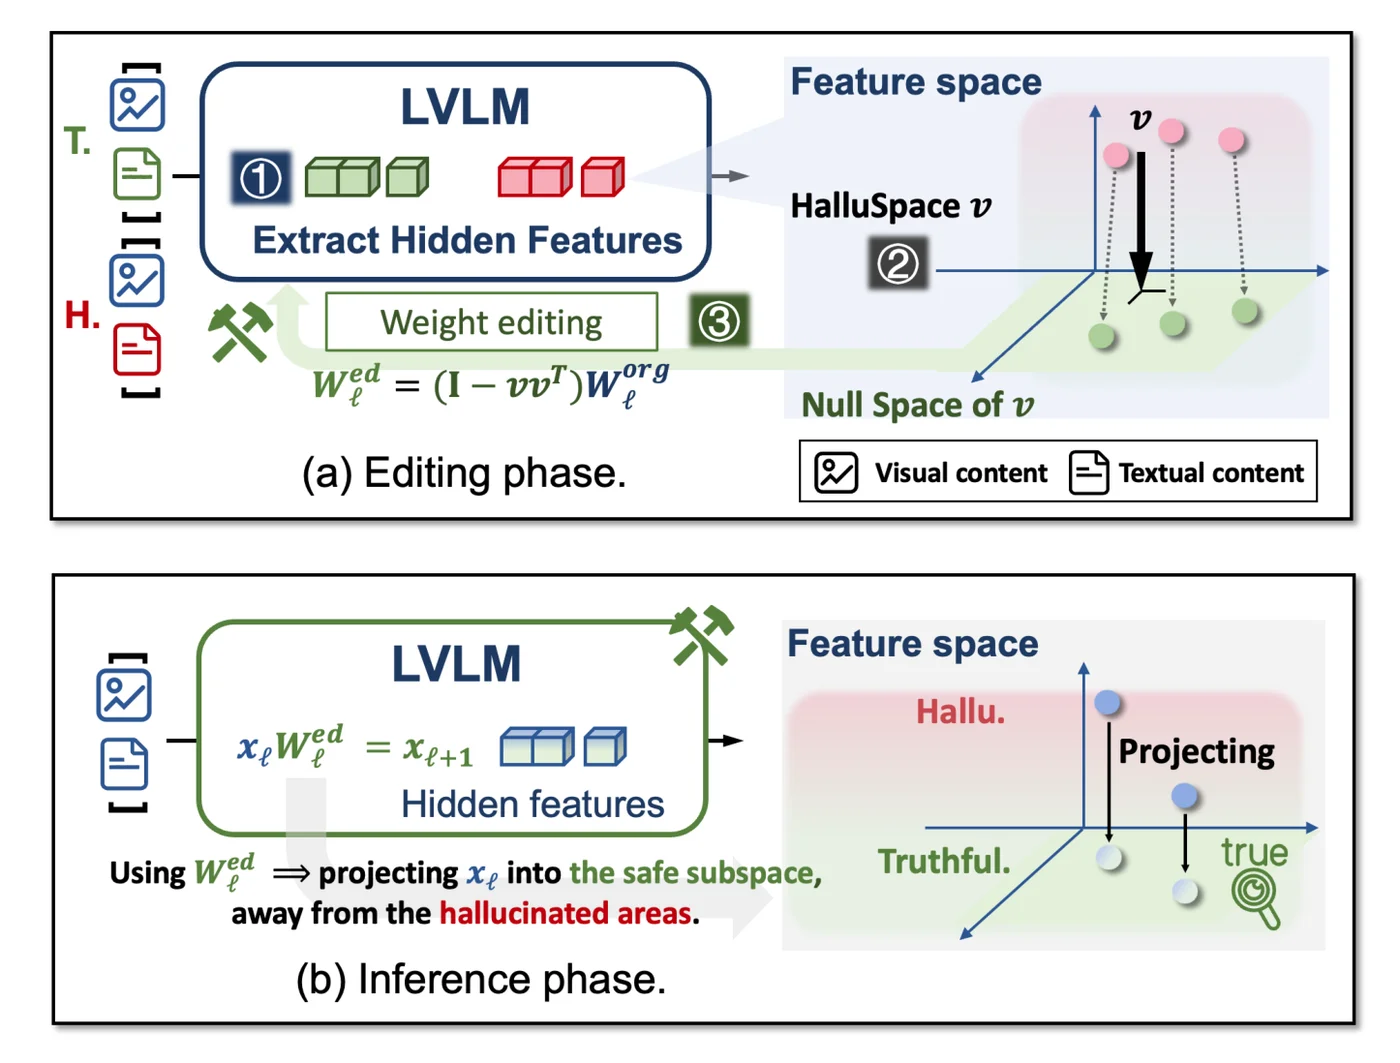 (a) Editing 단계: truthful(T.) 입력과 hallucinated(H.) 입력의 hidden feature를 뽑고, 그 차이에서 low-rank HalluSpace \(v\)를 찾아, weight를 그 null space로 projection한다. (b) Inference 단계: 편집된 weight를 쓰는 것은 모든 입력 feature를 hallucinated 영역에서 떨어진 safe subspace로 projection하는 것과 같다. 논문 Figure.
이 전제를 뒷받침하는 근거는 두 가지이다. 첫째, 낮은 rank로 충분하다. LLaVA-1.5에서 layer당 \(k = 4\)개 방향이 가장 좋은 CHAIR 점수를 낸다(아래 Table 3). 즉 truthful/hallucinated 차이는 작은 subspace에 몰려 있다. 둘째, HalluSpace는 보지 못한 test sample에도 일반화된다. 편집으로 hallucination이 사라진 CHAIR test sample 100개에 대해, 원래 모델과 편집된 모델 사이의 feature 변화를 rank-4 HalluSpace에 projection하면, 그 크기가 random vector 100개보다 편집한 모든 layer에서 약 10배 크다. 저자들은 이를 HalluSpace가 paired 학습 데이터의 noise가 아니라 실제 hallucination과 연결된 방향을 잡는다는 근거로 본다.
비용 측면도 실질적인 motivation이다. VCD는 token당 forward pass가 두 번 필요하고 HALC는 여러 adaptive branch를 돌린다. Weight 편집에는 이런 비용이 전혀 없다.
Method
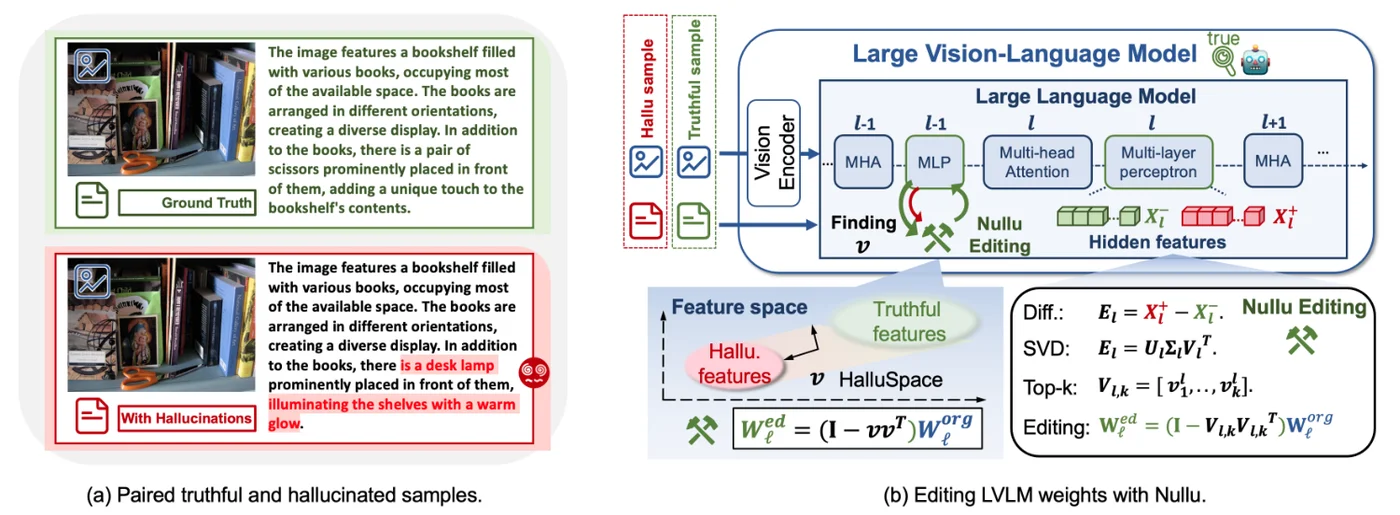 (a) Paired sample: 같은 이미지에 ground-truth 설명과 hallucinated 설명(“a desk lamp … illuminating the shelves”)을 붙인 것. (b) 대상 layer마다 Nullu는 두 입력의 hidden feature를 쌓고, 그 차이에 SVD를 적용해 상위 k개 right singular vector를 HalluSpace로 남긴 뒤 MLP weight를 편집한다. 논문 Figure.
Paired data
각 쌍은 같은 이미지를 공유한다. 한쪽 text는 ground-truth 설명 \(x^-_i\)이고 다른 쪽은 hallucinated 버전 \(x^+_i\)이다. 쌍은 LURE에서 가져온다. GPT-3.5가 co-occurrence, object uncertainty, object position을 기준으로 정확한 설명 속 object를 hallucination이 일어나기 쉬운 object로 바꿔 쓴 것이다.
HalluSpace 찾기
LLM의 layer \(\ell\)에서 각 sample의 feature를 token 방향으로 평균 내어 \(X^+_\ell, X^-_\ell \in \mathbb{R}^{N \times D}\)로 쌓는다. 그 차이를 SVD로 분해한다.
\[E_\ell = X^+_\ell - X^-_\ell = U_\ell \Sigma_\ell V_\ell^\top\]처음 \(k\)개 right singular vector \(V_{\ell,k} = [v_1, \dots, v_k] \in \mathbb{R}^{D \times k}\)가 hallucinated feature와 truthful feature가 다른 주요 방향이다. 이것이 HalluSpace이다.
Weight 편집
Layer \(\ell\)의 MLP weight를 HalluSpace의 null space로 projection한다.
\[W^{\text{ed}}_\ell = (I - V_{\ell,k} V_{\ell,k}^\top)\, W^{\text{org}}_\ell\]입력 feature \(x_i\)에 대해 편집된 출력은 \(x_i (I - V_k V_k^\top) W^{\text{org}}\)이다. MLP가 보기 전에 \(x_i\) 중 HalluSpace에 놓인 성분이 제거된다. 출력을 truthful content, hallucinated bias, noise의 합으로 모델링하면, projection은 상위 k개 차이 방향으로 설명되는 부분을 빼고 나머지는 남긴다. 편집은 LLM의 layer \(\ell \in \{16, \dots, 32\}\)에 \(k = 4\)로 적용하고, 편집된 weight를 모델에 다시 저장한다.
HalluSpace에 담긴 것
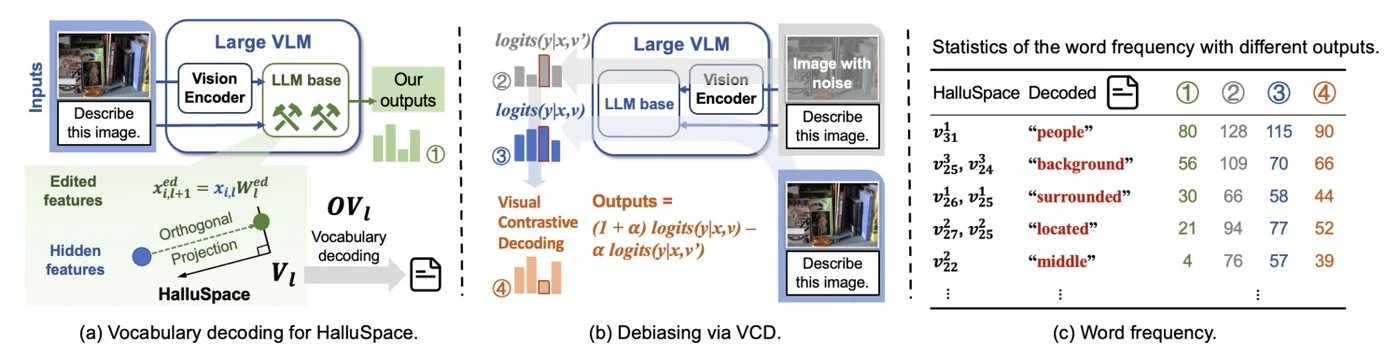 (a) HalluSpace vector를 output embedding으로 decoding해 가장 가까운 단어를 찾는다. (b) VCD는 깨끗한 이미지와 noise를 넣은 이미지의 logit을 대조한다. (c) Decoding된 단어가 Nullu(1), 왜곡된 이미지를 넣은 모델 즉 LLM prior(2), 원래 LLaVA(3), VCD(4)의 출력에 나오는 빈도. 논문 Figure.
HalluSpace vector를 vocabulary로 decoding하면 “people”, “background”, “surrounded”, “located”, “middle” 같은 흔하고 일반적인 단어가 나온다. 이 단어들은 이미지를 왜곡했을 때 LLaVA-1.5가 과하게 생성하는 단어와 같다. VCD가 LLM prior를 추정하는 방식이 바로 이것이다. VCD와 Nullu 모두 이 단어들의 빈도를 줄인다(“background”의 경우 원래 LLaVA 70, VCD 66, Nullu 56). 저자들은 Nullu가 LLM prior를 weight에서 제거하고, VCD는 같은 prior를 decoding 단계에서 제거한다고 결론짓는다.
논문은 Nullu를 DPO와도 연결한다. 단순한 log-linear 모델에서 DPO loss의 gradient에는 feature 차이 \(x^+_i - x^-_i\)로 이루어진 항이 들어 있다. DPO는 이 차이를 gradient step으로 줄이고, Nullu는 SVD로 근사한 뒤 closed form으로 제거한다.
Main Experiments
CHAIR, MSCOCO val 이미지 500장, prompt “Please describe this image in detail.”, 최대 64 new token, seed 3개의 평균. CS는 hallucinated object가 있는 caption의 비율, CI는 hallucinated object의 비율이다(낮을수록 좋다). 세 모델 모두 7B급이다.
| Method | LLaVA-1.5 CS | LLaVA-1.5 CI | MiniGPT-4 CS | MiniGPT-4 CI | mPLUG-Owl2 CS | mPLUG-Owl2 CI |
|---|---|---|---|---|---|---|
| Greedy | 20.40 | 7.08 | 32.40 | 12.20 | 22.90 | 8.62 |
| Beam Search | 19.50 | 6.84 | 30.10 | 11.87 | 20.30 | 7.62 |
| DoLa | 20.20 | 6.75 | 31.90 | 12.15 | 22.40 | 8.36 |
| OPERA | 17.50 | 6.07 | 29.70 | 11.96 | 20.07 | 7.18 |
| VCD | 20.30 | 7.28 | 29.00 | 12.64 | 22.80 | 8.68 |
| Woodpecker | 23.85 | 7.50 | 28.87 | 10.20 | 26.33 | 8.43 |
| LURE | 19.48 | 6.50 | 27.88 | 10.20 | 21.27 | 7.67 |
| HALC | 16.90 | 5.72 | 25.20 | 9.42 | 18.80 | 7.00 |
| Nullu | 15.20 | 5.30 | 21.40 | 8.99 | 15.60 | 5.77 |
OPOPE는 모델에게 자세한 설명을 요청한 뒤, 샘플링한 positive/negative POPE object가 그 설명에 나오는지 offline으로 확인한다. 수치는 random, popular, adversarial split의 평균이다.
| Method | LLaVA-1.5 Acc | LLaVA-1.5 F | MiniGPT-4 Acc | MiniGPT-4 F | mPLUG-Owl2 Acc | mPLUG-Owl2 F |
|---|---|---|---|---|---|---|
| Greedy | 79.14 | 90.45 | 71.22 | 90.04 | 76.46 | 87.29 |
| OPERA | 79.29 | 90.71 | 70.48 | 90.66 | 75.49 | 89.11 |
| VCD | 78.01 | 89.69 | 70.83 | 88.76 | 75.49 | 87.02 |
| HALC | 77.87 | 91.25 | 71.17 | 90.95 | 74.93 | 88.12 |
| Nullu | 79.52 | 91.79 | 71.92 | 92.07 | 77.09 | 90.80 |
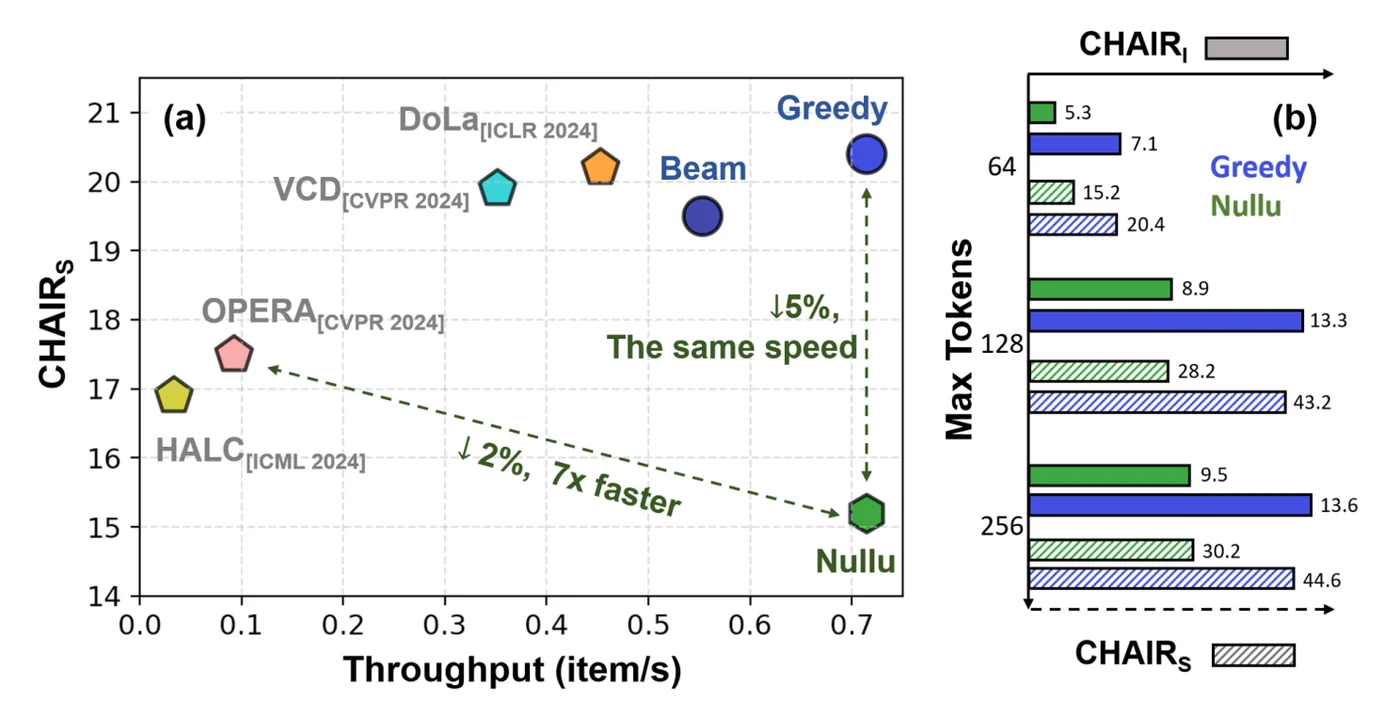 (a) LLaVA-1.5에서 RTX 4090 기준 throughput 대비 CHAIR-S. Nullu는 greedy decoding과 같은 속도로 CHAIR-S가 약 5 point 낮고, OPERA보다 약 7배 빠르다. (b) 최대 token 64, 128, 256에서 greedy와 Nullu의 CHAIR-I와 CHAIR-S. 논문 Figure.
- Nullu는 세 모델 모두에서 CHAIR가 가장 낮고, base model의 hallucination이 심할수록 격차가 크다. MiniGPT-4 CS는 32.40에서 21.40으로, mPLUG-Owl2는 22.90에서 15.60으로 내려간다. BLEU는 greedy 수준을 유지한다(LLaVA-1.5에서 15.69 vs. 15.72).
- 긴 caption에서도 이득이 유지된다. 256 token에서 CHAIR-S는 44.6에서 30.2로, CHAIR-I는 13.6에서 9.5로 내려간다.
- 일반 능력은 떨어지지 않는다. MME에서 LLaVA-1.5의 recognition 합계는 321.19에서 351.31로 오르며, 대부분 code reasoning(71.67에서 92.50)에서 나온다. LLaVA-Bench에서 GPT-4V가 평가한 accuracy도 세 모델 모두 오른다(LLaVA-1.5 5.89에서 6.53, MiniGPT-4 4.11에서 5.63).
- LLaVA-1.5 ablation: layer 16-32 편집이 가장 좋다(CS 15.2). 24-32는 16.2, 28-32는 18.2이다. Rank는 \(k = 4\)가 가장 좋다(15.2). \(k = 2\)(20.2)와 \(k = 16\)(17.2)은 모두 더 나쁘다.
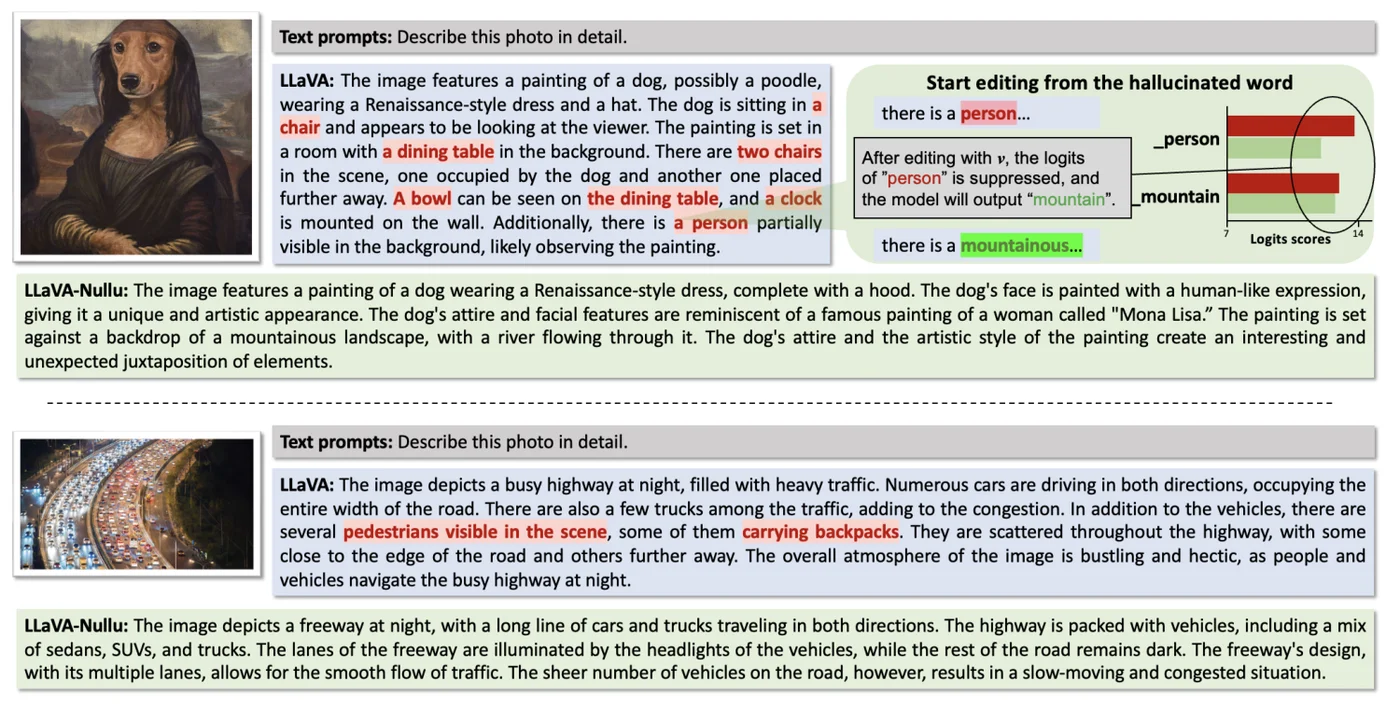 LLaVA-Bench 이미지 두 장에서 편집 전후의 LLaVA-1.5-7B. 원래 모델은 함께 자주 등장하는 object(chair, dining table, bowl, clock, pedestrian)를 덧붙이지만, 편집된 모델은 그렇지 않다. 오른쪽 위는 hallucinated token에서 HalluSpace를 online으로 적용한 예로, “person”의 logit이 떨어지고 모델은 대신 “mountainous”를 쓴다. 논문 Figure.
Limitations
- Paired data가 필요하다. HalluSpace는 GPT-3.5가 hallucinated caption을 쓴 LURE 쌍에서 나온다. 방법은 training-free이지만 data-free는 아니며, HalluSpace는 재작성 규칙이 만들어 내는 종류의 hallucination만 반영할 수 있다.
- Hyperparameter는 경험적으로 정한다. 논문은 어느 layer를 편집할지, \(k\)를 얼마로 할지에 대한 이론적 근거가 없다고 밝힌다. 둘 다 LLaVA-1.5-7B의 CHAIR에서 sweep으로 고른 뒤 고정했으므로, 주요 결과에 쓰인 바로 그 benchmark에서 튜닝된 셈이다.
- 편집은 정적이다. 모든 입력과 모든 task에 같은 projection이 적용된다. 일부 정당한 출력에 필요한 방향까지 제거될 수 있다. MME와 LLaVA-Bench에서는 이런 현상이 보이지 않지만, 평가는 오래된 7B 모델만 다룬다.
- POPE 이득의 일부는 “no”를 더 자주 말하는 데서 온다. Supplementary의 POPE 결과에서 Nullu는 recall을 낮춘다. LLaVA-1.5 random은 89.43에서 87.10으로, MiniGPT-4는 97.13에서 78.53으로 떨어지고 precision은 오른다. 거의 항상 “yes”라고 답하는 MiniGPT-4에서는 bias를 실제로 고친 것이다. 그래도 F1 이득의 일부는 더 나은 grounding만이 아니라 답변 분포의 이동이다. POPE 결과를 읽을 때 이것이 왜 중요한지는 CD Mirage 리뷰에 정리되어 있다.
- LLM prior와의 연결은 상관관계 수준이다. 이 주장은 직접 고른 몇몇 decoding 단어의 빈도 겹침에 기대며, 저자들 스스로 이를 “the most representative results”라고 부른다.