Abstract
LVLM은 이미지에 없는 object를 자주 언급한다. 초기 해법은 정제된 데이터로 fine-tuning하거나(LURE 등) 비용이 크고, 출력을 proprietary LLM에 보내 교정하는 방식(Woodpecker는 GPT-3.5 사용)은 API 비용과 privacy 우려가 있다. 둘 다 문제의 visual 측면을 다루지 않는다.
MARINE(Mitigating hallucinAtion via image-gRounded guIdaNcE)은 training-free이면서 API-free이다. 이미지에 open-source vision model(DETR object detector와 RAM++ tagger)을 돌리고, 둘이 동의하는 object만 남겨 짧은 text prompt로 쓴다. 그런 다음 LVLM은 token마다 이 guidance prompt가 있을 때와 없을 때 두 번 decoding하고, 두 log-probability vector를 guidance strength \(\gamma\)로 섞는다. Classifier-free guidance와 비슷한 방식이다. 다섯 LVLM에서 MARINE은 CHAIR를 낮추고 POPE를 개선하며, 추가 decoding 비용은 greedy의 1.98배에 그친다.
Motivation
저자들은 LVLM의 object hallucination 원인을 세 가지로 본다. (1) vision encoder가 visual detail을 충분히 주지 못한다, (2) visual feature를 text space로 projection하는 과정에서 정보가 왜곡되거나 손실된다, (3) language model 자체의 hallucination 경향이 있다. 앞의 두 가지는 LVLM에 고유한 원인이다. 대부분의 LVLM vision encoder는 CLIP에서 왔는데, CLIP은 이미지와 caption을 전체로서 맞추도록 학습되었지 모든 object를 나열하도록 학습되지 않았다. 전용 object detection model은 정확히 그 일을 하도록 학습된다. 따라서 질문은 새 alignment layer를 학습하지 않고 detector의 object 수준 정보를 LVLM에 어떻게 전달하느냐이다.
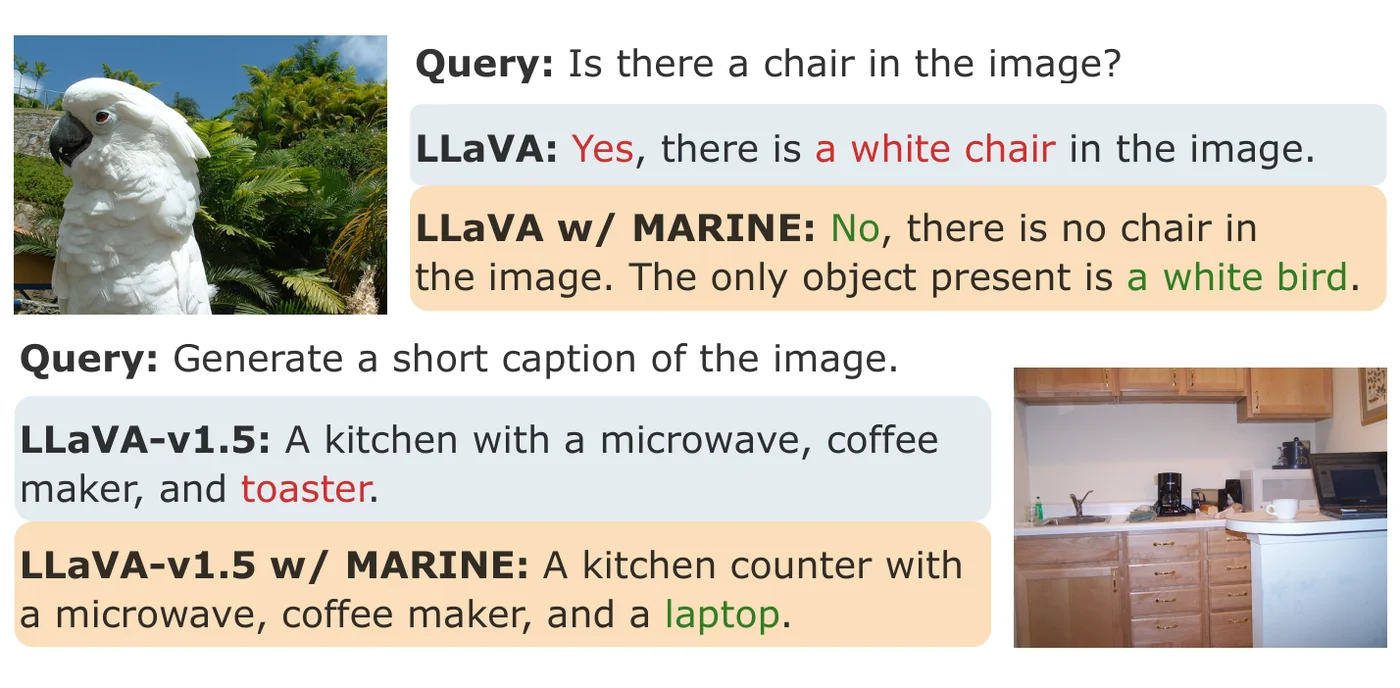 위: 앵무새 이미지에 “Is there a chair in the image?”라고 물으면 LLaVA는 “Yes, there is a white chair”라고 답한다. MARINE을 쓰면 “No”라고 답하고 흰 새를 언급한다. 아래: LLaVA-v1.5는 부엌 caption에 toaster를 덧붙이고, MARINE을 쓰면 실제로 있는 laptop을 언급한다. 논문 Figure.
Appendix는 모델에게 조심하라고 prompt로 말하는 것만으로는 해결되지 않음을 보인다. 직접 작성한 prompt(“Describe the visible contents of this image … without adding any information not clearly visible”)가 query를 대체하면 CHAIR가 오히려 나빠진다. 예를 들어 LLaVA-v1.5의 CHAIR-S는 8.8에서 19.6이 된다. 추가 context로 넣어도 CHAIR가 나빠진다(8.8에서 12.6). MARINE은 6.2를 낸다. 모델에게는 어떤 object가 있는지 알려 줘야 하고, guidance는 prompt에만 있어서는 안 되며 logit에 작용해야 한다.
Method
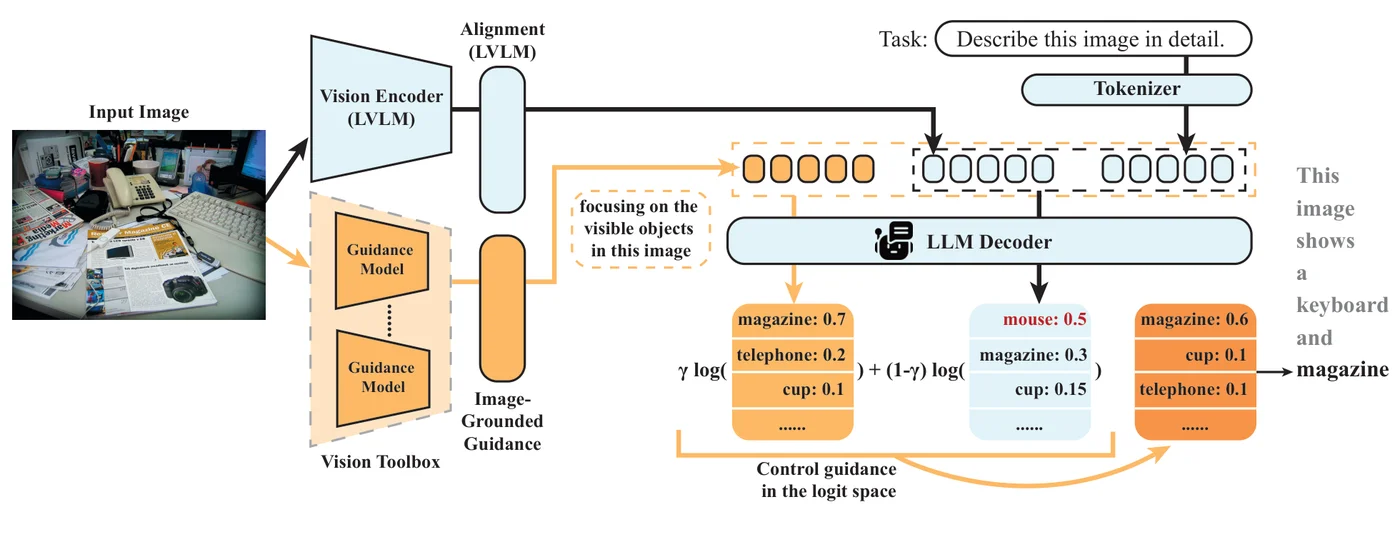 이미지는 LVLM 자체의 vision encoder로 가는 동시에 guidance model들로 이루어진 “vision toolbox”로도 간다. 그 detection 결과가 guidance text(“focusing on the visible objects in this image: …“)가 된다. LLM decoder는 그 text가 있을 때와 없을 때 두 번 돌고, 두 출력 분포를 weight \(\gamma\)로 log space에서 섞는다. 예시에서 guidance가 없는 branch는 hallucinated “mouse”(0.5)를 선호하지만, 섞은 분포는 “magazine”을 고른다. 논문 Figure.
Image-grounded guidance prompt
이미지에 DETR(score threshold 0.95)과 RAM++(threshold 0.68)를 돌린다. MARINE은 두 모델이 찾은 object의 intersection을 남겨 text prompt \(c\)로 만든다. “focusing on the visible objects in this image:” 뒤에 object 목록을 붙인 것이다. Guidance가 일반 text이므로 LVLM은 새로운 alignment 학습 없이 이를 읽을 수 있다.
Guided decoding
매 step마다 LVLM을 두 번 돌린다. 한 번은 일반 입력 \([v, x, y_{<t}]\)로, 한 번은 guidance를 더한 \([v, c, x, y_{<t}]\)로 돌린다. 두 결과는 다음과 같이 결합된다.
\[\hat p_\theta(y_t \mid v, c, x, y_{<t}) \propto \frac{p_\theta(y_t \mid v, c, x, y_{<t})^{\gamma}}{p_\theta(y_t \mid v, x, y_{<t})^{\gamma - 1}}\]Log space로 쓰면 다음과 같다.
\[\log \hat p_\theta(y_t) = \gamma \log p_\theta(y_t \mid v, c, x, y_{<t}) + (1 - \gamma) \log p_\theta(y_t \mid v, x, y_{<t})\]수식은 classifier-free guidance의 형태이지만, \(\gamma \in (0, 1)\)에서는 extrapolation이 아니라 interpolation이다. \(\gamma = 0\)은 원래 모델이고 \(\gamma = 1\)은 guided branch만 쓴다. Log-probability를 더하므로, 두 branch 모두에서 확률이 어느 정도 높아야 token이 상위에 남는다. 그림의 “mouse”처럼 guidance 없는 모델은 좋아하지만 detector 정보를 받은 branch는 그렇지 않은 object는 떨어진다. 기본값은 \(\gamma = 0.7\)이고 greedy decoding을 쓴다.
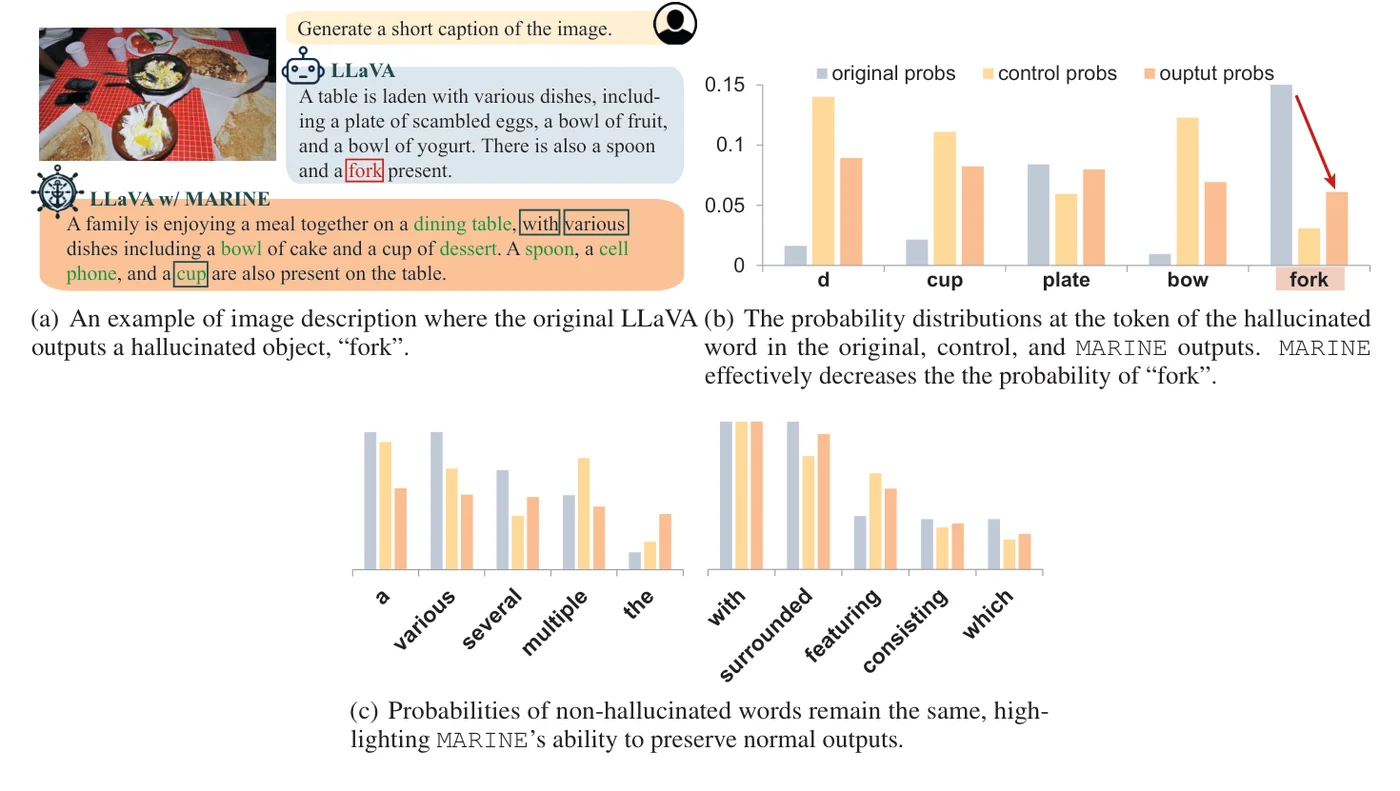 (a) LLaVA는 “fork”를 hallucinate하지만 MARINE을 쓰면 그렇지 않다. (b) 그 token에서 “fork”의 원래 확률은 가장 높고, guided(“control”) branch는 낮은 확률을 주며, 섞은 출력은 확률을 낮춘다. (c) “with”, “various” 같은 기능어는 세 분포 모두에서 비슷한 확률을 유지한다. 논문 Figure.
Main Experiments
MSCOCO 이미지 500장에서의 CHAIR. CS(sentence 수준)와 CI(instance 수준)는 낮을수록, recall R은 높을수록 좋다. LLaVA는 LLaMA-2-7B-Chat, LLaVA-v1.5는 Vicuna-7B를 쓴다. “Avg”는 다섯 LVLM(LLaVA, LLaVA-v1.5, MiniGPT-v2, mPLUG-Owl2, InstructBLIP)의 평균이다. MARINE-Truth는 ground-truth object를 guidance로 쓴 참고용 결과이다.
| Method | LLaVA CS | LLaVA CI | LLaVA R | LLaVA-v1.5 CS | LLaVA-v1.5 CI | LLaVA-v1.5 R | Avg CS | Avg CI | Avg R |
|---|---|---|---|---|---|---|---|---|---|
| Greedy | 26.6 | 10.5 | 47.4 | 8.8 | 4.6 | 41.1 | 11.0 | 5.2 | 40.3 |
| LURE | 33.8 | 11.6 | 54.8 | 38.9 | 11.2 | 56.3 | 36.2 | 11.4 | 55.2 |
| Woodpecker | 19.5 | 8.9 | 44.3 | 8.5 | 4.5 | 38.4 | 10.3 | 5.7 | 38.0 |
| VCD | 28.1 | 11.0 | 46.6 | 7.3 | 4.1 | 40.8 | 10.1 | 4.8 | 39.4 |
| OPERA | 22.4 | 9.9 | 43.6 | 11.0 | 6.7 | 40.2 | 10.6 | 5.5 | 40.3 |
| MARINE | 17.8 | 7.2 | 50.8 | 6.2 | 3.0 | 44.3 | 8.4 | 3.7 | 44.5 |
| MARINE-Truth | 19.6 | 5.1 | 79.0 | 6.0 | 2.5 | 55.3 | 8.9 | 2.9 | 57.5 |
POPE adversarial 설정, 다섯 LVLM의 평균. 이상적인 Yes 비율은 50%이다. LURE는 yes/no 답을 내지 않아 제외된다.
| Method | Accuracy | F1 | Yes (%) |
|---|---|---|---|
| Greedy | 73.2 | 77.9 | 67.0 |
| Woodpecker | 78.8 | 78.3 | 47.8 |
| VCD | 73.2 | 77.5 | 65.6 |
| OPERA | 72.4 | 78.0 | 69.7 |
| MARINE | 79.9 | 80.4 | 51.1 |
| MARINE-Truth | 88.3 | 89.7 | 59.8 |
- MARINE은 평균 CHAIR-S와 CHAIR-I가 가장 낮으면서 recall도 올린다(40.3에서 44.5). 즉 object를 덜 언급해서 hallucination을 줄이는 것이 아니다. LURE는 recall이 더 높지만 hallucination이 훨씬 많다(평균 CS 36.2).
- POPE에서 주된 효과는 base model의 강한 “Yes” bias를 바로잡는 것이다. 평균 Yes 비율은 67.0%에서 51.1%로, 원래 LLaVA에서는 97.7%에서 72.3%로 내려간다(accuracy 51.8에서 66.9).
- 비용이 낮다. LLaVA-7B에서 token당 52.2 ms로 greedy의 1.98배이며, VCD는 2.03배, Woodpecker는 3.59배, OPERA는 7.0배이다.
- 두 detector가 모두 필요하고, 서로 동의해야 한다. LLaVA에서 DETR만 쓰면 CS 27.6, RAM++만 쓰면 29.0으로 둘 다 greedy(26.6)보다 나쁘지만, 둘의 intersection은 17.8을 낸다. 두 모델의 object를 union으로 합치면 30.4가 된다.
- GPT-4V가 평가한 accuracy는 같은 detail 수준에서 오른다. 예를 들어 image captioning에서 LLaVA는 5.27에서 6.11로, mPLUG-Owl2는 7.97에서 8.63으로 오른다.
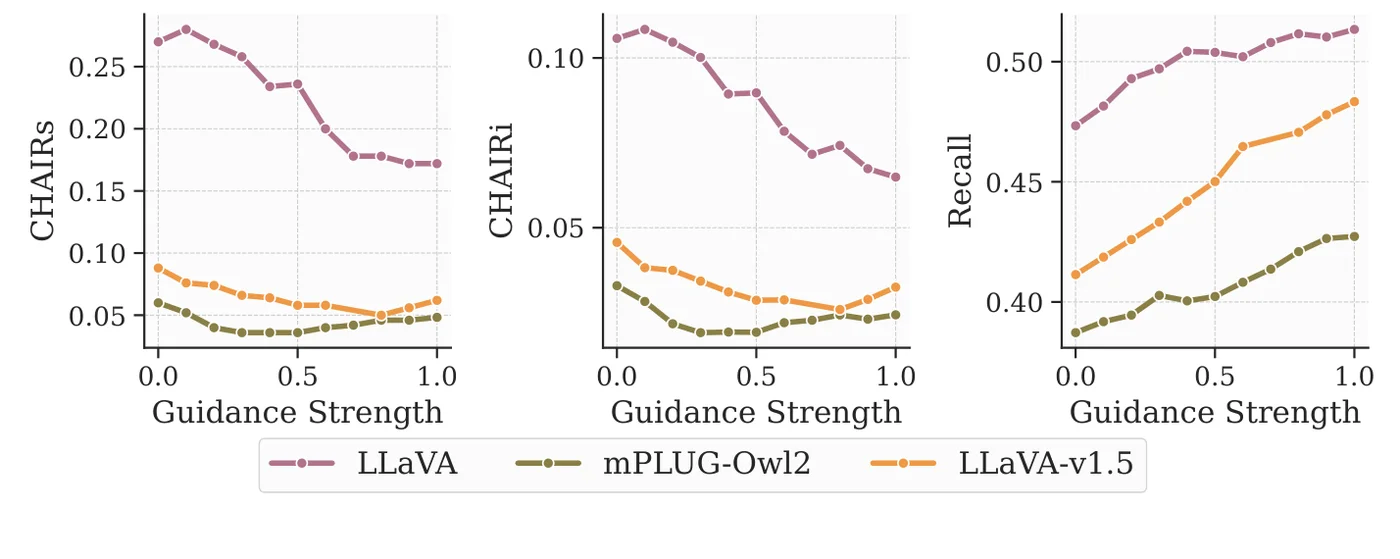 LLaVA, LLaVA-v1.5, mPLUG-Owl2에서 \(\gamma\)를 0에서 1로 바꿀 때의 CHAIR-S, CHAIR-I, recall. \(\gamma\)가 커질수록 hallucination은 줄고 recall은 오른다. LLaVA-v1.5와 mPLUG-Owl2는 0.3-0.8 부근에서 CHAIR가 가장 낮다. 논문 Figure.
저자들은 \(\gamma\)를 0.3에서 0.7 사이로 권한다. 일부 모델은 \(\gamma = 1\)에서 CHAIR가 가장 좋지만, appendix는 guidance가 너무 강하면 질문이 다른 것을 물어도 모델이 guidance의 object를 나열한다는 것을 보여 준다.
Limitations
- 모든 이득이 detector에 달려 있다. MARINE은 DETR과 RAM++가 없다고 동의한 object만 제거할 수 있다. 그들의 오류는 그대로 guidance로 들어간다. POPE에서 MARINE-Truth와의 큰 격차(accuracy 79.9 vs. 88.3)는 아직 남은 여지가 얼마나 큰지 보여 준다.
- Detector의 vocabulary가 benchmark와 같다. DETR은 COCO의 object class로 학습되었고, CHAIR와 POPE-COCO도 같은 vocabulary로 채점한다. 그 label space 밖의 object나 attribute, relation hallucination으로 이득이 얼마나 이어지는지는 검증하지 않았다. 저자들 스스로도 다른 종류의 hallucination을 future work로 꼽는다.
- 결과가 모델마다 다르다. MiniGPT-v2에서 MARINE은 CHAIR-S를 악화시킨다(8.2에서 11.8). InstructBLIP의 POPE에서는 Yes 비율을 균형 아래인 38.8%까지 밀어 “No” 쪽으로 과하게 교정한다. CD Mirage 리뷰가 지적하듯, 큰 Yes 비율 이동을 동반한 POPE 이득은 조심해서 읽어야 한다. 여기서는 출발점이 강한 “Yes” bias이므로 50% 쪽으로의 이동은 올바른 방향이다.
- Decoder pass 두 번과 추가 모델이 필요하다. Decoding에 token당 LVLM pass가 두 번 들고, 이미지마다 DETR과 RAM++를 한 번씩 돌린다. OPERA나 Woodpecker보다 싸지만 공짜는 아니다.
- Guidance strength는 정확도와 instruction following 사이의 trade-off이다. 튜닝이 필요하며, 최적값은 모델마다 다르다.