Abstract
Multimodal LLM은 image에 없는 object, attribute, relation을 hallucinate하며, 긴 설명에서 특히 심하다. 기존 해법은 특별히 설계한 data로 학습하거나 외부 knowledge나 model을 끌어오며, 둘 다 추가 비용이 든다. OPERA는 추가 data, knowledge, 학습 없이 순전히 decoding 단계에서 동작한다.
출발점은 self-attention map에서의 관찰이다. 많은 hallucination이 knowledge aggregation pattern 직후에 시작된다. 이는 attention map에서 이후 token들이 모두 앞선 한 token에 강하게 attend하는 column 모양이며, 그 token은 보통 마침표처럼 정보가 거의 없는 token이다. Model은 이런 summary token을 “over-trust”하고 image token을 소홀히 한다. OPERA는 이 pattern에 대한 penalty를 beam search 점수에 더하고, pattern이 계속되면 decoding을 summary token까지 rollback하여 다른 다음 token을 고른다.
Motivation
저자들은 생성된 token의 self-attention을 시각화하여 반복되는 그림을 발견한다. 내용이 거의 없는 token 위에 column 모양의 attention pattern이 생기고, 그 뒤에 hallucination이 따라온다.
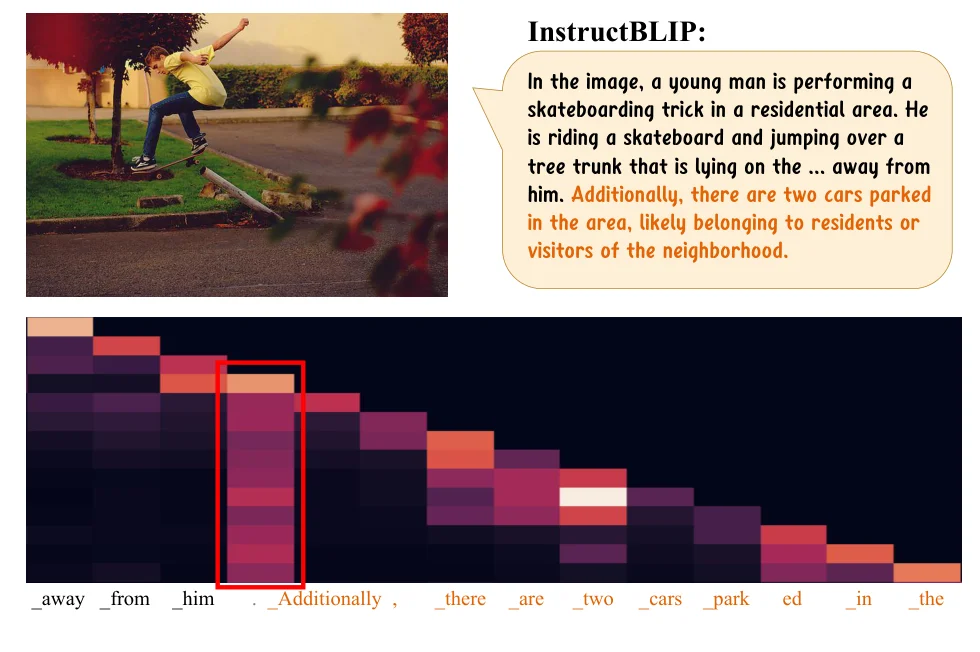 InstructBLIP이 skateboarding image를 묘사한다. “him” 뒤의 마침표 이후 token들이 모두 그 마침표에 강하게 attend하고(빨간 상자), 다음 문장에서 “two cars parked in the area”를 hallucinate한다. 논문 Figure.
이는 NLP의 “anchor token” 발견과 일치한다. LLM은 shallow layer에서 앞선 정보를 몇 개의 anchor token에 모으고 deep layer에서 그것으로부터 예측한다. MLLM에서 image token은 sequence 맨 앞에 있다. Text가 길어질수록 visual 정보는 summary token의 사슬을 거쳐야 하며, summary token 하나가 모든 것을 담을 수는 없다. 그러면 이후 token들은 image 대신 가까운 summary token을 over-trust하고 학습된 bias로 돌아간다. 예를 들어 앞에서 “road”가 나왔으니 “cars”를 말하는 식이다.
두 측정이 이를 뒷받침한다. Model마다 100개 image에서, 네 model 모두 대부분의 hallucination이 이런 pattern 이후 10 token 안에 시작된다. 그리고 긴 응답을 summary token 위치에서 나누면, 중간에 작은 굴곡은 있지만 split 번호가 커질수록 CHAIR가 오른다.
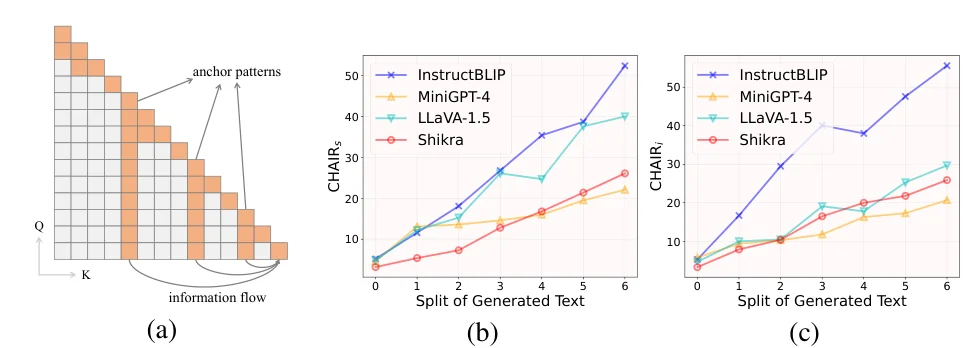 (a) Aggregation pattern은 “anchor token” 그림과 일치한다. 정보가 몇 개의 column을 통해 흐른다. (b), (c) 무작위 MSCOCO image 5,000장에서 context에 summary token이 많아질수록(split 0에서 6) CHAIR-S와 CHAIR-I가 커진다. 논문 Figure.
Method
OPERA는 \(N_{\text{beam}}\)개 beam을 쓰는 beam search 위에 만들어진다. 각 후보의 점수를 바꾸고 rollback 규칙을 더한다.
Over-trust logit penalty
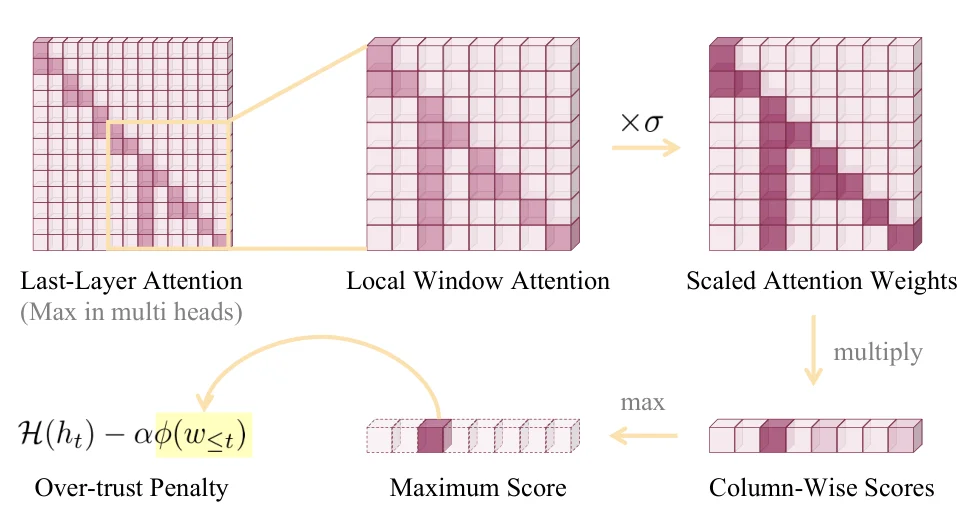 Last-layer attention(head 중 max)에서 생성된 token 위의 local window를 잘라내고, \(\sigma\)로 scale한 뒤, 각 column을 따라 곱하고, 가장 큰 column score를 penalty로 쓴다. 논문 Figure.
현재 sequence에 대해 마지막 \(k\)개 생성 token 사이의 last-layer attention weight를 head 중 최댓값으로 취한다(image token과 prompt token은 제외한다). 원래 attention 값은 작으므로 upper triangle을 0으로 채우고 값을 \(\sigma\)배 한다. 강한 column은 이후 많은 token이 같은 token에 attend한다는 뜻이므로, column-wise product로 이를 측정한다.
\[\phi(\omega_{<t}) = \prod_{i=c}^{t-1} \sigma \omega_{i,c}, \qquad c = \arg\max_{t-k \le j \le t-1} \prod_{i=j}^{t-1} \sigma \omega_{i,j}\]\(\sigma = 50\)이면 강한 column의 attention 값은 1보다 커지고 약한 값은 1보다 작아지므로, 실제 column에서만 product가 커진다. 효율을 위해, 그리고 이상한 출력을 피하기 위해 각 beam은 상위 \(N_{\text{can}}\)개 token만 고려하며, 이것이 후보 집합 \(\mathcal{Y}\)가 된다. Penalty는 각 후보의 logit에 들어간다.
\[p(x_t \mid x_{<t}) = \mathrm{Softmax}\big[\mathcal{H}(h_t) - \alpha\, \phi(w_{\le t})\big]_{x_t}, \qquad x_t \in \mathcal{Y}\]여기서 \(w_{\le t}\)는 후보 \(x_t\)를 붙인 뒤의 attention이다. Penalty는 beam score에 누적되므로, summary token을 계속 over-trust하는 beam은 뒤처진다.
Retrospection-allocation
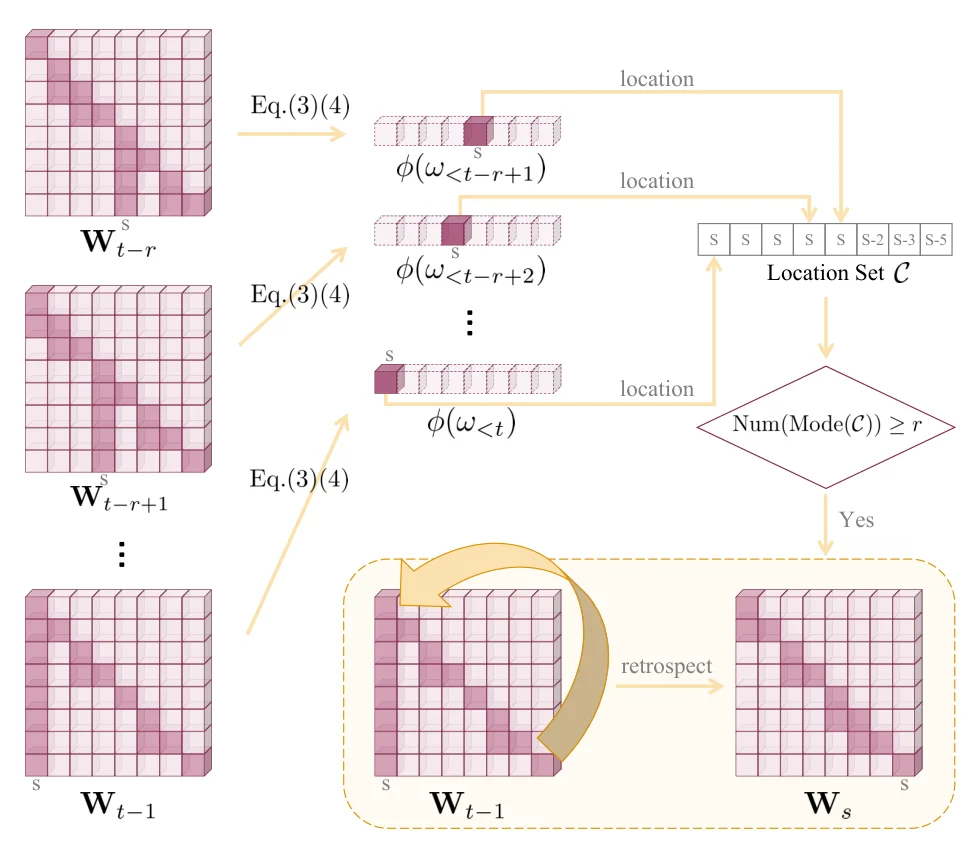 최근 token 각각에 대해 OPERA는 최대 column score의 위치를 기록한다. 같은 위치 \(s\)가 \(r\)번 이상 나타나면 decoding을 \(s\)로 rollback하고 다른 다음 token을 고른다. 논문 Figure.
Pattern은 늦게 나타난다. 보일 때쯤에는 모든 beam이 이미 hallucination을 담고 있을 수 있고, 그러면 penalty로는 도울 수 없다. 이때 OPERA는 되돌아간다. 마지막 \(l\)개 token의 column 위치 \(c\)를 집합 \(\mathcal{C}\)로 모으고, 가장 흔한 위치가 몇 번 나오는지 센다.
\[N_{\text{overlap}} = \sum_{c \in \mathcal{C}} \mathbb{1}_{c = s}, \qquad s = \mathrm{Mode}(\mathcal{C})\]\(N_{\text{overlap}} \ge r\)이면 sequence를 \(x_0, \dots, x_s\)로 잘라내고, 이전에 고른 token을 제외한 \(\mathcal{Y} \setminus \{x_{s+1}\}\)에서 다음 token을 고른다. Rollback 위치는 뒤로 물러날 수 없으며, 같은 위치에서 \(\beta\)번 rollback하면 한 token 더 앞으로 rollback한다. Score에 threshold를 두는 대신 위치를 세는 이유는 score의 scale이 model마다 다르기 때문이다.
기본값은 모든 model에 대해 \(N_{\text{beam}} = 5\), \(N_{\text{can}} = 5\), \(\sigma = 50\), \(\alpha = 1\), \(\beta = 5\), \(r = 15\), \(l = k\)이다.
Main Experiments
7B MLLM 네 개를 실험한다. InstructBLIP과 MiniGPT-4(Q-Former, image token 32개), LLaVA-1.5와 Shikra(linear projection, image token 256개 또는 576개)이다. CHAIR는 무작위 COCO val2014 image 500장에서 “Please describe this image in detail.” prompt와 최대 512 new token으로 측정한다. CS는 CHAIR-S(sentence level: hallucinated object가 있는 caption의 비율), CI는 CHAIR-I(instance level: 언급된 object 중 hallucinated object의 비율)이며, 낮을수록 좋다.
| Method | InstructBLIP CS | InstructBLIP CI | MiniGPT-4 CS | MiniGPT-4 CI | LLaVA-1.5 CS | LLaVA-1.5 CI | Shikra CS | Shikra CI |
|---|---|---|---|---|---|---|---|---|
| Greedy | 58.8 | 23.7 | 31.8 | 9.9 | 45.0 | 14.7 | 55.8 | 15.4 |
| Nucleus | 54.6 | 24.8 | 32.6 | 10.7 | 48.8 | 14.2 | 55.6 | 15.4 |
| Beam Search | 55.6 | 15.8 | 30.6 | 9.5 | 48.8 | 13.9 | 50.4 | 13.3 |
| DoLa | 48.4 | 15.9 | 32.2 | 10.0 | 47.8 | 13.8 | 55.8 | 15.1 |
| OPERA | 46.4 | 14.2 | 26.2 | 9.5 | 44.6 | 12.8 | 36.2 | 12.1 |
POPE(random, popular, adversarial split의 평균 F1):
| Method | InstructBLIP | MiniGPT-4 | LLaVA-1.5 | Shikra |
|---|---|---|---|---|
| Greedy | 80.0 | 58.5 | 82.2 | 81.1 |
| Nucleus | 80.1 | 57.8 | 82.5 | 81.2 |
| Beam Search | 84.4 | 70.3 | 84.9 | 82.5 |
| DoLa | 83.4 | 72.8 | 83.2 | 82.1 |
| OPERA | 84.8 | 73.3 | 85.4 | 82.7 |
- 긴 caption에서 OPERA는 모든 model에서 CHAIR가 가장 낮다. 가장 큰 이득은 Shikra로, beam search 대비 CHAIR-S가 50.4 → 36.2이다. 64 new token에서도 대부분의 항목에서 앞서며, 예를 들어 LLaVA-1.5의 CHAIR-S는 18.8 → 14.2이다.
- POPE에서 beam search 대비 이득은 작다(0.2에서 3.0 F1). 저자들은 이것이 예상된 결과라고 말한다. 한 단어 답변은 aggregation pattern이 생기기 전에 끝난다.
- 두 구성 요소 모두 도움이 된다. Shikra에서 beam search 대비, penalty만 쓰면 CHAIR-S가 41.8, rollback만 쓰면 46.8, 둘 다 쓰면 36.2가 된다. Penalty의 기여가 더 크다.
- LLaVA-1.5에서 text 품질은 유지된다. Perplexity는 beam search와 비슷하고(PPL1 11.67 vs. 11.11), MME는 소폭 오른다(1504.3 → 1515.4).
저자들은 VG-100K(HalluBench)에서 GPT-4로 설명을 문장 단위로 판정하기도 하며, 이는 attribute와 relation 오류까지 다룬다.
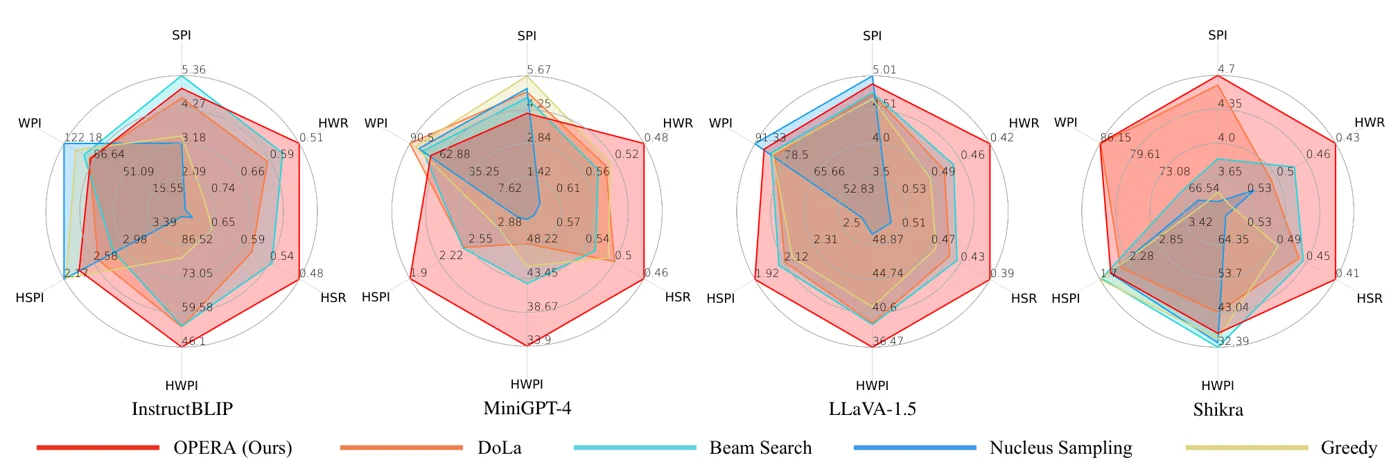 네 model에 대한 여섯 지표. Image당 문장 수와 단어 수(SPI, WPI; 클수록 좋음), image당 hallucinated 문장 수와 단어 수 및 그 비율(HSPI, HWPI, HSR, HWR; 작을수록 좋으며 축이 뒤집혀 있어 radar가 클수록 좋음). OPERA(빨강)는 hallucination 축에서 면적이 가장 크고, 일부 model에서는 출력이 다소 짧다. 논문 Figure.
GPT-4V가 COCO image 500장에서 beam search와 OPERA를 나란히 비교하면, 네 model 모두에서 correctness가 10점 만점에 약 5.3-5.5에서 6.3-6.9로 오르고 detailedness는 거의 같다.
Limitations
- 짧은 답변. 저자들은 pattern이 늦게 나타나기 때문에 약 10 token 미만의 답변에서는 이득이 미미하다고 밝힌다. POPE 표에서 이것이 드러난다.
- 모든 hallucination을 다루지는 못한다. Model의 bias가 너무 강하면(예: “road” → “cars”) rollback이 좋은 대안을 찾지 못할 수 있다. 비슷한 모양이나 낮은 해상도처럼 perception이 약해서 생기는 오류는 손댈 수 없다.
- 비용. OPERA는 beam 5개, beam당 후보 5개로 beam search를 돌리고, 각 후보 continuation의 attention이 필요하며, rollback하여 다시 생성할 수 있다. Greedy decoding보다 훨씬 느리며, 논문은 runtime을 보고하지 않는다.
- Beam search와 attention 접근에 묶여 있다. Sampling 기반 decoding에 바로 넣을 수 없고, 명시적인 attention weight가 필요한데 fused attention kernel은 이를 돌려주지 않는다.
- 짧아지는 출력. GPT-4 평가에서 image당 문장과 단어 수가 다소 줄어든다. 저자들은 hallucinated content가 제거된 결과로 보지만, hallucination 수가 줄어든 일부는 단순히 말을 덜 한 데서 올 수 있다.