Abstract
Point cloud test-time adaptation(TTA) 방법들은 대부분 여러 번의 backpropagation step으로 모델을 적응시킨다. 이 때문에 느리고, update step 수에 민감하다. MATE처럼 학습 시점에 auxiliary task가 필요한 방법도 있어, 임의의 pre-trained model에는 적용할 수 없다. BFTT3D는 backpropagation을 피하지만, test time에 class-level source prototype이 필요하고 시간과 memory 부담이 크다.
Purge-Gate(PG)는 token 수준에서 동작한다. Background point나 impulse noise 같은 corruption은 일부 local patch에 다른 patch보다 훨씬 크게 영향을 준다. PG는 각 token이 source prototype에서 얼마나 떨어져 있는지 측정하고, 가장 크게 벗어난 token들을 attention layer 이전에 제거한다. 아무것도 갱신하지 않는다. 두 가지 변형이 있다. PG-SP는 저장된 source statistics를 사용하고, PG-SF는 완전히 source-free하며 모델 자신의 [cls] token을 prototype으로 사용한다.
Motivation
논문은 image와 point cloud의 차이에서 출발한다. 2D TTA에서는 입력 크기가 고정되어 있고 corruption이 보통 image 전체에 고르게 퍼져 있다. Point cloud에서는 distribution shift가 새로운 point(background clutter, impulse outlier)를 추가하거나 shape의 일부 영역만 교란할 수 있다. 그래서 손상이 고르지 않다. 몇몇 local patch는 심하게 corrupt되고 나머지 object는 거의 깨끗하다. 기존 point cloud TTA 방법들은 이를 무시하고 backpropagation(TENT, MATE, SMART-PC)이나 class-level source prototype(BFTT3D)으로 모델 전체를 적응시킨다.
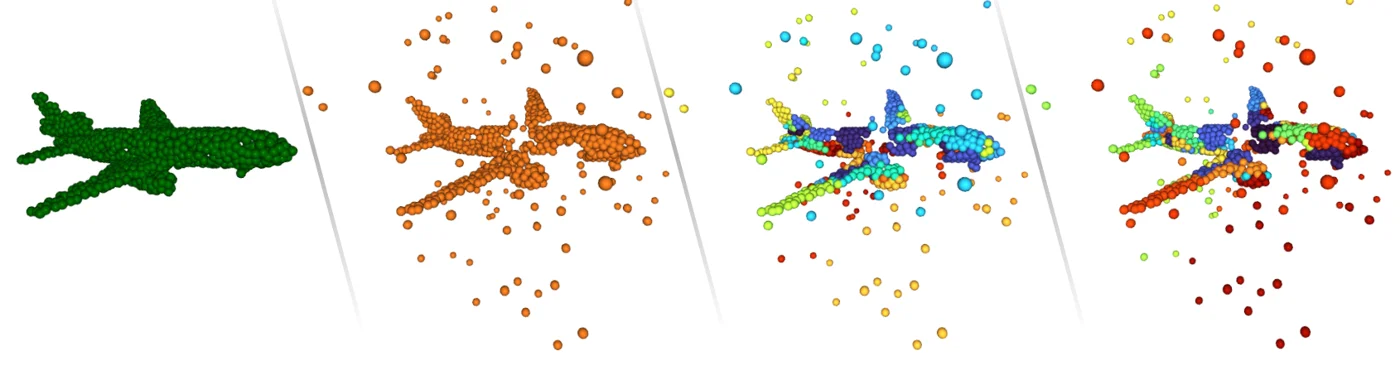 왼쪽부터 깨끗한 airplane, 흩어진 outlier point로 corrupt된 같은 shape, PG-SF로 순위를 매긴 token, PG-SP로 순위를 매긴 token이다. 빨간색이 가장 많이 shift된 token이다. 두 score 모두 떨어져 나온 outlier patch를 위쪽 순위에 두고, 동체와 날개 위의 patch는 낮게 둔다. 논문 Figure.
이 그림이 핵심 관찰이다. Shift는 특정 token에 집중되어 있고, source prototype까지의 단순한 거리만으로 그 token을 찾을 수 있다. Method 섹션의 분석은 이런 token이 왜 문제인지 설명한다. Noise가 token을 지배하면 LayerNorm 출력이 거의 random direction을 가리키고, attention layer는 uniform weight 쪽으로 흘러간다. 핵심 insight는 efficient transformer의 token pruning(예: Kim et al., 2022)에서 빌려온 것이다. Token pruning은 계산량을 줄이려고 uninformative token을 버린다. Purge-Gate는 대신 가장 많이 shift된 token을 버려서 attention을 보호한다. Gradient step도, weight 변경도 필요 없다.
Method
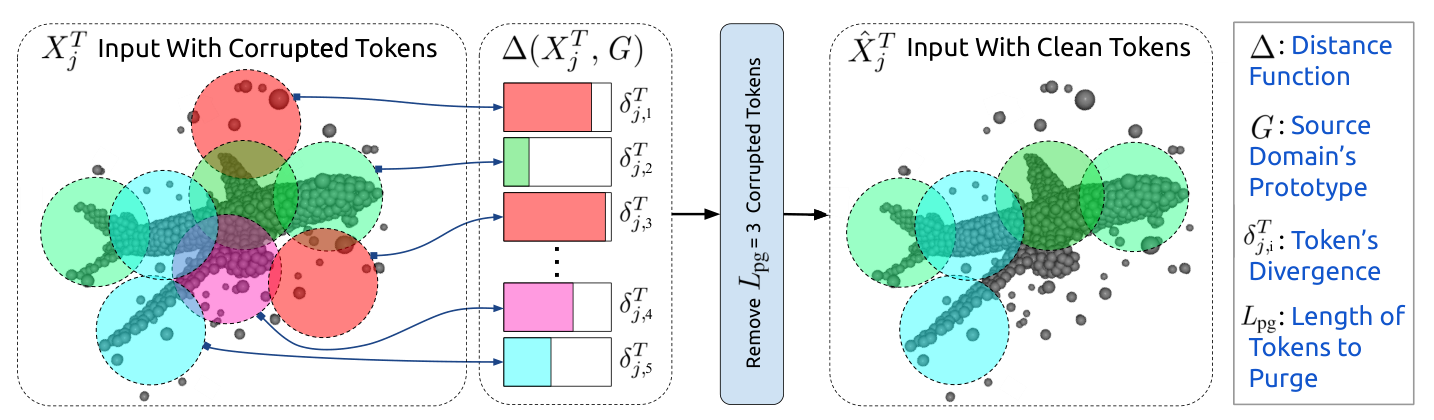 입력 token \(X_j^T\)는 source prototype \(G\)까지의 거리 \(\Delta\)로 점수가 매겨진다. 가장 크게 벗어난 \(L_{\text{pg}}\)개의 token이 제거되어 정제된 입력 \(\hat{X}_j^T\)가 된다. 그림은 논문에서 가져왔다.
Tokens
Backbone은 Point-MAE 방식의 transformer이다. Point cloud는 \(L_t\)개의 token으로 나뉜다. 각 token \(x_{i,t} = (c_t, \mathcal{N}_t)\)는 farthest point sampling으로 고른 center \(c_t\)와 그 \(k\)개의 nearest neighbor \(\mathcal{N}_t\)로 이루어진다. 그림 왼쪽의 색칠된 patch들이 이것이다.
Why noisy tokens hurt attention
논문은 distribution shift를 embedding에 더해지는 noise \(x_{j,t}^T = x_{j,t}^S + \epsilon_{j,t}\)로 모델링한다. LayerNorm은 locally Lipschitz이므로, 작은 noise는 token을 깨끗한 버전 근처에 머물게 한다. Noise가 지배적이면 \(\mathit{LN}(x_{j,t}^T) \approx \mathit{LN}(\epsilon_{j,t})\)가 되며, 이는 고차원에서 random direction에 가깝다. Random direction들은 거의 orthogonal하므로 이러한 token에 대한 attention score는 거의 0이 되고, softmax는 uniform weight 쪽으로 흘러간다.
\[A_{ij} = \frac{\exp(S_{ij}/\sqrt{d})}{\sum_k \exp(S_{ik}/\sqrt{d})} \approx \frac{1}{L_t}\]Uniform attention은 layer가 유용한 정보를 더 이상 aggregate하지 못한다는 뜻이다. 따라서 noise가 지배하는 token을 attention에 들어가기 전에 제거하자는 것이 핵심 아이디어이다.
The gate
그림의 가운데 부분이다. PG는 모든 target token과 source prototype \(G\) 사이의 거리를 계산한다.
\[\Delta(X_j^T, G) = (\delta_{j,1}^T, \delta_{j,2}^T, \dots, \delta_{j,L_t}^T)\]그런 다음 거리가 가장 큰 \(L_{\text{pg}}\)개의 token을 버린다.
\[\hat{X}_j^T = X_j^T \setminus \big\{ x_{j,t}^T \mid t \in \arg\max_{S \subseteq [L_t],\, |S| = L_{\text{pg}}} \sum_{t \in S} \delta_{j,t}^T \big\}\]Purge size는 batch를 병렬로 처리할 수 있도록 forward pass마다 고정된다. 남은 문제는 \(G\)와 \(\Delta\)를 어떻게 정하느냐뿐이다.
PG-SP: source prototype
\(G = (\mu_S, \sigma_S)\)는 source token embedding의 mean과 standard deviation이다. 이는 (a) Welford online algorithm으로 source data를 한 번 훑어서 수집하거나, (b) 학습 중에 이 statistics를 누적하는 수정된 첫 번째 LayerNorm으로 수집한다. 거리는 diagonal Mahalanobis distance이다.
\[\Delta(X_j^T, G) = \sqrt{(X_j^T - \mu_S)^T \Sigma_S^{-1} (X_j^T - \mu_S)}, \qquad \Sigma_S = \text{diag}(\sigma_S^2)\]PG-SF: source-free prototype
학습 가능한 [cls] token은 source token에 attend하고 이를 요약하도록 학습된다. 그래서 PG-SF는 이를 query space로 projection한 \(G = \mathit{LN}([\texttt{cls}])W_Q\)를 하나의 벡터로 된 prototype으로 사용한다. 각 token의 key는 negative cosine similarity로 이와 비교된다.
\[\Delta(X_j^T, G) = -\frac{(\mathit{LN}(X_j^T)W_K)\, G}{\|\mathit{LN}(X_j^T)W_K\| \cdot \|G\|}\][cls] query가 거의 attend하지 않을 token들이 제거된다.
Choosing the purge size, and BatchNorm
최적의 purge size는 corruption 종류에 따라 다르며, gradient 없이는 학습할 수 없다. PG는 작은 집합 \(\mathcal{L}_{\text{pg}} = \{0, 2, 4, 8, 16, 32\}\)에 대해 모델을 실행하고 entropy가 가장 낮은 출력을 택한다.
\[L_{\text{pg}}^* = \arg\min_{L \in \mathcal{L}_{\text{pg}}} H(f(x; L))\]마지막으로, adaptation pass가 없으므로 BatchNorm layer는 forward pass마다 현재 batch statistics를 사용하도록 reset된다.
Main Experiments
15개 corruption에 대한 평균 top-1 accuracy(%, 높을수록 좋음)이다. 모든 방법은 MATE가 공개한 Point-MAE backbone을 사용한다. Batch size 32, 1회 iteration, batch마다 모델을 reset한다. 이는 Table 1~3의 “Mean” 열이며, 논문은 corruption별 accuracy도 제시한다. *로 표시된 행은 저자들이 재현한 결과이다. MATE와 SMART-PC는 학습 시점 auxiliary task가 필요하며, 그 수치는 SMART-PC 논문에서 가져왔다.
| Method | Type | ScanObjectNN-C | ModelNet40-C | ShapeNet-C |
|---|---|---|---|---|
| Source Only | – | 36.96 | 54.16 | 61.35 |
| MATE | TTT | 36.90 | 58.90 | 63.10 |
| SMART-PC | TTT | 39.60 | 63.10 | 64.40 |
| TTT-Rot | TTA, backprop | 29.58 | 53.05 | 60.93 |
| SHOT | TTA, backprop | 27.69 | 26.60 | 36.19 |
| T3A* | TTA, backprop | 42.46 | 57.22 | 54.18 |
| TENT* | TTA, backprop | 43.45 | 63.53 | 54.98 |
| DUA | TTA, BP-free | 38.66 | 54.73 | 60.77 |
| BFTT3D* | TTA, BP-free | 33.00 | 57.16 | 60.73 |
| PG-SP | TTA, BP-free | 49.13 | 68.93 | 64.17 |
| PG-SF | TTA, BP-free, source-free | 47.54 | 68.68 | 64.40 |
ShapeNet-C에서 MATE와 SMART-PC 행은 “Standard” 변형이다.
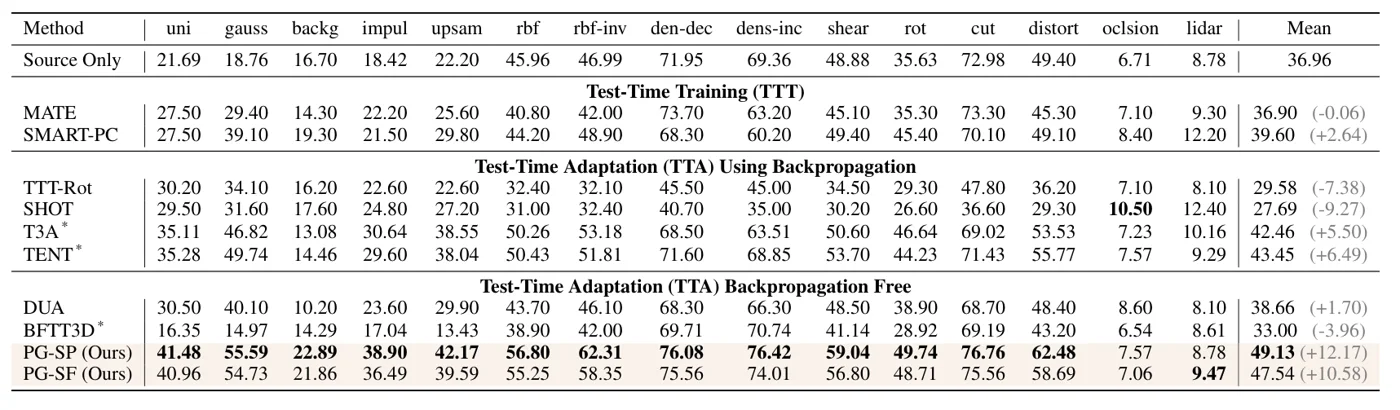 논문의 Table 1: ScanObjectNN-C의 15개 corruption 각각에 대한 top-1 accuracy이며, 괄호 안은 Source Only 대비 변화량이다. PG-SP는 15개 중 13개 corruption에서 최고이다. 예외는 occlusion과 LiDAR로, 모든 방법이 약 12% 이하에 머문다. 논문 Figure.
Corruption별로 보면 purging이 어디서 가장 효과적인지 알 수 있다. 가장 큰 향상은 point를 추가하거나 옮기는 noise에서 나온다. Uniform noise(21.69에서 41.48), Gaussian noise(18.76에서 55.59), impulse noise(18.42에서 38.90)이다. Occlusion과 LiDAR는 나쁜 point를 더하는 대신 shape의 일부를 지우므로 제거할 token이 거의 없고, PG-SP의 향상도 거의 없다.
BFTT3D 대비 비용(batch size 32, NVIDIA A6000 한 장, 여섯 가지 purge size는 병렬이 아니라 순차적으로 실행):
| Method | Time per batch | GPU memory |
|---|---|---|
| BFTT3D | 173.94 ms | 7400 MiB |
| PG-SP | 14.07 ms | 1300 MiB |
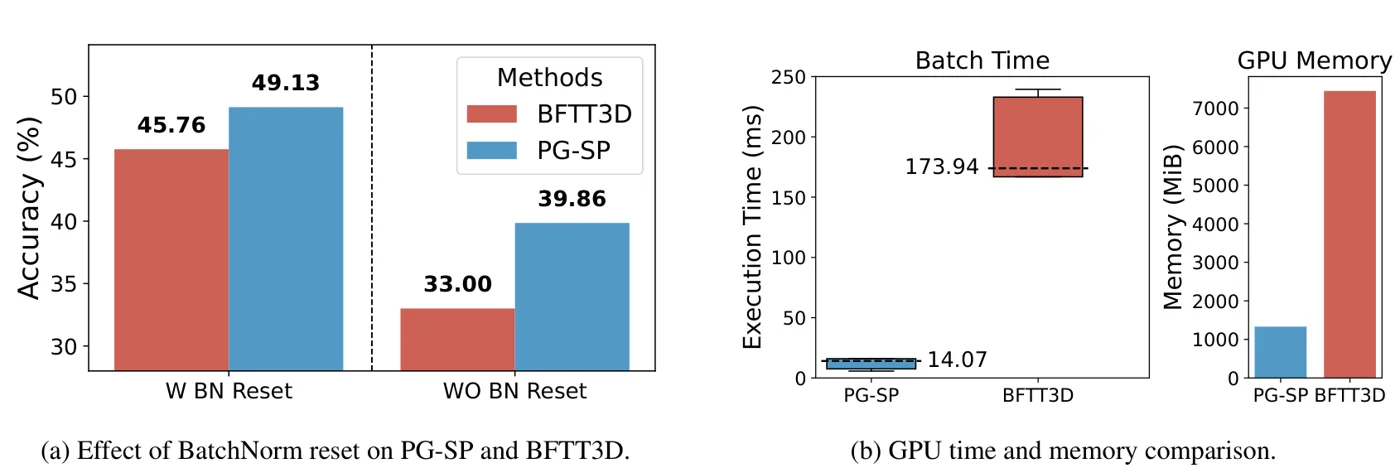 (a) BatchNorm reset 유무에 따른 PG-SP와 BFTT3D의 ScanObjectNN-C 평균 accuracy. (b) Batch size 32에서 batch당 시간과 GPU memory. PG-SP는 (a)의 두 설정 모두에서 앞서지만, reset만으로도 BFTT3D가 33.00에서 45.76으로 오른다. 논문 Figure.
(a)는 두 요소를 분리해서 보여준다. Reset이 없어도 PG-SP는 BFTT3D보다 약 7포인트 높으며(39.86 vs. 33.00), 이것이 purging만의 효과이다. 두 방법 모두 reset을 쓰면 격차는 약 3포인트로 줄어든다. (b)는 위의 비용 표를 그림으로 나타낸 것이다.
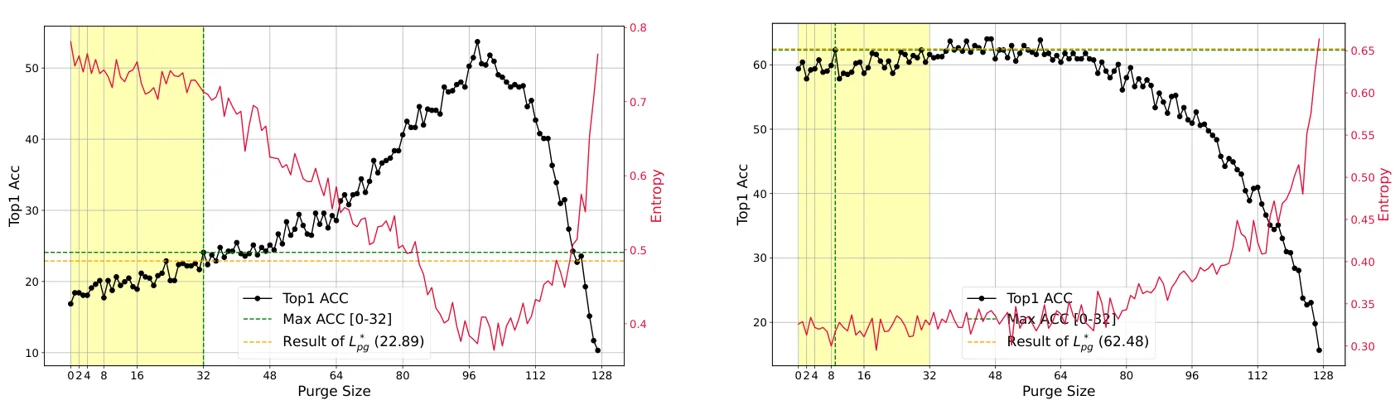 ScanObjectNN-C의 Background(왼쪽)와 Distortion(오른쪽) corruption에서 0부터 127까지 모든 purge size에 대한 accuracy(검은색)와 출력 entropy(빨간색). 노란 띠는 탐색 범위 [0, 32]이다. 주황색 선은 여섯 개 size 중 entropy 기반 선택이 얻은 accuracy이고, 초록색 선은 [0, 32] 안의 최고 accuracy이다. 논문 Figure.
이 그림은 entropy가 왜 괜찮은 selector인지 보여준다. Purge size가 커질수록 accuracy는 오르고 entropy는 내려가며, 약 100개 token을 넘으면 둘 다 방향이 바뀐다. Accuracy는 급락하고 entropy는 치솟는다. [0, 32] 안에서 entropy 선택은 최고값에 가깝다(Background에서 22.89 vs. 약 24, Distortion에서 62.48). 하지만 Background에서 실제 최고점은 약 100개 token을 제거했을 때의 50% 이상으로, 탐색 범위 밖에 있다.
PG-SP와 PG-SF는 ScanObjectNN-C와 ModelNet40-C에서 가장 높은 평균 accuracy를 기록하며, gradient step 없이도 TENT와 TTT 방법들을 앞선다. ShapeNet-C는 더 어렵다. 대부분의 TTA 방법이 Source Only보다 낮아지는 반면, PG는 약 3포인트를 얻어 SMART-PC와 동률이다. PG-SP는 BFTT3D보다 12.4배 빠르고 memory를 5.5배 적게 쓴다. Point-Mamba backbone(Table 4)에서 PG-SP는 ScanObjectNN-C를 29.11에서 41.42로, ModelNet-C를 58.32에서 68.61로 향상시키지만, ShapeNet-C에서는 Source Only보다 약간 낮다(51.66 vs. 51.92).
Limitations
논문에는 limitations 섹션이 없다. 근거가 있는 관찰은 다음과 같다.
- Batch마다 여러 번의 forward pass. Purge size 탐색은 \(\mathcal{L}_{\text{pg}}\)의 값마다(여섯 개) 모델을 한 번씩 실행한다. 이는 병렬 또는 순차로 실행되므로, 단일 forward pass보다 memory나 시간이 더 든다.
- 탐색 범위가 너무 좁을 수 있음. Supplementary는 심한 corruption에서는 훨씬 더 많은 purging이 필요함을 보여준다. Severity 7의 background corruption에서 accuracy는 \(L_{\text{pg}} \approx 112\) 근처에서 최고(33%)에 달하지만, \([0, 32]\) 범위에서 가장 좋은 값은 16%에 그친다. 고정된 집합 \(\{0, 2, 4, 8, 16, 32\}\)로는 여기에 도달할 수 없다.
- BatchNorm reset의 영향이 큼. Reset이 없으면 PG-SP는 ScanObjectNN-C에서 49.13에서 39.86으로 떨어진다. 같은 reset은 BFTT3D를 33.00에서 45.76으로 끌어올리지만, Table 1에는 BFTT3D가 33.00으로 기재되어 있다. BFTT3D 대비 주요 격차의 일부는 purging이 아니라 reset에서 온다. Reset은 batch statistics에도 의존한다. Batch size 연구(ShapeNet-C)는 batch size가 커질수록 accuracy가 여전히 오른다는 것을 보여주지만, PG-SP는 모든 크기에서 TENT보다 높다.
- PG-SP는 source 접근 또는 재학습이 필요. PG-SP는 statistics를 위한 source data나, 수정된 LayerNorm으로 학습된 모델이 필요하다. PG-SF는 이를 피하지만 [cls] token과 query/key projection이 필요하므로 transformer classifier에 묶여 있다. Mamba 실험은 PG-SP만 사용한다.
- Global token distance만 사용. Source mean에서 멀리 떨어진 token이 항상 corrupt된 것은 아니다. 너무 많이 제거하면 informative token까지 사라지며, ablation에서 purge token이 약 80~100개를 넘으면 accuracy가 급격히 떨어진다.
- Synthetic distribution shift 위주. Real-world distribution shift는 두 가지 ScanObjectNN 변형에서만 시험되며, 향상 폭도 더 작다(OBJ-BG에서 +1.38, PB-T50-RS에서 +4.30).