Abstract
Test-time prompt tuning(TPT)은 augmented view들에 대한 prediction entropy를 최소화하여 CLIP의 text prompt를 각 test image에 맞게 조정한다. 이는 zero-shot accuracy를 높이지만, 동시에 모델을 overconfident하게 만들어 expected calibration error(ECE)를 크게 증가시킨다. C-TPT는 class text feature를 L2 거리 기준으로 centroid에서 멀어지게 하는 Average Text Feature Dispersion(ATFD) loss로 이 문제를 다루었다. 저자들은 이것만으로는 충분하지 않다고 주장한다. Unit hypersphere 위에서 centroid를 원점 쪽으로 옮긴다고 해서 개별 class feature들이 서로 멀리 떨어진다는 보장은 없다. 어려운 경우에는 일부 feature가 여전히 가깝게 모여 있으며, 이러한 경우에 ECE가 높다.
O-TPT는 dispersion을 angular objective로 대체한다. Class text feature 간 pairwise cosine similarity 행렬을 identity 쪽으로 미는 penalty를 추가하여, feature들이 orthogonal에 가까워지도록 한다. 저자들은 text feature 간 cosine similarity가 낮을수록 ECE도 낮다는 것을 보이고, 이 단순한 constraint가 C-TPT와 Robust-Adapt 변형들보다 ECE를 더 많이 낮춘다는 것을 보인다.
Motivation
출발점은 hand-crafted prompt에 대한 관찰이다. 서로 다른 prompt style은 CLIP에 거의 같은 accuracy를 주면서도 calibration은 크게 다를 수 있다. C-TPT는 이를 centroid 주변 text feature의 L2 dispersion으로 설명했다. 저자들은 대신 angle을 본다. Caltech101에서 여러 prompt style(zero-shot CLIP)에 대해 class text feature 간 pairwise cosine similarity의 분포를 그린다.
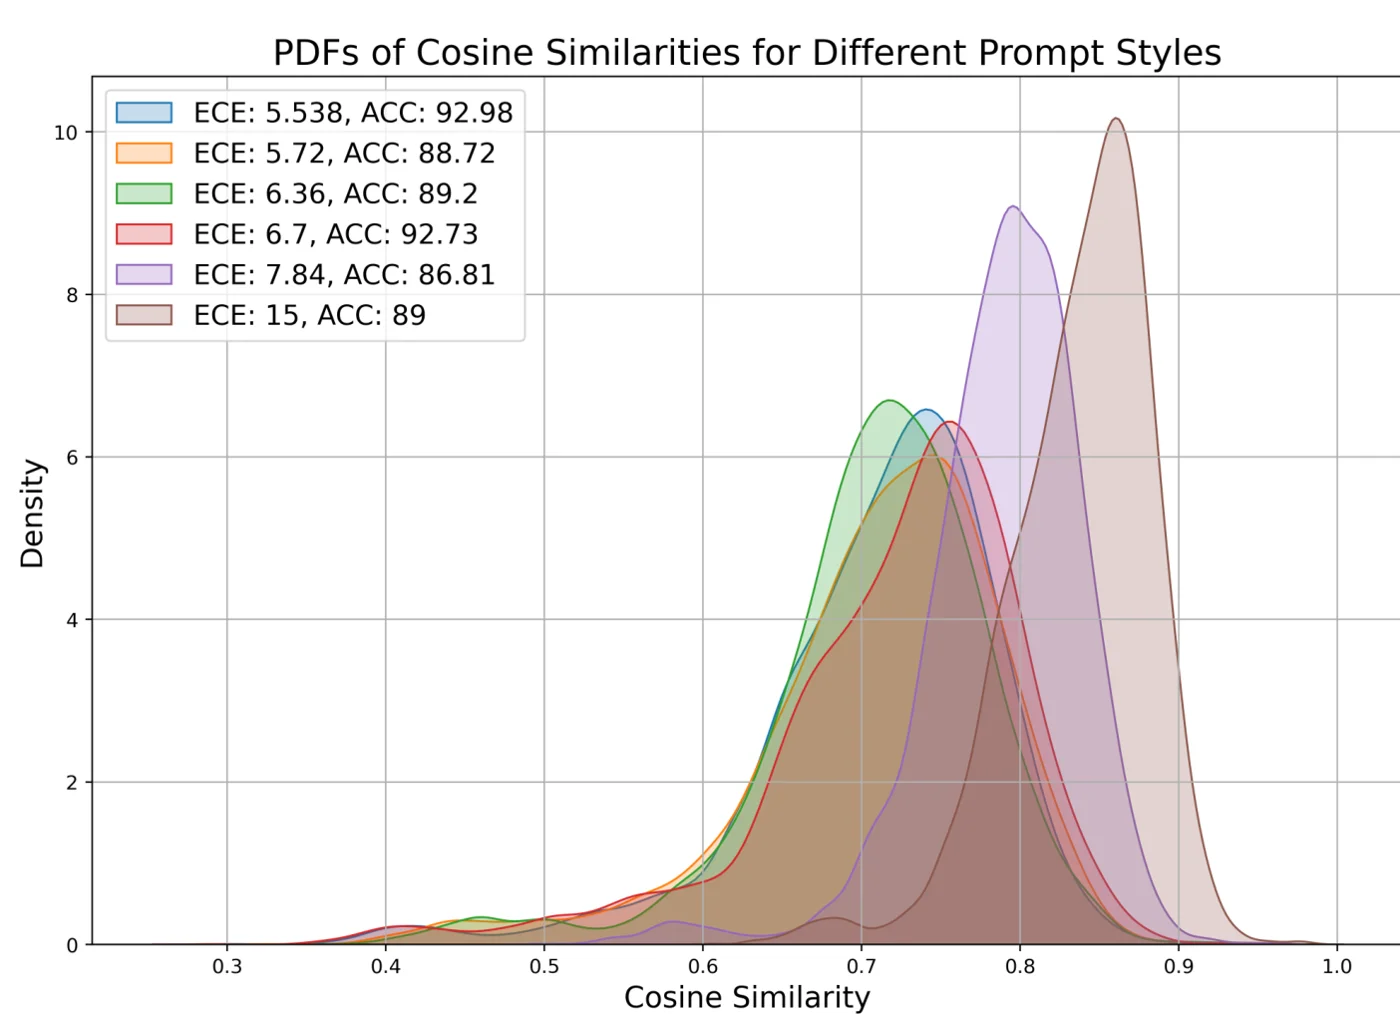 Caltech101에서 hand-crafted prompt style별 class text feature 간 pairwise cosine similarity 분포. ECE가 낮은 prompt일수록 왼쪽(낮은 similarity, 큰 angle)에 위치하고, 가장 나쁜 prompt(ECE 15)는 accuracy(89)가 다른 prompt와 비슷한데도 0.86 근처에서 peak를 가진다. 논문 Figure.
순서가 깔끔하다. ECE 5.5-5.7인 prompt는 0.72-0.74 근처, ECE 7.84인 prompt는 0.80 근처, ECE 15인 prompt는 0.86 근처에서 peak를 가진다. Accuracy는 이 순서를 전혀 따르지 않는다. Appendix에서는 80개 prompt template과 7개 dataset으로 같은 확인을 반복하고, mean cosine similarity와 ECE 사이에 같은 관계를 찾는다. 즉 calibration 신호를 담는 것은 centroid 주변의 퍼짐만이 아니라 class feature 간 angle인 것으로 보인다.
두 번째 근거는 test sample 단위의 분석이다. 저자들은 Flowers에서 TPT, C-TPT, O-TPT를 돌리고, test image마다 tuning된 class text feature의 mean cosine similarity를 기록한다.
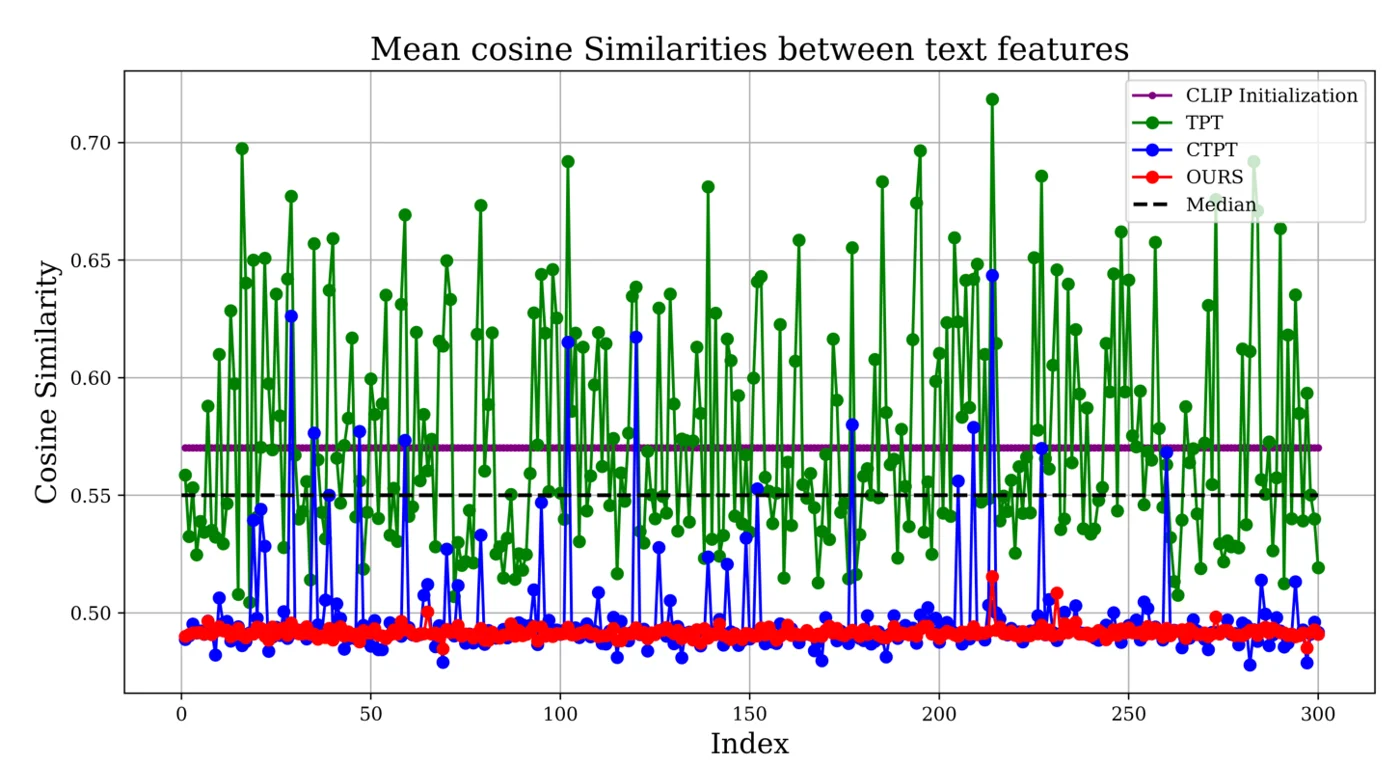 Flowers(CLIP ViT-B/16)에서 test sample별 tuning된 text feature의 mean pairwise cosine similarity. TPT(초록)는 많은 sample에서 similarity를 CLIP initialization(보라)보다 높이며 크게 요동친다. C-TPT(파랑)는 대체로 낮지만 0.55-0.65까지 튀는 spike가 자주 나온다. O-TPT(빨강)는 0.49 근처에서 평평하게 유지된다. 논문 Figure.
TPT의 entropy minimization은 class feature들을 서로 끌어당기는 경우가 많고, 이때 overconfident해진다. C-TPT는 대부분의 sample에서 이를 고치지만, spike는 TPT가 실패하는 바로 그 어려운 sample에서 나타나며, 이들이 ECE가 높은 sample이다(아래 분석의 Group 1). O-TPT가 기반으로 하는 insight는, L2 dispersion은 모든 pair를 떼어놓지 않고 centroid만 옮겨도 만족될 수 있으므로 pairwise angle을 직접 penalize하는 편이 낫다는 것이다.
Method
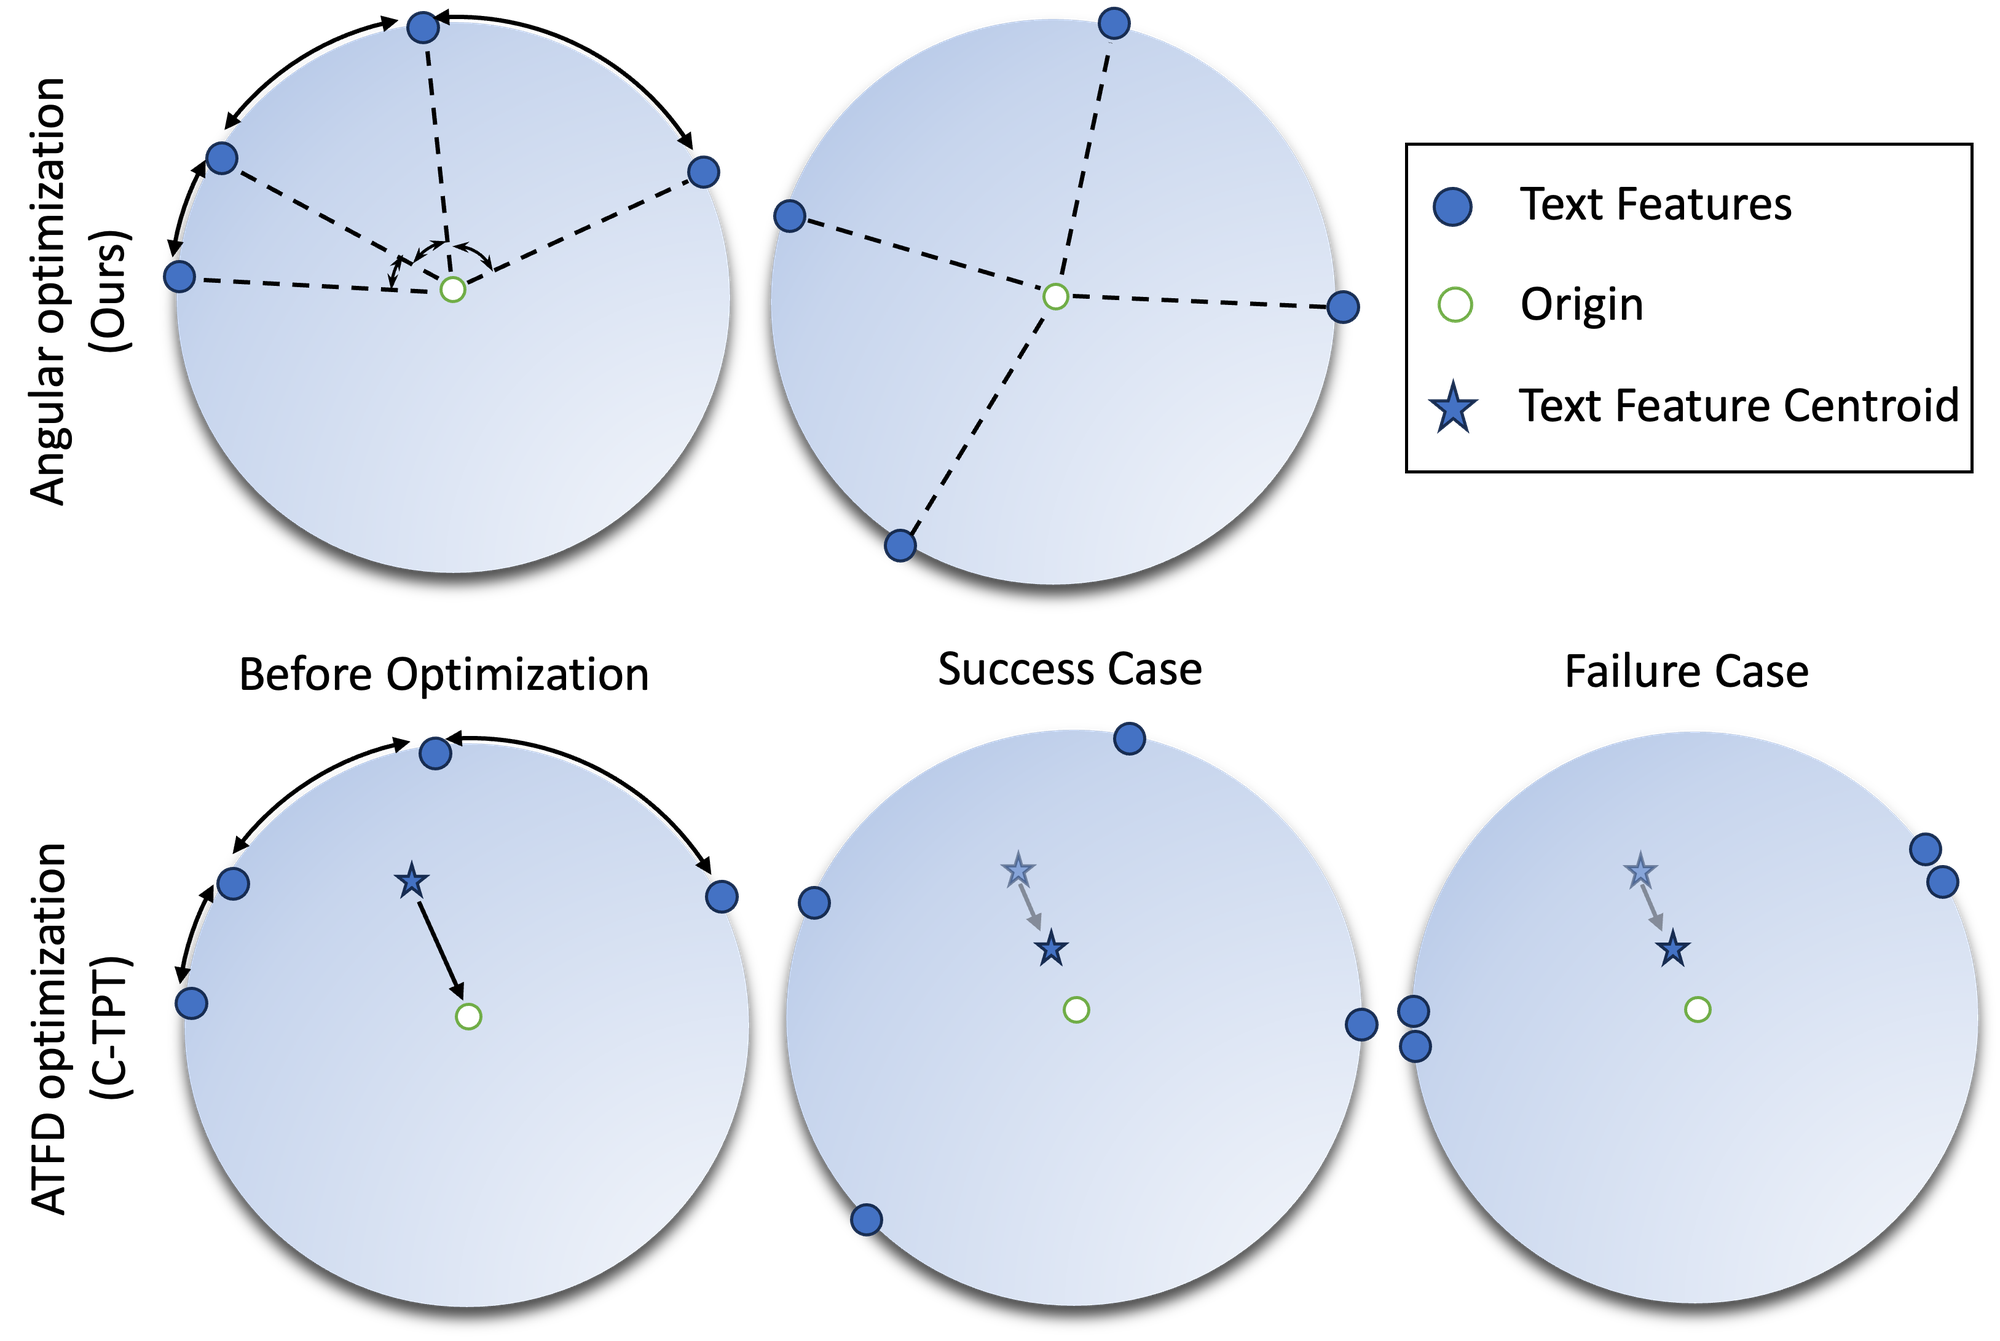 Text feature hypersphere 위에서의 angular optimization(O-TPT, 위)과 ATFD optimization(C-TPT, 아래) 비교. ATFD는 centroid를 원점 쪽으로 옮기는데, 이는 성공할 수도 있지만 feature들이 여전히 뭉쳐 있는 채로 남을 수도 있다. O-TPT는 feature들을 각도상으로 퍼뜨린다. 그림은 논문에서 가져왔다.
Setup
CLIP은 text encoder \(\mathbf{f}_T\)와 image encoder \(\mathbf{f}_I\)를 가진다. 각 class \(c_i\)에 대해 prompt \(\mathbf{t}_{c_i}\)(예: “a photo of a {class}”)는 text feature \(\mathbf{e}_{c_i} = \mathbf{f}_T(\mathbf{t}_{c_i})\)를 만든다. Test image는 \(\mathbf{v} = \mathbf{f}_I(I)\)를 만들고, class probability는 temperature \(\tau\)를 사용한 cosine similarity \(s_i = \cos(\mathbf{v}, \mathbf{e}_{c_i})\)에 대한 softmax이다. TPT에서는 prompt token이 학습 가능하며, confidence가 높은 augmented view들에 대한 entropy loss \(L_{TPT}\)를 사용해 test image마다 한 번의 gradient step으로 갱신된다. Calibration은 ECE로 측정한다.
\[\text{ECE} = \sum_{m=1}^{M} \frac{\lvert A_m \rvert}{N} \left\lvert \text{acc}(A_m) - \text{conf}(A_m) \right\rvert.\]Why angles and not L2 dispersion
그림이 이 논지를 보여준다. Normalize된 CLIP text feature는 unit hypersphere 위에 놓인다. ATFD(아래 행)는 각 feature와 centroid 사이의 거리를 최대화하며, 실제로는 centroid를 원점 쪽으로 옮기는 효과를 낸다. 성공 사례에서는 이것이 feature들을 퍼뜨린다. 실패 사례에서는 centroid가 움직이지만 일부 feature 쌍은 여전히 가깝게 남아 있어 공간이 충분히 활용되지 않는다.
저자들은 두 가지 분석으로 이를 뒷받침한다. 첫째, 여러 hand-crafted prompt 스타일에 걸쳐, ECE가 낮은 prompt일수록 cosine similarity 분포가 더 낮은 값 쪽으로 이동해 있다. 둘째, TPT text feature의 평균 cosine similarity가 중앙값보다 높은지(Group 1) 낮은지(Group 2)에 따라 test sample을 나눈다. 더 어려운 Group 1에서 ECE는 TPT가 15.97, C-TPT가 6.04, O-TPT가 4.75이다. 즉 text feature가 collapse하는 sample에서 calibration이 실패하며, C-TPT는 이를 완전히 해결하지 못한다.
The orthogonality constraint
모든 \(C\)개 class의 text feature를 쌓아 \(\mathbf{E} \in \mathbb{R}^{C\times D}\)를 만든다. 그러면 \(\mathbf{E}\mathbf{E}^T\)는 pairwise cosine similarity를 담는다. 이상적인 경우는 모든 class feature가 orthogonal한 \(\mathbf{E}\mathbf{E}^T = I_C\)이다. O-TPT는 이를 TPT loss에 penalty로 더한다.
\[\mathbf{t}^{*} = \arg\min_{\mathbf{t}} \left( L_{TPT} + \lambda \left\lVert \mathbf{E}\mathbf{E}^{T} - I_C \right\rVert_2^2 \right).\]최적화되는 것은 prompt \(\mathbf{t}\)뿐이다. Normalize된 feature에서는 \(\mathbf{E}\mathbf{E}^T\)의 대각 성분이 이미 1이므로, 사실상 이 항은 모든 off-diagonal cosine similarity를 0 쪽으로 민다. 그림의 위쪽 행이 보여주는 것이 바로 이것으로, centroid만 옮기는 대신 feature들이 각도상으로 퍼진다.
Details
Prompt는 C-TPT와 마찬가지로 hard prompt로 초기화되며, 단 한 번의 AdamW step(learning rate 0.005, augmented view 64개의 batch)으로 갱신된다. One-step optimization을 돕기 위해 \(\mathbf{E}\mathbf{E}^T\) 위에 Householder transform이 적용된다. 논문은 이 단계를 자세히 설명하지 않지만, 이를 제거하면 fine-grained benchmark의 평균 ECE가 4.23에서 4.45로 오른다고 보고한다(ViT-B/16). 가중치는 fine-grained dataset에 \(\lambda = 18\), ImageNet 변형들에 \(\lambda = 2\)이다.
Main Experiments
Backbone은 CLIP ViT-B/16과 CLIP RN50이다. 지표는 top-1 accuracy(%)와 ECE(%)이다. Fine-grained 표는 논문 Table 4와 5의 Average 열만 보여주며, 이는 11개 dataset(ImageNet, DTD, Flowers, Food101, SUN397, Aircraft, Pets, Caltech101, UCF101, EuroSAT, Cars)의 평균이다. Robust-Adapt 행은 Murugesan 등의 logit normalization 방법을 C-TPT와 함께 적용한 것이다.
Fine-grained classification, 11개 dataset 평균
| Method | ViT-B/16 Acc. | ViT-B/16 ECE | RN50 Acc. | RN50 ECE |
|---|---|---|---|---|
| Zero-shot CLIP | 63.7 | 4.43 | 55.9 | 5.61 |
| TPT | 65.0 | 11.6 | 57.7 | 11.7 |
| C-TPT | 64.57 | 5.13 | 57.75 | 6.19 |
| Robust-adapt-SaLs-CTPT | 64.55 | 5.69 | 57.20 | 6.82 |
| Robust-adapt-Penalty-CTPT | 64.65 | 4.66 | 57.40 | 6.41 |
| Robust-adapt-ZS-CTPT | 64.51 | 5.09 | 57.41 | 6.34 |
| O-TPT | 64.41 | 4.23 | 57.47 | 5.45 |
Natural distribution shift, ImageNet-A, -V2, -R, -Sketch 평균 (Table 6의 Average 열)
| Method | ViT-B/16 Acc. | ViT-B/16 ECE | RN50 Acc. | RN50 ECE |
|---|---|---|---|---|
| Zero-shot CLIP | 57.2 | 5.04 | 40.6 | 7.46 |
| TPT | 59.9 | 12.0 | 43.5 | 16.7 |
| C-TPT | 59.6 | 5.82 | 42.8 | 12.1 |
| O-TPT | 57.80 | 4.88 | 41.16 | 9.69 |
O-TPT는 두 benchmark와 두 backbone 모두에서 test-time 방법들 중 가장 낮은 평균 ECE를 기록한다. Fine-grained benchmark에서는 ECE가 zero-shot CLIP보다도 낮은데, 표의 다른 어떤 test-time 방법도 이를 달성하지 못한다. 논문 본문은 ViT-B/16 평균 ECE를 4.21로 인용하지만 표에는 4.23으로 되어 있으며, 여기서는 표의 값을 사용했다. Calibration 향상에는 accuracy 손실이 따른다. ViT-B/16 기준 fine-grained dataset에서 TPT 대비 약 0.6포인트, ImageNet 변형에서 2.1포인트이다. O-TPT는 CoOp prompt 위에 더했을 때(평균 ECE 7.91, C-TPT는 10.04, TPT는 18.36)와 MaPLe 위에 더했을 때에도 ECE를 낮춘다.
Dataset별로 보면 평균만큼 균일하지는 않다. 논문의 teaser는 C-TPT 및 가장 좋은 Robust-Adapt 변형과 dataset별 ECE를 비교한다.
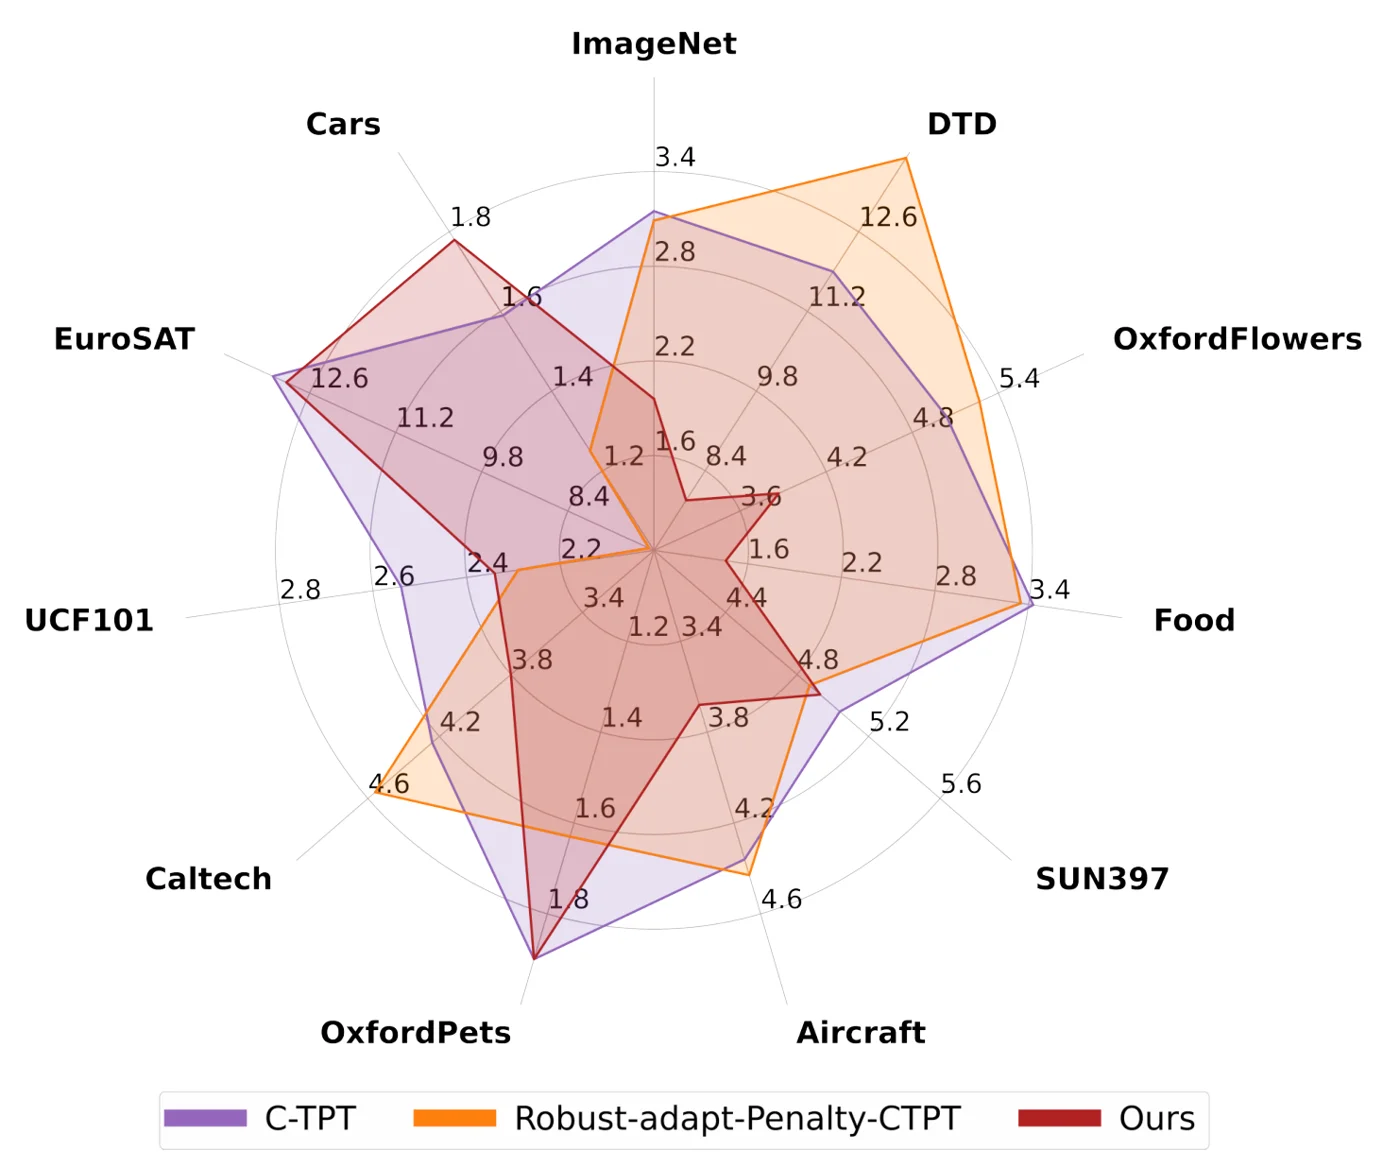 C-TPT(보라), Robust-adapt-Penalty-CTPT(주황), O-TPT(빨강)의 dataset별 ECE. 축마다 scale이 다르며 작을수록 좋다. O-TPT는 DTD, Flowers, Food, Aircraft에서 훨씬 낮지만, Cars에서는 다른 방법보다 높고 EuroSAT과 Pets에서는 C-TPT와 비슷하다. 논문 Figure.
가장 큰 향상은 C-TPT가 여전히 뚜렷하게 overconfident한 DTD, Flowers, Food에서 나온다. Cars에서는 O-TPT가 셋 중 가장 나쁘지만, 값이 모두 2 미만이므로 절대적인 차이는 작다.
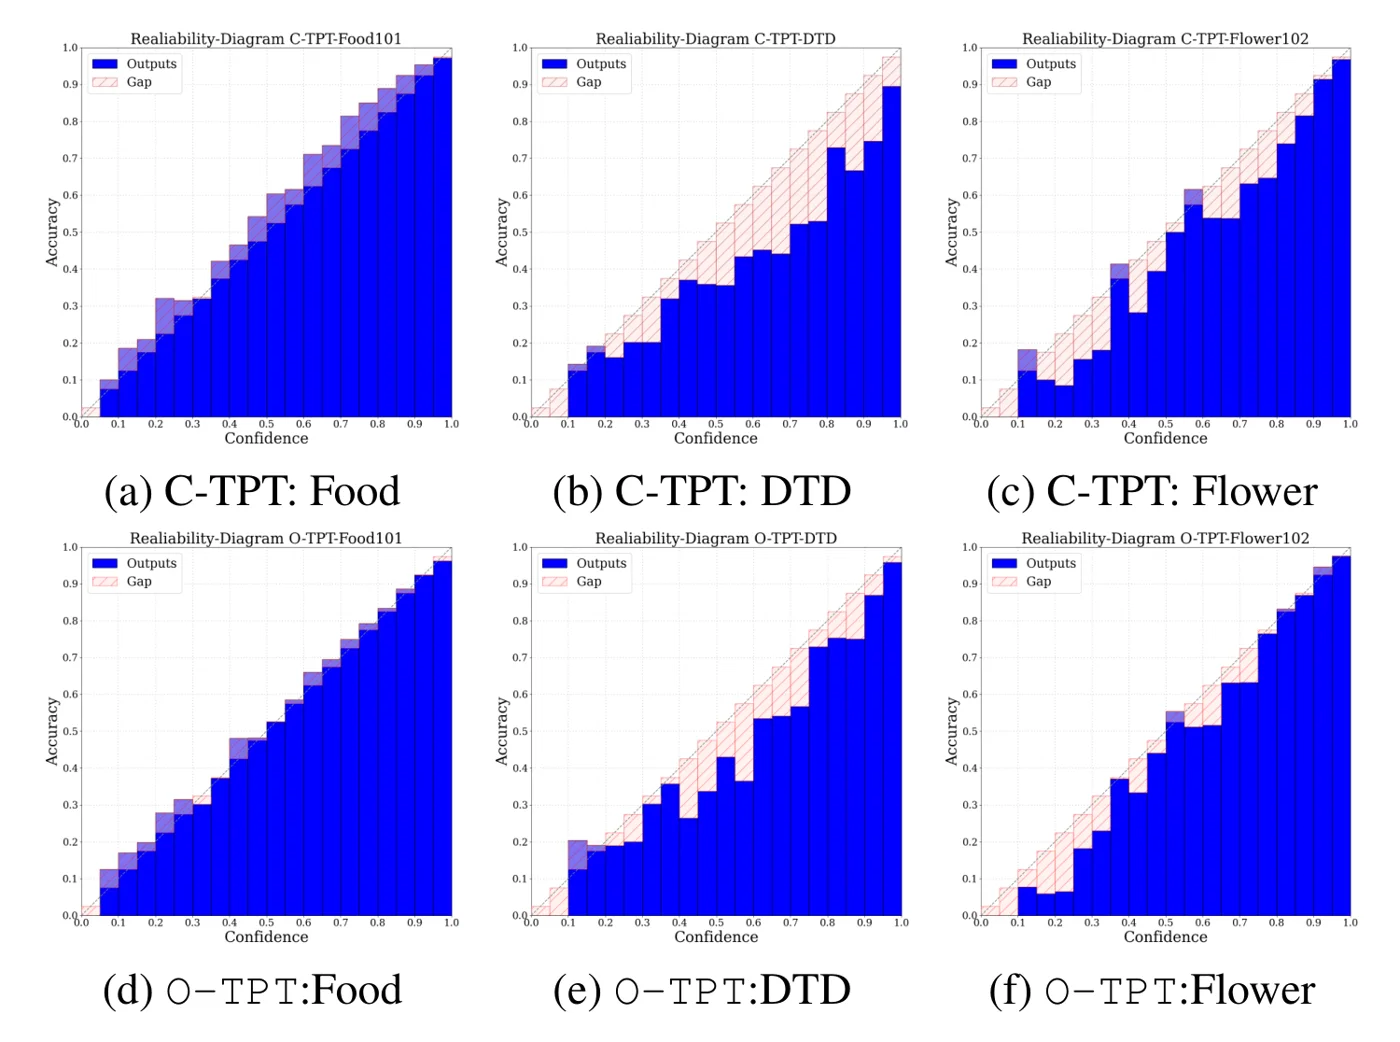 Food101, DTD, Flowers에서 C-TPT(위)와 O-TPT(아래)의 reliability diagram(CLIP ViT-B/16). Bar가 diagonal 아래에 있으면 overconfidence, 위에 있으면 underconfidence이다. O-TPT는 DTD와 Flowers의 overconfident gap을 줄이고, Food에서 C-TPT의 약한 underconfidence를 없앤다. 논문 Figure.
Reliability diagram은 O-TPT가 overconfidence를 underconfidence로 바꾸기만 하는 것이 아님을 보여준다. Food에서는 diagonal 위에 있던 C-TPT의 bar를 diagonal에 맞추고, DTD와 Flowers에서는 C-TPT의 큰 빗금 gap이 작아진다. DTD는 중간 confidence 구간에 여전히 gap이 보인다.
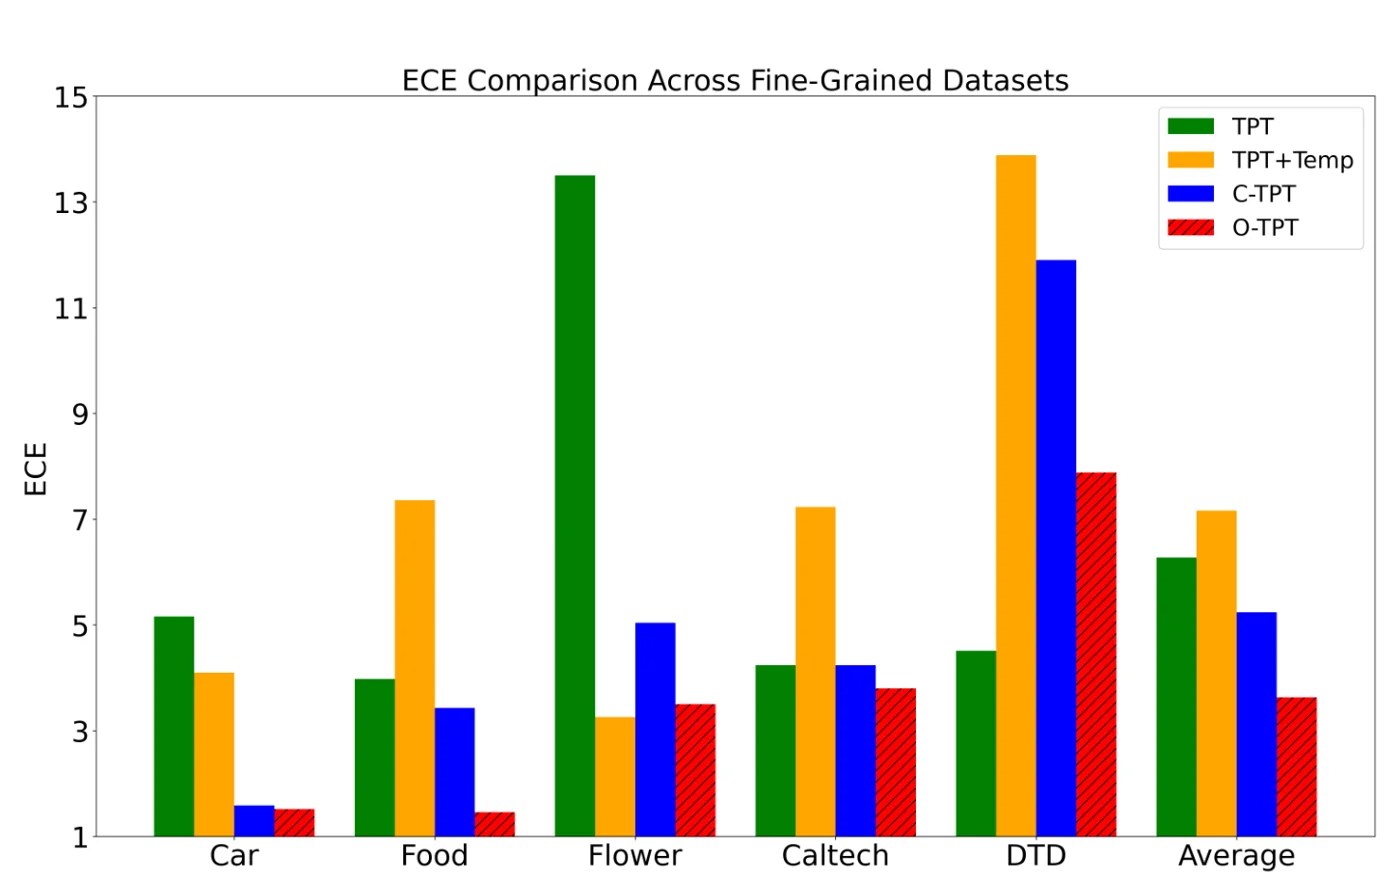 5개 fine-grained dataset과 그 평균에서 TPT, temperature scaling을 적용한 TPT, C-TPT, O-TPT의 ECE. Temperature는 별도의 labeled validation set에서 학습되지만, 평균 ECE는 O-TPT가 가장 낮다. 논문 Figure.
이 비교가 중요한 이유는 temperature scaling이 test-time 방법에는 없는 label을 사용하기 때문이다. 이 plot에서 TPT+Temp는 평균적으로 plain TPT보다도 나쁘다(Cars와 Flowers에서는 도움이 되지만 Food, Caltech, DTD에서는 오히려 나빠진다). 이는 다른 split에서 학습된 단일 temperature가 sample별 prompt tuning에 잘 옮겨지지 않음을 시사한다.
Limitations
- 명시된 limitation 없음. 논문에는 limitations 섹션이 없다.
- Distribution shift에서의 accuracy 하락. ViT-B/16을 사용한 ImageNet 변형에서 accuracy는 59.9(TPT)에서 57.80으로 떨어지며, ImageNet-R은 72.55로 zero-shot CLIP(74.0)보다 낮아진다. 여기서는 TPT의 accuracy 향상 대부분이 사라진다.
- 항상 zero-shot보다 나은 것은 아님. Natural distribution shift에서 RN50을 사용할 때 O-TPT의 평균 ECE(9.69)는 여전히 zero-shot CLIP(7.46)보다 높다.
- Class 수가 차원 수보다 많으면 정확한 orthogonality는 불가능. \(\mathbf{E}\mathbf{E}^T\)의 rank는 최대 \(D\)이므로, ImageNet의 1000개 class와 512차원 ViT-B/16 embedding에서는 목표 \(I_C\)에 도달할 수 없다. Penalty는 여전히 평균 similarity를 낮추지만, 그 optimum이 무엇인지는 더 이상 명확하지 않다. 후속 연구인 A-TPT가 이 지점에서 출발한다.
- Hyperparameter 선택. \(\lambda\)는 fine-grained 데이터에서 18, ImageNet 변형에서 2이다. Label 없이 새로운 target domain에서 이를 어떻게 정할지는 논의되지 않는다. \(\lambda\)에 대한 Pareto plot은 Food101과 Flowers에 대해서만 제시된다.
- 비용. Penalty는 test image마다 전체 \(C\times C\) similarity 행렬을 필요로 하므로, TPT에 더해 \(O(C^2 D)\)의 비용이 든다. 본문은 runtime이나 memory를 보고하지 않는다. Householder 단계는 짧게만 설명된다.
- 일부 dataset은 여전히 calibration이 좋지 않음. EuroSAT의 ECE는 ViT-B/16에서 12.98, RN50에서 14.71로 C-TPT와 거의 차이가 없다.