5장은 이미지 처리의 기본 도구인 합성곱 신경망(Convolutional Neural Network, CNN) 을 다룬다. 합성곱층과 풀링층이 무엇을 계산하는지부터 시작해, 간단한 CNN을 직접 학습시키고, 이미 학습된 대형 모델을 빌려 쓰는 전이 학습, CNN 내부를 들여다보는 특성 맵 시각화, 그래프 데이터로 합성곱을 확장한 GCN 순서로 진행한다.
5.1 합성곱 신경망
완전연결 신경망은 역전파 때 모든 노드 사이의 가중치에 대해 기울기를 계산해야 하므로, 입력이 큰 이미지에서는 계산량과 메모리 사용량이 급격히 커진다. 합성곱 신경망은 이미지 전체를 한꺼번에 처리하지 않고 작은 국소 영역 단위로 같은 연산을 반복한다. 덕분에 파라미터 수와 계산량을 줄이면서도 이미지의 세밀한 구조를 분석할 수 있다.
5.1.1 합성곱층의 필요성
3×3 흑백 이미지를 완전연결층에 넣으려면 먼저 9개 값을 한 줄로 펼쳐야(flatten) 한다. 그러면 “어떤 픽셀이 어떤 픽셀의 위나 옆에 있었는가”라는 공간 구조가 사라진다. 이미지에서 의미 있는 패턴(모서리, 질감, 형태)은 이웃한 픽셀들의 관계에서 나오므로, 이 정보를 버리면 학습이 비효율적이 된다. 합성곱층은 2차원 배치를 그대로 유지한 채 이웃 픽셀을 묶어 처리하기 위해 도입되었다.
5.1.2 합성곱 신경망 구조
CNN은 보통 다섯 종류의 층으로 이루어진다.
- 입력층(input layer)
- 합성곱층(convolutional layer)
- 풀링층(pooling layer)
- 완전연결층(fully connected layer)
- 출력층(output layer)
합성곱층과 풀링층을 번갈아 지나며 이미지의 주요 특성(feature) 을 뽑고, 완전연결층에서 이를 1차원 벡터로 받아 분류하며, 출력층의 소프트맥스(softmax)가 클래스별 확률을 낸다.
입력층. 이미지는 높이(height), 너비(width), 채널(channel) 을 갖는 3차원 데이터다. 흑백(grayscale)이면 채널이 1, 컬러(RGB)면 3이다. 예를 들어 4×4 크기의 RGB 이미지는 (4, 4, 3) 형태가 된다. 참고로 PyTorch는 채널을 앞에 두는 (C, H, W) 순서를 쓴다.
합성곱층. 작은 가중치 행렬인 커널(kernel) 또는 필터(filter) 를 이미지 위에 겹쳐 놓고, 겹친 위치의 값끼리 곱해서 모두 더한 값을 하나 출력한다. 커널을 정해진 간격인 스트라이드(stride) 만큼 옮기며 이 계산을 반복하면 새로운 2차원 결과가 생기는데, 이것이 특성 맵(feature map) 이다. 커널은 3×3이나 5×5를 주로 쓴다.
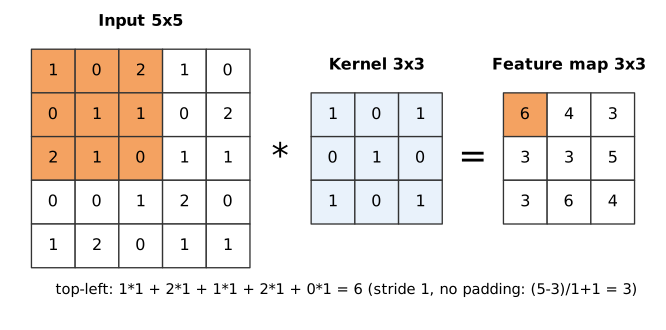 5×5 입력에 3×3 커널을 스트라이드 1로 적용하는 예. 주황색 영역과 커널을 원소별로 곱해 더하면 특성 맵의 왼쪽 위 값 6이 된다. 커널을 한 칸씩 옮기며 같은 계산을 하면 3×3 특성 맵이 채워진다.
책의 예시처럼 6×6 흑백 이미지에 3×3 커널을 스트라이드 1로 적용하면 커널이 가로·세로로 각각 4번 위치할 수 있으므로 결과는 4×4가 된다. 커널이 이미지 밖으로 나갈 수 없어서 출력이 입력보다 작아지는 것이다.
컬러 이미지라면 커널도 입력 채널 수만큼(여기서는 3장) 깊이를 갖는다. R, G, B 채널마다 서로 다른 가중치로 합성곱을 한 뒤 세 결과를 더해서 한 장의 특성 맵을 만든다. 따라서 깊이가 3인 커널이라도 필터는 1개이며, 출력 채널도 1개다. 필터를 K개 쓰면 특성 맵이 K장 생기고, 이것이 곧 출력 채널 수가 된다.
합성곱층의 입출력 관계는 다음과 같이 정리된다. 입력이 \(W_1 \times H_1 \times D_1\)(가로, 세로, 채널)이고, 필터 개수 \(K\), 필터 크기 \(F\), 스트라이드 \(S\), 패딩(padding) \(P\)를 쓰면 출력은 다음과 같다.
\[W_2 = \frac{W_1 - F + 2P}{S} + 1, \qquad H_2 = \frac{H_1 - F + 2P}{S} + 1, \qquad D_2 = K\]패딩은 입력 가장자리에 0을 둘러 출력 크기를 조절하는 장치다. 3×3 커널에 \(P=1\), \(S=1\)을 쓰면 \(W_2 = W_1\)이 되어 크기가 유지된다.
풀링층. 특성 맵을 작게 줄이는 다운 샘플링(down sampling) 을 수행한다. 크기가 줄면 이후 층의 연산량이 감소하고, 작은 위치 변화에 덜 민감한 대표값만 남는다. 연산은 두 가지가 대표적이다.
- 최대 풀링(max pooling): 창 안의 최댓값을 고른다.
- 평균 풀링(average pooling): 창 안의 평균을 낸다.
평균을 내면 강하게 반응한 값이 주변 값에 묻혀 흐려지기 쉽기 때문에, 대부분의 CNN은 최대 풀링을 쓴다.
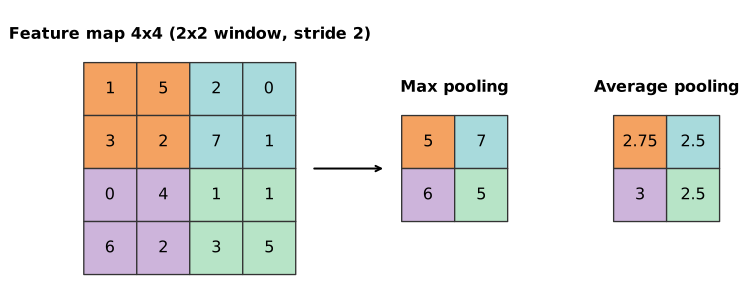 4×4 특성 맵에 2×2 창, 스트라이드 2로 풀링한 결과. 같은 색 영역이 하나의 출력 값이 된다. 최대 풀링은 각 영역의 가장 큰 값(5, 7, 6, 5)을, 평균 풀링은 평균(2.75, 2.5, 3, 2.5)을 남긴다.
풀링층은 학습할 가중치가 없고 채널별로 독립적으로 동작한다. 창 크기 \(F\), 스트라이드 \(S\)일 때 출력은 다음과 같다.
\[W_2 = \frac{W_1 - F}{S} + 1, \qquad H_2 = \frac{H_1 - F}{S} + 1, \qquad D_2 = D_1\]완전연결층. 합성곱과 풀링을 거쳐 작아진 3차원 특성 맵을 1차원 벡터로 펼친 뒤, 일반적인 선형층으로 연결한다.
출력층. 소프트맥스 함수가 각 출력을 0과 1 사이의 값으로 바꾸고 합이 1이 되게 하여 클래스별 확률로 해석할 수 있게 한다. 가장 큰 확률을 가진 레이블이 최종 예측이 된다.
\[\text{softmax}(z)_i = \frac{e^{z_i}}{\sum_{j} e^{z_j}}\]5.1.3 1D, 2D, 3D 합성곱
합성곱은 커널이 움직이는 방향의 수와 출력의 차원에 따라 나눌 수 있다.
| 종류 | 커널이 움직이는 방향 | 입력 → 출력 (패딩으로 크기 유지 시) | 쓰임 |
|---|---|---|---|
| 1D 합성곱 | 시간 축 1방향 | \(W\) → \(W\) | 시계열, 신호, 그래프 곡선 평활화 |
| 2D 합성곱 | 가로·세로 2방향 | \((W, H)\) → \((W, H)\) | 흑백 이미지 |
| 3D 합성곱 | 가로·세로·깊이 3방향 | \((W, H, L)\) → \((W, H, L)\), 커널 깊이 \(d < L\) | 동영상, 의료 영상(CT 등) |
| 3D 입력의 2D 합성곱 | 가로·세로 2방향 | \((W, H, L)\) → \((W, H)\), 커널 깊이 \(= L\) | 일반적인 컬러 이미지 CNN (LeNet-5, VGG) |
| 1×1 합성곱 | 가로·세로 2방향 | \((W, H, L)\) → \((W, H)\), 커널 \(1 \times 1 \times L\) | 채널 수 조절로 연산량 감소 (GoogLeNet) |
1D 합성곱의 예로, 입력 [1, 1, 1, 1, 1]에 필터 [0.25, 0.5, 0.25]를 적용하면(양 끝을 적절히 채운다고 할 때) 출력도 [1, 1, 1, 1, 1]이다. 필터 가중치의 합이 1인 가중 평균이므로 일정한 신호는 그대로 두고 들쭉날쭉한 곡선은 부드럽게 만든다.
중요한 구분은 3D 합성곱과 3D 입력을 갖는 2D 합성곱이다. 컬러 이미지 CNN에서 커널의 깊이는 입력 채널 수와 같으므로 커널이 깊이 방향으로는 움직일 수 없고, 결과적으로 커널 하나당 2D 특성 맵이 나온다. 반면 진짜 3D 합성곱은 커널 깊이가 입력보다 작아서 깊이 방향으로도 미끄러지며 3D 출력을 만든다. 1×1 합성곱은 공간 크기는 그대로 두고 채널 축만 섞는 연산으로, 필터 개수를 입력 채널보다 적게 잡으면 채널 수가 줄어 이후 연산량이 크게 감소한다. 이 아이디어는 6장의 GoogLeNet과 ResNet 병목 블록에서 다시 등장한다.
5.2 합성곱 신경망 맛보기
Fashion-MNIST 데이터셋으로 일반 심층 신경망(DNN)과 CNN을 각각 학습시켜 비교한다. Fashion-MNIST는 torchvision에 내장된 28×28 흑백 의류 이미지 7만 장(훈련 6만, 테스트 1만)으로, 레이블은 0~9의 정수이며 각각 T-Shirt, Trouser, Pullover, Dress, Coat, Sandal, Shirt, Sneaker, Bag, Ankle Boot를 뜻한다.
데이터 준비
import torch
import torch.nn as nn
import torch.nn.functional as F
import torchvision
import torchvision.transforms as transforms

device = torch.device("cuda:0" if torch.cuda.is_available() else "cpu")

# ToTensor(): PIL 이미지(0~255) -> FloatTensor(0~1), (H, W) -> (1, H, W)
train_dataset = torchvision.datasets.FashionMNIST(
    "../chap05/data", download=True,
    transform=transforms.Compose([transforms.ToTensor()]))
test_dataset = torchvision.datasets.FashionMNIST(
    "../chap05/data", download=True, train=False,
    transform=transforms.Compose([transforms.ToTensor()]))

# 100장씩 묶어서 꺼내는 데이터로더
train_loader = torch.utils.data.DataLoader(train_dataset, batch_size=100)
test_loader = torch.utils.data.DataLoader(test_dataset, batch_size=100)
torchvision.datasets의 클래스들은torch.utils.data.Dataset을 상속하며, 첫 인자는 저장 위치,download=True는 파일이 없을 때 내려받기,train=False는 테스트 분할을 뜻한다.DataLoader는 데이터셋에서batch_size만큼 묶어 꺼내 주며,shuffle=True를 주면 순서를 섞는다.
GPU가 여러 장이면 nn.DataParallel(model)로 감싸 배치를 GPU들에 나눠 보낼 수 있다. 이때 각 GPU가 받는 양이 줄어들므로 배치 크기를 GPU 수에 맞춰 키우는 것이 보통이다.
데이터를 눈으로 확인할 때는 무작위 인덱스로 샘플을 뽑아 imshow로 그린다. train_dataset[idx]는 (이미지 텐서, 레이블) 튜플이고, 이미지 텐서의 형태가 (1, 28, 28)이므로 [0][0, :, :]로 첫 채널만 꺼내 2차원 배열로 만든다.
import numpy as np
import matplotlib.pyplot as plt

labels_map = {0: 'T-Shirt', 1: 'Trouser', 2: 'Pullover', 3: 'Dress', 4: 'Coat',
              5: 'Sandal', 6: 'Shirt', 7: 'Sneaker', 8: 'Bag', 9: 'Ankle Boot'}

fig = plt.figure(figsize=(8, 8))
for i in range(1, 21):                              # 4열 x 5행 = 20장
    idx = np.random.randint(len(train_dataset))     # 0 ~ len-1 중 정수 하나
    img = train_dataset[idx][0][0, :, :]            # (1, 28, 28) -> (28, 28)
    fig.add_subplot(5, 4, i)
    plt.title(labels_map[train_dataset[idx][1]])
    plt.axis('off')
    plt.imshow(img, cmap='gray')
plt.show()
심층 신경망 모델
비교 기준으로 합성곱 없이 선형층만 쌓은 모델을 만든다.
class FashionDNN(nn.Module):
    def __init__(self):
        super(FashionDNN, self).__init__()
        self.fc1 = nn.Linear(in_features=784, out_features=256)
        self.drop = nn.Dropout(0.25)
        self.fc2 = nn.Linear(in_features=256, out_features=128)
        self.fc3 = nn.Linear(in_features=128, out_features=10)

    def forward(self, input_data):
        out = input_data.view(-1, 784)   # (N, 1, 28, 28) -> (N, 784)
        out = F.relu(self.fc1(out))
        out = self.drop(out)
        out = F.relu(self.fc2(out))
        out = self.fc3(out)              # 소프트맥스 없이 로짓을 반환
        return out
- 모델 클래스는
nn.Module을 상속하고,__init__에서 층을 만들고forward에서 순전파를 정의한다.forward는 객체를model(x)처럼 호출하면 자동으로 실행된다. 클래스는 함수와 그 함수가 쓰는 상태(변수)를 한데 묶어 두므로, 같은 설계도로 독립적인 객체를 여러 개 찍어 낼 수 있다. nn.Linear(in_features, out_features)는 \(y = xW^\top + b\)를 계산하는 선형층이다.nn.Dropout(p)는 학습 중에 각 원소를 확률 \(p\)로 0으로 만들고, 살아남은 값은 \(1/(1-p)\)배로 키워 기댓값을 유지한다. \(p=0.25\)이면 남은 값은 약 1.33배가 된다. 평가 모드(model.eval())에서는 아무 일도 하지 않는다.view(-1, 784)는 넘파이의reshape처럼 형태를 바꾼다.-1은 “나머지 원소 수에 맞춰 자동으로 정하라”는 뜻이다.- 활성화 함수는
forward안에서 함수형F.relu()로 쓸 수도,__init__에서 모듈nn.ReLU()로 만들어 둘 수도 있다.
nn.xx와 nn.functional.xx의 차이는 합성곱에서 더 분명하다.
inputs = torch.randn(64, 3, 244, 244)

# 클래스 방식: 하이퍼파라미터만 주면 가중치는 모듈이 만들고 관리한다
conv = nn.Conv2d(in_channels=3, out_channels=64, kernel_size=3, padding=1)
outputs = conv(inputs)

# 함수 방식: 가중치와 편향을 직접 만들어 넘겨야 한다
weight = torch.randn(64, 3, 3, 3)
bias = torch.randn(64)
outputs = F.conv2d(inputs, weight, bias, padding=1)
| 구분 | nn.xx (예: nn.Conv2d) |
nn.functional.xx (예: F.conv2d) |
|---|---|---|
| 형태 | nn.Module을 상속한 클래스 |
순수 함수 |
| 호출 | 객체 생성 때 하이퍼파라미터, 호출 때 데이터 전달 | 호출할 때 하이퍼파라미터와 데이터를 함께 전달 |
nn.Sequential 안에 |
넣을 수 있음 | 넣을 수 없음 |
| 파라미터 | 모듈이 내부에 보관 | 필요할 때마다 직접 정의해 전달 |
학습할 가중치가 있는 층은 nn.xx, 가중치 없는 연산(ReLU 등)은 어느 쪽이든 편한 것을 쓰면 된다.
손실 함수, 옵티마이저, 학습률을 정한다.
learning_rate = 0.001
model = FashionDNN()
model.to(device)

criterion = nn.CrossEntropyLoss()   # 다중 분류용 (내부에서 log-softmax 수행)
optimizer = torch.optim.Adam(model.parameters(), lr=learning_rate)
print(model)
FashionDNN(
  (fc1): Linear(in_features=784, out_features=256, bias=True)
  (drop): Dropout(p=0.25, inplace=False)
  (fc2): Linear(in_features=256, out_features=128, bias=True)
  (fc3): Linear(in_features=128, out_features=10, bias=True)
)
학습과 평가 루프
5 에폭 동안 학습하면서 50 반복마다 테스트 데이터 전체로 정확도를 재고, 500 반복마다 출력한다.
num_epochs = 5
count = 0
loss_list, iteration_list, accuracy_list = [], [], []

for epoch in range(num_epochs):
    for images, labels in train_loader:
        images, labels = images.to(device), labels.to(device)   # 모델과 같은 장치로
        train = images.view(100, 1, 28, 28)

        outputs = model(train)
        loss = criterion(outputs, labels)
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()
        count += 1

        if not (count % 50):                     # 50번째 반복마다 평가
            total, correct = 0, 0
            for images, labels in test_loader:
                images, labels = images.to(device), labels.to(device)
                outputs = model(images.view(100, 1, 28, 28))
                predictions = torch.max(outputs, 1)[1]   # 가장 큰 로짓의 인덱스
                correct += (predictions == labels).sum()
                total += len(labels)
            accuracy = correct * 100 / total
            loss_list.append(loss.data)
            iteration_list.append(count)
            accuracy_list.append(accuracy)

        if not (count % 500):
            print("Iteration: {}, Loss: {}, Accuracy: {}%".format(count, loss.data, accuracy))
- 모델과 데이터는 같은 장치(CPU 또는 GPU)에 있어야 한다. 섞이면 런타임 오류가 난다.
- 원래 예제는 텐서를
torch.autograd.Variable로 감싸는데, PyTorch 0.4 이후로는 텐서 자체가 자동 미분을 지원하므로 감쌀 필요가 없다. 위 코드는 그 부분을 뺐다. torch.max(outputs, 1)은 (최댓값, 인덱스)를 돌려주므로[1]로 인덱스, 즉 예측 클래스를 꺼낸다.- 평가 부분은 엄밀하게는
model.eval()과torch.no_grad()안에서 돌리는 것이 맞다(드롭아웃을 끄고 불필요한 기울기 계산을 막는다).
정확도는 전체 예측 중 맞힌 비율이다.
\[\text{accuracy} = \frac{\text{correct predictions}}{\text{total predictions}} \times 100, \qquad \text{error rate} = 100 - \text{accuracy}\]클래스가 셋 이상이면 정확도 하나만 보고 판단하기 어렵다. 정확도 80%가 모든 클래스를 고르게 맞힌 결과인지, 특정 클래스만 잘 맞힌 결과인지 알 수 없고, 데이터의 90%가 한 클래스라면 전부 그 클래스로 찍기만 해도 90%가 나온다.
Iteration: 500, Loss: 0.5627565979957581, Accuracy: 82.70999908447266%
Iteration: 1000, Loss: 0.4662465751171112, Accuracy: 84.4000015258789%
Iteration: 1500, Loss: 0.33023178577423096, Accuracy: 84.41000366210938%
Iteration: 2000, Loss: 0.3131774067878723, Accuracy: 85.05999755859375%
Iteration: 2500, Loss: 0.28404906392097473, Accuracy: 86.26000213623047%
Iteration: 3000, Loss: 0.31252551078796387, Accuracy: 86.4800033569336%
DNN은 약 86%에 도달한다.
합성곱 신경망 모델
이번에는 합성곱 블록 두 개 뒤에 완전연결층 세 개를 붙인다.
class FashionCNN(nn.Module):
    def __init__(self):
        super(FashionCNN, self).__init__()
        self.layer1 = nn.Sequential(
            nn.Conv2d(in_channels=1, out_channels=32, kernel_size=3, padding=1),
            nn.BatchNorm2d(32),
            nn.ReLU(),
            nn.MaxPool2d(kernel_size=2, stride=2)
        )
        self.layer2 = nn.Sequential(
            nn.Conv2d(in_channels=32, out_channels=64, kernel_size=3),
            nn.BatchNorm2d(64),
            nn.ReLU(),
            nn.MaxPool2d(2)
        )
        self.fc1 = nn.Linear(in_features=64*6*6, out_features=600)
        self.drop = nn.Dropout2d(0.25)
        self.fc2 = nn.Linear(in_features=600, out_features=120)
        self.fc3 = nn.Linear(in_features=120, out_features=10)   # 클래스 10개

    def forward(self, x):
        out = self.layer1(x)
        out = self.layer2(out)
        out = out.view(out.size(0), -1)   # (N, 64, 6, 6) -> (N, 2304)
        out = self.fc1(out)
        out = self.drop(out)
        out = self.fc2(out)
        out = self.fc3(out)
        return out
nn.Sequential은 여러 층을 순서대로 담는 컨테이너다. 데이터가 층을 차례로 통과하기만 하면 될 때forward를 짧고 읽기 쉽게 만든다.nn.Conv2d(in_channels, out_channels, kernel_size, stride=1, padding=0): 입력 채널 수(흑백 1, 컬러 3), 출력 채널 수(필터 개수), 커널 크기(정수면 정사각형,(3, 5)처럼 직사각형도 가능), 스트라이드, 패딩이다. 학습되는 대상은 커널의 값이다.nn.BatchNorm2d(C)는 미니배치마다 채널별 평균과 분산으로 값을 정규화해 평균 0, 분산 1 근처로 맞춘다. 층마다 입력 분포가 출렁이는 것을 줄여 학습을 안정시킨다(8장에서 자세히 다룬다).nn.MaxPool2d(kernel_size, stride)는 최대 풀링이다.stride를 생략하면kernel_size와 같은 값이 된다.
fc1의 입력 크기 64*6*6이 어디서 나왔는지는 5.1.2의 공식으로 층마다 따라가 보면 알 수 있다. 입력은 28×28이다.
| 층 | 계산 | 출력 형태 (C, H, W) |
|---|---|---|
| 입력 | (1, 28, 28) | |
Conv2d(1, 32, 3, padding=1) |
\((28 - 3 + 2 \cdot 1)/1 + 1 = 28\) | (32, 28, 28) |
MaxPool2d(2, 2) |
\((28 - 2)/2 + 1 = 14\) | (32, 14, 14) |
Conv2d(32, 64, 3) |
\((14 - 3 + 0)/1 + 1 = 12\) | (64, 12, 12) |
MaxPool2d(2) |
\((12 - 2)/2 + 1 = 6\) | (64, 6, 6) |
view(N, -1) |
\(64 \times 6 \times 6\) | (2304,) |
책 본문은 이 계산에 입력 크기로 784(=28×28, 펼친 길이)를 넣어 설명하지만, 합성곱의 공식에는 한 변의 길이 28을 넣어야 한다. 위 표의 결과 2304가 아래 print(model) 출력의 in_features=2304와 일치한다. 또 out.view(out.size(0), -1)에서 out.size(0)은 배치 크기이고, -1 자리가 2304로 자동 계산된다.
FashionCNN(
  (layer1): Sequential(
    (0): Conv2d(1, 32, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
    (1): BatchNorm2d(32, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)
    (2): ReLU()
    (3): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
  )
  (layer2): Sequential(
    (0): Conv2d(32, 64, kernel_size=(3, 3), stride=(1, 1))
    (1): BatchNorm2d(64, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)
    (2): ReLU()
    (3): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
  )
  (fc1): Linear(in_features=2304, out_features=600, bias=True)
  (drop): Dropout2d(p=0.25, inplace=False)
  (fc2): Linear(in_features=600, out_features=120, bias=True)
  (fc3): Linear(in_features=120, out_features=10, bias=True)
)
손실 함수, 옵티마이저, 학습 루프는 DNN과 똑같이 두고 모델만 FashionCNN()으로 바꿔 학습한다.
Iteration: 500, Loss: 0.43928107619285583, Accuracy: 87.87000274658203%
Iteration: 1000, Loss: 0.3258974850177765, Accuracy: 88.0999984741211%
Iteration: 1500, Loss: 0.30115756392478943, Accuracy: 88.38999938964844%
Iteration: 2000, Loss: 0.1754811853170395, Accuracy: 89.62999725341797%
Iteration: 2500, Loss: 0.13775354623794556, Accuracy: 89.56999969482422%
Iteration: 3000, Loss: 0.24831737577915192, Accuracy: 88.94999694824219%
CNN은 약 89%로 DNN보다 2~3%p 높다. 28×28 흑백처럼 작고 단순한 이미지에서는 차이가 크지 않지만, 이미지가 커지고 복잡해질수록 공간 구조를 보존하는 CNN의 이점이 커진다.
5.3 전이 학습
CNN을 처음부터 제대로 학습시키려면 많은 데이터가 필요하지만, 큰 데이터셋을 모으는 데는 비용과 시간이 든다. 전이 학습(transfer learning) 은 ImageNet처럼 매우 큰 데이터셋으로 이미 학습된 모델, 즉 사전 훈련된 모델(pre-trained model) 의 가중치를 가져와 내 문제에 맞게 조정하는 방법이다. 큰 데이터에서 배운 일반적인 시각 특성(모서리, 질감, 부분 형태 등)을 재활용하므로 적은 데이터로도 좋은 성능을 낼 수 있다. 방법은 크게 특성 추출과 미세 조정 두 가지다.
5.3.1 특성 추출 기법
특성 추출(feature extractor) 은 사전 훈련된 모델의 합성곱 부분은 가중치를 고정한 채 그대로 쓰고, 마지막 분류를 맡는 완전연결층만 새로 만들어 학습시키는 방법이다. 이미지 분류 모델은 두 부분으로 볼 수 있다.
- 합성곱 기반(convolutional base): 합성곱층과 풀링층. 이미지에서 특성을 뽑는다. 이 부분은 고정한다.
- 데이터 분류기(classifier): 추출된 특성을 받아 클래스를 결정하는 완전연결층. 이 부분만 새로 학습한다.
이런 용도로 많이 쓰는 모델로는 Xception, Inception V3, ResNet50, VGG16, VGG19, MobileNet 등이 있다. 예제는 개·고양이 사진(Kaggle Dogs vs. Cats 중 일부)을 ResNet18로 분류한다.
데이터 준비와 데이터 확장
import torchvision.models as models

data_path = '../chap05/data/catanddog/train'
transform = transforms.Compose([
    transforms.Resize([256, 256]),          # 입력 크기 통일
    transforms.RandomResizedCrop(224),      # 무작위 영역을 잘라 224x224로 (데이터 확장)
    transforms.RandomHorizontalFlip(),      # 50% 확률로 좌우 반전 (데이터 확장)
    transforms.ToTensor()
])
# 하위 폴더 이름(Cat, Dog)을 클래스로 쓰는 데이터셋
train_dataset = torchvision.datasets.ImageFolder(data_path, transform=transform)
train_loader = torch.utils.data.DataLoader(
    train_dataset, batch_size=32, num_workers=8, shuffle=True)
print(len(train_dataset))
385
Resize는 합성곱층에 넣기 위해 크기를 맞추는 전처리이고,RandomResizedCrop과RandomHorizontalFlip은 매 에폭 조금씩 다른 이미지를 만들어 내는 데이터 확장(data augmentation) 이다. 둘 다 이미지를 자르거나 크기를 바꾸지만 목적이 다르다.ImageFolder는train/Cat/...,train/Dog/...같은 폴더 구조에서 폴더 이름을 레이블로 삼는다.num_workers는 데이터를 읽는 하위 프로세스 수다. 너무 크게 잡으면 메모리 부족이나 오류가 날 수 있다.
RandomResizedCrop(size, scale, ratio)의 동작을 정리하면, 원본에서 면적 비율이 scale 범위(예: 0.1~1)이고 가로세로 비가 ratio 범위(예: 0.5~2)인 영역을 무작위로 골라 잘라 낸 뒤 size로 늘리거나 줄인다. 책은 이를 mxnet으로 시연하지만 torchvision의 transforms.RandomResizedCrop도 같은 인자를 받는다. 같은 고양이 사진에서도 확대된 얼굴, 몸 일부, 전체 모습 등 다양한 학습 샘플이 만들어진다.
배치 하나를 그려 볼 때는 텐서가 (C, H, W) 순서라는 점에 주의한다. matplotlib은 (H, W, C)를 기대하므로 축 순서를 바꿔야 한다.
samples, labels = next(iter(train_loader))   # 배치 하나 꺼내기
print(samples.shape)                          # torch.Size([32, 3, 224, 224])
img = np.transpose(samples[0].numpy(), (1, 2, 0))   # (3, 224, 224) -> (224, 224, 3)
plt.imshow(img)
책의 iter(train_loader).next() 표기는 최신 PyTorch에서 동작하지 않으므로 파이썬 내장 next()를 쓴다. np.transpose(a, (1, 2, 0))은 “새 0번 축에 옛 1번 축, 새 1번 축에 옛 2번 축, 새 2번 축에 옛 0번 축”을 놓으라는 뜻이다. 순서를 바꾸지 않으면 Invalid shape (3, 224, 224) for image data 오류가 난다.
사전 훈련된 ResNet18 불러오기와 가중치 고정
resnet18 = models.resnet18(pretrained=True)   # ImageNet으로 학습된 가중치 포함

def set_parameter_requires_grad(model, feature_extracting=True):
    if feature_extracting:
        for param in model.parameters():
            param.requires_grad = False       # 역전파에서 기울기를 계산하지 않음 = 고정

set_parameter_requires_grad(resnet18)
resnet18.fc = nn.Linear(512, 2)               # 새 분류기: 512차원 특성 -> 2클래스
- ResNet18은 18개 층(합성곱 17 + 완전연결 1)으로 된 ResNet이다(구조는 6장에서 다룬다). torchvision은 ResNet, AlexNet, VGG, SqueezeNet, DenseNet, Inception v3, GoogLeNet, ShuffleNet, MobileNet, ResNeXt, Wide ResNet, MNASNet 등을 제공하며,
pretrained=True를 주면 사전 학습된 가중치를, 주지 않으면 무작위 가중치를 쓴다. 최신 torchvision에서는weights=models.ResNet18_Weights.DEFAULT형식이 권장된다. requires_grad = False로 둔 파라미터는 기울기가 계산되지 않으므로 옵티마이저가 갱신하지 않는다.- 그 뒤에
resnet18.fc를 새nn.Linear로 바꾸면, 새로 만든 층의 파라미터는 기본값requires_grad=True이므로 이 층만 학습 대상이 된다.
학습 대상 파라미터를 확인하면 새 분류기의 가중치와 편향만 남아 있다.
params_to_update = []
for name, param in resnet18.named_parameters():
    if param.requires_grad:
        params_to_update.append(param)
        print("\t", name)
optimizer = optim.Adam(params_to_update)      # 학습할 파라미터만 옵티마이저에 넘김
	 fc.weight
	 fc.bias
print(model)로 본 ResNet18의 뼈대는 다음과 같다(블록 내부는 생략).
ResNet(
  (conv1): Conv2d(3, 64, kernel_size=(7, 7), stride=(2, 2), padding=(3, 3), bias=False)
  (bn1): BatchNorm2d(64, ...)
  (relu): ReLU(inplace=True)
  (maxpool): MaxPool2d(kernel_size=3, stride=2, padding=1, ...)
  (layer1): Sequential( BasicBlock x 2, 64 channels )
  (layer2): Sequential( BasicBlock x 2, 128 channels, downsample )
  (layer3): Sequential( BasicBlock x 2, 256 channels, downsample )
  (layer4): Sequential( BasicBlock x 2, 512 channels, downsample )
  (avgpool): AdaptiveAvgPool2d(output_size=(1, 1))
  (fc): Linear(in_features=512, out_features=2, bias=True)
)
학습 함수
에폭마다 평균 손실과 정확도를 계산하고, 다음 단계에서 비교할 수 있도록 에폭별 가중치를 파일로 저장한다.
import time, os

def train_model(model, dataloaders, criterion, optimizer, device, num_epochs=13):
    since = time.time()
    acc_history, loss_history = [], []
    best_acc = 0.0

    for epoch in range(num_epochs):
        print('Epoch {}/{}'.format(epoch, num_epochs - 1))
        running_loss, running_corrects = 0.0, 0

        for inputs, labels in dataloaders:
            inputs, labels = inputs.to(device), labels.to(device)
            model.to(device)
            optimizer.zero_grad()
            outputs = model(inputs)
            loss = criterion(outputs, labels)
            _, preds = torch.max(outputs, 1)
            loss.backward()
            optimizer.step()
            # loss는 배치 평균이므로 배치 크기를 곱해 합계로 누적
            running_loss += loss.item() * inputs.size(0)
            running_corrects += torch.sum(preds == labels.data)

        epoch_loss = running_loss / len(dataloaders.dataset)
        epoch_acc = running_corrects.double() / len(dataloaders.dataset)
        print('Loss: {:.4f} Acc: {:.4f}'.format(epoch_loss, epoch_acc))

        if epoch_acc > best_acc:
            best_acc = epoch_acc
        acc_history.append(epoch_acc.item())
        loss_history.append(epoch_loss)
        # 에폭마다 00.pth, 01.pth ... 로 저장
        torch.save(model.state_dict(),
                   os.path.join('../chap05/data/catanddog/', '{0:0=2d}.pth'.format(epoch)))

    time_elapsed = time.time() - since
    print('Training complete in {:.0f}m {:.0f}s'.format(time_elapsed // 60, time_elapsed % 60))
    print('Best Acc: {:4f}'.format(best_acc))
    return acc_history, loss_history

criterion = nn.CrossEntropyLoss()
train_acc_hist, train_loss_hist = train_model(resnet18, train_loader, criterion, optimizer, device)
Epoch 0/12
Loss: 0.5614 Acc: 0.7221
Epoch 1/12
Loss: 0.4387 Acc: 0.7948
...
Epoch 11/12
Loss: 0.1858 Acc: 0.9377
Epoch 12/12
Loss: 0.1985 Acc: 0.9169
Training complete in 6m 27s
Best Acc: 0.937662
385장뿐인 훈련 데이터로도 마지막 층만 학습해 훈련 정확도 약 93%에 도달한다.
테스트 데이터로 평가
테스트 데이터에는 데이터 확장을 쓰지 않고 Resize(224) 뒤 가운데를 잘라 내는 CenterCrop(224)만 적용한다(98장). 평가 함수는 저장된 에폭별 가중치를 하나씩 불러와 각각의 정확도를 잰다.
import glob

def eval_model(model, dataloaders, device):
    since = time.time()
    acc_history = []
    best_acc = 0.0
    saved_models = sorted(glob.glob('../chap05/data/catanddog/' + '*.pth'))

    for model_path in saved_models:
        print('Loading model', model_path)
        model.load_state_dict(torch.load(model_path))
        model.eval()                       # 평가 모드
        model.to(device)
        running_corrects = 0

        for inputs, labels in dataloaders:
            inputs, labels = inputs.to(device), labels.to(device)
            with torch.no_grad():          # 기울기 계산 끄기
                outputs = model(inputs)
            _, preds = torch.max(outputs.data, 1)   # 예측 클래스 인덱스
            running_corrects += preds.eq(labels).int().sum()

        epoch_acc = running_corrects.double() / len(dataloaders.dataset)
        print('Acc: {:.4f}'.format(epoch_acc))
        if epoch_acc > best_acc:
            best_acc = epoch_acc
        acc_history.append(epoch_acc.item())

    time_elapsed = time.time() - since
    print('Validation complete in {:.0f}m {:.0f}s'.format(time_elapsed // 60, time_elapsed % 60))
    print('Best Acc: {:4f}'.format(best_acc))
    return acc_history

val_acc_hist = eval_model(resnet18, test_loader, device)
glob.glob(pattern)은 패턴에 맞는 파일 경로 목록을 돌려준다.torch.max(t, 1)의 두 번째 반환값은 최댓값의 인덱스다. 예를 들어[[0.2, 0.7, 0.8, 0.4]]이면 2를 돌려준다.preds.eq(labels)는 원소별 일치 여부를,.sum()은 맞힌 개수를 준다.- 원래 예제에는
preds[preds >= 0.5] = 1같은 줄이 더 있다. 그러나preds는 이미 0 또는 1인 클래스 인덱스이므로 이 줄은 결과를 바꾸지 않아 위 코드에서는 뺐다.
Loading model ../chap05/data/catanddog\00.pth
Acc: 0.7347
Loading model ../chap05/data/catanddog\01.pth
Acc: 0.8878
...
Loading model ../chap05/data/catanddog\09.pth
Acc: 0.9490
...
Loading model ../chap05/data/catanddog\12.pth
Acc: 0.9286
Validation complete in 1m 52s
Best Acc: 0.948980
테스트 정확도도 최고 약 95%다. 같은 성능을 처음부터 설계하고 학습한 모델로 얻으려면 훨씬 많은 데이터와 시간이 필요하므로, 실무에서는 이렇게 사전 훈련된 모델을 출발점으로 삼는 경우가 많다. plt.plot(train_acc_hist), plt.plot(val_acc_hist), plt.plot(train_loss_hist)로 그려 보면 에폭이 지날수록 정확도는 오르고 손실은 내려가는 추세가 보인다.
예측 결과 그려 보기
예측을 눈으로 확인하려면 텐서를 이미지로 되돌리는 함수가 필요하다.
def im_convert(tensor):
    image = tensor.clone().detach().numpy()   # 복사본, 계산 그래프와 분리
    image = image.transpose(1, 2, 0)          # (C, H, W) -> (H, W, C)
    image = image * np.array((0.5, 0.5, 0.5)) + np.array((0.5, 0.5, 0.5))
    image = image.clip(0, 1)                  # 0~1 범위를 벗어난 값 자르기
    return image
| 연산 | 메모리 | 계산 그래프 |
|---|---|---|
tensor.clone() |
새로 할당 | 그래프에 연결된 채 남음 |
tensor.detach() |
원본과 공유 | 그래프에서 분리 |
tensor.clone().detach() |
새로 할당 | 그래프에서 분리 |
계산 그래프(computational graph) 는 연산을 노드, 데이터 흐름을 에지로 나타낸 그래프다. 한 부분의 입력이 바뀌면 그 부분만 다시 계산하면 되고(국소적 계산), 역전파 때는 연쇄 법칙(chain rule) 으로 각 노드의 미분을 곱해 나가며 기울기를 쉽게 구할 수 있다. 예를 들어 \(z = (x + y)^2\)를 \(z = t^2\), \(t = x + y\)로 나누면 다음과 같다.
\[\frac{\partial z}{\partial x} = \frac{\partial z}{\partial t} \cdot \frac{\partial t}{\partial x} = 2t \cdot 1 = 2(x + y)\]np.clip(a, lo, hi)는 범위를 벗어난 값을 경계값으로 바꾼다. 예를 들어 [-1.8, -0.7, 0.0, 0.8, 1.9]를 (-0.5, 0.5)로 자르면 [-0.5, -0.5, 0.0, 0.5, 0.5]가 된다.
classes = {0: 'cat', 1: 'dog'}
images, labels = next(iter(test_loader))
output = model(images)
_, preds = torch.max(output, 1)

fig = plt.figure(figsize=(25, 4))
for idx in np.arange(20):
    ax = fig.add_subplot(2, 10, idx + 1, xticks=[], yticks=[])   # 2행 10열, 눈금 제거
    plt.imshow(im_convert(images[idx]))
    ax.set_title("{}({})".format(classes[preds[idx].item()], classes[labels[idx].item()]),
                 color=("green" if preds[idx] == labels[idx] else "red"))   # 맞으면 초록, 틀리면 빨강
plt.show()
책의 결과 그림에는 빨간 제목(오답)이 여럿 보인다. 훈련 데이터와 에폭을 늘리면 개선될 여지가 있다.
5.3.2 미세 조정 기법
미세 조정(fine-tuning) 은 분류기뿐 아니라 사전 훈련된 합성곱층의 가중치 일부 또는 전부도 함께 다시 학습시키는 방법이다. 특성 추출은 사전 훈련된 모델이 내 데이터에 필요한 특성을 이미 잘 뽑는다는 전제에서 잘 동작한다. ImageNet 사진과 전자상거래 상품 사진처럼 데이터의 성격이 다르면, 합성곱층도 새 데이터에 맞게 조정해야 특성이 제대로 추출된다. 계산량이 많으므로 GPU를 쓰는 것이 좋다.
데이터셋 크기와, 사전 훈련에 쓰인 데이터와의 유사성에 따라 전략이 달라진다.
| 내 데이터셋 | 사전 훈련 데이터와 유사성 | 전략 | 이유 |
|---|---|---|---|
| 크다 | 작다 | 모델 전체를 재학습 | 데이터가 충분하므로 처음부터 다시 맞춰도 과적합 위험이 낮다 |
| 크다 | 크다 | 합성곱층 뒷부분 + 분류기 학습 | 앞쪽의 일반적 특성은 그대로 쓰고, 과제 특유의 특성이 담긴 뒷부분만 조정 |
| 작다 | 작다 | 합성곱층 일부 + 분류기 학습 | 다시 맞춰야 할 부분은 있지만 데이터가 적으므로 학습할 범위를 신중히 정한다 |
| 작다 | 크다 | 분류기만 학습 | 많은 층을 학습시키면 적은 데이터에 과적합되기 쉽다 |
미세 조정에서는 이미 좋은 상태인 가중치를 크게 흔들면 과적합이나 성능 저하가 생기기 쉬우므로, 작은 학습률로 조금씩 갱신하는 것이 보통이다.
5.4 설명 가능한 CNN
CNN은 내부에서 무슨 일이 일어나는지 알기 어려운 블랙박스처럼 보인다. 결과를 믿고 쓰려면 각 층이 입력에서 어떤 특성을 뽑아내는지 사람이 볼 수 있는 형태로 보여 줄 필요가 있는데, 이를 설명 가능한 CNN(explainable CNN) 이라 한다. 시각화 대상은 필터와 특성 맵 두 가지가 있으며, 여기서는 특성 맵만 다룬다.
5.4.1 특성 맵 시각화
특성 맵(feature map), 또는 활성화 맵(activation map) 은 입력(이미지 또는 이전 층의 특성 맵)에 필터를 적용한 결과다. 특정 입력에 대한 특성 맵을 그려 보면 그 층이 입력의 어떤 부분에 반응하는지 이해할 수 있다.
예제는 VGG16과 비슷한 형태로, 3×3 합성곱 13개(배치 정규화, ReLU, 드롭아웃 포함)와 최대 풀링 5개, 완전연결층 두 개로 된 XAI 모델을 정의한다. 앞부분만 보면 다음과 같다.
class XAI(torch.nn.Module):
    def __init__(self, num_classes=2):
        super(XAI, self).__init__()
        self.features = nn.Sequential(
            nn.Conv2d(3, 64, kernel_size=3, bias=False),       # features[0]
            nn.BatchNorm2d(64),
            nn.ReLU(inplace=True),    # inplace=True: 새 텐서를 만들지 않고 입력을 덮어씀
            nn.Dropout(0.3),
            nn.Conv2d(64, 64, kernel_size=3, padding=1, bias=False),
            nn.BatchNorm2d(64),
            nn.ReLU(inplace=True),
            nn.MaxPool2d(kernel_size=2, stride=2),
            # ... 128 -> 256 -> 512 -> 512 채널로 같은 패턴 반복 (총 합성곱 13개) ...
        )
        self.classifier = nn.Sequential(
            nn.Linear(512, 512, bias=False),
            nn.Dropout(0.5),
            nn.BatchNorm1d(512),
            nn.ReLU(inplace=True),
            nn.Dropout(0.5),
            nn.Linear(512, num_classes)
        )

    def forward(self, x):
        x = self.features(x)
        x = x.view(-1, 512)
        x = self.classifier(x)
        return F.log_softmax(x, dim=1)
마지막에 쓰인 로그 소프트맥스(log softmax) 는 소프트맥스 결과에 로그를 취한 값이다.
\[\text{log\_softmax}(z)_i = \log \frac{e^{z_i}}{\sum_{j} e^{z_j}} = z_i - \log \sum_{j} e^{z_j}\]소프트맥스 확률은 매우 작아질 수 있어서 그대로 로그를 취하면 수치적으로 불안정하고 기울기도 작아지기 쉽다. 오른쪽처럼 정리한 형태로 직접 계산하면 안정적이며, nn.NLLLoss와 짝을 이루면 교차 엔트로피 손실이 된다.
모델을 만들고 평가 모드로 둔다. 이 예제는 학습 없이 무작위 초기 가중치 상태의 특성 맵을 본다.
model = XAI()
model.to(device)
model.eval()
훅으로 중간 출력 가로채기
특정 층의 출력을 꺼내기 위해 PyTorch의 훅(hook) 을 쓴다. register_forward_hook(fn)을 모듈에 등록하면 순전파 때 그 모듈의 입력과 출력이 fn으로 전달된다.
class LayerActivations:
    features = []
    def __init__(self, model, layer_num):
        # model[layer_num] 모듈의 순전파 출력을 hook_fn이 받도록 등록
        self.hook = model[layer_num].register_forward_hook(self.hook_fn)

    def hook_fn(self, module, input, output):
        self.features = output.detach().numpy()   # 특성 맵 저장

    def remove(self):
        self.hook.remove()                        # 훅 해제
훅은 중간 결과를 들여다볼 때 유용하다. 예를 들어 z = x + y, o = w @ z를 계산하고 o.backward()를 하면 잎 텐서인 x, y, w의 .grad는 채워지지만 중간 텐서 z의 .grad는 None이다. PyTorch는 메모리를 아끼려고 중간 변수의 기울기를 보관하지 않기 때문이다. 이때 z.register_hook(fn)을 걸어 두면 역전파 중에 z의 기울기를 받아 볼 수 있다.
입력 이미지 준비
import cv2
from torchvision.transforms import ToTensor

img = cv2.imread("../chap05/data/cat.jpg")
img = cv2.resize(img, (100, 100), interpolation=cv2.INTER_LINEAR)   # (너비, 높이), 선형 보간
img = ToTensor()(img).unsqueeze(0)    # (3, 100, 100) -> (1, 3, 100, 100)
print(img.shape)
cv2.resize는 크기를 바꿀 때 새 격자의 픽셀 값을 주변 픽셀로부터 추정해야 하는데, 그 방법이 보간법(interpolation) 이다.INTER_LINEAR는 가까운 픽셀들의 선형 결합으로 값을 정한다.unsqueeze(dim)은 지정 위치에 크기 1인 차원을 끼워 넣는다. 모델은 배치 차원을 기대하므로 이미지 한 장에도 맨 앞에 배치 축을 추가한다. 예를 들어 (3, 10, 64)에unsqueeze(0)을 하면 (1, 3, 10, 64),unsqueeze(1)을 하면 (3, 1, 10, 64)가 된다.
층별 특성 맵 비교
result = LayerActivations(model.features, 0)   # features[0]: 첫 번째 Conv2d
model(img)
activations = result.features                  # (1, 64, 98, 98)

fig, axes = plt.subplots(4, 4)
for row in range(4):
    for column in range(4):
        axis = axes[row][column]
        axis.get_xaxis().set_ticks([])
        axis.get_yaxis().set_ticks([])
        axis.imshow(activations[0][row*10 + column])   # 채널 일부를 골라 표시
plt.show()
같은 코드에서 층 번호만 20, 40으로 바꿔 깊은 층의 특성 맵을 그린다(features[20], features[40]은 각각 중간과 끝 부근의 Conv2d다).
- 첫 번째 합성곱층: 입력에 가까워서 고양이의 윤곽과 형태가 특성 맵에 그대로 드러난다. 채널마다 밝게 반응하는 부분(모서리, 밝은 영역 등)이 조금씩 다르다.
- 20번째 층: 풀링을 몇 번 거쳐 해상도가 낮아지고, 원래 고양이 모양은 거의 알아볼 수 없다.
- 40번째 층: 형태는 완전히 사라지고 추상적인 패턴만 남는다.
출력층에 가까워질수록 원본의 모양 대신 분류에 쓰이는 추상적인 특성만 전달된다는 것을 확인할 수 있다. 이처럼 필터와 특성 맵을 시각화하면 CNN 결과를 해석하고 신뢰성을 점검하는 데 도움이 된다.
5.5 그래프 합성곱 네트워크
그래프 합성곱 네트워크(Graph Convolutional Network, GCN) 는 격자 형태의 이미지가 아니라 그래프 형태의 데이터에 합성곱 아이디어를 적용한 신경망이다.
5.5.1 그래프란
그래프(graph) 는 노드(node, vertex) 와 노드 쌍을 잇는 에지(edge) 의 집합이다. 에지는 방향이 있을 수도(directed) 없을 수도(undirected) 있다. 무엇을 노드로, 무엇을 에지로 삼을지는 문제에 대한 도메인 지식으로 정한다. 예를 들어 분자를 그래프로 표현하면 원자가 노드, 원자 사이의 결합(단일, 이중, 삼중, 방향족 결합 등)이 에지가 된다.
5.5.2 그래프 신경망
그래프 신경망(Graph Neural Network, GNN) 은 그래프 구조의 데이터를 다루는 신경망이다. 그래프를 신경망에 넣으려면 먼저 행렬로 표현해야 하며, 두 단계를 거친다.
- 인접 행렬(adjacency matrix): 노드가 \(n\)개면 \(n \times n\) 행렬 \(A\)를 만들고, 노드 \(i\)와 \(j\)가 연결되어 있으면 \(A_{ij} = 1\), 아니면 0으로 채운다. 컴퓨터가 연결 구조를 다룰 수 있게 하는 표현이다.
- 특성 행렬(feature matrix): 각 노드가 가진 속성 값을 행렬 \(X\)로 모은다. \(i\)번째 행이 \(i\)번째 노드의 특성 벡터다. 인접 행렬만으로는 노드 자신의 정보가 반영되지 않으므로, 단위 행렬을 더한 \(A + I\)처럼 자기 자신과의 연결(self-loop)을 포함시켜 계산하기도 한다.
이렇게 하면 노드들의 연결 관계와 각 노드의 특성을 한꺼번에 행렬 연산으로 처리할 수 있다.
5.5.3 그래프 합성곱 네트워크
GCN은 이미지 합성곱이 “주변 픽셀 값을 가중합”하듯이, 그래프에서 이웃 노드들의 특성을 모아 가중합하여 각 노드의 새 특성을 만든다. 핵심인 그래프 합성곱층(graph convolutional layer) 의 동작을 대표적인 형태로 쓰면 다음과 같다.
\[H^{(l+1)} = \sigma\left( \hat{A} H^{(l)} W^{(l)} \right), \qquad \hat{A} = \text{normalize}(A + I), \quad H^{(0)} = X\]\(\hat{A}\)를 곱하면 각 노드가 자신과 이웃의 특성을 섞고, \(W^{(l)}\)은 모든 노드가 공유하는 학습 가중치(이미지 합성곱의 커널에 해당), \(\sigma\)는 활성화 함수다. 그래프 합성곱층을 여러 번 쌓으면 더 멀리 떨어진 노드의 정보까지 반영된다.
그래프 전체에 대한 예측(예: 분자의 성질 분류)을 하려면 노드별 특성 행렬을 하나의 벡터로 요약해야 한다. 이 함수를 리드아웃(readout) 이라 하며, 모든 노드 특성 벡터의 평균을 내는 방식이 대표적이다. 리드아웃 뒤에는 일반적인 완전연결층으로 분류나 회귀를 한다.
그래프 합성곱층 덕분에 원래 신경망에 바로 넣기 어려운 그래프 데이터를 행렬 연산으로 다룰 수 있게 되었다. GCN은 SNS의 관계 네트워크, 논문 인용 네트워크, 3D 메시(mesh) 등에 활용된다.
정리
- 합성곱층은 커널을 스트라이드 간격으로 움직이며 국소 영역의 가중합을 계산해 공간 구조를 보존한 특성 맵을 만든다. 출력 크기는 \((W - F + 2P)/S + 1\), 출력 채널 수는 필터 개수다.
- 풀링층은 학습 파라미터 없이 특성 맵을 줄이며, 강한 반응을 살리는 최대 풀링이 주로 쓰인다. 1×1 합성곱은 채널 수를 조절해 연산량을 줄인다.
- Fashion-MNIST에서 CNN(약 89%)은 같은 학습 조건의 DNN(약 86%)보다 높은 정확도를 보였고,
fc1의 입력 크기 2304는 층별 출력 크기를 따라가 계산할 수 있다. - 전이 학습의 특성 추출은 사전 훈련된 모델의 가중치를
requires_grad=False로 고정하고 새 분류기만 학습한다. ResNet18로 개·고양이 385장만 학습해도 테스트 정확도 약 95%를 얻었다. - 미세 조정은 합성곱층까지 다시 학습하며, 데이터 크기와 사전 훈련 데이터와의 유사성에 따라 학습할 범위를 정한다.
register_forward_hook으로 중간 층의 출력을 가로채 특성 맵을 그리면, 깊은 층일수록 원본 형태 대신 추상적인 특성이 남는 것을 볼 수 있다.- GCN은 인접 행렬과 특성 행렬로 그래프를 표현하고, 이웃 노드 특성의 가중합으로 합성곱을 그래프에 확장하며, 리드아웃으로 그래프 전체를 하나의 벡터로 요약한다.