7장은 순서가 있는 데이터를 다룬다. 앞부분은 전통적인 통계 모형(AR, MA, ARMA, ARIMA)을, 뒷부분은 순환 신경망 계열(RNN, LSTM, GRU, 양방향 RNN)을 다룬다. 신경망 예제는 같은 모델을 셀(cell) 단위로 직접 반복문을 돌려 만드는 방법과 PyTorch의 계층(layer) 을 그대로 쓰는 방법으로 나누어 구현하는 것이 특징이다.
예제 코드는 2022년 당시 버전(torchtext.legacy, statsmodels.tsa.arima_model, torch.autograd.Variable)을 기준으로 한다. 최신 버전에서는 일부 API가 사라졌으므로, 해당하는 곳에 따로 적어 둔다.
7.1 시계열 문제
시계열 분석(time series analysis) 은 시간 순서로 관측된 값을 보고 흐름을 파악하거나 앞으로의 값을 예측하는 작업이다. 주가, 환율, 기온, 판매량처럼 “언제 관측했는가”가 의미를 갖는 데이터가 대상이다.
시계열 값의 움직임은 보통 네 가지 성분으로 나누어 생각한다.
| 성분 | 의미 | 예 |
|---|---|---|
| 불규칙 변동(irregular variation) | 규칙 없이 우연히 생기는 변동. 예측할 수 없다. | 전쟁, 지진, 파업 |
| 추세 변동(trend variation) | 긴 기간에 걸쳐 꾸준히 오르거나 내리는 경향. 짧은 구간만 보면 잘 드러나지 않는다. | GDP, 인구 증가율 |
| 순환 변동(cyclical variation) | 몇 년 정도의 주기로 오르내림을 반복하는 변동 | 경기 순환 |
| 계절 변동(seasonal variation) | 계절이나 관습 때문에 1년 단위로 반복되는 변동 | 계절별 판매량 |
평균(추세)과 분산이 시간에 따라 변하지 않는 시계열을 규칙적(정상적, stationary) 시계열, 그렇지 않은 것을 불규칙적 시계열이라고 부를 수 있다. 시계열 분석의 목표는 불규칙해 보이는 데이터에서 규칙을 찾아 모형으로 표현하는 것이다. 전통적으로는 AR, MA, ARMA, ARIMA 같은 통계 모형을 썼고, 최근에는 데이터의 연속성을 신경망이 직접 학습하게 하는 RNN 계열이 더 많이 쓰인다.
7.2 AR, MA, ARMA, ARIMA
일반적인 회귀는 여러 독립 변수로 종속 변수를 예측한다. 시계열 모형은 같은 변수의 과거 값(또는 과거 오차) 을 입력으로 삼는다는 점이 다르다. 아래에서 \(Z_t\)는 시점 \(t\)의 관측값, \(a_t\)는 평균 0인 무작위 오차인 백색 잡음(white noise) 이다.
7.2.1 AR 모델
AR(AutoRegressive, 자기 회귀) 모델은 “현재 값은 직전 몇 개 값의 선형 결합으로 설명된다”고 가정한다. 직전 \(p\)개 시점을 쓰면 AR(\(p\))이다.
\[Z_t = \Phi_1 Z_{t-1} + \Phi_2 Z_{t-2} + \cdots + \Phi_p Z_{t-p} + a_t\]\(\Phi_i\)는 \(i\) 시점 전 값이 현재에 주는 영향의 크기다.
7.2.2 MA 모델
MA(Moving Average, 이동 평균) 모델은 과거 값 대신 과거 오차 로 현재를 설명한다. 크기 \(q\)의 윈도우가 시계열을 따라 미끄러지며(moving) 직전 \(q\)개 오차를 반영하므로 MA(\(q\))라고 부른다.
\[Z_t = \theta_1 a_{t-1} + \theta_2 a_{t-2} + \cdots + \theta_q a_{t-q} + a_t\]AR이 “이전 상태가 어땠는가”를 보는 반면, MA는 “이전 예측이 얼마나 빗나갔는가”를 보고 현재를 보정한다.
7.2.3 ARMA 모델
ARMA(AutoRegressive Moving Average) 는 두 관점을 합친 모형이다. 과거 값과 과거 오차를 모두 쓴다.
\[Z_t = \sum_{i=1}^{p} \Phi_i Z_{t-i} + \sum_{j=1}^{q} \theta_j a_{t-j} + a_t\]7.2.4 ARIMA 모델
ARIMA(AutoRegressive Integrated Moving Average) 는 ARMA 앞에 차분(differencing) 단계를 추가한다. ARMA는 정상 시계열을 가정하므로, 추세가 있는 데이터는 이웃한 값의 차이 \(Z_t - Z_{t-1}\)을 취해 추세를 없앤 뒤 ARMA를 적용한다. 차분을 \(d\)번 하면 ARIMA(\(p, d, q\))다.
- \(p\): 자기 회귀 차수
- \(d\): 차분 차수
- \(q\): 이동 평균 차수
statsmodels로 자전거 월별 판매량(sales.csv, 36개월)에 ARIMA(5, 1, 0)을 적용한다. 직전 5개 시점을 보고, 1번 차분하고, MA 항은 쓰지 않는다는 뜻이다.
from pandas import read_csv, DataFrame
from statsmodels.tsa.arima_model import ARIMA   # 책 기준 (구버전 API)
import datetime

def parser(x):                       # '1-01' 같은 문자열을 1991-01 날짜로
    return datetime.datetime.strptime('199' + x, '%Y-%m')

series = read_csv('../chap07/data/sales.csv', header=0, parse_dates=[0],
                  index_col=0, squeeze=True, date_parser=parser)

model = ARIMA(series, order=(5, 1, 0))   # (p, d, q)
model_fit = model.fit(disp=0)            # disp=0: 최적화 로그 끄기
print(model_fit.summary())

residuals = DataFrame(model_fit.resid)   # 잔차(실제 - 적합값)
residuals.plot(kind='kde')               # 잔차 분포
print(residuals.describe())
Dep. Variable:                D.Sales     No. Observations:                 35
Model:                  ARIMA(5, 1, 0)    Log Likelihood              -197.350
...
                    coef    std err          z      P>|z|
const            12.4256      3.774      3.292      0.001
ar.L1.D.Sales    -1.0850      0.188     -5.764      0.000
ar.L2.D.Sales    -0.6688      0.283     -2.365      0.018
...
count    35.000000
mean     -5.569266
std      70.272666
D.Sales는 차분한 판매량을 모델링했다는 뜻이고, 관측치가 36개에서 35개로 줄어든 것도 차분 때문이다. 잔차의 평균이 0이 아니라 약 -5.6이므로 예측에 약간의 치우침(bias)이 남아 있다.
다음은 실제 예측이다. 앞 66%로 시작해, 한 달을 예측할 때마다 그 달의 실제 값을 이력(history)에 추가하고 모델을 다시 맞추는 롤링 예측(rolling forecast) 방식이다.
import numpy as np
from sklearn.metrics import mean_squared_error

X = np.nan_to_num(series.values)
size = int(len(X) * 0.66)
train, test = X[:size], X[size:]
history = list(train)
predictions = []

for t in range(len(test)):              # 테스트 13개월을 하나씩 예측
    model_fit = ARIMA(history, order=(5, 1, 0)).fit(disp=0)
    yhat = model_fit.forecast()[0]      # 다음 한 시점 예측
    predictions.append(yhat)
    history.append(test[t])             # 실제 값을 이력에 추가
    print('predicted=%f, expected=%f' % (yhat, test[t]))

print('Test MSE: %.3f' % mean_squared_error(test, predictions))
predicted=354.377730, expected=346.300000
predicted=288.627290, expected=329.700000
...
predicted=522.091111, expected=676.900000
Test MSE: 8074.991
예측값이 실제 값의 우상향 추세를 대체로 따라간다. 판매량이 계속 늘어날 것이라는 경향은 잡아내지만 개별 달의 큰 변동까지 맞추지는 못한다.
최신 statsmodels에서는 statsmodels.tsa.arima_model.ARIMA가 제거되었다. from statsmodels.tsa.arima.model import ARIMA를 쓰고, fit()에서 disp 인자를 빼면 같은 흐름으로 동작한다. pandas.datetime도 사라졌으므로 위 코드처럼 표준 datetime 모듈을 쓴다.
7.3 순환 신경망(RNN)
RNN(Recurrent Neural Network) 은 순서가 있는 데이터를 위해 만든 신경망이다. 핵심은 은닉 상태(hidden state) 라는 기억이다. 첫 입력 \(x_1\)이 들어오면 기억 \(h_1\)을 만들고, 다음 입력 \(x_2\)가 들어오면 \(h_1\)과 \(x_2\)를 함께 보고 \(h_2\)로 갱신한다. 이 과정을 시퀀스 길이만큼 반복하므로 마지막 은닉 상태는 지금까지 본 입력 전체의 요약이 된다. 이전 은닉 상태가 다음 계산의 입력으로 되돌아온다는(recurrent) 점에서 이름이 붙었다.
입력과 출력의 개수에 따라 다음 유형으로 나눈다.
| 유형 | 구조 | 예 |
|---|---|---|
| 일대일(one-to-one) | 입력 하나, 출력 하나. 순환이 없으므로 사실상 일반 순방향 신경망이다. | 이미지 분류 |
| 일대다(one-to-many) | 입력 하나로 시퀀스를 출력 | 이미지 캡셔닝(image captioning) |
| 다대일(many-to-one) | 시퀀스를 읽고 하나를 출력 | 감성 분석(긍정/부정) |
| 다대다(many-to-many) | 입력 시퀀스를 다 읽은 뒤 출력 시퀀스를 생성 | 기계 번역(seq2seq) |
| 동기화 다대다(synced many-to-many) | 매 시점마다 출력 | 언어 모델, 프레임 단위 비디오 분류 |
7장의 예제는 모두 다대일 구조다. 문장(또는 시퀀스)을 끝까지 읽고 마지막 은닉 상태 하나로 분류나 회귀를 한다. 다대일 모델의 뼈대는 다음과 같다.
self.em  = nn.Embedding(len(TEXT.vocab.stoi), embeding_dim)  # 단어 번호 -> 벡터
self.rnn = nn.RNNCell(input_dim, hidden_size)                # 순환 셀 하나
self.fc1 = nn.Linear(hidden_size, 256)                       # 완전연결층
self.fc2 = nn.Linear(256, 3)                                 # 출력층
입력과 출력 사이에 RNN 셀이 하나뿐이고, 이 셀을 시점마다 반복 적용한다. 다대일 구조 위에 RNN 층을 여러 겹 쌓으면 적층(stacked) RNN 이 된다. 다대다 번역 모델은 PyTorch에서 보통 인코더와 디코더를 분리한 seq2seq 구조로 만든다. 케라스는 return_sequences=True 옵션 하나로 모든 시점의 출력을 돌려받을 수 있지만, PyTorch의 nn.RNN/nn.LSTM은 처음부터 모든 시점의 출력을 함께 반환하므로 필요한 시점을 골라 쓰면 된다.
7.3.1 RNN 계층과 셀
PyTorch는 순환 신경망을 두 수준으로 제공한다.
- RNN 셀(cell): 한 시점(time step)만 계산한다. 입력 \(x_t\)와 이전 상태 \(h_{t-1}\)을 받아 새 상태 \(h_t\)를 돌려준다. 시퀀스 전체를 처리하려면 사용자가
for문을 직접 돌려야 한다. - RNN 계층(layer): 셀을 감싸서(wrapping) 시퀀스 전체에 같은 셀을 반복 적용한다. 즉 계층은 “셀 + for 문”이다.
| 셀 | 대응 계층 |
|---|---|
nn.RNNCell |
nn.RNN |
nn.LSTMCell |
nn.LSTM |
nn.GRUCell |
nn.GRU |
셀을 쓰면 시점마다 무엇이 일어나는지 코드에서 그대로 보이므로 구조를 이해하기 좋고, 계층을 쓰면 코드가 짧고 cuDNN 최적화 덕분에 빠르다. RNN은 자연어 처리(음성 인식, 문장 분류, 대화), 손글씨, 센서 데이터 등 순서가 의미를 갖는 데이터에 널리 쓰인다.
7.4 RNN 구조
RNN은 은닉층의 노드가 다음 시점의 은닉층과 연결되어 과거 정보를 이어 받는 신경망이다. 시간 축으로 펼쳐 그리면 다음과 같다.
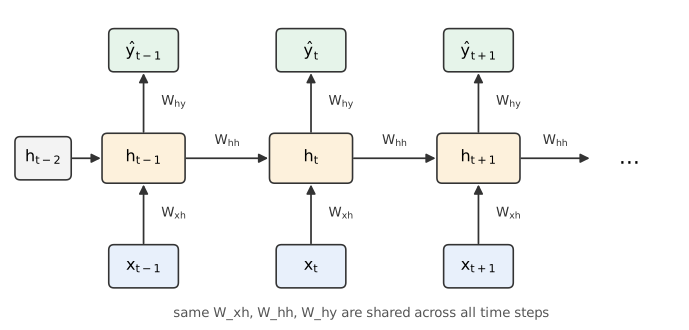 시간 축으로 펼친 RNN. 각 시점의 은닉 상태는 현재 입력(\(W_{xh}\))과 직전 은닉 상태(\(W_{hh}\))를 함께 받아 만들어지고, 출력은 은닉 상태에서 \(W_{hy}\)로 계산된다. 세 가중치는 모든 시점이 공유한다.
RNN에는 세 종류의 가중치가 있다.
- \(W_{xh}\): 입력층 → 은닉층
- \(W_{hh}\): \(t\) 시점 은닉층 → \(t+1\) 시점 은닉층
- \(W_{hy}\): 은닉층 → 출력층
중요한 점은 이 가중치들이 모든 시점에서 같은 값으로 공유된다 는 것이다. 시퀀스가 길어져도 파라미터 수는 늘지 않는다.
\(t\) 시점의 계산은 다음 순서다.
-
은닉 상태: 직전 은닉 상태와 현재 입력을 각각의 가중치로 변환해 더한 뒤 하이퍼볼릭 탄젠트(tanh)를 적용한다.
\[h_t = \tanh(W_{hh} h_{t-1} + W_{xh} x_t + b_h)\] -
출력: 일반 신경망과 같다. 은닉 상태에 \(W_{hy}\)를 곱하고 소프트맥스를 적용한다.
\[\hat{y}_t = \mathrm{softmax}(W_{hy} h_t + b_y)\] -
오차: 순방향 신경망은 출력에서 한 번 오차를 재지만, RNN은 출력이 나오는 각 시점마다 실제 값 \(y_t\)와 예측 \(\hat{y}_t\)의 오차(예: 평균 제곱 오차)를 재고 합친다.
-
역전파: 각 시점의 오차를 시간을 거슬러 앞 시점으로 전달하며 \(W_{xh}\), \(W_{hh}\), \(W_{hy}\)와 편향을 갱신한다. 이를 BPTT(BackPropagation Through Time) 라고 한다.
BPTT에는 약점이 있다. 오차가 먼 과거로 전파될수록 같은 \(W_{hh}\)와 tanh의 미분(1 이하)이 반복해서 곱해지므로 기울기가 점점 작아진다. 이것이 기울기 소멸 문제(vanishing gradient problem) 이며, 결과적으로 RNN은 먼 과거의 정보를 잘 학습하지 못한다. 계산량도 시퀀스 길이에 비례해 커진다.
대응책은 두 가지다. 하나는 오차를 일정 시점(예: 5단계)까지만 역전파하는 생략된 BPTT(truncated BPTT) 로 계산량을 줄이는 것이고, 더 근본적인 해법은 구조 자체를 바꾼 LSTM과 GRU를 쓰는 것이다.
RNN 예제에는 IMDB 영화 리뷰 데이터셋 을 쓴다. 리뷰 5만 개(훈련 25,000, 테스트 25,000)로 이루어져 있고 긍정과 부정이 절반씩이다.
7.4.1 RNN 셀 구현
torchtext로 IMDB를 불러와 전처리한다. Field는 텍스트를 어떻게 다룰지 정의하는 객체다.
import torch, torchtext, time
import torch.nn as nn
import torch.nn.functional as F

TEXT = torchtext.legacy.data.Field(lower=True, fix_length=200, batch_first=False)
LABEL = torchtext.legacy.data.Field(sequential=False)

from torchtext.legacy import datasets
train_data, test_data = datasets.IMDB.splits(TEXT, LABEL)
lower=True: 모두 소문자로 바꾼다.fix_length=200: 리뷰 길이를 200 토큰으로 맞춘다. 짧으면 패딩(padding)을 채우고 길면 자른다.batch_first=False: 텐서 모양을(시퀀스 길이, 배치, 특성)으로 둔다.True면(배치, 시퀀스 길이, 특성)이 된다. 은닉 상태의 모양은 이 옵션과 상관없이 항상(층 수, 배치, 은닉 크기)다.sequential=False: 레이블은 순서가 있는 시퀀스가 아니라 값 하나이므로 끈다.
RNN 코드에서 오류의 대부분은 텐서 모양이 맞지 않아서 생긴다. 각 차원이 무엇을 뜻하는지를 항상 의식해야 한다.
훈련 데이터 하나는 {'text': [...토큰 목록...], 'label': 'pos'} 형태의 딕셔너리다. 여기에 간단한 정제를 적용한다.
import string

for example in train_data.examples:
    text = [x.lower() for x in vars(example)['text']]
    text = [x.replace("<br", "") for x in text]                       # HTML 줄바꿈 흔적 제거
    text = [''.join(c for c in s if c not in string.punctuation) for s in text]  # 구두점 제거
    text = [s for s in text if s]                                      # 빈 문자열 제거
    vars(example)['text'] = text
훈련 데이터를 다시 8:2로 나누어 검증 데이터를 만들고, 단어 집합(vocabulary)을 만든다.
import random
train_data, valid_data = train_data.split(random_state=random.seed(0), split_ratio=0.8)

TEXT.build_vocab(train_data, max_size=10000, min_freq=10, vectors=None)
LABEL.build_vocab(train_data)
print(len(TEXT.vocab), len(LABEL.vocab))
print(LABEL.vocab.stoi)
10002 3
{'<unk>': 0, 'pos': 1, 'neg': 2}
- 훈련 20,000개, 검증 5,000개, 테스트 25,000개가 된다.
max_size=10000: 단어 집합에 최대 1만 개 단어를 넣는다.min_freq=10: 10번 이상 나온 단어만 넣는다. 결과가 10002개인 것은 특수 토큰<unk>(사전에 없는 단어)와<pad>(패딩)가 추가되었기 때문이다.vectors=None: 미리 학습된 임베딩(Word2Vec, GloVe 등)을 쓰지 않고, 모델 안의nn.Embedding이 임베딩을 직접 학습한다.- 레이블 집합에도
<unk>가 들어가 크기가 3이 된다. 그래서 뒤에서 출력층 크기를 3으로 둔다.
BucketIterator로 배치를 만든다. 역할은 DataLoader와 같지만 길이가 비슷한 문장끼리 묶어 패딩을 최소화한다.
BATCH_SIZE = 64
device = torch.device('cuda:0' if torch.cuda.is_available() else 'cpu')
embeding_dim = 100   # 단어 하나를 100차원 벡터로
hidden_size = 300    # 은닉 상태의 크기(유닛 수)

train_iterator, valid_iterator, test_iterator = torchtext.legacy.data.BucketIterator.splits(
    (train_data, valid_data, test_data), batch_size=BATCH_SIZE, device=device)
은닉층의 유닛 수와 층 수는 정답이 없는 하이퍼파라미터다. 보통 한 층의 유닛을 많이 늘리기보다 층을 쌓는 편이 비선형 관계를 학습하는 데 유리하다. 실무에서는 넉넉하게 크게 잡은 뒤 과적합을 보며 줄여 가는 방식을 많이 쓴다.
이제 nn.RNNCell로 인코더를 만든다. 핵심은 forward의 for 문이다.
class RNNCell_Encoder(nn.Module):
    def __init__(self, input_dim, hidden_size):
        super().__init__()
        self.rnn = nn.RNNCell(input_dim, hidden_size)

    def forward(self, inputs):              # inputs: (seq_len, batch, embedding)
        bz = inputs.shape[1]
        ht = torch.zeros((bz, hidden_size)).to(device)   # h_0 = 0
        for word in inputs:                 # 시점마다 한 단어씩
            ht = self.rnn(word, ht)         # h_t = RNNCell(x_t, h_{t-1})
        return ht                           # 마지막 은닉 상태 = 문장 요약

class Net(nn.Module):
    def __init__(self):
        super().__init__()
        self.em = nn.Embedding(len(TEXT.vocab.stoi), embeding_dim)
        self.rnn = RNNCell_Encoder(embeding_dim, hidden_size)
        self.fc1 = nn.Linear(hidden_size, 256)
        self.fc2 = nn.Linear(256, 3)        # <unk>, pos, neg

    def forward(self, x):
        x = self.em(x)                      # (200, batch) -> (200, batch, 100)
        x = self.rnn(x)                     # (batch, 300)
        x = F.relu(self.fc1(x))
        return self.fc2(x)
nn.RNNCell(input_dim, hidden_size): 입력word의 모양은(batch, input_dim), 상태ht의 모양은(batch, hidden_size)다.for word in inputs:batch_first=False이므로 첫 차원이 시간 축이고, 반복할 때마다 한 시점의 단어 벡터 묶음이 나온다.nn.Embedding(단어 수, 임베딩 차원): 정수 단어 번호를 학습 가능한 벡터로 바꾼다.
손실 함수는 nn.CrossEntropyLoss, 옵티마이저는 Adam(학습률 0.0001)이다. CrossEntropyLoss는 내부에서 LogSoftmax와 NLLLoss를 합쳐 계산하므로, 모델의 마지막 층에는 소프트맥스를 넣지 않고 원시 점수(logit)를 그대로 내보낸다.
model = Net().to(device)
loss_fn = nn.CrossEntropyLoss()
optimizer = torch.optim.Adam(model.parameters(), lr=0.0001)
학습 함수는 한 에폭 동안 훈련 데이터를 돌며 가중치를 갱신하고, 이어서 검증 데이터로 손실과 정확도를 잰다.
def training(epoch, model, trainloader, validloader):
    correct, total, running_loss = 0, 0, 0
    model.train()
    for b in trainloader:
        x, y = b.text.to(device), b.label.to(device)
        y_pred = model(x)
        loss = loss_fn(y_pred, y)
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()
        with torch.no_grad():
            correct += (torch.argmax(y_pred, dim=1) == y).sum().item()
            total += y.size(0)
            running_loss += loss.item()
    epoch_loss = running_loss / len(trainloader.dataset)
    epoch_acc = correct / total

    model.eval()
    # ... 같은 방식으로 validloader에서 valid_loss, valid_acc 계산 (torch.no_grad 안에서) ...
    return epoch_loss, epoch_acc, epoch_valid_loss, epoch_valid_acc

for epoch in range(5):
    training(epoch, model, train_iterator, valid_iterator)
epoch: 0 loss: 0.011 accuracy: 0.498 valid_loss: 0.011 valid_accuracy: 0.508
epoch: 1 loss: 0.011 accuracy: 0.502 valid_loss: 0.011 valid_accuracy: 0.496
...
epoch: 4 loss: 0.011 accuracy: 0.524 valid_loss: 0.011 valid_accuracy: 0.515
손실을 데이터셋 크기로 나누어 값이 작게 보인다. 5에폭으로는 정확도가 50% 근처, 즉 동전 던지기 수준에 머문다. 훈련과 검증 손실이 비슷하므로 과적합은 없지만, 아직 거의 배우지 못한 상태다. 테스트 데이터로 평가해도 정확도 약 0.504로 같은 수준이다. 단순 RNN은 길이 200의 시퀀스에서 앞쪽 정보가 기울기 소멸로 거의 전달되지 않는 데다, 작은 학습률로 적은 에폭만 돌렸기 때문이다.
7.4.2 RNN 계층 구현
같은 IMDB 데이터를 nn.RNN 계층으로 처리한다. 이번에는 Field에서 batch_first=True로 두어 입력 모양이 (배치, 시퀀스 길이)가 되게 하고, 배치 크기는 100으로 한다. 클래스는 긍정/부정 2개로 둔다.
class BasicRNN(nn.Module):
    def __init__(self, n_layers, hidden_dim, n_vocab, embed_dim, n_classes, dropout_p=0.2):
        super().__init__()
        self.n_layers = n_layers
        self.hidden_dim = hidden_dim
        self.embed = nn.Embedding(n_vocab, embed_dim)
        self.dropout = nn.Dropout(dropout_p)
        self.rnn = nn.RNN(embed_dim, hidden_dim, num_layers=n_layers, batch_first=True)
        self.out = nn.Linear(hidden_dim, n_classes)

    def forward(self, x):
        x = self.embed(x)                              # (batch, seq, embed)
        h_0 = self._init_state(batch_size=x.size(0))  # (layers, batch, hidden)
        x, _ = self.rnn(x, h_0)                        # x: 모든 시점의 출력 (batch, seq, hidden)
        h_t = x[:, -1, :]                              # 마지막 시점의 출력만 사용
        h_t = self.dropout(h_t)
        return self.out(h_t)

    def _init_state(self, batch_size=1):
        weight = next(self.parameters()).data
        return weight.new(self.n_layers, batch_size, self.hidden_dim).zero_()
nn.RNN(입력 크기, 은닉 크기, num_layers, batch_first): 셀 구현에서 직접 돌리던for문이 이 안에 들어 있다.self.rnn(x, h_0)은(모든 시점의 출력, 마지막 은닉 상태)두 가지를 반환한다. 다대일 분류이므로 출력 중 마지막 시점x[:, -1, :]만 쓴다._init_state: 모델 파라미터와 같은 자료형·장치에(층 수, 배치, 은닉 크기)모양의 0 텐서를 만든다.weight.new(...)는 같은 타입의 새 텐서를 만드는 오래된 관용구다.
책의 코드는 self.dropout(h_t)의 결과를 변수에 받지 않아 드롭아웃이 실제로 적용되지 않고, 출력에 torch.sigmoid를 씌운 뒤 cross_entropy에 넣는다. 위 코드는 드롭아웃 결과를 받도록 고치고 시그모이드를 뺐다. cross_entropy가 내부에서 소프트맥스를 계산하므로 logit을 그대로 넘기는 것이 맞다.
model = BasicRNN(n_layers=1, hidden_dim=256, n_vocab=len(TEXT.vocab),
                 embed_dim=128, n_classes=2, dropout_p=0.5).to(device)
optimizer = torch.optim.Adam(model.parameters(), lr=0.0001)

def train(model, optimizer, train_iter):
    model.train()
    for b, batch in enumerate(train_iter):
        x, y = batch.text.to(device), batch.label.to(device)
        y.data.sub_(1)                   # 레이블 1, 2 -> 0, 1
        optimizer.zero_grad()
        loss = F.cross_entropy(model(x), y)
        loss.backward()
        optimizer.step()

def evaluate(model, val_iter):
    model.eval()
    corrects, total, total_loss = 0, 0, 0
    for batch in val_iter:
        x, y = batch.text.to(device), batch.label.to(device)
        y.data.sub_(1)
        logit = model(x)
        total_loss += F.cross_entropy(logit, y, reduction="sum").item()
        total += y.size(0)
        corrects += (logit.max(1)[1].view(y.size()).data == y.data).sum()
    return total_loss / len(val_iter.dataset), corrects / total
sub_(1): 밑줄로 끝나는 메서드는 제자리(in-place) 연산이다. 레이블 번호 1(pos), 2(neg)를 0, 1로 바꿔n_classes=2에 맞춘다.logit.max(1)[1]:max(dim)은(최댓값, 인덱스)를 돌려주므로[1]은 가장 점수가 높은 클래스 번호, 즉 예측 레이블이다.reduction="sum": 배치 평균 대신 합계를 받아, 마지막에 전체 개수로 나눈다.
[EPOCH: 1], Validation Loss:  0.69 | Validation Accuracy:  0.51
[EPOCH: 2], Validation Loss:  0.69 | Validation Accuracy:  0.50
...
[EPOCH: 5], Validation Loss:  0.69 | Validation Accuracy:  0.50
Test Loss:  0.69 | Test Accuracy:  0.56
손실 0.69는 \(\ln 2 \approx 0.693\)으로, 두 클래스에 확률을 반반 주는 모델의 교차 엔트로피와 같다. 계층으로 바꿔도 단순 RNN의 성능은 셀 구현과 비슷하게 낮다. 이런 경우에는 에폭이나 하이퍼파라미터를 조정하거나, 다른 모델을 시험해 가장 좋은 것을 고른다. 다음 절의 LSTM이 그 후보다.
7.5 LSTM
RNN의 결정적인 약점은 앞에서 본 기울기 소멸이다. 역전파 과정에서 1보다 작은 값이 계속 곱해지면서 먼 과거의 기울기가 사라진다. LSTM(Long Short-Term Memory) 은 은닉 상태와 별도로 셀 상태(cell state) 라는 정보 통로를 두고, 그 통로에 정보를 넣고 빼는 양을 게이트(gate) 로 조절해 이 문제를 완화한다.
7.5.1 LSTM 구조
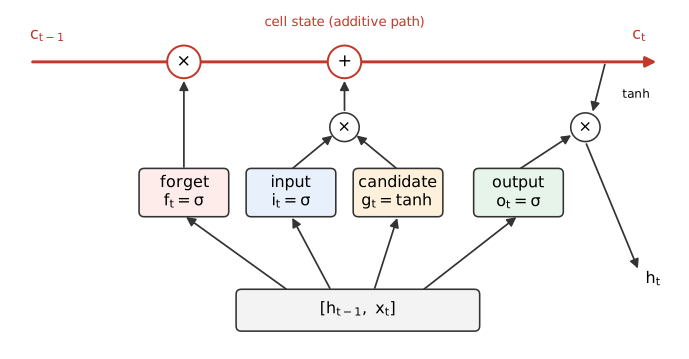 LSTM 셀의 데이터 흐름. 네 개의 게이트가 모두 \([h_{t-1}, x_t]\)를 입력으로 받는다. 위쪽 셀 상태는 망각 게이트와의 곱, 입력 게이트·후보의 곱과의 합만 거치며 흘러가고, 출력 게이트가 셀 상태의 tanh 중 얼마를 은닉 상태 \(h_t\)로 내보낼지 정한다.
순전파
모든 게이트는 직전 은닉 상태 \(h_{t-1}\)과 현재 입력 \(x_t\)를 받는다. 시그모이드 \(\sigma\)의 출력은 0~1이므로 “얼마나 통과시킬지”를 나타내는 비율로 해석한다.
망각 게이트(forget gate): 이전 셀 상태 중 얼마를 유지할지 정한다. 1에 가까우면 과거 정보를 그대로 두고, 0에 가까우면 지운다.
\[f_t = \sigma(W_f [h_{t-1}, x_t] + b_f)\]입력 게이트(input gate): 현재 정보를 셀 상태에 얼마나 반영할지 정한다. 시그모이드로 반영 비율 \(i_t\)를, tanh로 새로 기록할 후보 값 \(g_t\)(-1~1)를 만든다.
\[i_t = \sigma(W_i [h_{t-1}, x_t] + b_i), \qquad g_t = \tanh(W_g [h_{t-1}, x_t] + b_g)\]셀 상태 갱신: 과거 정보 중 남길 부분과 새 정보 중 받아들일 부분을 더한다. \(\odot\)는 원소별 곱이다.
\[c_t = f_t \odot c_{t-1} + i_t \odot g_t\]출력 게이트(output gate): 갱신된 셀 상태 중 얼마를 은닉 상태(그리고 이 시점의 출력)로 내보낼지 정한다.
\[o_t = \sigma(W_o [h_{t-1}, x_t] + b_o), \qquad h_t = o_t \odot \tanh(c_t)\]역전파
셀 상태의 갱신이 곱셈의 반복이 아니라 덧셈 이라는 점이 핵심이다. \(c_t\)를 \(c_{t-1}\)로 미분하면 대략 \(f_t\)만 남는다.
\[\frac{\partial c_t}{\partial c_{t-1}} = f_t\]망각 게이트가 1에 가깝게 열려 있으면 기울기가 셀 상태를 따라 거의 줄지 않고 먼 과거까지 흘러간다. 그래서 LSTM의 셀 경로를 중단 없는 기울기 흐름(uninterrupted gradient flow) 이라고 부른다. 물론 셀 안에서는 게이트를 거쳐 입력 \(x_t\)와 \(h_{t-1}\) 쪽으로도 기울기가 전달되어 게이트의 가중치가 학습된다.
7.5.2 LSTM 셀 구현
LSTM 셀은 MNIST 손글씨 숫자로 실험한다. 28×28 이미지를 28개 행을 차례로 읽는 길이 28의 시퀀스 로 보고, 각 시점의 입력은 한 행(28 픽셀)이다. 마지막 은닉 상태로 숫자 10개 중 하나를 분류한다.
import math
import torch, torch.nn as nn, torch.nn.functional as F
import torchvision.transforms as transforms
from torchvision.datasets import MNIST
from torch.utils.data import DataLoader

device = torch.device('cuda:0' if torch.cuda.is_available() else 'cpu')
torch.manual_seed(125)

mnist_transform = transforms.Compose([
    transforms.ToTensor(),
    transforms.Normalize((0.5,), (1.0,)),   # (x - 0.5) / 1.0
])
download_root = '../chap07/MNIST_DATASET'
train_dataset = MNIST(download_root, transform=mnist_transform, train=True, download=True)
test_dataset = MNIST(download_root, transform=mnist_transform, train=False, download=True)

batch_size = 64
train_loader = DataLoader(train_dataset, batch_size=batch_size, shuffle=True)
valid_loader = DataLoader(test_dataset, batch_size=batch_size, shuffle=True)
test_loader = DataLoader(test_dataset, batch_size=batch_size, shuffle=True)
책은 검증용과 테스트용 로더에 같은 테스트 세트를 쓴다. 엄밀하게는 훈련 세트 일부를 떼어 검증 세트로 써야 한다.
LSTM 셀을 직접 구현한다.
class LSTMCell(nn.Module):
    def __init__(self, input_size, hidden_size, bias=True):
        super().__init__()
        self.hidden_size = hidden_size
        self.x2h = nn.Linear(input_size, 4 * hidden_size, bias=bias)   # 입력 -> 네 게이트
        self.h2h = nn.Linear(hidden_size, 4 * hidden_size, bias=bias)  # 은닉 -> 네 게이트
        self.reset_parameters()

    def reset_parameters(self):
        std = 1.0 / math.sqrt(self.hidden_size)
        for w in self.parameters():
            w.data.uniform_(-std, std)          # U(-1/sqrt(H), 1/sqrt(H)) 초기화

    def forward(self, x, hidden):
        hx, cx = hidden                         # 이전 은닉 상태, 이전 셀 상태
        x = x.view(-1, x.size(1))
        gates = self.x2h(x) + self.h2h(hx)      # (batch, 4H): 네 게이트를 한 번에 계산
        ingate, forgetgate, cellgate, outgate = gates.chunk(4, 1)   # 열 방향으로 4등분

        ingate = torch.sigmoid(ingate)
        forgetgate = torch.sigmoid(forgetgate)
        cellgate = torch.tanh(cellgate)         # 후보 값 g_t
        outgate = torch.sigmoid(outgate)

        cy = cx * forgetgate + ingate * cellgate    # c_t = f*c_{t-1} + i*g
        hy = outgate * torch.tanh(cy)               # h_t = o*tanh(c_t)
        return hy, cy
- 왜
4 * hidden_size인가: 네 게이트(입력, 망각, 후보, 출력)는 모두 같은 입력 \([h_{t-1}, x_t]\)에 서로 다른 가중치를 곱한 것이다. 그래서 출력 크기가 \(4H\)인 선형층 하나로 네 개를 한꺼번에 계산하고chunk(4, 1)로 나눈다. 즉gates는 \(W_x x_t + b_x + W_h h_{t-1} + b_h\)를 네 게이트분 이어 붙인 것이다. torch.chunk(tensor, chunks, dim): 텐서를 지정한 차원 기준으로 같은 크기 조각으로 나눈다.dim=1이므로 열 방향으로 자른다.uniform_(-std, std): 밑줄이 붙은 제자리 연산으로, 파라미터를 균등 분포 난수로 채운다. PyTorch 내장nn.LSTMCell도 같은 범위로 초기화한다.- 책은
F.sigmoid,F.tanh,torch.mul을 쓰는데, 현재는torch.sigmoid,torch.tanh,*연산자를 쓰는 것이 권장된다. 결과는 같다.
셀을 시점마다 반복 적용하는 모델은 다음과 같다.
class LSTMModel(nn.Module):
    def __init__(self, input_dim, hidden_dim, layer_dim, output_dim):
        super().__init__()
        self.hidden_dim = hidden_dim
        self.layer_dim = layer_dim
        self.lstm = LSTMCell(input_dim, hidden_dim)
        self.fc = nn.Linear(hidden_dim, output_dim)

    def forward(self, x):                    # x: (batch, 28, 28)
        h0 = torch.zeros(self.layer_dim, x.size(0), self.hidden_dim, device=x.device)
        c0 = torch.zeros(self.layer_dim, x.size(0), self.hidden_dim, device=x.device)
        hn, cn = h0[0], c0[0]                # (batch, hidden)
        outs = []
        for seq in range(x.size(1)):         # 28개 행을 차례로
            hn, cn = self.lstm(x[:, seq, :], (hn, cn))
            outs.append(hn)
        out = outs[-1].squeeze()             # 마지막 시점의 은닉 상태
        return self.fc(out)

input_dim, hidden_dim, layer_dim, output_dim = 28, 128, 1, 10
model = LSTMModel(input_dim, hidden_dim, layer_dim, output_dim).to(device)
criterion = nn.CrossEntropyLoss()
optimizer = torch.optim.SGD(model.parameters(), lr=0.1)
squeeze()는 크기가 1인 차원을 없앤다. 예를 들어 (2, 1) 텐서는 (2,)가 된다.
학습 루프에서는 이미지를 (배치, 28, 28)로 바꿔 넣고, 500 반복마다 검증 정확도를 출력한다. 책 코드의 Variable은 PyTorch 0.4 이전의 래퍼로, 지금은 모든 텐서가 자동 미분을 지원하므로 쓰지 않아도 된다.
seq_dim = 28
num_epochs = 6000 // (len(train_dataset) // 100)   # 책의 계산식(= 10)
iter = 0
for epoch in range(num_epochs):
    for images, labels in train_loader:
        images = images.view(-1, seq_dim, input_dim).to(device)
        labels = labels.to(device)
        optimizer.zero_grad()
        loss = criterion(model(images), labels)
        loss.backward()
        optimizer.step()
        iter += 1
        if iter % 500 == 0:
            # valid_loader로 정확도 계산 (torch.max(outputs, 1)로 예측 클래스)
            ...
Iteration: 500. Loss: 2.237457513809204. Accuracy: 21.42
Iteration: 1000. Loss: 0.8156253695487976. Accuracy: 75.58
Iteration: 2000. Loss: 0.2941139340400696. Accuracy: 92.52
Iteration: 4000. Loss: 0.02473960630595684. Accuracy: 97.39
...
Iteration: 9000. Loss: 0.03081698529422283. Accuracy: 97.88
Test Loss:  0.06 | Test Accuracy:  0.98
테스트 정확도 98%다. IMDB와 달리 MNIST는 이미 깔끔하게 정리된 데이터이고 시퀀스 길이도 28로 짧다. 전처리가 덜 된 데이터라면 은닉층 크기, 층 수, 하이퍼파라미터를 더 손봐야 한다. 모델 구조가 바뀌어도 학습·평가 코드의 패턴은 거의 같으므로, 네트워크 정의와 그 파라미터에 집중해 읽으면 된다.
7.5.3 LSTM 계층 구현
nn.LSTM 계층은 스타벅스 주가 데이터(SBUX.csv, 2019-12-11 ~ 2020-12-10, 253거래일)로 실험한다. 열은 Open, High, Low, Close, Adj Close, Volume이다.
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.preprocessing import StandardScaler, MinMaxScaler

data = pd.read_csv('../chap07/data/SBUX.csv')
data['Date'] = pd.to_datetime(data['Date'])
data.set_index('Date', inplace=True)          # 날짜를 인덱스로
data['Volume'] = data['Volume'].astype(float) # 정수 -> 실수 (텐서 변환 대비)

X = data.iloc[:, :-1]     # 가격 5개 열을 입력으로
y = data.iloc[:, 5:6]     # 마지막 열 Volume(거래량)을 예측 대상으로
날짜는 임베딩하기 까다로우므로 인덱스로 빼 둔다. 열 이름은 대소문자를 구분하므로 'Date', 'Volume'처럼 원본 그대로 써야 한다(책 본문 코드 7-42, 7-43의 소문자 'date'는 오류가 난다).
입력과 출력의 값 범위가 크게 다르므로 스케일을 맞춘다. 입력은 평균 0·분산 1로 표준화하고, 출력은 0~1로 정규화한다. 앞 200일은 훈련, 뒤 53일은 테스트에 쓴다.
ms, ss = MinMaxScaler(), StandardScaler()
X_ss = ss.fit_transform(X)
y_ms = ms.fit_transform(y)
X_train, X_test = X_ss[:200, :], X_ss[200:, :]
y_train, y_test = y_ms[:200, :], y_ms[200:, :]

X_train_tensors = torch.Tensor(X_train)
y_train_tensors = torch.Tensor(y_train)
X_train_tensors_f = torch.reshape(X_train_tensors, (X_train_tensors.shape[0], 1, X_train_tensors.shape[1]))
print(X_train_tensors_f.shape, y_train_tensors.shape)
torch.Size([200, 1, 5]) torch.Size([200, 1])
(200, 5)를 (200, 1, 5)로 바꾼 것은 batch_first=True인 LSTM의 입력 모양 (배치, 시퀀스 길이, 특성)에 맞추기 위해서다. 즉 하루치 가격 5개를 길이 1짜리 시퀀스 로 넣고 같은 날의 거래량을 맞추는 구성이다. 엄밀히 보면 과거 여러 날을 보고 다음 값을 예측하는 시계열 모델이라기보다 LSTM 계층의 사용법을 익히기 위한 회귀 예제다. 실제 시계열 예측이라면 최근 \(k\)일을 묶은 (배치, k, 특성) 윈도우를 입력으로 만들어야 한다.
class LSTM(nn.Module):
    def __init__(self, num_classes, input_size, hidden_size, num_layers, seq_length):
        super().__init__()
        self.num_layers = num_layers
        self.hidden_size = hidden_size
        self.lstm = nn.LSTM(input_size=input_size, hidden_size=hidden_size,
                            num_layers=num_layers, batch_first=True)
        self.fc_1 = nn.Linear(hidden_size, 128)
        self.fc = nn.Linear(128, num_classes)
        self.relu = nn.ReLU()

    def forward(self, x):
        h_0 = torch.zeros(self.num_layers, x.size(0), self.hidden_size)   # 은닉 상태
        c_0 = torch.zeros(self.num_layers, x.size(0), self.hidden_size)   # 셀 상태
        output, (hn, cn) = self.lstm(x, (h_0, c_0))
        hn = hn.view(-1, self.hidden_size)    # (layers, batch, H) -> (batch, H)
        out = self.relu(hn)
        out = self.relu(self.fc_1(out))
        return self.fc(out)

model = LSTM(num_classes=1, input_size=5, hidden_size=2, num_layers=1,
             seq_length=X_train_tensors_f.shape[1])
criterion = torch.nn.MSELoss()                 # 회귀이므로 평균 제곱 오차
optimizer = torch.optim.Adam(model.parameters(), lr=0.0001)

for epoch in range(1000):
    outputs = model(X_train_tensors_f)
    optimizer.zero_grad()
    loss = criterion(outputs, y_train_tensors)
    loss.backward()
    optimizer.step()
    if epoch % 100 == 0:
        print("Epoch: %d, loss: %1.5f" % (epoch, loss.item()))
nn.LSTM은(output, (h_n, c_n))을 반환한다. RNN과 달리 상태가 은닉 상태와 셀 상태 두 개다.hn은 마지막 시점의 은닉 상태로 모양이(층 수, 배치, 은닉 크기)다. 층이 1개이므로view로(배치, 은닉 크기)로 펼쳐 완전연결층에 넣는다.
Epoch: 0, loss: 0.10221
Epoch: 100, loss: 0.00653
Epoch: 200, loss: 0.00031
...
Epoch: 900, loss: 0.00023
손실만으로는 예측이 얼마나 맞는지 감이 오지 않으므로 그래프로 확인한다. 전체 기간을 같은 스케일러로 변환해 예측하고, inverse_transform으로 원래 단위(주식 수)로 되돌린다.
df_x_ss = torch.Tensor(ss.transform(data.iloc[:, :-1]))
df_y_ms = torch.Tensor(ms.transform(data.iloc[:, -1:]))
df_x_ss = torch.reshape(df_x_ss, (df_x_ss.shape[0], 1, df_x_ss.shape[1]))

predicted = ms.inverse_transform(model(df_x_ss).data.numpy())
label_y = ms.inverse_transform(df_y_ms.data.numpy())

plt.figure(figsize=(10, 6))
plt.axvline(x=200, c='r', linestyle='--')   # 훈련/테스트 경계에 세로선
plt.plot(label_y, label='Actual Data')
plt.plot(predicted, label='Predicted Data')
plt.title('Time-Series Prediction')
plt.legend()
plt.show()
axvline은 지정한 x 위치에 세로선을, axhline은 가로선을 그린다. 결과 그래프에서 예측선은 실제 거래량의 큰 움직임을 따라가지 못하고 평평하게 뭉개진다. 은닉 크기가 2로 아주 작은 탓도 있다. 결과가 만족스럽지 않을 때는 하이퍼파라미터 튜닝(8장)과 함께 다른 모델을 시도해 본다.
7.6 게이트 순환 신경망(GRU)
GRU(Gated Recurrent Unit) 는 LSTM을 단순하게 만든 게이트 RNN이다. 셀 상태와 은닉 상태를 하나로 합쳤고, 게이트도 두 개뿐이어서 파라미터가 LSTM보다 적다.
7.6.1 GRU 구조
LSTM과 비교한 차이는 다음과 같다.
- 별도의 셀 상태가 없다. 은닉 상태 \(h_t\) 하나가 기억과 출력을 모두 맡는다.
- 망각 게이트와 입력 게이트를 업데이트 게이트 하나로 합쳤다. 하나의 값 \(z_t\)가 “과거를 얼마나 남길지”를 정하면, 새 정보를 받아들이는 비율은 자동으로 \(1 - z_t\)가 된다. 한쪽이 열리면 다른 쪽은 닫히는 구조다.
- 출력 게이트가 없어 매 시점 은닉 상태 전체가 그대로 출력된다. 대신 이전 상태의 어느 부분을 후보 계산에 쓸지 정하는 리셋 게이트 가 있다.
리셋 게이트(reset gate): 과거 은닉 상태를 후보 계산에 얼마나 반영할지 정한다(책은 망각 게이트라고도 부른다).
\[r_t = \sigma(W_r x_t + U_r h_{t-1} + b_r)\]업데이트 게이트(update gate): 과거 정보와 새 정보의 비율을 정한다.
\[z_t = \sigma(W_z x_t + U_z h_{t-1} + b_z)\]후보(candidate): 과거 은닉 상태를 그대로 쓰지 않고 리셋 게이트로 걸러서 쓴다.
\[\tilde{h}_t = \tanh(W_n x_t + r_t \odot (U_n h_{t-1}) + b_n)\]은닉 상태: 업데이트 게이트로 과거 상태와 후보를 섞는다.
\[h_t = (1 - z_t) \odot \tilde{h}_t + z_t \odot h_{t-1}\]\(z_t\)를 과거 쪽에 곱하느냐 후보 쪽에 곱하느냐는 문헌마다 다르다(책의 설명은 반대 방향으로 적혀 있다). 위 식은 아래 구현 코드와 PyTorch nn.GRU가 쓰는 방식이다. 어느 쪽이든 “한 게이트 값으로 과거와 현재를 보간한다”는 의미는 같다.
7.6.2 GRU 셀 구현
데이터(MNIST), 전처리, 학습 루프는 LSTM 셀과 같고 셀 내부만 다르다.
class GRUCell(nn.Module):
    def __init__(self, input_size, hidden_size, bias=True):
        super().__init__()
        self.hidden_size = hidden_size
        self.x2h = nn.Linear(input_size, 3 * hidden_size, bias=bias)    # 게이트 3개분
        self.h2h = nn.Linear(hidden_size, 3 * hidden_size, bias=bias)
        self.reset_parameters()

    def reset_parameters(self):
        std = 1.0 / math.sqrt(self.hidden_size)
        for w in self.parameters():
            w.data.uniform_(-std, std)

    def forward(self, x, hidden):
        x = x.view(-1, x.size(1))
        gate_x = self.x2h(x)              # 입력 쪽, 은닉 쪽을 따로 유지
        gate_h = self.h2h(hidden)
        i_r, i_i, i_n = gate_x.chunk(3, 1)
        h_r, h_i, h_n = gate_h.chunk(3, 1)

        resetgate = torch.sigmoid(i_r + h_r)                 # r_t
        inputgate = torch.sigmoid(i_i + h_i)                 # z_t
        newgate = torch.tanh(i_n + (resetgate * h_n))        # 후보 h~_t
        hy = newgate + inputgate * (hidden - newgate)        # (1-z)*h~ + z*h_{t-1}
        return hy
3 * hidden_size: 엄밀히 게이트는 리셋과 업데이트 두 개지만, tanh를 쓰는 후보 계산까지 같은 방식으로 묶어 세 덩어리로 만든다.- LSTM 셀은
x2h(x) + h2h(hx)를 먼저 더했지만, GRU 셀은 두 결과를 따로 유지한다. 후보 계산에서 리셋 게이트를 은닉 쪽 항h_n에만 곱해야 하기 때문이다. - 마지막 줄을 전개하면
newgate * (1 - inputgate) + inputgate * hidden이므로 위 식과 같다.
전체 모델은 셀 상태가 없다는 점만 LSTM 모델과 다르다.
class GRUModel(nn.Module):
    def __init__(self, input_dim, hidden_dim, layer_dim, output_dim):
        super().__init__()
        self.hidden_dim, self.layer_dim = hidden_dim, layer_dim
        self.gru_cell = GRUCell(input_dim, hidden_dim)
        self.fc = nn.Linear(hidden_dim, output_dim)

    def forward(self, x):
        hn = torch.zeros(self.layer_dim, x.size(0), self.hidden_dim, device=x.device)[0]
        outs = []
        for seq in range(x.size(1)):
            hn = self.gru_cell(x[:, seq, :], hn)     # 은닉 상태 하나만 전달
            outs.append(hn)
        return self.fc(outs[-1].squeeze())
학습 설정(입력 28, 은닉 128, SGD 학습률 0.1)도 LSTM 셀과 같다.
Iteration: 500. Loss: 1.661692500114441. Accuracy: 43.59
Iteration: 1000. Loss: 0.8945671319961548. Accuracy: 76.19
...
Iteration: 9000. Loss: 0.04198891296982765. Accuracy: 98.22
Test Loss:  0.07 | Test Accuracy:  0.98
초반 수렴은 GRU가 조금 빠르지만 최종 정확도는 LSTM 셀과 거의 같다. RNN, LSTM, GRU 중 어느 것이 항상 낫다고 할 수는 없으므로, 데이터마다 여러 모델과 하이퍼파라미터를 시험해 가장 좋은 조합을 고른다.
7.6.3 GRU 계층 구현
스타벅스 주가 예제를 nn.GRU로 바꾼다. 데이터 준비는 LSTM 계층과 완전히 같다.
class GRU(nn.Module):
    def __init__(self, num_classes, input_size, hidden_size, num_layers, seq_length):
        super().__init__()
        self.num_layers, self.hidden_size = num_layers, hidden_size
        self.gru = nn.GRU(input_size=input_size, hidden_size=hidden_size,
                          num_layers=num_layers, batch_first=True)
        self.fc_1 = nn.Linear(hidden_size, 128)
        self.fc = nn.Linear(128, num_classes)
        self.relu = nn.ReLU()

    def forward(self, x):
        h_0 = torch.zeros(self.num_layers, x.size(0), self.hidden_size)   # 셀 상태는 없음
        output, hn = self.gru(x, h_0)
        hn = hn.view(-1, self.hidden_size)
        out = self.relu(hn)
        out = self.relu(self.fc_1(out))
        return self.fc(out)

model = GRU(num_classes=1, input_size=5, hidden_size=2, num_layers=1,
            seq_length=X_train_tensors_f.shape[1])
nn.GRU는 (output, h_n)만 반환한다. 책 본문은 input_size = 4, 학습 루프에서 lstm1.forward(...)로 적혀 있는데, 입력 열이 5개이고 모델 변수 이름이 model이므로 공식 예제 노트북처럼 input_size = 5, model(...)로 써야 동작한다.
Epoch: 0, loss: 0.07065
Epoch: 100, loss: 0.03507
...
Epoch: 900, loss: 0.02572
그래프로 보면 GRU 쪽 예측선이 실제 거래량의 오르내림을 더 잘 따라가는 것처럼 보이지만, 수치상 차이는 크지 않다. 학습 데이터 순서나 초기화에 따라 결과가 달라질 수 있다.
7.7 양방향 RNN
지금까지의 RNN은 과거에서 현재 방향으로만 정보를 모은다. 하지만 문장의 빈칸을 채울 때처럼 뒤에 오는 내용 이 힌트가 되는 경우도 많다. 양방향 RNN(bidirectional RNN) 은 과거와 미래 양쪽 문맥을 함께 사용한다.
7.7.1 양방향 RNN 구조
양방향 RNN은 한 시점의 출력을 위해 메모리 셀 두 개를 쓴다.
- 순방향 셀: 앞 시점의 은닉 상태(forward states)를 받아 왼쪽에서 오른쪽으로 진행한다.
- 역방향 셀: 뒤 시점의 은닉 상태(backward states)를 받아 오른쪽에서 왼쪽으로 진행한다.
각 시점에서 두 은닉 상태를 이어 붙여(concatenate) 출력층에 넣는다.
\[h_t = [\overrightarrow{h}_t ; \overleftarrow{h}_t]\]이 개념은 기본 RNN뿐 아니라 LSTM과 GRU에도 똑같이 적용된다. 시퀀스 전체를 미리 알아야 하므로, 문장 분류처럼 입력이 다 주어진 문제에 적합하고 실시간으로 다음 값을 예측하는 문제에는 그대로 쓰기 어렵다.
7.7.2 양방향 LSTM 구현
스타벅스 데이터 준비 코드는 LSTM 계층과 같다. 네트워크만 바꾼다.
class biLSTM(nn.Module):
    def __init__(self, num_classes, input_size, hidden_size, num_layers, seq_length):
        super().__init__()
        self.num_layers, self.hidden_size = num_layers, hidden_size
        self.lstm = nn.LSTM(input_size=input_size, hidden_size=hidden_size,
                            num_layers=num_layers, bidirectional=True, batch_first=True)
        self.fc = nn.Linear(hidden_size * 2, num_classes)   # 두 방향을 이어 붙였으므로 2배
        self.relu = nn.ReLU()

    def forward(self, x):
        h_0 = torch.zeros(self.num_layers * 2, x.size(0), self.hidden_size)  # 방향 수만큼
        c_0 = torch.zeros(self.num_layers * 2, x.size(0), self.hidden_size)
        out, _ = self.lstm(x, (h_0, c_0))     # out: (batch, seq, 2*hidden)
        out = self.fc(out[:, -1, :])          # 마지막 시점의 출력
        return self.relu(out)

model = biLSTM(num_classes=1, input_size=5, hidden_size=2, num_layers=1,
               seq_length=X_train_tensors_f.shape[1])
bidirectional=True하나로 양방향이 된다.nn.RNN,nn.GRU에도 같은 옵션이 있다.- 방향이 둘이므로 초기 은닉·셀 상태의 첫 차원은
num_layers * 2이고, 출력의 마지막 차원은hidden_size * 2다.num_layers=1이어도 내부적으로는 두 개의 LSTM이 돌기 때문이다. 그래서 출력층의 입력 크기도 2배가 된다. - 책 본문의
biLSTM(num_classes, input_size, X_train_tensors_f.shape[1])은 인자가 부족하므로 위처럼 모든 인자를 넘겨야 한다.
학습 설정(1000 에폭, Adam 0.0001, MSE)도 같다.
Epoch: 0, loss: 0.13400
Epoch: 100, loss: 0.12098
...
Epoch: 900, loss: 0.02978
그래프에서는 예측선이 실제 값과 꽤 비슷하게 움직여, 단방향 LSTM보다 나은 결과로 보인다. 다만 여기서는 시퀀스 길이가 1이므로 “미래 문맥”의 효과라기보다 구조와 파라미터 수 차이에서 오는 결과로 보는 편이 맞다. 데이터를 섞는 순서에 따라 실행마다 결과가 달라질 수도 있다.
모델 구현 자체는 어렵지 않다. 실제로 어려운 부분은 데이터 처리다. 시계열 데이터의 상당수는 숫자의 나열이 아니라 사람의 언어이므로, 텍스트를 숫자로 바꾸는 전처리와 임베딩이 성능을 좌우한다. 이 내용은 9장과 10장에서 다룬다.
정리
- 시계열은 불규칙·추세·순환·계절 변동으로 나누어 볼 수 있다. AR은 과거 값, MA는 과거 오차, ARMA는 둘 다, ARIMA는 여기에 \(d\)번의 차분을 더해 추세가 있는 데이터를 다룬다.
- RNN은 \(h_t = \tanh(W_{hh} h_{t-1} + W_{xh} x_t + b)\)로 은닉 상태를 갱신하며, \(W_{xh}, W_{hh}, W_{hy}\)를 모든 시점이 공유한다. 학습은 BPTT로 하며, 먼 과거로 갈수록 기울기가 사라지는 문제가 있다.
- PyTorch의 셀(
nn.RNNCell,nn.LSTMCell,nn.GRUCell)은 한 시점만 계산하므로for문을 직접 돌리고, 계층(nn.RNN,nn.LSTM,nn.GRU)은 시퀀스 전체를 한 번에 처리한다. - LSTM은 망각·입력·출력 게이트와 덧셈으로 갱신되는 셀 상태 \(c_t = f_t \odot c_{t-1} + i_t \odot g_t\)로 기울기가 끊기지 않게 한다. 직접 구현할 때는 네 게이트를
4 * hidden_size선형층 하나로 계산해chunk로 나눈다. - GRU는 셀 상태 없이 리셋·업데이트 게이트 두 개로 동작하며, 업데이트 게이트 하나로 과거와 후보를 보간한다. 파라미터가 적고 성능은 LSTM과 비슷한 경우가 많다.
- 입력 모양은
batch_first에 따라(seq, batch, feature)또는(batch, seq, feature)이고, 은닉 상태는 항상(층 수 × 방향 수, batch, hidden)이다. 다대일 분류에서는 마지막 시점의 출력이나h_n을 쓴다. - 양방향 RNN은
bidirectional=True로 만들며, 상태의 첫 차원과 출력 크기가 2배가 된다. - 단순 RNN은 IMDB에서 약 50%에 머물렀고, LSTM/GRU 셀은 MNIST 행 시퀀스에서 98%를 냈다. 어떤 모델이 항상 낫다고 할 수 없으므로 데이터마다 비교해 고른다.