6장은 5장에서 익힌 합성곱 신경망(CNN)이 실제로 어떤 구조로 발전해 왔는지를 세 가지 과제로 나누어 살펴본다. 이미지 분류에서는 LeNet-5부터 ResNet까지 대표 모델을 직접 구현해 보고, 객체 인식과 이미지 분할에서는 R-CNN 계열과 FCN, U-Net 등 대표 네트워크의 핵심 아이디어를 정리한다.
6.1 이미지 분류를 위한 신경망
이미지 분류(image classification) 는 이미지에 특정 대상이 있는지, 있다면 어떤 클래스인지를 판단하는 과제다. 이 절의 예제들은 모두 개·고양이 사진 일부(Kaggle Dogs vs. Cats에서 고른 소량)를 같은 방식으로 불러와 쓰므로, 데이터 준비 코드는 LeNet-5에서 한 번 자세히 보고 이후에는 네트워크 구조에 집중한다.
6.1.1 LeNet-5
LeNet-5는 얀 르쿤(Yann LeCun) 등이 수표의 손글씨 숫자 인식을 위해 발표한 구조로, 오늘날 CNN의 원형이다. 합성곱과 다운 샘플링(풀링)을 번갈아 반복한 뒤 마지막에 완전연결층으로 분류한다. 원래 구조는 다음과 같다(C는 합성곱층, S는 풀링층, F는 완전연결층).
| 층 | 연산 | 출력 |
|---|---|---|
| 입력 | 32×32×1 | |
| C1 | 5×5 합성곱, 필터 6개 | 28×28×6 |
| S2 | 2×2 다운 샘플링 | 14×14×6 |
| C3 | 5×5 합성곱, 필터 16개 | 10×10×16 |
| S4 | 2×2 다운 샘플링 | 5×5×16 |
| C5 | 5×5 합성곱, 필터 120개 | 1×1×120 |
| F6 | 완전연결 | 84 |
| 출력 | 완전연결 | 10 |
크기 변화는 5장의 공식 \((W - F + 2P)/S + 1\)로 확인할 수 있다. 예를 들어 C1은 \((32 - 5)/1 + 1 = 28\), C3는 \((14 - 5)/1 + 1 = 10\)이다.
데이터 전처리
훈련용과 검증용 전처리를 딕셔너리에 담아 두고, 객체를 함수처럼 호출하면 단계(phase)에 맞는 변환을 적용하는 클래스를 만든다.
from torchvision import transforms

class ImageTransform():
    def __init__(self, resize, mean, std):
        self.data_transform = {
            'train': transforms.Compose([
                transforms.RandomResizedCrop(resize, scale=(0.5, 1.0)),  # 면적 50~100% 무작위 자르기
                transforms.RandomHorizontalFlip(),                      # 50% 확률 좌우 반전
                transforms.ToTensor(),
                transforms.Normalize(mean, std)                         # 채널별 정규화
            ]),
            'val': transforms.Compose([
                transforms.Resize(256),
                transforms.CenterCrop(resize),
                transforms.ToTensor(),
                transforms.Normalize(mean, std)
            ])
        }

    def __call__(self, img, phase):          # 객체(img, phase) 형태로 호출하면 실행
        return self.data_transform[phase](img)
ToTensor()는 PIL 이미지(값 범위 0~255, 형태 H×W×C)를FloatTensor(값 범위 0~1, 형태 C×H×W)로 바꾼다.Normalize(mean, std)는 채널마다 \((x - \mu)/\sigma\)를 적용한다. 예제에서 쓰는mean=(0.485, 0.456, 0.406),std=(0.229, 0.224, 0.225)는 ImageNet 이미지의 RGB 채널별 평균과 표준편차다. ImageNet으로 사전 훈련된 모델을 쓸 때는 같은 정규화를 해야 하므로 관례적으로 이 값을 쓴다. OpenCV로 읽은 이미지는 BGR 순서이므로 채널 순서에 주의한다.__init__이 객체를 만들 때 실행된다면,__call__은 만들어진 객체를 함수처럼 호출할 때 실행된다.
데이터 분할과 커스텀 데이터셋
import os, random, cv2

cat_directory = r'../chap06/data/dogs-vs-cats/Cat/'
dog_directory = r'../chap06/data/dogs-vs-cats/Dog/'

cat_images_filepaths = sorted([os.path.join(cat_directory, f) for f in os.listdir(cat_directory)])
dog_images_filepaths = sorted([os.path.join(dog_directory, f) for f in os.listdir(dog_directory)])
images_filepaths = [*cat_images_filepaths, *dog_images_filepaths]
# OpenCV로 읽히지 않는(깨진) 파일은 제외
correct_images_filepaths = [i for i in images_filepaths if cv2.imread(i) is not None]

random.seed(42)                         # 같은 시드면 같은 순서로 섞인다
random.shuffle(correct_images_filepaths)
train_images_filepaths = correct_images_filepaths[:400]    # 훈련 400장
val_images_filepaths = correct_images_filepaths[400:-10]   # 검증 92장
test_images_filepaths = correct_images_filepaths[-10:]     # 테스트 10장
print(len(train_images_filepaths), len(val_images_filepaths), len(test_images_filepaths))
400 92 10
os.listdir는 폴더 안의 파일 이름 목록을,os.path.join은 경로 조각을 운영체제에 맞는 구분자로 이어 붙인 경로를 돌려준다.- 난수 생성기는 시드(seed) 가 같으면 항상 같은 수열을 낸다. 시드를 고정해 두면 실행할 때마다 같은 분할을 얻어 결과를 재현할 수 있다.
from torch.utils.data import Dataset, DataLoader
from PIL import Image

class DogvsCatDataset(Dataset):
    def __init__(self, file_list, transform=None, phase='train'):
        self.file_list = file_list      # 경로만 저장 (이미지는 필요할 때 읽음)
        self.transform = transform
        self.phase = phase

    def __len__(self):
        return len(self.file_list)

    def __getitem__(self, idx):
        img_path = self.file_list[idx]
        img = Image.open(img_path)
        img_transformed = self.transform(img, self.phase)
        # '.../Dog/dog.113.jpg' -> 'dog.113.jpg' -> 'dog'
        label = img_path.split('/')[-1].split('.')[0]
        if label == 'dog':
            label = 1
        elif label == 'cat':
            label = 0
        return img_transformed, label

size, batch_size = 224, 32
mean, std = (0.485, 0.456, 0.406), (0.229, 0.224, 0.225)

train_dataset = DogvsCatDataset(train_images_filepaths, transform=ImageTransform(size, mean, std), phase='train')
val_dataset = DogvsCatDataset(val_images_filepaths, transform=ImageTransform(size, mean, std), phase='val')

train_dataloader = DataLoader(train_dataset, batch_size=batch_size, shuffle=True)
val_dataloader = DataLoader(val_dataset, batch_size=batch_size, shuffle=False)
dataloader_dict = {'train': train_dataloader, 'val': val_dataloader}

inputs, label = next(iter(train_dataloader))
print(inputs.size())
torch.Size([32, 3, 224, 224])
Dataset을 상속한 클래스는 __len__(전체 개수)과 __getitem__(인덱스 하나에 해당하는 샘플)만 구현하면 된다. 데이터가 클 수 있으므로 __init__에서는 경로만 저장하고 실제 이미지는 __getitem__에서 읽는다. DataLoader는 이 데이터셋에서 배치 크기만큼씩 꺼내 메모리에 올린다.
네트워크
예제의 LeNet은 원본과 달리 224×224 컬러 이미지를 받고, 필터 수(16, 32)와 완전연결층 크기도 다르다.
import torch.nn as nn

class LeNet(nn.Module):
    def __init__(self):
        super(LeNet, self).__init__()
        self.cnn1 = nn.Conv2d(in_channels=3, out_channels=16, kernel_size=5, stride=1, padding=0)  # (16, 220, 220)
        self.relu1 = nn.ReLU()
        self.maxpool1 = nn.MaxPool2d(kernel_size=2)                                             # (16, 110, 110)
        self.cnn2 = nn.Conv2d(in_channels=16, out_channels=32, kernel_size=5, stride=1, padding=0) # (32, 106, 106)
        self.relu2 = nn.ReLU()
        self.maxpool2 = nn.MaxPool2d(kernel_size=2)                                             # (32, 53, 53)
        self.fc1 = nn.Linear(32*53*53, 512)
        self.relu5 = nn.ReLU()
        self.fc2 = nn.Linear(512, 2)
        self.output = nn.Softmax(dim=1)

    def forward(self, x):
        out = self.maxpool1(self.relu1(self.cnn1(x)))
        out = self.maxpool2(self.relu2(self.cnn2(out)))
        out = out.view(out.size(0), -1)     # (N, 32*53*53) = (N, 89888)
        out = self.fc1(out)
        out = self.fc2(out)
        out = self.output(out)
        return out
torchsummary의 summary(model, input_size=(3, 224, 224))를 쓰면 층별 출력 형태와 파라미터 수를 표로 볼 수 있다.
        Layer (type)               Output Shape         Param #
================================================================
            Conv2d-1         [-1, 16, 220, 220]           1,216
              ReLU-2         [-1, 16, 220, 220]               0
         MaxPool2d-3         [-1, 16, 110, 110]               0
            Conv2d-4         [-1, 32, 106, 106]          12,832
              ReLU-5         [-1, 32, 106, 106]               0
         MaxPool2d-6           [-1, 32, 53, 53]               0
            Linear-7                  [-1, 512]      46,023,168
            Linear-8                    [-1, 2]           1,026
           Softmax-9                    [-1, 2]               0
================================================================
Total params: 46,038,242
파라미터 수는 직접 계산할 수 있다. 합성곱층은 (커널 높이 × 너비 × 입력 채널 + 1) × 출력 채널이므로 첫 층은 \((5 \cdot 5 \cdot 3 + 1) \cdot 16 = 1{,}216\)이다. fc1은 \(89{,}888 \cdot 512 + 512 = 46{,}023{,}168\)으로 전체의 99.97%를 차지한다. 큰 특성 맵을 그대로 펼쳐 완전연결층에 넣으면 파라미터가 폭발한다는 점이 잘 드러난다. 학습 가능한 파라미터 수는 다음처럼 셀 수도 있다.
def count_parameters(model):
    return sum(p.numel() for p in model.parameters() if p.requires_grad)
print(f'The model has {count_parameters(model):,} trainable parameters')
참고로 이 코드에는 relu5가 정의만 되고 forward에서 쓰이지 않으며, 출력에 Softmax를 적용한 뒤 다시 nn.CrossEntropyLoss(내부에서 log-softmax 수행)에 넣는다. 소프트맥스가 두 번 적용되면 기울기가 작아져 학습이 더뎌지므로, 보통은 모델이 로짓을 그대로 내보내게 하고 확률이 필요할 때만 따로 소프트맥스를 적용한다.
옵티마이저와 학습 함수
from torch import optim

optimizer = optim.SGD(model.parameters(), lr=0.001, momentum=0.9)
criterion = nn.CrossEntropyLoss()
model = model.to(device)
criterion = criterion.to(device)
모멘텀 SGD는 매 스텝의 기울기에 이전 갱신 방향을 일정 비율 더해 관성을 준다. 같은 방향으로 계속 내려가면 속도가 붙고, 방향이 자주 바뀌는 진동은 상쇄되어 줄어든다.
\[v_t = \mu \, v_{t-1} + \nabla_\theta \mathcal{L}, \qquad \theta \leftarrow \theta - \eta \, v_t\]여기서 \(\mu\)가 momentum(0.9), \(\eta\)가 학습률이다.
학습 함수는 에폭마다 'train'과 'val' 단계를 차례로 돌며, 훈련 단계에서만 역전파와 갱신을 한다.
import time
from tqdm import tqdm    # 진행 막대 표시

def train_model(model, dataloader_dict, criterion, optimizer, num_epoch):
    since = time.time()
    best_acc = 0.0
    for epoch in range(num_epoch):
        print('Epoch {}/{}'.format(epoch + 1, num_epoch))
        for phase in ['train', 'val']:
            model.train() if phase == 'train' else model.eval()
            epoch_loss, epoch_corrects = 0.0, 0

            for inputs, labels in tqdm(dataloader_dict[phase]):
                inputs, labels = inputs.to(device), labels.to(device)
                optimizer.zero_grad()
                # 훈련 단계에서만 계산 그래프를 만든다
                with torch.set_grad_enabled(phase == 'train'):
                    outputs = model(inputs)
                    _, preds = torch.max(outputs, 1)
                    loss = criterion(outputs, labels)
                    if phase == 'train':
                        loss.backward()
                        optimizer.step()
                    epoch_loss += loss.item() * inputs.size(0)   # 배치 평균 -> 배치 합
                    epoch_corrects += torch.sum(preds == labels.data)

            epoch_loss = epoch_loss / len(dataloader_dict[phase].dataset)
            epoch_acc = epoch_corrects.double() / len(dataloader_dict[phase].dataset)
            print('{} Loss: {:.4f} Acc: {:.4f}'.format(phase, epoch_loss, epoch_acc))
            if phase == 'val' and epoch_acc > best_acc:
                best_acc = epoch_acc
                best_model_wts = model.state_dict()
    time_elapsed = time.time() - since
    print('Training complete in {:.0f}m {:.0f}s'.format(time_elapsed // 60, time_elapsed % 60))
    print('Best val Acc: {:4f}'.format(best_acc))
    return model

model = train_model(model, dataloader_dict, criterion, optimizer, num_epoch=10)
loss.item() * inputs.size(0)를 하는 이유는 손실 함수의 reduction 기본값이 'mean'이어서 loss가 배치 평균이기 때문이다. 배치 크기를 곱해 합계로 되돌린 뒤 마지막에 전체 데이터 수로 나누면, 마지막 배치 크기가 달라도 정확한 에폭 평균이 된다.
Epoch 1/10
train Loss: 0.6971 Acc: 0.4875
val Loss: 0.7125 Acc: 0.4457
...
Epoch 10/10
train Loss: 0.6562 Acc: 0.5975
val Loss: 0.6507 Acc: 0.6304
Training complete in 4m 6s
Best val Acc: 0.641304
검증 정확도는 최고 약 64%로 높지 않다. 훈련 이미지가 400장뿐이기 때문이다.
테스트 데이터 예측
테스트 이미지는 한 장씩 검증용 전처리를 적용해 예측하고, “개일 확률”을 데이터 프레임에 모아 CSV로 저장한다.
import pandas as pd
import torch.nn.functional as F

id_list, pred_list = [], []
with torch.no_grad():                            # 추론에서는 기울기 계산이 필요 없다
    for test_path in tqdm(test_images_filepaths):
        img = Image.open(test_path)
        _id = test_path.split('/')[-1].split('.')[1]          # 'dog.113.jpg' -> '113'
        img = ImageTransform(size, mean, std)(img, phase='val')
        img = img.unsqueeze(0).to(device)        # (3, 224, 224) -> (1, 3, 224, 224)
        model.eval()
        outputs = model(img)
        preds = F.softmax(outputs, dim=1)[:, 1].tolist()      # 1번 클래스(dog)의 확률
        id_list.append(_id)
        pred_list.append(preds[0])

res = pd.DataFrame({'id': id_list, 'label': pred_list})
res.sort_values(by='id', inplace=True)
res.reset_index(drop=True, inplace=True)
res.to_csv('../chap06/data/LeNet', index=False)
unsqueeze(0)은 맨 앞에 크기 1인 배치 축을 끼워 넣는다. (2, 2) 텐서라면 위치 0, 1, 2에 넣을 때 각각 (1, 2, 2), (2, 1, 2), (2, 2, 1)이 된다.F.softmax(outputs, dim=1)은 각 행의 합이 1이 되게 하고,[:, 1]은 모든 행에서 두 번째 열(개일 확률)을 고른다.label이 0.5보다 크면 개, 작으면 고양이로 해석한다.
결과를 이미지와 함께 그리는 display_image_grid 함수는 cv2.imread로 읽은 BGR 이미지를 cv2.cvtColor(image, cv2.COLOR_BGR2RGB)로 바꿔 그린다. 책의 예측 그림에서도 적은 데이터로 학습한 탓에 오답이 많다.
6.1.2 AlexNet
AlexNet은 ImageNet 이미지 인식 대회 ILSVRC 2012에서 우승하며 딥러닝 붐을 연 CNN이다. CNN의 데이터는 너비, 높이, 깊이(채널) 의 3차원 구조를 가지며, 입력은 RGB 3채널로 시작하지만 합성곱층을 지날 때마다 필터 개수에 따라 깊이가 바뀐다. AlexNet 구조도의 숫자들은 이 3차원 크기를 나타낸다.
AlexNet은 합성곱층 5개와 완전연결층 3개로 이루어지며, 마지막 층은 1,000개 클래스에 소프트맥스를 적용한다. 당시 GPU 메모리 한계 때문에 네트워크를 GPU 두 대에 나눠 병렬로 학습시킨 점을 빼면 큰 틀은 LeNet-5와 같다. 활성화 함수로 ReLU를 쓴 것도 특징이다.
| 층 | 특성 맵 | 크기 | 커널 | 스트라이드 |
|---|---|---|---|---|
| 입력 | 3 | 227×227 | ||
| 합성곱 | 96 | 55×55 | 11×11 | 4 |
| 최대 풀링 | 96 | 27×27 | 3×3 | 2 |
| 합성곱 | 256 | 27×27 | 5×5 | 1 |
| 최대 풀링 | 256 | 13×13 | 3×3 | 2 |
| 합성곱 | 384 | 13×13 | 3×3 | 1 |
| 합성곱 | 384 | 13×13 | 3×3 | 1 |
| 합성곱 | 256 | 13×13 | 3×3 | 1 |
| 최대 풀링 | 256 | 6×6 | 3×3 | 2 |
| 완전연결 | 4096 | |||
| 완전연결 | 4096 | |||
| 완전연결(소프트맥스) | 1000 |
학습 가능한 파라미터는 약 6,000만 개다. 첫 합성곱층은 11×11×3 커널 96개를 스트라이드 4로 적용해 \((227 - 11)/4 + 1 = 55\), 즉 55×55×96을 출력한다. 원 논문에서는 첫 층을 학습한 뒤 한쪽 GPU의 커널은 주로 색과 무관한 모서리·방향 패턴을, 다른 쪽은 주로 색 정보를 담는 경향이 관찰되었다.
네트워크
데이터 준비는 LeNet과 같고, 이미지 크기만 256으로 키운다(작은 이미지를 넣으면 스트라이드 큰 층과 풀링을 거치며 너무 작아질 수 있다). 출력은 2개 클래스로 바꾼다.
class AlexNet(nn.Module):
    def __init__(self) -> None:
        super(AlexNet, self).__init__()
        self.features = nn.Sequential(
            nn.Conv2d(3, 64, kernel_size=11, stride=4, padding=2),
            nn.ReLU(inplace=True),               # 입력 텐서를 결과로 덮어써 메모리 절약
            nn.MaxPool2d(kernel_size=3, stride=2),
            nn.Conv2d(64, 192, kernel_size=5, padding=2),
            nn.ReLU(inplace=True),
            nn.MaxPool2d(kernel_size=3, stride=2),
            nn.Conv2d(192, 384, kernel_size=3, padding=1),
            nn.ReLU(inplace=True),
            nn.Conv2d(384, 256, kernel_size=3, padding=1),
            nn.ReLU(inplace=True),
            nn.Conv2d(256, 256, kernel_size=3, padding=1),
            nn.ReLU(inplace=True),
            nn.MaxPool2d(kernel_size=3, stride=2),
        )
        self.avgpool = nn.AdaptiveAvgPool2d((6, 6))   # 입력 크기와 상관없이 6x6으로
        self.classifier = nn.Sequential(
            nn.Dropout(),
            nn.Linear(256*6*6, 4096),
            nn.ReLU(inplace=True),
            nn.Dropout(),
            nn.Linear(4096, 512),
            nn.ReLU(inplace=True),
            nn.Linear(512, 2),
        )

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        x = self.features(x)
        x = self.avgpool(x)
        x = torch.flatten(x, 1)      # 배치 축(0)은 두고 나머지를 펼침
        x = self.classifier(x)
        return x
nn.AvgPool2d는 커널 크기 \(k\), 스트라이드 \(s\), 패딩 \(p\)를 정해 주면 출력 크기가 다음 식으로 결정된다.
반대로 nn.AdaptiveAvgPool2d 는 원하는 출력 크기만 지정하면 커널과 스트라이드를 입력 크기에 맞춰 알아서 정한다. 입력 해상도가 달라져도 완전연결층에 들어가는 크기가 항상 같으므로, 합성곱 부분 뒤에 완전연결층을 붙일 때 편리하다.
256×256 입력에 대한 요약은 다음과 같다. 첫 합성곱 출력은 \(\lfloor (256 + 4 - 11)/4 \rfloor + 1 = 63\)이다.
            Conv2d-1           [-1, 64, 63, 63]          23,296
         MaxPool2d-3           [-1, 64, 31, 31]               0
            Conv2d-4          [-1, 192, 31, 31]         307,392
         MaxPool2d-6          [-1, 192, 15, 15]               0
            Conv2d-7          [-1, 384, 15, 15]         663,936
            Conv2d-9          [-1, 256, 15, 15]         884,992
           Conv2d-11          [-1, 256, 15, 15]         590,080
        MaxPool2d-13            [-1, 256, 7, 7]               0
AdaptiveAvgPool2d-14            [-1, 256, 6, 6]               0
           Linear-16                 [-1, 4096]      37,752,832
           Linear-19                  [-1, 512]       2,097,664
           Linear-21                    [-1, 2]           1,026
================================================================
Total params: 42,321,218
옵티마이저(모멘텀 SGD), 학습 함수, 예측 코드는 LeNet과 같다.
Epoch 1/10
train Loss: 0.6929 Acc: 0.4950
val Loss: 0.6926 Acc: 0.5109
...
Epoch 10/10
train Loss: 0.6924 Acc: 0.5025
val Loss: 0.6924 Acc: 0.5109
Training complete in 6m 9s
손실이 \(\ln 2 \approx 0.693\) 근처에서 거의 움직이지 않는다. 이는 두 클래스에 확률을 반반씩 주는 상태, 즉 사실상 아무것도 배우지 못한 상태다. 파라미터가 4천만 개가 넘는 모델을 400장으로 처음부터 학습시키기에는 데이터가 턱없이 부족하다. 데이터를 늘리거나, 확장 기법(RandomRotation 등)을 더하거나, 5장의 전이 학습을 쓰는 것이 현실적인 대안이다.
6.1.3 VGGNet
VGGNet은 카렌 시모니안(Karen Simonyan)과 앤드루 지서먼(Andrew Zisserman)이 2015년 ICLR 논문 “Very Deep Convolutional Networks for Large-Scale Image Recognition”에서 발표했다. 연구의 초점은 네트워크 깊이가 성능에 미치는 영향이었고, 깊이 외의 변수를 없애기 위해 모든 합성곱 커널을 가장 작은 3×3으로 고정했다.
3×3 합성곱을 두 번 쌓으면 출력 한 칸이 입력의 5×5 영역을 보게 되고, 세 번 쌓으면 7×7 영역을 본다. 채널 수가 \(C\)로 같을 때 파라미터 수를 비교하면 3×3 두 층은 \(2 \cdot 9C^2 = 18C^2\), 5×5 한 층은 \(25C^2\)이다. 같은 범위를 보면서 파라미터는 더 적고, 층 사이마다 ReLU가 들어가 비선형성은 더 커진다. 이것이 작은 커널을 깊게 쌓는 VGG 설계의 핵심이다.
VGG16은 합성곱 13개와 완전연결 3개, 총 16개의 가중치 층으로 이루어지며 파라미터는 약 1억 3,800만 개다. 모든 합성곱은 3×3, 스트라이드 1, 패딩 1이라 크기를 유지하고, 크기 축소는 2×2 최대 풀링(스트라이드 2)만 담당한다. 마지막 층을 제외한 모든 층에 ReLU를 쓴다.
| 블록 | 구성 | 출력 크기 |
|---|---|---|
| 입력 | 224×224×3 | |
| 1 | 3×3 합성곱 64 ×2, 최대 풀링 | 112×112×64 |
| 2 | 3×3 합성곱 128 ×2, 최대 풀링 | 56×56×128 |
| 3 | 3×3 합성곱 256 ×3, 최대 풀링 | 28×28×256 |
| 4 | 3×3 합성곱 512 ×3, 최대 풀링 | 14×14×512 |
| 5 | 3×3 합성곱 512 ×3, 최대 풀링 | 7×7×512 |
| 분류기 | 완전연결 4096, 4096, 1000(소프트맥스) | 1000 |
설정 리스트로 VGG 만들기
예제는 가장 얕은 VGG11을 구현한다. 핵심은 층 구성을 리스트로 기술하고, 리스트를 읽어 층을 쌓는 함수를 따로 두는 것이다. 숫자는 그 개수만큼의 출력 채널을 갖는 3×3 합성곱, 'M'은 최대 풀링을 뜻한다.
vgg11_config = [64, 'M', 128, 'M', 256, 256, 'M', 512, 512, 'M', 512, 512, 'M']
vgg13_config = [64, 64, 'M', 128, 128, 'M', 256, 256, 'M', 512, 512, 'M', 512, 512, 'M']
vgg16_config = [64, 64, 'M', 128, 128, 'M', 256, 256, 256, 'M',
                512, 512, 512, 'M', 512, 512, 512, 'M']
vgg19_config = [64, 64, 'M', 128, 128, 'M', 256, 256, 256, 256, 'M',
                512, 512, 512, 512, 'M', 512, 512, 512, 512, 'M']

def get_vgg_layers(config, batch_norm):
    layers = []
    in_channels = 3
    for c in config:
        assert c == 'M' or isinstance(c, int)    # 'M' 또는 정수가 아니면 AssertionError
        if c == 'M':
            layers += [nn.MaxPool2d(kernel_size=2)]
        else:
            conv2d = nn.Conv2d(in_channels, c, kernel_size=3, padding=1)
            if batch_norm:
                layers += [conv2d, nn.BatchNorm2d(c), nn.ReLU(inplace=True)]
            else:
                layers += [conv2d, nn.ReLU(inplace=True)]
            in_channels = c                       # 이번 출력 채널이 다음 입력 채널
    return nn.Sequential(*layers)                 # 리스트를 풀어서 Sequential에 전달
VGG11, 13, 16, 19의 이름에 붙은 숫자는 가중치를 가진 층(합성곱 + 완전연결 3개)의 수다. 예를 들어 vgg11_config에는 숫자가 8개 있으므로 합성곱 8개에 완전연결 3개를 더해 11이 된다. 같은 방식으로 [64, 64, 64, 'M', 128, 128, 128, 'M'] 같은 나만의 구성도 쉽게 만들 수 있다.
assert 조건은 조건이 거짓이면AssertionError를 낸다. 잘못된 설정을 일찍 잡아내는 용도다.isinstance(값, 타입)은 값이 그 타입인지 판별한다.isinstance(1, int)는True,isinstance(1.2, int)는False다.
분류기는 별도 클래스에서 붙인다.
class VGG(nn.Module):
    def __init__(self, features, output_dim):
        super().__init__()
        self.features = features                    # get_vgg_layers가 만든 합성곱 부분
        self.avgpool = nn.AdaptiveAvgPool2d(7)
        self.classifier = nn.Sequential(
            nn.Linear(512*7*7, 4096),
            nn.ReLU(inplace=True),
            nn.Dropout(0.5),
            nn.Linear(4096, 4096),
            nn.ReLU(inplace=True),
            nn.Dropout(0.5),
            nn.Linear(4096, output_dim)
        )

    def forward(self, x):
        x = self.features(x)
        x = self.avgpool(x)
        h = x.view(x.shape[0], -1)     # 펼친 특성 벡터
        x = self.classifier(h)
        return x, h                    # 예측과 특성 벡터를 함께 반환

vgg11_layers = get_vgg_layers(vgg11_config, batch_norm=True)
model = VGG(vgg11_layers, output_dim=2)
이렇게 직접 만든 모델의 구조는 torchvision의 models.vgg11_bn(pretrained=True)와 같다(마지막 출력 수만 1000 대신 2). 실무에서는 대개 사전 훈련된 모델을 한 줄로 불러 쓰지만, 구조를 직접 구현해 보면 나중에 층을 바꾸거나 텐서 크기를 추적할 때 훨씬 수월하다.
데이터: ImageFolder와 random_split
import copy
import torchvision
import torch.utils.data as data

train_transforms = transforms.Compose([
    transforms.Resize((256, 256)),
    transforms.RandomRotation(5),               # -5도 ~ +5도 무작위 회전
    transforms.RandomHorizontalFlip(0.5),
    transforms.ToTensor(),
    transforms.Normalize(mean=[0.485, 0.456, 0.406], std=[0.229, 0.224, 0.225])])
test_transforms = transforms.Compose([
    transforms.Resize((256, 256)),
    transforms.ToTensor(),
    transforms.Normalize(mean=[0.485, 0.456, 0.406], std=[0.229, 0.224, 0.225])])

# train/Cat, train/Dog 처럼 클래스별 하위 폴더가 있는 구조
train_dataset = torchvision.datasets.ImageFolder('../chap06/data/catanddog/train', transform=train_transforms)
test_dataset = torchvision.datasets.ImageFolder('../chap06/data/catanddog/test', transform=test_transforms)

VALID_RATIO = 0.9
n_train_examples = int(len(train_dataset) * VALID_RATIO)
n_valid_examples = len(train_dataset) - n_train_examples
train_data, valid_data = data.random_split(train_dataset, [n_train_examples, n_valid_examples])

valid_data = copy.deepcopy(valid_data)          # 깊은 복사 후
valid_data.dataset.transform = test_transforms  # 검증 데이터에만 테스트용 전처리 적용
Number of training examples: 476
Number of validation examples: 53
Number of testing examples: 12
random_split이 돌려주는 두 Subset은 원본 데이터셋 하나를 공유하고 인덱스만 다르게 가진다. 그래서 valid_data.dataset.transform을 그냥 바꾸면 훈련 데이터의 전처리까지 바뀌어 버린다. copy.deepcopy로 원본 데이터셋까지 통째로 복제한 뒤 바꿔야 훈련 쪽이 영향을 받지 않는다.
파이썬의 복사 방식은 세 가지로 구분된다.
| 방식 | 코드 | 결과 |
|---|---|---|
| 대입 | b = a |
같은 객체를 가리킨다. b를 고치면 a도 바뀐다. |
| 얕은 복사 | copy.copy(a) |
바깥 컨테이너만 새로 만든다. 안쪽 리스트 같은 가변 객체는 공유한다. |
| 깊은 복사 | copy.deepcopy(a) |
안쪽 객체까지 모두 새로 만든다. 완전히 독립적이다. |
예를 들어 a = [[1, 2], 3]을 얕은 복사한 b에서 b[0].append(4)를 하면 a도 [[1, 2, 4], 3]이 되지만, 깊은 복사한 경우에는 a가 그대로다.
학습과 평가
정확도 계산, 훈련, 평가 함수를 따로 만든다.
def calculate_accuracy(y_pred, y):
    top_pred = y_pred.argmax(1, keepdim=True)          # 가장 큰 값의 인덱스, (N, 1)
    correct = top_pred.eq(y.view_as(top_pred)).sum()   # y를 top_pred와 같은 형태로 맞춰 비교
    return correct.float() / y.shape[0]

def train(model, iterator, optimizer, criterion, device):
    epoch_loss, epoch_acc = 0, 0
    model.train()
    for (x, y) in iterator:
        x, y = x.to(device), y.to(device)
        optimizer.zero_grad()
        y_pred, _ = model(x)             # VGG는 (예측, 특성)을 반환
        loss = criterion(y_pred, y)
        acc = calculate_accuracy(y_pred, y)
        loss.backward()
        optimizer.step()
        epoch_loss += loss.item()
        epoch_acc += acc.item()
    return epoch_loss / len(iterator), epoch_acc / len(iterator)

def evaluate(model, iterator, criterion, device):
    epoch_loss, epoch_acc = 0, 0
    model.eval()
    with torch.no_grad():
        for (x, y) in iterator:
            x, y = x.to(device), y.to(device)
            y_pred, _ = model(x)
            epoch_loss += criterion(y_pred, y).item()
            epoch_acc += calculate_accuracy(y_pred, y).item()
    return epoch_loss / len(iterator), epoch_acc / len(iterator)
학습 루프는 검증 손실이 가장 낮을 때의 가중치를 파일로 저장하는 패턴을 쓴다.
optimizer = optim.Adam(model.parameters(), lr=1e-7)
criterion = nn.CrossEntropyLoss()

EPOCHS = 5
best_valid_loss = float('inf')
for epoch in range(EPOCHS):
    start_time = time.monotonic()
    train_loss, train_acc = train(model, train_iterator, optimizer, criterion, device)
    valid_loss, valid_acc = evaluate(model, valid_iterator, criterion, device)
    if valid_loss < best_valid_loss:                 # 지금까지 가장 좋은 모델이면 저장
        best_valid_loss = valid_loss
        torch.save(model.state_dict(), '../chap06/data/VGG-model.pt')
    print(f'Epoch: {epoch+1:02} | Train Acc: {train_acc*100:.2f}% | Valid Acc: {valid_acc*100:.2f}%')

model.load_state_dict(torch.load('../chap06/data/VGG-model.pt'))
test_loss, test_acc = evaluate(model, test_iterator, criterion, device)
Epoch: 01 | Epoch Time: 8m 27s
	Train Loss: 0.691 | Train Acc: 54.48%
	 Valid. Loss: 0.693 | Valid. Acc: 52.83%
...
Epoch: 05 | Epoch Time: 7m 28s
	Train Loss: 0.700 | Train Acc: 51.52%
	 Valid. Loss: 0.693 | Valid. Acc: 47.17%
Test Loss: 0.693 | Test Acc: 50.00%
역시 손실이 \(\ln 2\)에 머물러 우연 수준이다. 데이터가 적은 것에 더해 학습률이 \(10^{-7}\)로 매우 작아서 5 에폭 동안 가중치가 거의 움직이지 않은 탓도 크다. 직접 실험한다면 학습률을 \(10^{-4}\) 정도로 키우거나, 사전 훈련된 vgg11_bn으로 시작하는 편이 낫다.
맞힌 예측 골라 보기
테스트 결과 중 정답을 맞힌 것만 골라 확신도(최대 확률)가 높은 순으로 정렬한다.
def get_predictions(model, iterator):
    model.eval()
    images, labels, probs = [], [], []
    with torch.no_grad():
        for (x, y) in iterator:
            y_pred, _ = model(x.to(device))
            images.append(x.cpu())
            labels.append(y.cpu())
            probs.append(F.softmax(y_pred, dim=-1).cpu())
    # 배치별 리스트를 dim=0(행 방향)으로 이어 붙여 하나의 텐서로
    return torch.cat(images, dim=0), torch.cat(labels, dim=0), torch.cat(probs, dim=0)

images, labels, probs = get_predictions(model, test_iterator)
pred_labels = torch.argmax(probs, 1)
corrects = torch.eq(labels, pred_labels)

correct_examples = []
for image, label, prob, correct in zip(images, labels, probs, corrects):
    if correct:
        correct_examples.append((image, label, prob))
# 각 샘플의 최대 확률을 기준으로 내림차순 정렬
correct_examples.sort(reverse=True, key=lambda x: torch.max(x[2], dim=0).values)
torch.cat([x, y], dim=0)은 행 방향으로,dim=1은 열 방향으로 이어 붙인다. (2, 3) 두 개를 붙이면 각각 (4, 3), (2, 6)이 된다.torch.max는 최댓값을,torch.argmax는 그 위치(인덱스)를 준다. 축을 지정하지 않은argmax는 텐서를 1차원으로 편 기준의 인덱스를 돌려준다.zip은 여러 시퀀스를 같은 위치끼리 튜플로 묶어 순회하게 한다.lambda x: ...는 이름 없는 한 줄 함수로, 여기서는 정렬 기준을 즉석에서 정의한다.
정규화된 텐서를 그대로 그리면 색이 왜곡되므로, 그리기 전에 값을 0~1 범위로 다시 펴 준다.
def normalize_image(image):
    image_min, image_max = image.min(), image.max()
    image.clamp_(min=image_min, max=image_max)
    image.add_(-image_min).div_(image_max - image_min + 1e-5)   # 최솟값 0, 최댓값 1로
    return image
이름 끝에 밑줄이 붙은 메서드(add_, div_, clamp_)는 새 텐서를 만들지 않고 기존 텐서를 제자리(in-place) 에서 수정한다. y = x.add(10)이면 x is y가 False지만, y = x.add_(10)이면 True다. 그리는 함수에서는 image.permute(1, 2, 0)으로 (C, H, W)를 (H, W, C)로 바꾼다. permute는 지정한 순서대로 축을 재배치한다.
6.1.4 GoogLeNet
GoogLeNet(Inception v1)은 주어진 연산 자원 안에서 신경망을 깊고 넓게 만들기 위해 설계된 모델이다. 망이 깊고 넓을수록 인식률은 좋아지지만, 파라미터가 늘어 과적합과 기울기 소멸이 생기고 학습과 추론도 느려진다. GoogLeNet은 이 문제를 인셉션 모듈(inception module) 로 풀었다.
인셉션 모듈은 같은 입력에 대해 네 갈래의 연산을 병렬로 수행하고, 결과를 채널 방향으로 이어 붙인다.
- 1×1 합성곱
- 1×1 합성곱 → 3×3 합성곱
- 1×1 합성곱 → 5×5 합성곱
- 3×3 최대 풀링 → 1×1 합성곱
커널 크기가 다른 갈래들이 서로 다른 크기의 패턴을 동시에 잡아낸다. 채널 방향으로 이어 붙이려면 모든 갈래의 출력 높이와 너비가 같아야 하므로, 3×3 최대 풀링도 이례적으로 스트라이드 1과 패딩을 써서 크기를 유지한다.
3×3, 5×5 앞에 놓인 1×1 합성곱이 연산량을 줄이는 열쇠다(5.1.3 참고). 예를 들어 192채널 입력에서 5×5 합성곱으로 32채널을 바로 만들면 가중치가 \(5 \cdot 5 \cdot 192 \cdot 32 = 153{,}600\)개 필요하다. 먼저 1×1 합성곱으로 16채널로 줄인 뒤 5×5를 적용하면 \(192 \cdot 16 + 5 \cdot 5 \cdot 16 \cdot 32 = 15{,}872\)개로 약 10분의 1이 된다.
이런 구조는 모든 노드를 빽빽하게 잇는 밀집 연결(dense connectivity) 대신, 관련성이 높은 부분끼리만 연결하는 희소 연결(sparse connectivity) 을 효율적인 밀집 연산들로 흉내 낸 것으로 볼 수 있다. 그 결과 GoogLeNet은 22층 깊이를 가지면서도 파라미터가 AlexNet보다 훨씬 적다.
6.1.5 ResNet
ResNet은 마이크로소프트 연구진이 “Deep Residual Learning for Image Recognition” 논문에서 발표한 모델로, 매우 깊은 신경망을 학습시키기 위해 레지듀얼(residual) 학습을 도입했다.
층을 쌓을수록 성능이 계속 좋아질 것 같지만 실제로는 그렇지 않다. 논문의 실험에서 56층 일반 CNN은 20층 CNN보다 훈련 오차조차 더 높았다. 과적합이 아니라 깊은 망 자체가 최적화하기 어려워지는 성능 저하(degradation) 문제다. 2014년의 GoogLeNet이 22층이었던 데 비해 ResNet은 152층까지 쌓는데, 이를 가능하게 한 것이 입력을 출력에 바로 더하는 숏컷(shortcut), 또는 스킵 연결(skip connection) 이다.
레지듀얼 블록과 아이덴티티 매핑
몇 개의 층이 학습해야 할 목표 함수를 \(H(x)\)라 하자. 레지듀얼 블록은 층들이 \(H(x)\)를 직접 배우게 하는 대신 차이(잔차) \(F(x) = H(x) - x\)를 배우게 하고, 입력 \(x\)를 그대로 더해 출력을 만든다.
\[y = F(x) + x\]입력을 손대지 않고 더하는 경로를 아이덴티티 매핑(identity mapping) 이라 한다. 이렇게 하면 두 가지 이점이 생긴다.
- 최적의 변환이 “거의 아무것도 하지 않는 것”이라면 \(F(x) \approx 0\)만 배우면 되므로, 층을 더 쌓아도 최소한 성능이 나빠지지는 않는다.
- 역전파 때 기울기가 \(\partial y / \partial x = \partial F / \partial x + 1\)로 전달되어, 덧셈 경로를 따라 기울기가 줄지 않고 앞쪽 층까지 흘러간다. 기울기 소멸이 크게 완화된다.
ResNet은 이런 레지듀얼 블록(residual block) 을 여러 개 쌓은 구조다. 큰 틀은 VGG처럼 3×3 합성곱을 깊게 쌓은 뼈대에 블록마다 숏컷을 추가한 형태라고 이해하면 된다.
기본 블록과 병목 블록
블록의 종류는 두 가지다.
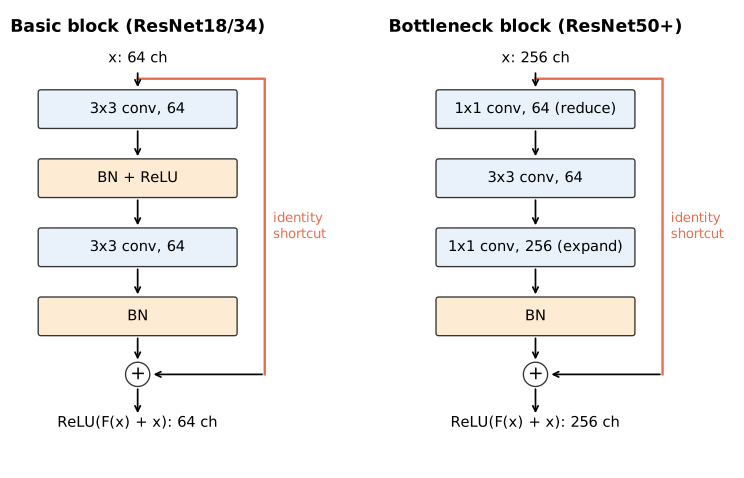 ResNet의 두 블록. 기본 블록은 3×3 합성곱 두 개, 병목 블록은 1×1(채널 축소) → 3×3 → 1×1(채널 확장) 세 개로 이루어지며, 둘 다 입력을 출력에 더하는 숏컷을 갖는다(병목 블록의 중간 BN, ReLU는 그림에서 생략).
- 기본 블록(basic block): 3×3 합성곱 두 개. ResNet18, ResNet34에서 쓴다.
- 병목 블록(bottleneck block): 1×1 → 3×3 → 1×1 합성곱. ResNet50, 101, 152에서 쓴다. 첫 1×1이 채널을 4분의 1로 줄이고, 3×3은 줄어든 채널에서 계산하며, 마지막 1×1이 다시 4배로 늘린다. 채널이 좁아지는 모양이 병목 같아서 붙은 이름이다.
층이 깊어질수록 파라미터가 계속 늘어나는 문제를 병목 블록이 완화한다. 256채널에서 비교하면 차이가 분명하다(편향 제외).
| 블록 | 계산 | 가중치 수 |
|---|---|---|
| 기본 블록 (3×3, 256 → 256 두 번) | \(2 \cdot (3 \cdot 3 \cdot 256 \cdot 256)\) | 1,179,648 |
| 병목 블록 (256 → 64 → 64 → 256) | \(256 \cdot 64 + 3 \cdot 3 \cdot 64 \cdot 64 + 64 \cdot 256\) | 69,632 |
층은 하나 더 많은데 파라미터는 약 17분의 1이다. 층이 늘어난 만큼 활성화 함수도 늘어 비선형성이 커지는 것도 장점이다.
다운샘플과 프로젝션 숏컷
\(F(x) + x\)를 계산하려면 두 텐서의 형태가 같아야 한다. 그런데 ResNet은 단계가 바뀔 때 첫 블록의 합성곱에 스트라이드 2를 써서 크기를 절반으로 줄이고 채널을 두 배로 늘린다. 예를 들어 (28, 28, 64)였던 특성 맵이 다음 단계에서 (14, 14, 128)이 되면 입력 \(x\)를 그대로 더할 수 없다.
이때 숏컷 쪽에 스트라이드 2인 1×1 합성곱(과 배치 정규화)을 넣어 \(x\)의 크기와 채널을 출력에 맞춘다. 이 과정을 다운샘플(downsample) 이라 한다. 입력과 출력 형태가 같아 그대로 더하는 블록을 아이덴티티 블록, 1×1 합성곱으로 형태를 맞춰 더하는 블록을 프로젝션 숏컷(projection shortcut) 또는 합성곱 블록이라 부른다.
블록 구현
class BasicBlock(nn.Module):
    expansion = 1                    # 출력 채널 = out_channels * 1

    def __init__(self, in_channels, out_channels, stride=1, downsample=False):
        super().__init__()
        self.conv1 = nn.Conv2d(in_channels, out_channels, kernel_size=3,
                               stride=stride, padding=1, bias=False)
        self.bn1 = nn.BatchNorm2d(out_channels)
        self.conv2 = nn.Conv2d(out_channels, out_channels, kernel_size=3,
                               stride=1, padding=1, bias=False)
        self.bn2 = nn.BatchNorm2d(out_channels)
        self.relu = nn.ReLU(inplace=True)
        if downsample:               # 숏컷의 형태를 출력에 맞추는 1x1 합성곱
            conv = nn.Conv2d(in_channels, out_channels, kernel_size=1, stride=stride, bias=False)
            bn = nn.BatchNorm2d(out_channels)
            downsample = nn.Sequential(conv, bn)
        else:
            downsample = None
        self.downsample = downsample

    def forward(self, x):
        i = x                                   # 숏컷용으로 입력 보관
        x = self.relu(self.bn1(self.conv1(x)))
        x = self.bn2(self.conv2(x))
        if self.downsample is not None:
            i = self.downsample(i)
        x += i                                  # 아이덴티티 매핑: F(x) + x
        x = self.relu(x)
        return x
class Bottleneck(nn.Module):
    expansion = 4                    # 출력 채널 = out_channels * 4

    def __init__(self, in_channels, out_channels, stride=1, downsample=False):
        super().__init__()
        self.conv1 = nn.Conv2d(in_channels, out_channels, kernel_size=1, stride=1, bias=False)    # 축소
        self.bn1 = nn.BatchNorm2d(out_channels)
        self.conv2 = nn.Conv2d(out_channels, out_channels, kernel_size=3, stride=stride,
                               padding=1, bias=False)
        self.bn2 = nn.BatchNorm2d(out_channels)
        self.conv3 = nn.Conv2d(out_channels, self.expansion*out_channels, kernel_size=1,
                               stride=1, bias=False)                                             # 확장
        self.bn3 = nn.BatchNorm2d(self.expansion*out_channels)
        self.relu = nn.ReLU(inplace=True)
        if downsample:
            conv = nn.Conv2d(in_channels, self.expansion*out_channels, kernel_size=1,
                             stride=stride, bias=False)
            downsample = nn.Sequential(conv, nn.BatchNorm2d(self.expansion*out_channels))
        else:
            downsample = None
        self.downsample = downsample

    def forward(self, x):
        i = x
        x = self.relu(self.bn1(self.conv1(x)))
        x = self.relu(self.bn2(self.conv2(x)))
        x = self.bn3(self.conv3(x))
        if self.downsample is not None:
            i = self.downsample(i)
        x += i
        x = self.relu(x)
        return x
합성곱 뒤에 배치 정규화가 오므로 합성곱의 편향은 의미가 없어 bias=False로 둔다. 책의 코드 일부에는 x += I(대문자)로 오타가 있는데, 위처럼 소문자 i여야 한다.
전체 네트워크
from collections import namedtuple

class ResNet(nn.Module):
    def __init__(self, config, output_dim, zero_init_residual=False):
        super().__init__()
        block, n_blocks, channels = config
        self.in_channels = channels[0]
        assert len(n_blocks) == len(channels) == 4

        self.conv1 = nn.Conv2d(3, self.in_channels, kernel_size=7, stride=2, padding=3, bias=False)
        self.bn1 = nn.BatchNorm2d(self.in_channels)
        self.relu = nn.ReLU(inplace=True)
        self.maxpool = nn.MaxPool2d(kernel_size=3, stride=2, padding=1)

        self.layer1 = self.get_resnet_layer(block, n_blocks[0], channels[0])
        self.layer2 = self.get_resnet_layer(block, n_blocks[1], channels[1], stride=2)
        self.layer3 = self.get_resnet_layer(block, n_blocks[2], channels[2], stride=2)
        self.layer4 = self.get_resnet_layer(block, n_blocks[3], channels[3], stride=2)
        self.avgpool = nn.AdaptiveAvgPool2d((1, 1))
        self.fc = nn.Linear(self.in_channels, output_dim)

        if zero_init_residual:     # 각 블록 마지막 BN의 가중치를 0으로 -> 처음엔 블록이 항등 함수처럼 동작
            for m in self.modules():
                if isinstance(m, Bottleneck):
                    nn.init.constant_(m.bn3.weight, 0)
                elif isinstance(m, BasicBlock):
                    nn.init.constant_(m.bn2.weight, 0)

    def get_resnet_layer(self, block, n_blocks, channels, stride=1):
        layers = []
        # 입력 채널과 블록 출력 채널이 다르면 첫 블록에 다운샘플 적용
        downsample = self.in_channels != block.expansion * channels
        layers.append(block(self.in_channels, channels, stride, downsample))
        for i in range(1, n_blocks):
            layers.append(block(block.expansion * channels, channels))
        self.in_channels = block.expansion * channels
        return nn.Sequential(*layers)

    def forward(self, x):            # 224x224 입력 기준 공간 크기
        x = self.relu(self.bn1(self.conv1(x)))   # 112x112
        x = self.maxpool(x)                      # 56x56
        x = self.layer1(x)                       # 56x56
        x = self.layer2(x)                       # 28x28
        x = self.layer3(x)                       # 14x14
        x = self.layer4(x)                       # 7x7
        x = self.avgpool(x)                      # 1x1
        h = x.view(x.shape[0], -1)
        x = self.fc(h)
        return x, h
- 첫 블록만
stride=2와 다운샘플을 받고, 나머지 블록은 형태를 유지한다. zero_init_residual은 각 레지듀얼 분기의 마지막 BN 스케일을 0으로 초기화해, 학습 초기에 모든 블록이 \(F(x) = 0\), 즉 항등 함수에 가깝게 시작하게 한다. 대규모 학습에서 정확도를 조금(0.2~0.3%p) 올리는 기법으로 보고되었다(Goyal et al., 2017).
모델의 변형은 블록 종류, 단계별 블록 수, 채널 수 세 가지로 정해지므로 네임드튜플(namedtuple) 로 묶는다. 네임드튜플은 튜플처럼 인덱스로도, config.block처럼 이름으로도 값에 접근할 수 있는 자료형이다.
ResNetConfig = namedtuple('ResNetConfig', ['block', 'n_blocks', 'channels'])

resnet18_config = ResNetConfig(block=BasicBlock, n_blocks=[2, 2, 2, 2], channels=[64, 128, 256, 512])
resnet34_config = ResNetConfig(block=BasicBlock, n_blocks=[3, 4, 6, 3], channels=[64, 128, 256, 512])
resnet50_config = ResNetConfig(block=Bottleneck, n_blocks=[3, 4, 6, 3], channels=[64, 128, 256, 512])
resnet101_config = ResNetConfig(block=Bottleneck, n_blocks=[3, 4, 23, 3], channels=[64, 128, 256, 512])
resnet152_config = ResNetConfig(block=Bottleneck, n_blocks=[3, 8, 36, 3], channels=[64, 128, 256, 512])

model = ResNet(resnet50_config, output_dim=2)
이름의 숫자는 가중치 층 수다. 예를 들어 ResNet50은 첫 합성곱 1개 + 병목 블록 \(3+4+6+3 = 16\)개 × 3층 + 완전연결 1개 = 50이다. ResNet34는 블록 구성이 같지만 기본 블록(2층)이라 \(1 + 16 \cdot 2 + 1 = 34\)가 된다. 이렇게 만든 ResNet50의 구조는 models.resnet50(pretrained=True)와 같고 마지막 fc만 Linear(2048, 2)로 다르다.
Top-k 정확도와 학습
def calculate_topk_accuracy(y_pred, y, k=2):
    with torch.no_grad():
        batch_size = y.shape[0]
        _, top_pred = y_pred.topk(k, 1)         # 점수 상위 k개 클래스 인덱스, (N, k)
        top_pred = top_pred.t()                 # (k, N)으로 전치
        correct = top_pred.eq(y.view(1, -1).expand_as(top_pred))   # 정답과 비교
        correct_1 = correct[:1].reshape(-1).float().sum(0, keepdim=True)   # 1순위에서 맞힌 수
        correct_k = correct[:k].reshape(-1).float().sum(0, keepdim=True)   # 상위 k개 안에서 맞힌 수
        return correct_1 / batch_size, correct_k / batch_size
topk(k, dim)은 상위 k개의 값과 인덱스를 준다.torch.topk(torch.arange(1., 6.), 3)이면 값[5, 4, 3], 인덱스[4, 3, 2]다.t()는 2차원 텐서의 두 축을 바꾼다(전치).torch.eq는 원소별 같음을,torch.ne는 다름을,torch.ge는 크거나 같음을 비교해 불리언 텐서를 돌려준다.- Top-1 정확도는 1순위 예측이 정답인 비율, Top-k 정확도는 상위 k개 안에 정답이 있는 비율이다. ImageNet처럼 클래스가 1,000개일 때는 Top-5 정확도도 함께 보고한다.
훈련·평가 함수와 루프는 VGG와 같은 구조이며, 정확도만 acc_1, acc_5 두 가지를 기록한다(옵티마이저는 Adam, 학습률 \(10^{-7}\)).
Epoch: 01 | Epoch Time: 4m 4s
	Train Loss: 0.698 | Train Acc @1:  50.24% | Train Acc @5: 100.00%
	Valid Loss: 0.699 | Valid Acc @1:  51.19% | Valid Acc @5: 100.00%
...
Epoch: 10 | Epoch Time: 4m 1s
	Train Loss: 0.690 | Train Acc @1:  57.69% | Train Acc @5: 100.00%
	Valid Loss: 0.693 | Valid Acc @1:  51.93% | Valid Acc @5: 100.00%
@5로 표시된 값은 실제로는 \(k=2\)인 Top-2 정확도다. 클래스가 2개뿐이라 상위 2개 안에는 항상 정답이 들어 있으므로 100%가 나오는 것은 당연하며, 의미 있는 지표는 Top-1이다. Top-1은 50% 남짓으로, VGG와 같은 이유(적은 데이터, 매우 작은 학습률)로 거의 학습되지 않았다.
이 절의 예제들은 성능보다 네트워크 구조를 익히는 것이 목적이다. 실제 과제에서는 구조를 이해한 상태에서 사전 훈련된 모델을 불러와 내 데이터에 맞게 전이 학습하는 것이 일반적이며, 무엇보다 학습할 데이터의 양과 질이 중요하다.
6.2 객체 인식을 위한 신경망
객체 인식(object detection) 은 이미지나 영상 속 여러 객체 각각이 무엇인지 분류하고, 어디 있는지를 바운딩 박스(bounding box) 로 표시하는 위치 검출(localization) 까지 수행하는 과제다.
객체 인식 = 여러 객체의 분류 + 각 객체의 위치 검출
딥러닝 기반 객체 인식 알고리즘은 두 갈래로 나뉜다.
| 구분 | 방식 | 특징 | 대표 모델 |
|---|---|---|---|
| 1단계(1-stage detector) | 분류와 위치 검출을 한 번에 수행 | 빠르지만 상대적으로 정확도가 낮다 | YOLO 계열, SSD 계열 |
| 2단계(2-stage detector) | 후보 영역을 먼저 찾고, 그다음 분류 | 느리지만 상대적으로 정확도가 높다 | R-CNN 계열 |
객체 인식은 자율 주행, CCTV, 무인 점포 등에서 널리 쓰인다. 이 절에서는 2단계 방식인 R-CNN 계열이 어떻게 발전했는지 살펴본다.
6.2.1 R-CNN
예전 객체 인식은 일정 크기의 창을 이미지 전체에 조금씩 옮겨 가며 검사하는 슬라이딩 윈도우(sliding window) 방식이었다. 객체가 없는 곳까지 모두 검사하므로 비효율적이어서, 지금은 객체가 있을 법한 영역만 먼저 골라내는 후보 영역(region proposal) 방식을 주로 쓴다.
R-CNN(Region-based CNN) 은 후보 영역 알고리즘과 CNN 분류기를 결합한 첫 모델이다.
- 이미지를 입력받는다.
- 선택적 탐색(selective search) 으로 후보 영역(바운딩 박스) 약 2,000개를 뽑고, 각 영역을 잘라 낸(crop) 뒤 CNN 입력 크기(227×227)로 강제로 맞춘다(warp).
- 2,000개 이미지 각각을 CNN에 통과시켜 특성을 뽑는다.
- 각 특성으로 클래스를 분류하고(원 논문에서는 SVM 사용) 박스 위치를 보정한다.
선택적 탐색은 이미지를 색, 질감, 모양 등이 비슷한 영역끼리 묶어 가며 후보 영역을 만든다.
- 초기 영역 생성(sub-segmentation): 이미지를 아주 잘게 여러 영역으로 나눈다. 객체 하나가 적어도 하나의 영역에 담기도록 과하게 분할한다.
- 작은 영역 통합: 가장 비슷한 이웃 영역 쌍을 하나로 합치는 일을 반복한다. 매번 당장 가장 좋아 보이는 선택을 하는 탐욕(greedy) 알고리즘이다.
- 후보 영역 생성: 합쳐지는 과정에서 나온 영역들을 감싸는 박스를 후보로 내놓는다.
이 과정은 크기와 비율이 제각각인 후보를 모두 고려하려는 완전 탐색(exhaustive search) 의 장점과, 이미지의 색·모양·무늬로 영역을 나누는 분할(segmentation) 의 장점을 결합한 것이다.
R-CNN은 정확도는 높았지만 단점이 뚜렷했다.
- 후보 추출, CNN 특성 추출, 분류기 학습이 따로 이루어지는 복잡한 다단계 학습
- 후보 2,000개마다 CNN을 돌리므로 긴 학습 시간과, 추출한 특성을 저장할 큰 공간
- 느린 검출 속도
6.2.2 공간 피라미드 풀링
R-CNN 같은 기존 CNN은 완전연결층의 입력 크기가 고정되어 있어서, 이미지를 정해진 크기로 자르거나(crop) 늘이고 줄여야(warp) 했다. 그러면 객체가 잘리거나 비율이 찌그러져 원래 모습이 훼손된다.
공간 피라미드 풀링(Spatial Pyramid Pooling, SPP) 은 이미지를 크기 그대로 합성곱층에 통과시킨 뒤, 완전연결층 직전에 출력 크기가 고정된 풀링을 놓아 이 문제를 해결한다. 특성 맵을 예를 들어 1×1, 2×2, 4×4 격자로 나눠 각 칸을 최대 풀링하면, 입력 특성 맵의 크기와 관계없이 채널당 \(1 + 4 + 16 = 21\)개의 값이 나온다. 여러 크기의 격자를 쓰므로 거친 전체 정보와 세밀한 위치 정보를 함께 담는다. 입력 크기를 강제로 바꾸지 않으므로 원본 특징이 보존되고, 분류와 객체 인식 모두에 적용할 수 있다.
6.2.3 Fast R-CNN
R-CNN의 가장 큰 병목은 후보 영역마다 CNN을 따로 돌리는 것이었다. Fast R-CNN 은 이미지 전체를 한 번만 CNN에 통과시켜 특성 맵을 얻고, 선택적 탐색으로 찾은 후보 영역을 그 특성 맵 위의 좌표로 옮겨 해당 부분만 잘라 쓴다. 잘라 낸 영역들은 크기가 제각각이므로 RoI 풀링(RoI pooling) 으로 같은 크기로 맞춘 뒤 완전연결층에 넣어 분류와 박스 회귀를 동시에 한다.
RoI 풀링은 SPP의 단일 격자 버전이다. 후보 영역을 원하는 출력 크기(예: 2×2)만큼의 칸으로 나누고 각 칸에서 최대 풀링을 한다. 영역 크기가 다르면 칸의 크기(풀링 창과 스트라이드)도 그에 맞춰 달라진다. 예를 들어 8×8 특성 맵 위의 7×5 후보 영역을 2×2로 만들려면, 한 방향은 3칸과 4칸, 다른 방향은 2칸과 3칸처럼 나눈 네 구역에서 각각 최댓값을 뽑는다. 어떤 크기의 영역이든 2×2 출력이 나온다.
6.2.4 Faster R-CNN
Fast R-CNN에서도 후보 영역을 찾는 선택적 탐색은 CPU에서 도는 별도 알고리즘이라 여전히 느렸다. Faster R-CNN 은 후보 영역 생성까지 신경망 안으로 가져와, 마지막 합성곱층 뒤에 후보 영역 추출 네트워크(Region Proposal Network, RPN) 를 붙였다. 이후 단계(RoI 풀링, 분류기, 바운딩 박스 회귀(bounding-box regression))는 Fast R-CNN과 같다. 특성 맵을 RPN과 분류기가 공유하므로 후보 추출 비용이 거의 사라지고, 전 과정을 GPU에서 처리한다.
RPN은 특성 맵 위를 작은 N×N 창(보통 3×3)으로 슬라이딩하며, 각 위치에서 두 가지를 예측하는 작은 네트워크다.
- 그 위치에 객체가 있는지 없는지(객체/배경 이진 분류)
- 객체가 있다면 박스 좌표를 얼마나 고쳐야 하는지(박스 회귀)
하지만 고정된 창 하나로는 크기와 비율이 다양한 객체를 다루기 어렵다. 그래서 위치마다 크기와 가로세로 비가 다른 기준 박스(reference box) \(k\)개를 미리 정해 두는데, 이를 앵커(anchor) 라 한다(원 논문은 크기 3종 × 비율 3종으로 \(k=9\)). RPN은 위치마다 앵커별로 객체/배경 점수 \(2k\)개와 박스 보정값(\(x, y, w, h\)) \(4k\)개를 출력한다. 특성 맵 크기가 \(w \times h\)라면 앵커는 모두 \(w \times h \times k\)개다.
6.3 이미지 분할을 위한 신경망
이미지 분할(image segmentation) 은 이미지를 픽셀 단위로 나누어 각 픽셀이 어느 객체(또는 클래스)에 속하는지 정하는 과제다. 분류가 이미지 전체에 레이블 하나를, 객체 인식이 박스 단위로 레이블을 붙인다면, 분할은 픽셀마다 레이블을 붙인다. 대표 네트워크로 완전 합성곱 네트워크, 합성곱 & 역합성곱 네트워크, U-Net, PSPNet, DeepLabv3/DeepLabv3+를 살펴본다.
6.3.1 완전 합성곱 네트워크
완전연결층에는 두 가지 한계가 있다. 입력 크기가 고정되어야 하고, 특성 맵을 1차원으로 펼치는 순간 위치 정보가 사라진다. 픽셀마다 답을 내야 하는 분할에서는 치명적이다.
완전 합성곱 네트워크(Fully Convolutional Network, FCN) 는 AlexNet, VGG16, GoogLeNet 같은 분류용 CNN의 완전연결층을 모두 1×1 합성곱으로 바꾼 네트워크다. 예를 들어 AlexNet 끝의 완전연결층 세 개를 1×1 합성곱으로 바꾸면 출력이 벡터가 아니라 공간 차원을 가진 맵이 된다. 클래스별로 “이 위치가 그 클래스일 점수”를 담은 히트맵(heatmap) 이 나오므로, 고양이 클래스의 히트맵을 보면 고양이가 이미지 어디에 있는지 알 수 있다. 모든 층이 합성곱이므로 입력 크기 제약도 사라진다.
6.3.2 합성곱 & 역합성곱 네트워크
FCN은 위치 정보를 보존하지만 단점도 있다.
- 합성곱과 풀링을 여러 번 거치면서 해상도가 크게 낮아진다.
- 낮아진 해상도를 단순한 업 샘플링(upsampling) 으로 한 번에 키우므로 세부 정보가 뭉개진다.
합성곱 & 역합성곱 네트워크(convolutional & deconvolutional network) 는 해상도를 줄이는 합성곱 부분 뒤에, 해상도를 단계적으로 되살리는 역합성곱(deconvolution) 부분을 대칭으로 붙여 이 문제를 줄인다. 최종 출력을 입력 이미지와 같은 크기로 만들 수 있어 픽셀마다 클래스를 정하는 시맨틱 분할(semantic segmentation) 등에 쓰인다.
합성곱이 특성 맵을 줄인다면, 역합성곱은 반대로 키운다. 동작은 다음과 같다.
- 입력 픽셀들 사이와 주위에 0을 채워(zero-padding) 넓게 벌린다.
- 그 위에 일반 합성곱을 수행한다.
결과적으로 입력보다 큰 출력이 나오며, 이때의 커널도 학습되므로 “학습 가능한 업 샘플링”이라 할 수 있다. PyTorch에서는 nn.ConvTranspose2d(전치 합성곱)로 구현한다.
x = torch.randn(1, 64, 14, 14)
up = nn.ConvTranspose2d(64, 32, kernel_size=2, stride=2)   # 학습 가능한 2배 업 샘플링
print(up(x).shape)    # torch.Size([1, 32, 28, 28])
6.3.3 U-Net
U-Net은 바이오메디컬 영상 분할을 위해 제안된 네트워크로, 의료 영상 분할에서 기준처럼 쓰인다. 특징은 두 가지다.
- 빠르다. 슬라이딩 윈도우 방식은 겹치는 패치(patch) 마다 같은 부분을 반복해 검사해서 느리다. U-Net은 이미 검사한 영역을 다시 계산하지 않고 이미지 전체를 한 번에 처리하므로 빠르다.
- 문맥과 지역화 사이의 트레이드오프를 완화한다. 큰 패치를 보면 넓은 범위의 컨텍스트(context) 를 잘 파악하지만 정확한 위치를 짚는 지역화(localization) 에는 약하고, 작은 패치는 반대다. U-Net은 두 정보를 모두 활용한다. 지역화란 객체의 위치 정보를 출력하는 것으로, 박스라면 보통 왼쪽 위와 오른쪽 아래 두 꼭짓점 좌표로 나타낸다.
U-Net은 FCN을 바탕으로 하며 이름처럼 U자 모양이다.
- 수축 경로(contracting path): 3×3 합성곱 두 개(사이에 드롭아웃)로 된 블록과 최대 풀링을 반복하며 해상도를 줄이고 채널을 늘린다. 이미지의 컨텍스트를 포착한다.
- 확장 경로(expansive path): 각 블록 앞에 업 샘플링 합성곱(up-conv)을 두어 해상도를 다시 키운다. 이때 수축 경로의 같은 단계 특성 맵을 이어 붙여(skip connection) 세밀한 위치 정보를 되살리고, 이를 바탕으로 정확한 지역화를 한다.
다운 샘플링과 업 샘플링을 차례로 거치며 크기가 다른 특성 맵들을 병합하므로, 크기가 다양한 객체를 분할할 수 있다.
6.3.4 PSPNet
PSPNet(Pyramid Scene Parsing Network) 은 CVPR 2017에서 발표된 시맨틱 분할 모델이다. 이미지 전체의 맥락(예: “물 위에 있으니 자동차가 아니라 배다”)을 활용하기 위해 피라미드 풀링 모듈(pyramid pooling module) 을 추가했다. 동작은 다음과 같다.
- 백본 CNN이 만든 특성 맵을 서로 다른 크기로 여러 번 풀링한다. 예를 들어 1×1, 2×2, 3×3, 6×6 출력이 되도록 풀링한다. 1×1은 이미지 전체를 요약한 가장 넓은 정보를, 6×6은 더 국소적인 정보를 담는다.
- 각 결과에 1×1 합성곱을 적용해 채널 수를 줄인다. 풀링 갈래가 \(N\)개면 각 갈래의 출력 채널 수를 입력 채널 수의 \(1/N\)로 맞춘다.
- 각 결과를 양선형 보간법(bilinear interpolation) 으로 원래 특성 맵 크기까지 업 샘플링한다.
- 원래 특성 맵과 업 샘플링한 맵들을 채널 방향으로 이어 붙인 뒤 최종 예측을 한다.
풀링 갈래의 수와 크기는 구현에 따라 다르게 정할 수 있다.
보간법(interpolation) 은 값이 없는 위치(예: 확대한 영상의 빈 화소)의 값을 주변 화소로부터 추정하는 방법이다. 선형 보간법(linear interpolation) 은 두 점 사이를 직선으로 이어 값을 정하고, 양선형 보간법은 이를 가로와 세로 두 방향으로 적용해 가장 가까운 네 화소의 가중 평균으로 값을 정한다.
네 꼭짓점의 값이 왼쪽 위 \(A\), 오른쪽 위 \(B\), 왼쪽 아래 \(C\), 오른쪽 아래 \(D\)인 사각형 안의 점 \(P\)를 생각하자. \(P\)에서 왼쪽 변까지 거리를 \(w_1\), 오른쪽 변까지 \(w_2\), 위쪽 변까지 \(h_1\), 아래쪽 변까지 \(h_2\)라 하고 \(a = w_1/(w_1 + w_2)\), \(b = h_1/(h_1 + h_2)\)로 두면 다음과 같다.
\[P = (1 - b)\left[ (1 - a) A + a B \right] + b \left[ (1 - a) C + a D \right]\]먼저 위쪽 변과 아래쪽 변에서 각각 가로 방향 선형 보간을 하고, 그 두 결과를 세로 방향으로 한 번 더 보간한 것이다(선형 보간 세 번). 가까운 꼭짓점일수록 큰 가중치를 받으며, 네 가중치의 합은 1이다.
6.3.5 DeepLabv3/DeepLabv3+
DeepLabv3/DeepLabv3+ 는 Atrous 합성곱(atrous convolution, 팽창 합성곱) 을 핵심으로 하는 분할 네트워크다. 인코더-디코더(encoder-decoder) 구조를 가지며, 보통의 인코더-디코더에서는 고정되어 있던 인코더 출력 특성 맵의 해상도를 Atrous 합성곱으로 조절할 수 있게 했다.
Atrous 합성곱은 커널 원소 사이에 빈칸을 두고 계산한다. 빈칸의 정도를 rate \(r\)로 정하며, \(r=1\)이면 일반 합성곱과 같고 \(r\)이 커질수록 커널이 더 넓게 퍼진다. 커널 크기가 \(k\)일 때 실제로 덮는 범위는 다음과 같다.
\[k_{\text{eff}} = k + (k - 1)(r - 1)\]3×3 커널에 \(r=2\)를 쓰면 5×5 범위를, \(r=3\)이면 7×7 범위를 보지만 가중치는 여전히 9개다.
분할에서 높은 성능을 내려면 수용 영역(receptive field), 즉 출력 한 칸이 입력에서 영향을 받는 범위가 넓어야 한다. 픽셀 하나의 클래스를 정하려면 주변을 넓게 봐야 하기 때문이다. 원래 수용 영역은 생물의 감각 뉴런이 자극 전체가 아니라 특정 영역에만 반응한다는 개념에서 왔다. 영상에서도 한 픽셀은 가까운 픽셀들과 관련이 크고 멀어질수록 관련이 약해지므로, 각 뉴런이 한정된 범위만 보도록 하는 것이 효율적이다.
일반 CNN은 수용 영역을 넓히기 위해 풀링과 스트라이드로 해상도를 계속 줄여, 출력이 입력의 1/32까지 작아진다. Atrous 합성곱을 쓰면 해상도를 줄이지 않고도 수용 영역을 넓힐 수 있으므로, 출력을 입력의 1/8 수준으로 유지할 수 있다. 같은 수용 영역에서 특성 맵의 가로·세로가 각각 4배 크게 보존되는 셈이다.
x = torch.randn(1, 64, 32, 32)
atrous = nn.Conv2d(64, 64, kernel_size=3, padding=2, dilation=2)   # rate 2: 5x5 범위, 가중치는 3x3
print(atrous(x).shape)    # torch.Size([1, 64, 32, 32]) 해상도 유지
정리
- LeNet-5는 합성곱과 풀링을 반복한 뒤 완전연결층으로 분류하는 CNN의 원형이다. 큰 특성 맵을 그대로 펼쳐 완전연결층에 넣으면 파라미터가 폭발한다는 점을 예제(약 4,600만 개 중
fc1이 대부분)에서 확인했다. - AlexNet은 ReLU와 GPU 병렬 학습으로 ILSVRC 2012에서 우승했고,
AdaptiveAvgPool2d는 입력 크기와 무관하게 분류기 입력 크기를 고정해 준다. - VGGNet은 3×3 합성곱만 깊게 쌓아 같은 수용 영역을 더 적은 파라미터와 더 큰 비선형성으로 얻으며, 설정 리스트와 층 생성 함수로 VGG11~19를 손쉽게 만들 수 있다.
- GoogLeNet의 인셉션 모듈은 1×1, 3×3, 5×5 합성곱과 풀링을 병렬로 수행해 이어 붙이고, 1×1 합성곱으로 채널을 줄여 연산량을 크게 낮춘다.
- ResNet은 \(y = F(x) + x\)의 숏컷으로 기울기 흐름을 보장해 152층까지 학습시키며, 병목 블록으로 깊이 대비 파라미터를 줄이고 형태가 다를 때는 1×1 합성곱 다운샘플로 숏컷을 맞춘다.
- 소량 데이터로 처음부터 학습한 예제들은 손실이 \(\ln 2\) 근처에 머물러 우연 수준이었다. 구조를 이해한 뒤 사전 훈련된 모델로 전이 학습하는 것이 실전적인 접근이다.
- 객체 인식은 R-CNN(후보마다 CNN) → SPP(크기 고정 풀링) → Fast R-CNN(CNN 한 번 + RoI 풀링) → Faster R-CNN(RPN과 앵커로 후보 생성까지 신경망 안에서) 순으로 빨라졌다.
- 이미지 분할은 FCN(완전연결층을 1×1 합성곱으로), 역합성곱(학습 가능한 업 샘플링), U-Net(수축·확장 경로와 스킵 연결), PSPNet(피라미드 풀링과 양선형 보간), DeepLab(Atrous 합성곱으로 해상도 유지)으로 발전했다.