8장은 모델의 성능을 끌어올리는 방법을 모은 장이다. 먼저 데이터·알고리즘·튜닝·앙상블이라는 큰 방향을 훑고, 하드웨어(GPU) 관점을 본 뒤, 하이퍼파라미터 수준의 세 가지 기법인 배치 정규화, 드롭아웃, 조기 종료 를 코드로 확인한다.
8.1 성능 최적화
성능을 높이는 방법은 크게 네 갈래로 정리할 수 있다.
8.1.1 데이터를 사용한 성능 최적화
가장 확실한 방법은 데이터를 늘리는 것이다. 전통적인 머신러닝 알고리즘은 데이터가 일정량을 넘으면 성능이 더 오르지 않는 경향이 있지만, 딥러닝은 데이터가 많을수록 계속 좋아지는 편이다.
- 데이터 수집: 가능한 한 많이 모은다.
- 데이터 생성: 더 모을 수 없다면 기존 데이터를 변형해 늘린다. 이미지라면 5장에서 본 회전, 뒤집기, 자르기 같은 증강(augmentation)을 쓴다.
- 값의 범위 조정: 활성화 함수의 출력 범위에 맞춘다. 시그모이드를 쓴다면 0~1, tanh를 쓴다면 -1~1로 맞추는 식이다. 정규화, 표준화, 규제화도 도움이 된다.
8.1.2 알고리즘을 이용한 성능 최적화
처음 고른 알고리즘이 최선이라는 보장은 없다. 같은 목적의 후보 여러 개를 학습시켜 비교한다. 분류라면 SVM, K-최근접 이웃 등을, 시계열이라면 7장의 RNN, LSTM, GRU를 모두 시험해 보는 식이다.
8.1.3 알고리즘 튜닝을 위한 성능 최적화
모델을 정한 뒤 하이퍼파라미터를 바꿔 가며 최적값을 찾는 단계로, 시간이 가장 많이 든다. 살펴볼 항목은 다음과 같다.
진단: 성능이 더 오르지 않으면 원인부터 찾는다. 훈련 성능과 검증 성능을 비교하는 것이 기본이다.
| 관찰 | 의심할 문제 | 대응 |
|---|---|---|
| 훈련 성능이 검증 성능보다 눈에 띄게 좋다 | 과적합(overfitting) | 규제화(드롭아웃 등) |
| 훈련과 검증 성능이 모두 나쁘다 | 과소적합(underfitting) | 네트워크를 키우거나 에폭을 늘림 |
| 어느 시점부터 검증 성능만 나빠진다 | 그 시점부터 과적합 | 조기 종료 |
가중치 초기화: 보통 작은 난수로 시작한다. 마땅한 초깃값을 정하기 어렵다면 오토인코더 같은 비지도 학습으로 먼저 사전 학습(pre-training)한 가중치에서 지도 학습을 시작하는 방법도 있다.
학습률: 네트워크 구성에 따라 적절한 값이 다르다. 아주 큰 값과 아주 작은 값을 먼저 시험해 보고, 결과를 보며 범위를 좁혀 간다.
활성화 함수: 바꿀 때는 신중해야 한다. 출력층의 활성화 함수와 손실 함수는 짝을 이루므로(예: 시그모이드와 이진 교차 엔트로피, 소프트맥스와 교차 엔트로피) 하나만 바꾸면 학습이 망가질 수 있다.
배치와 에폭: 큰 에폭과 작은 배치가 흔한 선택이지만, 배치 크기를 전체 데이터 크기로 하거나 1로 하는 극단까지 포함해 여러 값을 시험해 본다.
옵티마이저와 손실 함수: SGD가 기본이고, Adam이나 RMSProp도 좋은 성능을 보이는 경우가 많다. 역시 여러 조합을 비교해 고른다.
네트워크 구성(토폴로지, topology): 한 층에 뉴런을 많이 두는 넓은 네트워크, 뉴런을 줄이고 층을 늘리는 깊은 네트워크, 또는 둘의 조합을 비교한다.
8.1.4 앙상블을 이용한 성능 최적화
앙상블(ensemble) 은 모델 두 개 이상의 예측을 합쳐 쓰는 방법이다. 서로 다른 실수를 하는 모델을 섞으면 하나만 쓸 때보다 성능이 좋아지는 경우가 많다.
결국 성능 최적화는 하이퍼파라미터 조합을 수십, 수백 번 학습시켜 보는 시행착오의 과정이다. 한 번의 학습이 오래 걸리면 이 과정 전체가 느려지므로, 다음 절의 하드웨어가 중요해진다.
8.2 하드웨어를 이용한 성능 최적화
8.2.1 CPU와 GPU 사용의 차이
같은 딥러닝 작업에서 CPU 여러 개를 동시에 돌려도 GPU 하나를 이기지 못하는 경우가 흔하다. 두 장치는 설계 목적이 다르기 때문이다.
| CPU | GPU(Graphics Processing Unit) | |
|---|---|---|
| 구조 | 소수의 강력한 코어, 큰 캐시와 복잡한 제어(control) 장치 | 단순한 연산 장치(ALU)를 수백~수천 개 배치, 캐시와 제어 비중은 작음 |
| 강점 | 명령을 순서대로 빠르게 처리하는 직렬 처리, 분기가 많은 복잡한 로직 | 같은 연산을 많은 데이터에 동시에 적용하는 병렬 처리 |
| 코어 하나의 속도 | 빠름 | 느림 |
앞 단계의 결과가 있어야 다음 단계를 계산할 수 있는 순차적인 작업은 CPU가 유리하다. 반면 딥러닝의 핵심 연산인 행렬 곱셈과 역전파의 기울기 계산은 수많은 원소에 같은 연산을 독립적으로 적용하는 작업이라 병렬화가 잘 된다. 수백만 개의 데이터를 벡터로 바꿔 반복 계산하는 딥러닝에서 CPU만 쓰면 학습에 며칠에서 몇 달이 걸릴 수 있으므로, GPU는 사실상 필수다.
8.2.2 GPU를 이용한 성능 최적화
윈도에서 NVIDIA GPU로 PyTorch를 쓰려면 세 가지가 필요하다.
- CUDA(Compute Unified Device Architecture): NVIDIA가 만든 GPU 병렬 연산 플랫폼이자 개발 도구. 이것 덕분에 그래픽 전문가가 아니어도 GPU로 범용 계산을 할 수 있게 되었다.
- cuDNN: CUDA 위에서 돌아가는 딥러닝 기본 연산(합성곱, RNN 등) 라이브러리. PyTorch, TensorFlow 등이 내부적으로 사용한다.
- CUDA를 지원하는 PyTorch 빌드.
책의 설치 순서를 요약하면 다음과 같다.
- 환경 확인: 장치 관리자의 디스플레이 어댑터에서 NVIDIA 그래픽 카드가 있는지, 드라이버 버전이 무엇인지 확인한다. 드라이버 버전마다 쓸 수 있는 CUDA 툴킷 버전의 하한이 정해져 있다(예: CUDA 11.0은 윈도 드라이버 451.22 이상).
- CUDA 툴킷 설치: NVIDIA 툴킷 아카이브에서 GPU와 드라이버에 맞는 버전(책에서는 11.0)을 받아 설치한다. 설치 후 시스템 환경 변수에
CUDA_PATH가 등록되었는지 확인하고, 없으면 직접 추가한다. - cuDNN 설치: NVIDIA 개발자 계정으로 로그인해 설치한 CUDA 버전에 맞는 cuDNN(책에서는 8.0.5)을 받는다. 압축을 풀어 나온
bin,include,lib폴더의 내용을 CUDA 설치 경로(예:C:\Program Files\NVIDIA GPU Computing Toolkit\CUDA\v11.0)의 같은 이름 폴더에 복사한다. - 설치 확인: 명령 프롬프트에서
nvidia-smi를 실행하면 드라이버 버전, 지원 CUDA 버전, GPU 사용률과 메모리 사용량이 표시된다. - PyTorch 설치: pytorch.org의 설치 안내 페이지에서 Compute Platform을 CUDA로 고르고 나온 명령을 가상 환경에서 실행한다.
> nvidia-smi
| NVIDIA-SMI 456.38       Driver Version: 456.38       CUDA Version: 11.0 |
|   0  GeForce RTX 2060   WDDM | ...  |  2205MiB /  6144MiB |  46%  Default |

> conda install pytorch torchvision torchaudio cudatoolkit=11.3 -c pytorch
최근 PyTorch 배포판은 필요한 CUDA 런타임과 cuDNN을 패키지 안에 함께 담고 있어서, 대개 최신 NVIDIA 드라이버만 설치하고 pytorch.org의 명령으로 설치하면 된다. 별도의 툴킷 설치는 CUDA 코드를 직접 컴파일할 때 필요하다. 설치 후에는 torch.cuda.is_available()로 확인하고, 코드는 다음처럼 장치에 독립적으로 작성한다. 책의 예제는 CPU에서도 모두 돌아가며, 뒤로 갈수록 시간이 오래 걸릴 뿐이다.
device = torch.device("cuda:0" if torch.cuda.is_available() else "cpu")
8.3 하이퍼파라미터를 이용한 성능 최적화
이 절에서는 학습 과정 자체를 손보는 세 가지 기법인 배치 정규화, 드롭아웃, 조기 종료를 다룬다.
8.3.1 배치 정규화를 이용한 성능 최적화
배치 정규화에 앞서, 이름이 비슷해 헷갈리기 쉬운 세 용어를 구분해 둔다.
정규화(normalization): 값의 범위를 원하는 구간으로 맞추는 것이다. 특성마다 스케일을 맞춘다는 뜻에서 특성 스케일링(feature scaling) 이라고도 한다. 0~255인 픽셀 값을 255로 나눠 0~1로 만드는 것이 대표적인 예다. MinMaxScaler의 식은 다음과 같다.
규제화(regularization): 모델이 지나치게 복잡해지지 않도록 제약을 거는 방법이다. 학습 데이터의 세세한 잡음까지 외우지 못하게 막아 일반화 성능을 높인다. 드롭아웃과 조기 종료가 여기에 속한다(L1/L2 가중치 감쇠도 대표적인 규제화다).
표준화(standardization): 평균 0, 표준편차 1이 되도록 바꾸는 것이다. StandardScaler 또는 z-점수 정규화(z-score normalization) 라고도 하며, 값이 평균에서 표준편차 몇 배만큼 떨어져 있는지를 나타낸다. 데이터가 정규분포에 가까울 때 특히 유용하다.
배치 정규화(batch normalization) 는 2015년 Ioffe와 Szegedy의 논문 “Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shift”에서 제안된 기법으로, 표준화를 신경망 내부 의 각 층에 미니 배치 단위로 적용한다.
동기는 내부 공변량 변화(internal covariate shift) 다. 앞 층의 가중치가 학습으로 바뀌면 다음 층이 받는 입력의 분포도 계속 바뀐다. 층이 깊어질수록 이 변화가 누적되어, 뒤쪽 층은 매번 달라지는 입력에 적응하느라 학습이 불안정해지고 기울기 소멸이나 기울기 폭발도 생기기 쉽다.
- 기울기 소멸(vanishing gradient): 역전파 중에 기울기가 0에 가깝게 작아져 앞쪽 층이 학습되지 않는 현상
- 기울기 폭발(exploding gradient): 반대로 기울기가 급격히 커져 학습이 발산하는 현상
이런 문제에는 ReLU 같은 활성화 함수, 가중치 초기화, 학습률 조정으로도 대응하지만, 배치 정규화는 각 층의 입력 분포 자체를 안정시킨다. 크기 \(m\)인 미니 배치 \(\{x_1, \dots, x_m\}\)에 대해 다음 네 단계를 거친다.
-
미니 배치 평균
\[\mu_B = \frac{1}{m} \sum_{i=1}^{m} x_i\] -
미니 배치 분산
\[\sigma_B^2 = \frac{1}{m} \sum_{i=1}^{m} (x_i - \mu_B)^2\] -
정규화 (\(\epsilon\)은 0으로 나누는 것을 막는 작은 값)
\[\hat{x}_i = \frac{x_i - \mu_B}{\sqrt{\sigma_B^2 + \epsilon}}\] -
스케일과 이동
\[y_i = \gamma \hat{x}_i + \beta\]
4단계의 \(\gamma\)와 \(\beta\)는 학습되는 파라미터 다. 무조건 평균 0, 분산 1로 고정하면 층의 표현력이 제한될 수 있으므로, 필요하면 네트워크가 원래 분포 쪽으로 되돌릴 수 있게 여지를 남긴 것이다. 추론 때는 미니 배치 통계 대신 학습 중에 이동 평균으로 모아 둔 평균과 분산을 쓴다. 그래서 model.train()과 model.eval()을 반드시 구분해야 한다.
배치 정규화를 넣으면 각 층의 입력 분포가 일정하게 유지되어 더 큰 학습률로도 안정적으로, 빠르게 학습할 수 있다. 단점도 있다.
- 배치가 작으면 미니 배치 평균과 분산이 전체 분포를 잘 대표하지 못한다. 극단적으로 분산이 0이 되면 정규화가 제대로 되지 않는다.
- RNN처럼 시점마다 통계가 달라지는 구조에는 시점별로 따로 적용해야 해서 복잡하고 비효율적이다(이런 경우에는 층 정규화(layer normalization)가 흔히 쓰인다).
그래도 대부분의 경우 적용했을 때 성능이 좋아지므로 널리 쓰인다.
8.3.2 드롭아웃을 이용한 성능 최적화
과적합 은 훈련 데이터를 지나치게 학습한 상태다. 훈련 데이터는 실제 데이터 전체의 일부일 뿐이므로, 훈련을 계속하면 훈련 오류는 계속 줄지만 테스트 오류는 어느 시점부터 다시 늘어난다.
드롭아웃(dropout) 은 훈련할 때 은닉층의 노드 일부를 무작위로 꺼서(출력을 0으로 만들어) 학습하는 방법이다. 꺼지는 노드는 매 미니 배치마다 새로 고른다. 특정 노드나 노드 조합에 의존할 수 없게 되므로 네트워크가 더 견고한 특징을 배우고, 서로 다른 작은 네트워크 여러 개를 학습시켜 평균 내는 앙상블과 비슷한 효과도 난다. 대신 학습이 느려지고 더 많은 에폭이 필요하다.
평가할 때는 모든 노드를 사용한다. 이때 훈련과 평가에서 출력의 기댓값을 맞춰야 하는데, 원래 논문은 평가 시 가중치에 유지 비율 \((1-p)\)를 곱하는 방식을 썼다. PyTorch의 nn.Dropout(p)는 반대로 훈련 중에 살아남은 출력을 \(\frac{1}{1-p}\)배 키우는 역 드롭아웃(inverted dropout)을 쓰므로, 평가 모드(model.eval())에서는 아무것도 하지 않고 입력을 그대로 통과시킨다.
배치 정규화 비교 실험
배치 정규화의 효과부터 FashionMNIST(28×28 흑백 의류 이미지 10종)로 확인한다.
import torch, torchvision, numpy as np
import torch.nn as nn, torch.optim as optim
import torchvision.transforms as transforms
import matplotlib.pyplot as plt

trainset = torchvision.datasets.FashionMNIST(root='../chap08/data/', train=True,
                                             download=True, transform=transforms.ToTensor())
batch_size = 4
trainloader = torch.utils.data.DataLoader(trainset, batch_size=batch_size, shuffle=True)

images, labels = next(iter(trainloader))
print(images.shape, images[0].shape, labels[0].item())
torch.Size([4, 1, 28, 28]) torch.Size([1, 28, 28]) 9
이미지 텐서는 (배치, 채널, 높이, 너비) 순서다. 흑백이므로 채널은 1이다. 레이블 0~9는 차례로 T-Shirt/Top, Trouser, Pullover, Dress, Coat, Sandal, Shirt, Sneaker, Bag, Ankle Boot다.
몇 장을 그려 보려면 matplotlib이 기대하는 (높이, 너비, 채널) 순서로 축을 바꿔야 한다.
def imshow(img, title):
    plt.figure(figsize=(batch_size * 4, 4))
    plt.axis('off')
    plt.imshow(np.transpose(img, (1, 2, 0)))   # (C, H, W) -> (H, W, C)
    plt.title(title)
    plt.show()

def show_batch_images(dataloader):
    images, labels = next(iter(dataloader))
    img = torchvision.utils.make_grid(images)   # 배치 이미지를 한 장의 격자로
    imshow(img, title=[str(x.item()) for x in labels])
    return images, labels
배치 정규화가 없는 모델과 있는 모델을 같은 구조로 만든다.
class NormalNet(nn.Module):
    def __init__(self):
        super().__init__()
        self.classifier = nn.Sequential(
            nn.Linear(784, 48), nn.ReLU(),     # 28*28 = 784
            nn.Linear(48, 24), nn.ReLU(),
            nn.Linear(24, 10),                 # 10개 클래스
        )
    def forward(self, x):
        return self.classifier(x.view(x.size(0), -1))   # 이미지를 한 줄로 펼침

class BNNet(nn.Module):
    def __init__(self):
        super().__init__()
        self.classifier = nn.Sequential(
            nn.Linear(784, 48), nn.BatchNorm1d(48), nn.ReLU(),
            nn.Linear(48, 24), nn.BatchNorm1d(24), nn.ReLU(),
            nn.Linear(24, 10),
        )
    def forward(self, x):
        return self.classifier(x.view(x.size(0), -1))
nn.Sequential은 층을 순서대로 묶어forward를 간결하게 만든다.nn.BatchNorm1d(특성 수): 인자는 직전 층의 출력 크기다. 완전연결층 출력처럼(배치, 특성)모양에는BatchNorm1d, 합성곱 출력(배치, 채널, H, W)에는BatchNorm2d를 쓴다.- 위치는 이 예제처럼 선형(또는 합성곱) 층 다음, 활성화 함수 앞 이 일반적이다.
BNNet(
  (classifier): Sequential(
    (0): Linear(in_features=784, out_features=48, bias=True)
    (1): BatchNorm1d(48, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)
    (2): ReLU()
    ...
eps는 분모의 \(\epsilon\), affine=True는 \(\gamma, \beta\)를 학습한다는 뜻, track_running_stats=True는 추론용 이동 평균 통계를 모은다는 뜻이다.
배치 크기를 512로 키우고, 두 모델을 같은 배치로 나란히 학습시키며 손실을 기록한다.
batch_size = 512
trainloader = torch.utils.data.DataLoader(trainset, batch_size=batch_size, shuffle=True)

model, model_bn = NormalNet(), BNNet()
loss_fn = nn.CrossEntropyLoss()
opt = optim.SGD(model.parameters(), lr=0.01)
opt_bn = optim.SGD(model_bn.parameters(), lr=0.01)

loss_arr, loss_bn_arr = [], []
for epoch in range(2):
    for inputs, labels in trainloader:
        opt.zero_grad()                         # 배치 정규화 없는 모델
        loss = loss_fn(model(inputs), labels)
        loss.backward()
        opt.step()

        opt_bn.zero_grad()                      # 배치 정규화 모델
        loss_bn = loss_fn(model_bn(inputs), labels)
        loss_bn.backward()
        opt_bn.step()

        loss_arr.append(loss.item())
        loss_bn_arr.append(loss_bn.item())

plt.plot(loss_arr, 'yellow', label='Normal')
plt.plot(loss_bn_arr, 'blue', label='BatchNorm')
plt.legend()
plt.show()
두 모델 모두 손실이 줄지만, 배치 정규화 모델의 손실이 훨씬 빨리, 더 낮은 값으로 떨어지고 흔들림도 적다. 같은 학습률 0.01의 SGD에서 일반 모델은 손실이 천천히 내려가는 반면, 배치 정규화 모델은 초반부터 가파르게 수렴한다.
드롭아웃 비교 실험
드롭아웃은 과적합이 잘 드러나는 작은 회귀 문제로 확인한다. \(y = x + \text{잡음}\) 형태의 점 50개를 훈련용과 테스트용으로 각각 만든다.
N = 50
noise = 0.3
x_train = torch.unsqueeze(torch.linspace(-1, 1, N), 1)   # -1~1을 50등분, 모양 (50, 1)
y_train = x_train + noise * torch.normal(torch.zeros(N, 1), torch.ones(N, 1))
x_test = torch.unsqueeze(torch.linspace(-1, 1, N), 1)
y_test = x_test + noise * torch.normal(torch.zeros(N, 1), torch.ones(N, 1))
torch.linspace(start, end, steps): 구간을 같은 간격으로 나눈steps개의 값을 만든다.steps를 생략하면 예전 버전은 100개를 만들었지만 지금은 필수 인자다.torch.unsqueeze(t, 1): 1번 위치에 크기 1인 차원을 추가해(50,)을(50, 1)로 만든다. 선형층 입력 모양을 맞추기 위해서다.torch.normal(mean, std): 평균 텐서와 표준편차 텐서를 받아 원소별로 정규분포 난수를 뽑는다. 여기서는 표준정규분포 잡음에 0.3을 곱했다.
입력과 출력이 1차원이지만 은닉 유닛이 100개인 층을 두 개 쌓아, 데이터에 비해 일부러 크게 만든 모델이다. 하나는 그대로, 다른 하나는 각 은닉층 뒤에 드롭아웃 20%를 넣는다.
N_h = 100
model = torch.nn.Sequential(
    torch.nn.Linear(1, N_h), torch.nn.ReLU(),
    torch.nn.Linear(N_h, N_h), torch.nn.ReLU(),
    torch.nn.Linear(N_h, 1),
)
model_dropout = torch.nn.Sequential(
    torch.nn.Linear(1, N_h), torch.nn.Dropout(0.2), torch.nn.ReLU(),
    torch.nn.Linear(N_h, N_h), torch.nn.Dropout(0.2), torch.nn.ReLU(),
    torch.nn.Linear(N_h, 1),
)
opt = torch.optim.Adam(model.parameters(), lr=0.01)
opt_dropout = torch.optim.Adam(model_dropout.parameters(), lr=0.01)
loss_fn = torch.nn.MSELoss()
1000 에폭 동안 두 모델을 학습시키며, 50 에폭마다 평가 모드로 바꿔 테스트 손실을 재고 예측 곡선을 그린다.
for epoch in range(1000):
    loss = loss_fn(model(x_train), y_train)
    opt.zero_grad(); loss.backward(); opt.step()

    loss_dropout = loss_fn(model_dropout(x_train), y_train)
    opt_dropout.zero_grad(); loss_dropout.backward(); opt_dropout.step()

    if epoch % 50 == 0:
        model.eval(); model_dropout.eval()            # 드롭아웃 끄기
        test_pred = model(x_test)
        test_pred_dropout = model_dropout(x_test)
        test_loss = loss_fn(test_pred, y_test)
        test_loss_dropout = loss_fn(test_pred_dropout, y_test)

        plt.scatter(x_train.numpy(), y_train.numpy(), c='purple', alpha=0.5, label='train')
        plt.scatter(x_test.numpy(), y_test.numpy(), c='yellow', alpha=0.5, label='test')
        plt.plot(x_test.numpy(), test_pred.data.numpy(), 'b-', lw=3, label='normal')
        plt.plot(x_test.numpy(), test_pred_dropout.data.numpy(), 'g--', lw=3, label='dropout')
        plt.title('Epoch %d, Loss=%0.4f, Loss with dropout=%0.4f'
                  % (epoch, test_loss, test_loss_dropout))
        plt.legend()
        model.train(); model_dropout.train()          # 다시 학습 모드
        plt.pause(0.05)
plt.scatter의 c는 점 색, alpha는 투명도(1이면 불투명), label은 plt.legend()에 표시될 이름이다.
에폭이 진행될수록 드롭아웃이 없는 모델(파란 실선)은 훈련 점(보라색) 하나하나를 따라가려고 구불구불해진다. 훈련 데이터의 잡음까지 외우는 과적합이다. 드롭아웃 모델(초록 점선)은 직선에 가까운 매끄러운 곡선을 유지하고, 테스트 손실도 더 낮다. 두 곡선의 차이가 작아 보여도, 새 데이터에 대한 예측에서는 의미 있는 차이다.
8.3.3 조기 종료를 이용한 성능 최적화
조기 종료(early stopping) 는 검증 손실을 지켜보다가 더 이상 좋아지지 않으면 학습을 멈추는 규제 기법이다. 과적합이 시작되기 전에는 훈련 손실과 검증 손실이 함께 줄지만, 과적합이 시작되면 훈련 손실은 계속 줄고 검증 손실은 늘어난다. 그 전환점에서 멈추는 것이 목표다.
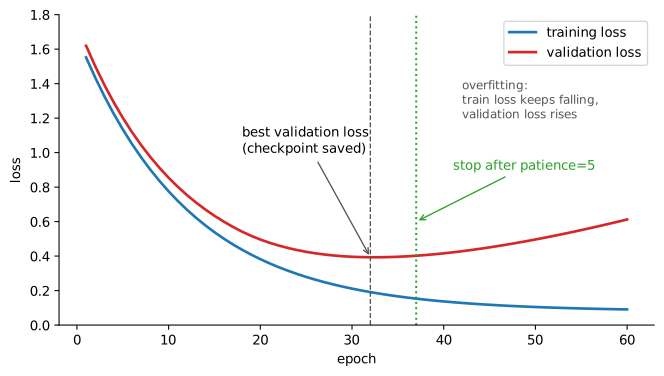 조기 종료의 원리를 보여 주는 개념도(임의의 곡선). 검증 손실이 가장 낮을 때 모델을 저장해 두고, 그 뒤로
patience번 연속 개선이 없으면 학습을 멈춘다.
검증 손실은 에폭마다 오르내리므로 한 번 나빠졌다고 바로 멈추지 않고 몇 에폭을 기다린다. 이 기다리는 횟수가 patience다. 또 조기 종료는 언제 멈출지만 정할 뿐, 그 시점의 모델이 최고라는 보장은 없다. 그래서 검증 손실이 가장 낮았던 시점의 가중치를 체크포인트로 저장해 두는 것이 일반적이다.
예제는 조기 종료와 함께 학습률 감소(learning rate decay) 도 다룬다. 사전 학습된 ResNet50으로 핫도그/핫도그 아님 이진 분류(Kaggle “Hot Dog - Not Hot Dog”, Food-101에서 추린 데이터)를 학습한다.
import torch, time, argparse
import torch.nn as nn, torch.optim as optim
import torchvision.models as models
from torchvision import transforms, datasets
import matplotlib, matplotlib.pyplot as plt
import numpy as np
from tqdm import tqdm

matplotlib.style.use('ggplot')
device = torch.device("cuda:0" if torch.cuda.is_available() else "cpu")

train_transform = transforms.Compose([
    transforms.Resize((224, 224)),
    transforms.RandomHorizontalFlip(),     # 훈련 데이터에만 증강
    transforms.RandomVerticalFlip(),
    transforms.ToTensor(),
    transforms.Normalize(mean=[0.485, 0.456, 0.406], std=[0.229, 0.224, 0.225]),  # ImageNet 통계
])
val_transform = transforms.Compose([
    transforms.Resize((224, 224)),
    transforms.ToTensor(),
    transforms.Normalize(mean=[0.485, 0.456, 0.406], std=[0.229, 0.224, 0.225]),
])

train_dataset = datasets.ImageFolder(root='../chap08/data/archive/train', transform=train_transform)
train_dataloader = torch.utils.data.DataLoader(train_dataset, batch_size=32, shuffle=True)
val_dataset = datasets.ImageFolder(root='../chap08/data/archive/test', transform=val_transform)
val_dataloader = torch.utils.data.DataLoader(val_dataset, batch_size=32, shuffle=False)
ImageFolder는 train/hot_dog, train/not_hot_dog처럼 클래스별 하위 폴더 이름을 레이블로 쓴다. 사전 학습 모델을 쓰므로 입력 크기 224×224와 정규화 통계를 ImageNet 학습 때와 맞춘다.
사전 학습 모델을 불러오는 함수는 다음과 같다. 6장의 전이 학습과 같은 방식이다.
def resnet50(pretrained=True, requires_grad=False):
    model = models.resnet50(progress=True, pretrained=pretrained)
    for param in model.parameters():
        param.requires_grad = requires_grad    # False면 특성 추출기를 고정
    model.fc = nn.Linear(2048, 2)              # 새 분류층은 항상 학습됨
    return model
학습률 스케줄러
학습률을 처음부터 끝까지 고정하지 않고, 학습이 정체되면 낮춰 주는 기법이다. PyTorch의 ReduceLROnPlateau는 지켜보는 값(여기서는 검증 손실)이 patience 에폭 동안 나아지지 않으면 학습률에 factor를 곱한다.
class LRScheduler():
    def __init__(self, optimizer, patience=5, min_lr=1e-6, factor=0.5):
        self.lr_scheduler = torch.optim.lr_scheduler.ReduceLROnPlateau(
            optimizer,
            mode='min',          # 지켜보는 값이 작을수록 좋음 (손실)
            patience=patience,   # 개선 없이 기다릴 에폭 수
            factor=factor,       # 새 학습률 = 기존 학습률 * factor
            min_lr=min_lr,       # 학습률의 하한
            verbose=True,
        )

    def __call__(self, val_loss):
        self.lr_scheduler.step(val_loss)   # 에폭마다 검증 손실을 넘겨 판단
mode: 정확도처럼 클수록 좋은 값을 지켜본다면'max'를 쓴다.factor=0.5: 학습률이 0.01이었다면 조건을 만족할 때 0.005가 된다.min_lr: 아무리 줄여도 이 값 아래로는 내려가지 않는다.verbose: 학습률을 바꿀 때 메시지를 출력한다(최신 버전에서는 이 인자가 사라지는 중이며,get_last_lr()로 확인한다).
이처럼 사용자가 직접 부르지 않고, 조건이 되면 학습 루프 안에서 실행되도록 등록해 두는 함수를 흔히 콜백(callback) 이라고 부른다.
조기 종료 클래스
PyTorch에는 케라스의 EarlyStopping 콜백 같은 기능이 내장되어 있지 않아 직접 만든다.
class EarlyStopping():
    def __init__(self, patience=5, verbose=False, delta=0, path='../chap08/data/checkpoint.pt'):
        self.patience = patience        # 개선 없이 기다릴 에폭 수
        self.verbose = verbose
        self.counter = 0                # 연속으로 개선이 없었던 횟수
        self.best_score = None
        self.early_stop = False
        self.val_loss_min = np.inf
        self.delta = delta              # 이만큼 이상 좋아져야 개선으로 인정
        self.path = path

    def __call__(self, val_loss, model):
        score = -val_loss               # 손실은 작을수록 좋으므로 부호를 뒤집어 '점수'로
        if self.best_score is None:     # 첫 에폭
            self.best_score = score
            self.save_checkpoint(val_loss, model)
        elif score < self.best_score + self.delta:   # 충분히 개선되지 않음
            self.counter += 1
            print(f'EarlyStopping counter: {self.counter} out of {self.patience}')
            if self.counter >= self.patience:
                self.early_stop = True
        else:                           # 개선됨: 기록 갱신, 저장, 카운터 초기화
            self.best_score = score
            self.save_checkpoint(val_loss, model)
            self.counter = 0

    def save_checkpoint(self, val_loss, model):
        if self.verbose:
            print(f'Validation loss decreased ({self.val_loss_min:.6f} --> {val_loss:.6f}).')
        torch.save(model.state_dict(), self.path)   # 가장 좋은 시점의 가중치 저장
        self.val_loss_min = val_loss
로직은 단순하다. 검증 손실이 최고 기록보다 delta 이상 좋아지면 기록을 갱신하고 저장한 뒤 카운터를 0으로 되돌린다. 그렇지 않으면 카운터를 올리고, patience에 도달하면 early_stop 플래그를 세운다. (책의 np.Inf는 NumPy 2.0에서 제거되었으므로 np.inf를 쓴다.)
케라스에서는 같은 기능을 콜백으로 제공한다.
from keras.callbacks import ModelCheckpoint, EarlyStopping
checkpoint = ModelCheckpoint('checkpoint.h5', monitor='val_loss', save_best_only=True, verbose=1)
earlystopping = EarlyStopping(monitor='val_loss', patience=10)
명령행 인자로 기법 선택하기
같은 스크립트로 세 가지 경우(아무것도 안 씀, 학습률 스케줄러, 조기 종료)를 비교하기 위해 argparse로 옵션을 받는다.
parser = argparse.ArgumentParser()
parser.add_argument('--lr-scheduler', dest='lr_scheduler', action='store_true')
parser.add_argument('--early-stopping', dest='early_stopping', action='store_true')
args = vars(parser.parse_args())     # {'lr_scheduler': bool, 'early_stopping': bool}
- 첫 인자는 명령행에서 쓸 옵션 이름이고,
dest는 값이 저장될 키 이름이다. action='store_true': 옵션을 붙이면True, 안 붙이면False가 된다.
이 예제는 주피터에서 셀을 실행하는 대신 .py 파일(es-python_8장.py)로 저장해 python es-python_8장.py --lr-scheduler처럼 실행한다.
모델과 학습 설정은 다음과 같다. 책은 앞의 resnet50() 함수 대신 models.resnet50(pretrained=True)를 그대로 써서, 2048→1000의 원래 분류층을 둔 채 모든 파라미터를 학습시킨다.
model = models.resnet50(pretrained=True).to(device)
total_params = sum(p.numel() for p in model.parameters())
total_trainable_params = sum(p.numel() for p in model.parameters() if p.requires_grad)
print(f"{total_params:,} total parameters.")
print(f"{total_trainable_params:,} training parameters.")

lr, epochs = 0.001, 100
optimizer = optim.Adam(model.parameters(), lr=lr)
criterion = nn.CrossEntropyLoss()

loss_plot_name, acc_plot_name, model_name = 'loss', 'accuracy', 'model'
if args['lr_scheduler']:
    lr_scheduler = LRScheduler(optimizer)
    loss_plot_name, acc_plot_name, model_name = 'lrs_loss', 'lrs_accuracy', 'lrs_model'
if args['early_stopping']:
    early_stopping = EarlyStopping()
    loss_plot_name, acc_plot_name, model_name = 'es_loss', 'es_accuracy', 'es_model'
25,557,032 total parameters.
25,557,032 training parameters.
p.numel()은 텐서의 원소 개수다. 1000 클래스 출력층이 남아 있어도 정답 레이블이 0, 1뿐이므로 학습은 되지만, 두 클래스 문제라면 앞의 resnet50() 함수처럼 출력층을 nn.Linear(2048, 2)로 바꾸는 편이 맞다.
훈련 함수와 검증 함수는 한 에폭의 평균 손실과 정확도(%)를 돌려준다. tqdm은 반복 진행률 막대를 표시한다.
def training(model, train_dataloader, train_dataset, optimizer, criterion):
    model.train()
    running_loss, running_correct, counter, total = 0.0, 0, 0, 0
    for i, (data, target) in tqdm(enumerate(train_dataloader)):
        counter += 1
        data, target = data.to(device), target.to(device)
        total += target.size(0)
        optimizer.zero_grad()
        outputs = model(data)
        loss = criterion(outputs, target)
        running_loss += loss.item()
        running_correct += (outputs.argmax(1) == target).sum().item()
        loss.backward()
        optimizer.step()
    return running_loss / counter, 100. * running_correct / total

# validate()는 model.eval()과 torch.no_grad() 아래에서 같은 계산을 하되 역전파하지 않는다.
학습 루프에서 옵션에 따라 스케줄러나 조기 종료를 호출한다.
for epoch in range(epochs):
    train_epoch_loss, train_epoch_accuracy = training(model, train_dataloader, train_dataset, optimizer, criterion)
    val_epoch_loss, val_epoch_accuracy = validate(model, val_dataloader, val_dataset, criterion)

    if args['lr_scheduler']:
        lr_scheduler(val_epoch_loss)          # 정체되면 학습률 절반
    if args['early_stopping']:
        early_stopping(val_epoch_loss, model)
        if early_stopping.early_stop:
            break                             # 학습 종료
학습이 끝나면 훈련·검증 정확도 곡선과 손실 곡선을 그려 저장하고, torch.save(model.state_dict(), ...)로 모델을 저장한다.
세 가지 경우의 결과
책은 CPU로 실행했기 때문에 100 에폭에 약 10시간이 걸렸다. GPU(또는 코랩의 GPU 런타임)를 쓰면 크게 줄어든다.
아무 옵션 없이 실행
Epoch 1 of 100 ... Train Loss: 2.2272, Train Acc: 58.84 / Val Loss: 7.0938, Val Acc: 43.60
Epoch 2 of 100 ... Train Loss: 0.5848, Train Acc: 71.69 / Val Loss: 2.0658, Val Acc: 54.80
...
Epoch 99 of 100 ... Train Loss: 0.1609, Train Acc: 94.38 / Val Loss: 1.9502, Val Acc: 68.40
Epoch 100 of 100 ... Train Loss: 0.0995, Train Acc: 96.59 / Val Loss: 1.5691, Val Acc: 72.00
Training time: 618.836 minutes
훈련 정확도는 96% 이상인데 검증 정확도는 68~80% 사이를 10%p 넘게 오르내린다. 손실 곡선에서는 10 에폭 무렵부터 검증 손실이 조금씩 오르는 추세가 보인다. 과적합이 시작되었고, 계속 학습하려면 학습률을 낮춰야 한다는 신호다.
--lr-scheduler로 실행
Epoch 1 of 100 ... Val Loss: 6.2706, Val Acc: 37.80
...
Epoch 97 of 100 ... Train Loss: 0.0017, Train Acc: 100.00 / Val Loss: 0.5876, Val Acc: 83.40
Epoch 100 of 100 ... Train Loss: 0.0023, Train Acc: 100.00 / Val Loss: 0.5959, Val Acc: 83.60
Training time: 589.638 minutes
정확도 곡선이 완만해지고, 최종 검증 정확도가 83~84%로 높아졌으며, 검증 손실이 오르는 현상도 사라졌다. 학습률 스케줄러가 효과를 냈다. 다만 검증 손실은 20 에폭 무렵부터 거의 정체되므로, 30 에폭 정도만 학습해도 비슷한 결과를 얻을 수 있다고 추정할 수 있다.
--early-stopping으로 실행
Epoch 4 of 100 ... Train Loss: 0.5004, Train Acc: 79.92 / Val Loss: 0.5125, Val Acc: 77.40
Epoch 5 of 100 ... EarlyStopping counter: 1 out of 5 ... Val Loss: 0.6830, Val Acc: 72.20
Epoch 6 of 100 ... EarlyStopping counter: 2 out of 5 ... Val Loss: 0.7071, Val Acc: 70.40
Epoch 7 of 100 ... EarlyStopping counter: 3 out of 5 ... Val Loss: 0.5996, Val Acc: 74.80
Epoch 8 of 100 ... EarlyStopping counter: 4 out of 5 ... Val Loss: 1.4061, Val Acc: 58.00
Epoch 9 of 100 ... EarlyStopping counter: 5 out of 5
Training time: 55.807 minutes
4 에폭의 검증 손실 0.5125가 최저였고, 이후 5 에폭 연속으로 이를 넘지 못해 9 에폭에서 멈췄다. 저장된 체크포인트는 4 에폭 시점의 모델이다. 학습 시간은 10시간에서 1시간 미만으로 줄었다.
이 결과에서 읽어 낼 점은 다음과 같다.
- 조기 종료가 항상 성능을 높여 주지는 않는다. 여기서는
patience=5가 너무 짧아, 검증 손실이 원래 크게 출렁이는 초반에 학습이 끝났다. 정확도만 보면 조기 종료 쪽이 낮지만, 검증 손실 자체는 낮은 지점을 잡았다. - 조기 종료는 성능 향상보다 계산 자원과 시간을 아끼는 장치 로 보는 편이 정확하다.
- 어떤 기법이든 일괄 적용하기보다 학습 곡선을 읽고 상황에 맞는 기법을 고르는 것이 중요하다. 이 데이터에서는 학습률 스케줄러가 가장 효과적이었고, 스케줄러와 충분히 긴
patience의 조기 종료를 함께 쓰는 구성도 흔하다.
정리
- 성능 최적화의 큰 방향은 데이터(수집·증강·스케일 조정), 알고리즘 선택, 하이퍼파라미터 튜닝, 앙상블이다. 튜닝은 훈련·검증 성능 비교로 과적합인지 과소적합인지 진단하는 데서 출발한다.
- GPU는 단순한 연산 장치를 대량으로 두어 행렬 연산과 역전파 같은 병렬 계산에 강하다. PyTorch에서는 CUDA 지원 빌드를 설치하고
torch.device("cuda" if torch.cuda.is_available() else "cpu")로 장치 독립 코드를 쓴다. - 정규화는 값의 범위를 맞추고(\(\frac{x - x_{\min}}{x_{\max} - x_{\min}}\)), 표준화는 평균 0·표준편차 1로 바꾸며(\(\frac{x - \mu}{\sigma}\)), 규제화는 모델 복잡도에 제약을 건다.
- 배치 정규화는 각 층의 입력을 미니 배치 평균과 분산으로 표준화한 뒤 학습 가능한 \(\gamma, \beta\)로 다시 조정한다. 학습이 빨라지고 안정되지만 작은 배치와 RNN에는 잘 맞지 않는다.
nn.BatchNorm1d는 보통 선형층과 활성화 함수 사이에 둔다. - 드롭아웃은 훈련 중 노드를 무작위로 꺼 과적합을 줄인다. PyTorch는 훈련 때 살아남은 출력을 \(\frac{1}{1-p}\)배 키우고 평가 때는 그대로 통과시키므로
model.train()/model.eval()전환이 필수다. ReduceLROnPlateau는 검증 손실이patience동안 정체되면 학습률에factor를 곱한다. 예제에서 검증 정확도를 72%에서 약 84%로 끌어올렸다.- 조기 종료는 검증 손실이
patience에폭 연속 개선되지 않으면 학습을 멈추고, 최저 손실 시점의 가중치를 체크포인트로 남긴다. 성능보다 자원 절약의 성격이 강하며patience가 너무 짧으면 학습이 덜 된 채 끝난다.