Abstract
Test-time prompt tuning (TPT)은 label이 없는 각 테스트 이미지에 대해 entropy minimization으로 CLIP의 prompt를 adaptation한다. Accuracy는 오르지만 예측이 overconfident하게 된다. 기존의 두 해결책은 class text feature에 regularization 항을 추가한다. C-TPT는 feature들을 centroid로부터 L2 distance 기준으로 멀어지게 한다(ATFD). O-TPT는 pairwise cosine similarity 행렬을 identity matrix 쪽으로 밀어 feature들이 orthogonal하도록 만든다. 저자들은 둘 중 어느 것도 hypersphere 위에서 feature가 고르게 퍼지는 것을 보장하지 않는다고 주장한다. ATFD는 일부 feature가 뭉쳐 있는 채로 centroid만 옮길 수 있다. Orthogonality는 클래스 수 \(N\)이 embedding 차원 \(\lvert D \rvert\)보다 크면 달성할 수 없고(예: CLIP ViT-B/16의 512차원 공간에 ImageNet 1000개 클래스), \(N < \lvert D \rvert\)인 경우에도 각도를 균일하게 만들지는 않는다.
A-TPT는 Tammes problem(구 위에 점들을 배치해 임의의 두 점 사이의 최소 거리를 최대한 크게 만드는 문제)의 아이디어를 빌려 온다. 각 클래스에 대해 가장 가까운 다른 class feature와의 각도를 최대화하는 loss를 추가한다. 이 loss는 \(N > \lvert D \rvert\)와 \(N < \lvert D \rvert\) 두 경우 모두에서 feature를 균일하게 퍼뜨리며, 비슷한 비용으로 C-TPT와 O-TPT보다 ECE를 더 낮춘다.
Motivation
논문의 출발 질문은 accuracy가 거의 같은 prompt들이 왜 calibration은 크게 다를 수 있는가이다. 저자들은 C-TPT를 따라 Caltech101에서 CLIP RN50으로 80개 hard prompt template을 비교하고, 같은 accuracy 구간 안의 prompt들끼리 본다. ECE가 낮은 prompt는 class text feature도 넓게 퍼져 있다. 아래 t-SNE에서 calibration이 나쁜 template “the nearest shape in this image is [class]”(ECE 10.84)는 class와 관계없이 가운데에 촘촘한 덩어리로 모이고, calibration이 좋은 template들은 각자의 class cluster 옆에 놓인다. 일반 TPT도 같은 종류의 가운데 덩어리를 만든다. A-TPT를 더하고 \(\lambda\)를 키우면 이 덩어리가 풀리며, AD는 0.659까지 오르고 ECE는 6.18에서 2.12로 떨어진다.
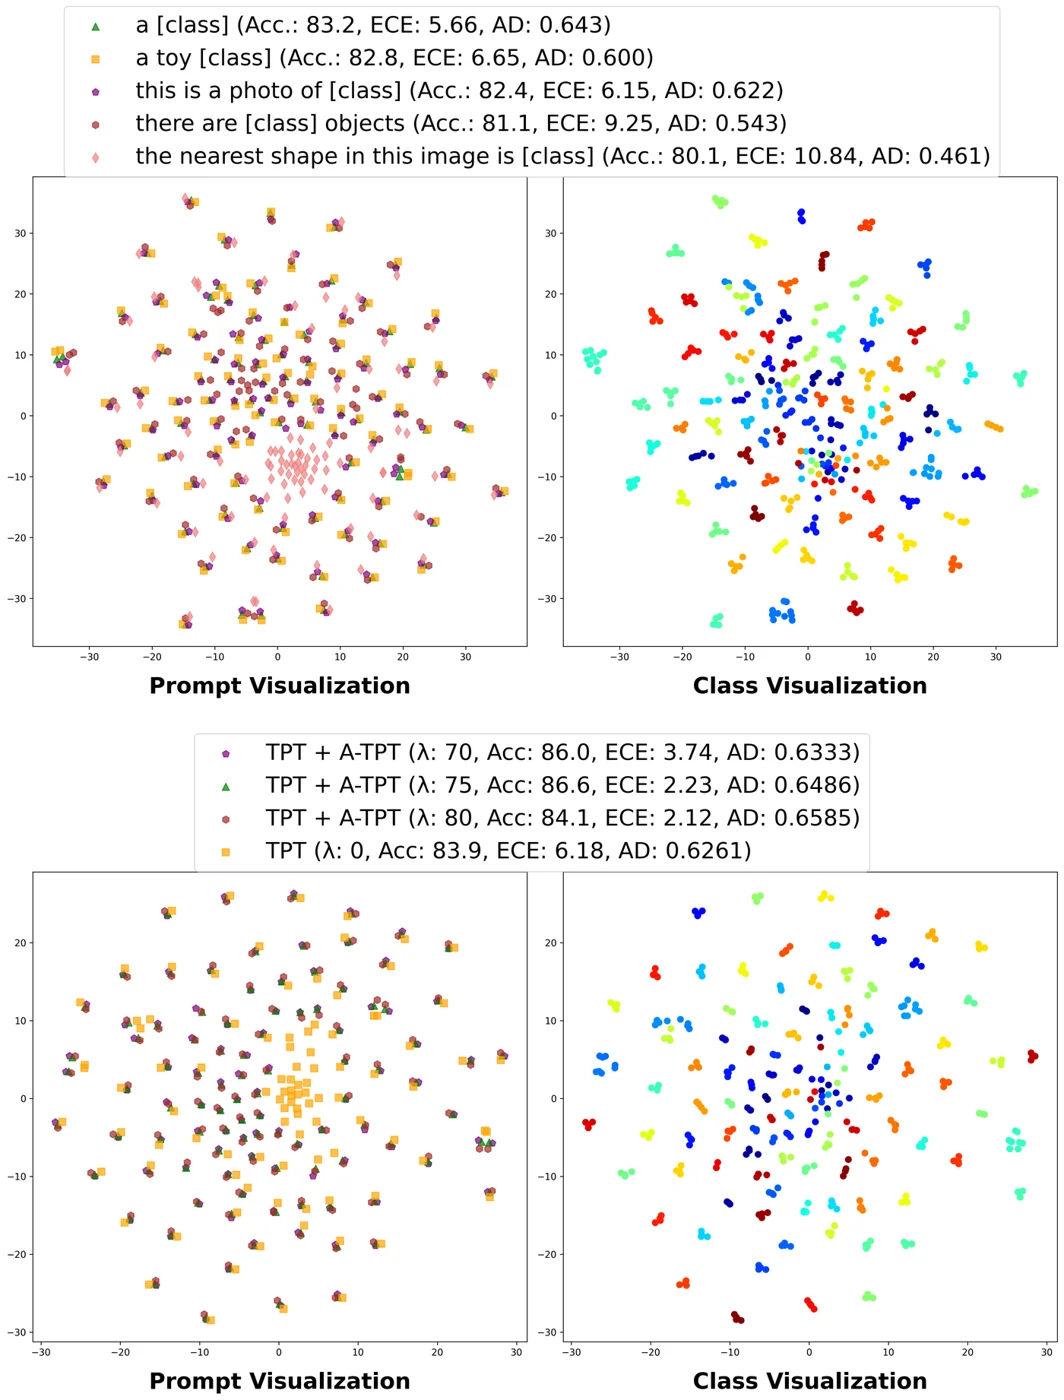 Caltech101에서 CLIP RN50의 class text feature t-SNE. 위: hard prompt, 아래: TPT와 TPT + A-TPT. 왼쪽 panel은 prompt별, 오른쪽 panel은 class별로 색을 칠했다. AD가 낮은 prompt(위의 분홍 마름모, 아래의 TPT 주황 사각형)가 가운데에 뭉치며, 바로 이들이 ECE가 높다. 논문 Figure.
두 번째 관찰은 O-TPT에 관한 것이다. Cosine을 0으로 미는 것은 같은 목표처럼 들리지만 실제로는 다르다. ImageNet-V2(1000개 class로 CLIP ViT-B/16의 512차원보다 많음)에서 O-TPT의 평균 pairwise cosine은 샘플마다 크게 출렁인다. 정확한 orthogonality가 불가능해서 optimizer가 매번 다른 곳에 도착하기 때문이다. EuroSAT(10개 class로 512보다 적음)에서는 O-TPT의 평균 cosine이 약 0.77에 머무는 반면 A-TPT는 약 0.69에 이르러, orthogonality만으로 실제 얻어지는 것보다 feature를 더 넓게 퍼뜨린다. 그래서 저자들은 “쌍을 orthogonal하게”에서 “가장 가까운 쌍을 최대한 멀리”로 목표를 바꾼다.
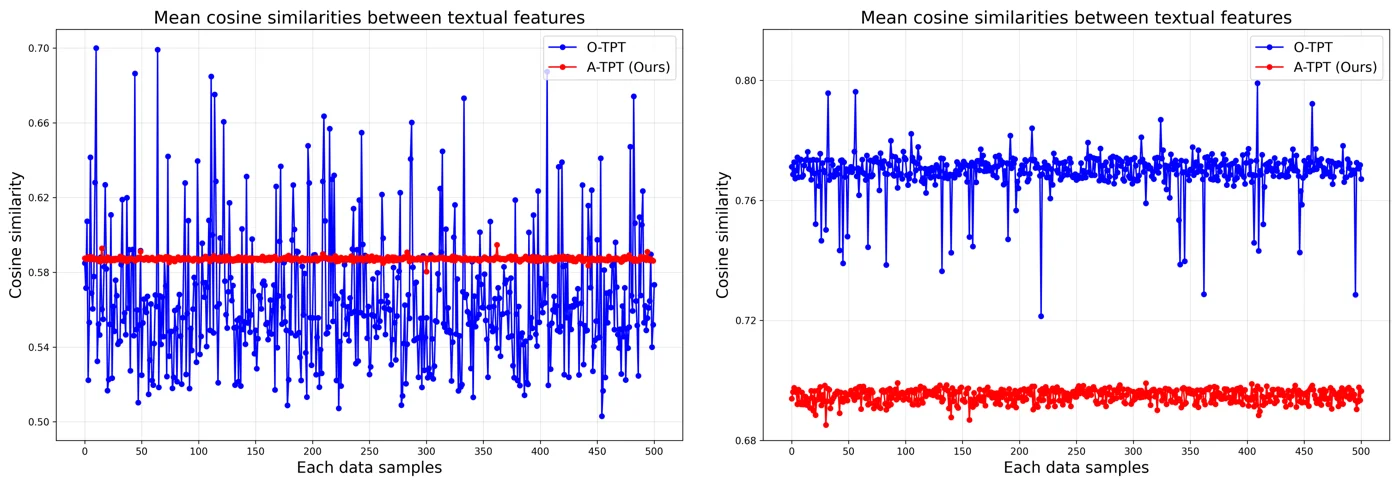 CLIP ViT-B/16에서 테스트 샘플별 class text feature 간 평균 cosine similarity. 왼쪽: \(N > \lvert D \rvert\)(ImageNet-V2)로, O-TPT(파란색)는 크게 출렁이고 A-TPT(빨간색)는 평평하다. 오른쪽: \(N < \lvert D \rvert\)(EuroSAT)로, A-TPT가 feature를 일관되게 더 멀리 떨어뜨린다. 논문 Figure.
Method
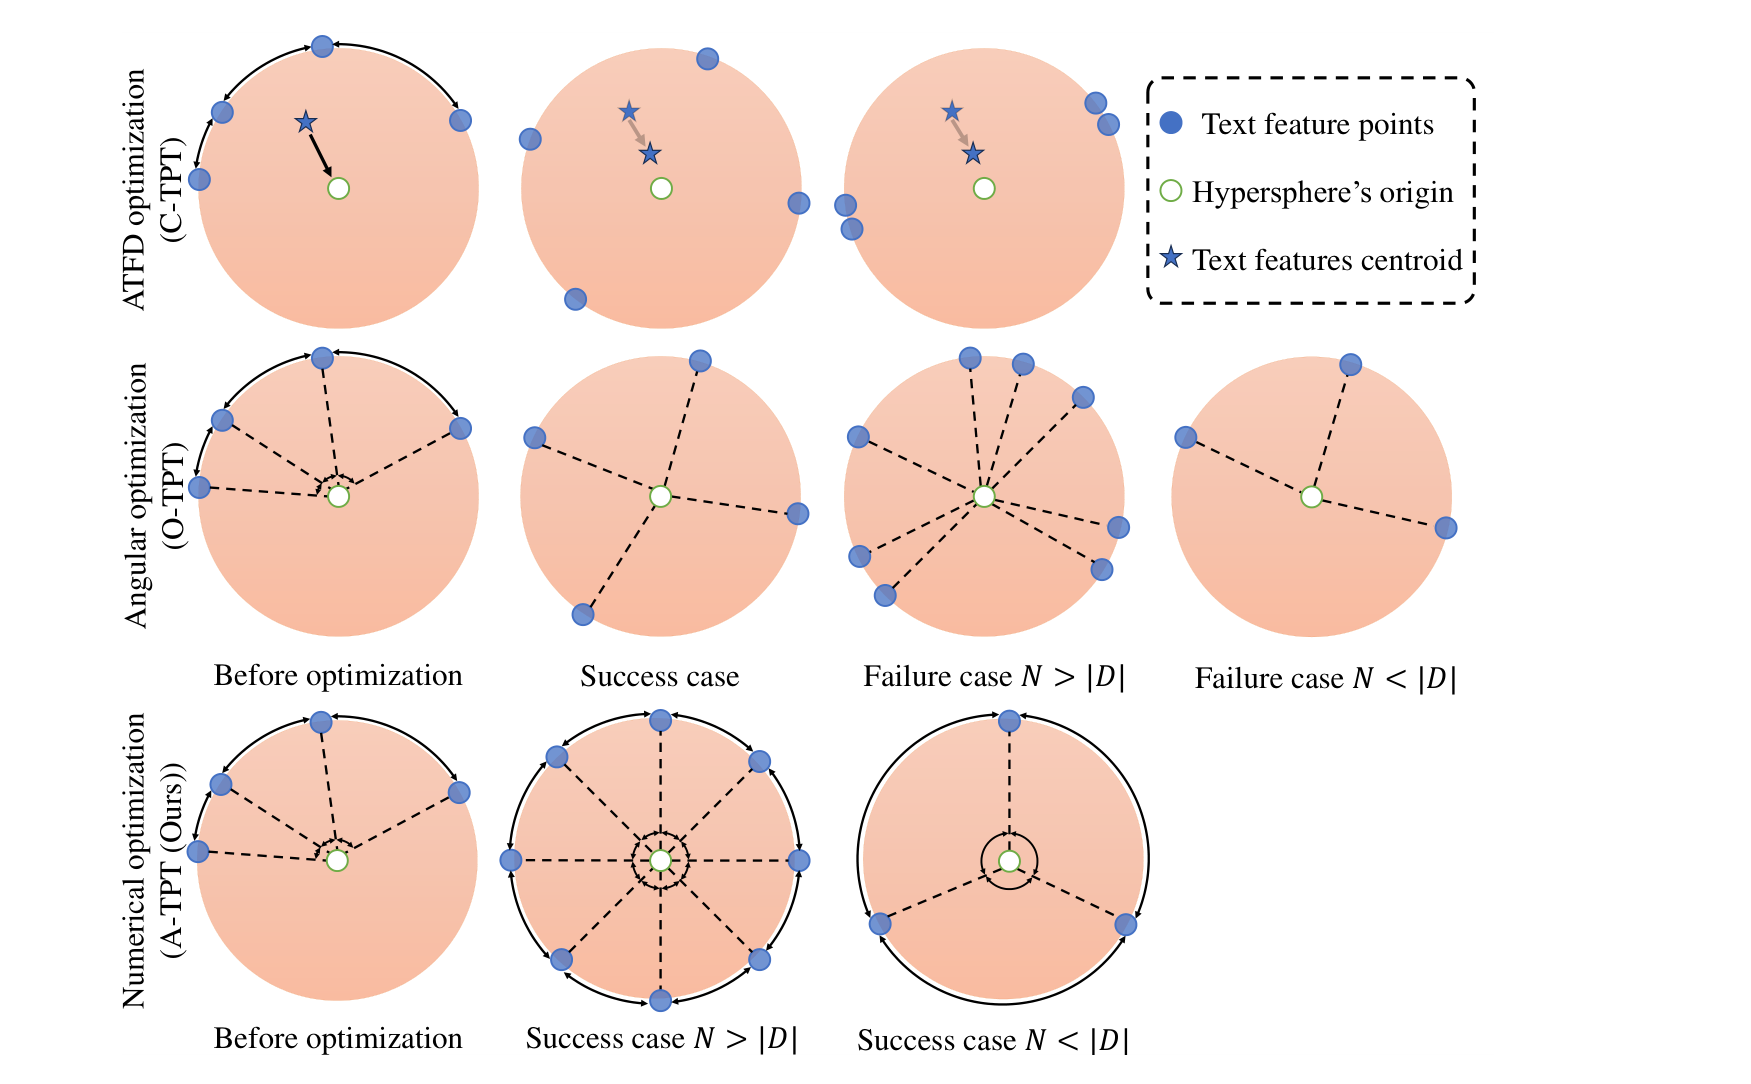 Unit hypersphere 위에서 ATFD(C-TPT, 위), orthogonality(O-TPT, 가운데), angular diversity(A-TPT, 아래)가 class text feature를 움직이는 방식. O-TPT는 \(N > \lvert D \rvert\)와 \(N < \lvert D \rvert\)에서 서로 다른 방식으로 실패한다. A-TPT는 두 경우 모두 feature를 고르게 퍼뜨린다. 그림은 논문에서 가져왔다.
Setup
CLIP은 각 class prompt \(\mathtt{p}_k\)를 text feature \(t_k = f_t(\mathtt{p}_k)\)로, 테스트 이미지를 \(v = f_i(x)\)로 변환한다. Class probability는 temperature 0.01에서 cosine similarity \(\text{sim}(v, t_k)\)에 대한 softmax이다. TPT에서는 prompt token \(\mathtt{p}\)가 학습 가능하며, 테스트 이미지마다 entropy loss \(\mathcal{L}_{\text{TPT}}\)에 대해 한 번의 gradient step을 받는다. 문제는 text feature에 어떤 추가 항을 걸어야 calibration이 좋아지는가이다.
What goes wrong with dispersion and orthogonality
그림의 윗줄은 C-TPT이다. ATFD는 feature들이 centroid에서 떨어진 L2 distance를 최대화한다. Centroid는 원점 쪽으로 이동하지만, 실패 사례에서는 여전히 두 feature가 서로 붙어 있다.
가운데 줄은 O-TPT이다. 이 loss는 모든 pairwise cosine을 0으로 민다. \(N > \lvert D \rvert\)이면 서로 orthogonal한 벡터 \(N\)개가 존재하지 않으며, 저자들은 이때 feature들이 오히려 더 가깝게 모이는 것을 관찰한다. \(N < \lvert D \rvert\)이면 orthogonality는 달성 가능하지만, orthogonal한 feature들이 구를 가능한 한 고르게 쓰지는 않는다(세 클래스가 서로 최대한 멀리 퍼지는 대신 서로 90도를 이룬다).
저자들은 gradient 관점에서도 논증한다. O-TPT에서 pairwise cosine의 feature에 대한 gradient norm은
\[\left\lVert \frac{\partial \, Cos_{ij}}{\partial \mathbf{e}_i} \right\rVert = \frac{\lvert \sin\theta_{ij} \rvert}{\lVert \mathbf{e}_i \rVert},\]이며, 이는 \(\theta_{ij} \to 0\)일 때 0으로 간다. 즉 calibration에 가장 해로운, 거의 같은 방향을 향하는 쌍이 정작 거의 밀려나지 않는다. 각도 자체를 최적화하면
\[\left\lVert \frac{\partial \theta_{ij}}{\partial \mathbf{e}_i} \right\rVert = \frac{1}{\sin\theta_{ij}} \cdot \frac{\sin\theta_{ij}}{\lVert \mathbf{e}_i \rVert} = \frac{1}{\lVert \mathbf{e}_i \rVert},\]가 되어 각도에 의존하지 않는다.
Angular diversity loss
Class text feature를 \(\mathbf{E} \in \mathbb{R}^{N\times \lvert D \rvert}\)로 쌓고 각 행을 L2 normalization해 \(\hat{\mathbf{E}}\)를 얻는다. Pairwise cosine과 각도는 다음과 같다.
\[Cos = \hat{\mathbf{E}}\hat{\mathbf{E}}^T, \qquad \theta = \arccos(Cos).\]Angular diversity (AD)는 각 클래스에서 가장 가까운 다른 클래스까지의 각도를 클래스에 대해 평균한 값이다.
\[\text{AD} = \frac{1}{N} \sum_{i=1}^{N} \min_{j \neq i} \theta_{ij}.\]Prompt는 다음과 같이 tuning된다.
\[\mathtt{p}^{*} = \arg\min_{\mathtt{p}} \left( \mathcal{L}_{\text{TPT}} + \lambda \cdot \mathcal{L}_{\text{A-TPT}} \right), \qquad \mathcal{L}_{\text{A-TPT}} = -\text{AD}.\]각 클래스의 nearest neighbor만 고려하므로, 이 loss는 가장 덜 분리된 쌍을 겨냥한다. 이것이 Tammes problem의 max-min 아이디어이다. 그림의 아랫줄이 이를 보여 준다. \(N > \lvert D \rvert\)에서는 feature들이 같은 각도로 구 둘레에 퍼지고, \(N < \lvert D \rvert\)에서는 세 feature가 90도가 아니라 서로 같은, 최대의 각도를 이룬다.
Evidence and details
RN50을 사용한 Caltech101에서, accuracy가 비슷한 hard prompt들도 ECE가 다르며, calibration이 더 잘 된 prompt일수록 AD가 크다(예: “this is a photo of [class]”: ECE 6.15, AD 0.622; “the nearest shape in this image is [class]”: ECE 10.84, AD 0.461). TPT에 A-TPT를 더하면, 보고된 세 prompt의 AD는 0.633~0.659, ECE는 2.12~3.74가 된다. 일반 TPT는 AD 0.622, ECE 6.18이다. 구현은 C-TPT와 TPT를 따른다. Hard prompt로 초기화하고, learning rate 5e-3의 AdamW 한 step, batch size 64를 사용한다. Weight는 fine-grained 데이터셋에서 \(\lambda = 80\), ImageNet 변형에서 \(\lambda = 10\)이다. 점근적 비용은 O-TPT와 같은 \(O(N^2 \lvert D \rvert)\)이다.
Main Experiments
Backbone은 CLIP ViT-B/16(512차원)과 CLIP RN50(1024차원)이다. 평가 지표는 top-1 accuracy(%)와 ECE(%)이다. 표에는 Average 열만 실었다. Fine-grained 평균은 11개 데이터셋(ImageNet, DTD, Flowers102, Food101, SUN397, Aircraft, OxfordPets, Caltech101, UCF101, EuroSAT, StanfordCars)을 포함한다. “Zero-shot”은 논문의 “Baseline” 행이다. C-TPT와 O-TPT 수치는 O-TPT 논문에 보고된 것과 같다.
Fine-grained classification, 11개 데이터셋 평균 (Table 2)
| Method | ViT-B/16 Acc. | ViT-B/16 ECE | RN50 Acc. | RN50 ECE |
|---|---|---|---|---|
| Zero-shot CLIP | 63.70 | 4.43 | 55.90 | 5.61 |
| TPT | 65.00 | 11.60 | 57.70 | 11.70 |
| C-TPT | 64.57 | 5.13 | 57.75 | 6.19 |
| O-TPT | 64.41 | 4.23 | 57.47 | 5.45 |
| A-TPT | 64.92 | 2.61 | 57.53 | 2.92 |
Natural distribution shift, ImageNet-A, -V2, -R, -Sketch 평균 (Table 3)
| Method | ViT-B/16 Acc. | ViT-B/16 ECE | RN50 Acc. | RN50 ECE |
|---|---|---|---|---|
| Zero-shot CLIP | 57.20 | 5.04 | 40.60 | 7.46 |
| TPT | 59.90 | 12.00 | 43.50 | 16.70 |
| C-TPT | 59.60 | 5.82 | 42.80 | 12.10 |
| O-TPT | 57.80 | 4.88 | 41.16 | 9.69 |
| A-TPT | 58.06 | 3.92 | 40.57 | 7.82 |
A-TPT는 네 가지 설정 모두에서 test-time 방법 중 평균 ECE가 가장 낮으며, ViT-B/16의 fine-grained 데이터에서는 TPT의 accuracy를 거의 그대로 유지한다(64.92 vs. 65.00). 두 backbone 모두에서 11개 fine-grained 데이터셋 각각의 ECE가 O-TPT보다 낮지만, 평균 향상의 상당 부분은 두 데이터셋에서 나온다. EuroSAT에서는 ECE가 ViT-B/16 기준 12.98(O-TPT)에서 3.92로, RN50 기준 14.71에서 2.51로 떨어지고, DTD에서는 7.88에서 4.76으로, 16.53에서 6.41로 떨어진다. 논문 본문은 fine-grained 평균 ECE를 2.92(ViT-B/16)와 2.79(RN50)로 인용하지만 Table 2는 2.61과 2.92를 제시하며, 여기서는 표의 값을 사용했다. ImageNet-V2에서 C-TPT 대비 추가 비용은 작다. Batch당 1.058 s, 21840 MiB로, C-TPT의 1.055 s, 21838 MiB와 O-TPT의 1.064 s, 23740 MiB와 비교된다.
데이터셋별 막대그래프를 보면 향상이 어디에 몰려 있는지 드러난다. A-TPT의 막대는 거의 모든 곳에서 가장 낮지만, 큰 차이는 DTD와 EuroSAT에서 난다. 나머지 대부분의 데이터셋에서는 세 방법의 차이가 1~2 포인트 안이다.
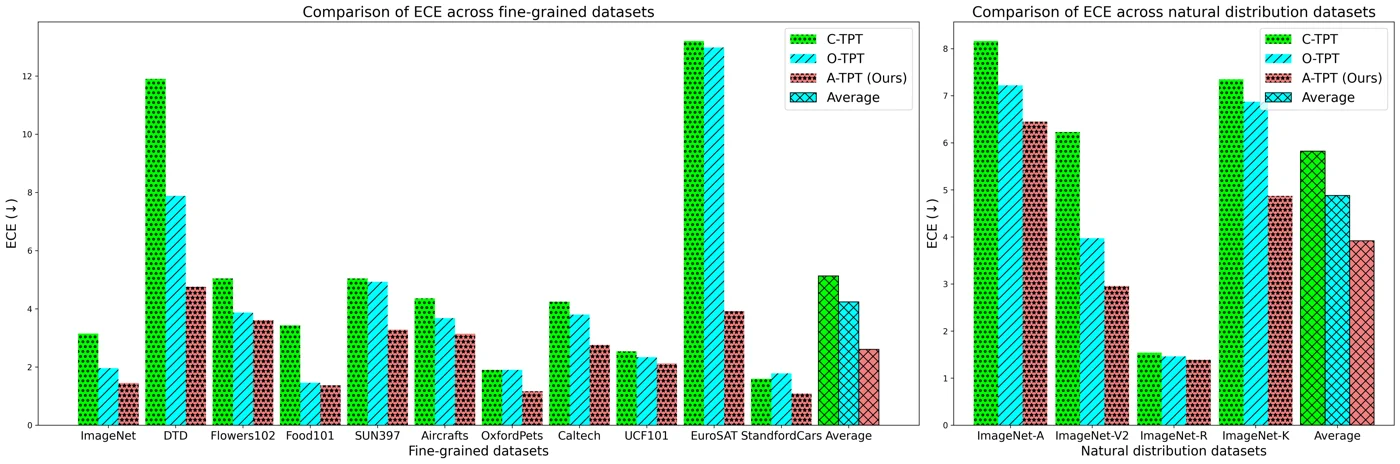 CLIP ViT-B/16에서 fine-grained 데이터셋(왼쪽)과 natural distribution shift(오른쪽)의 데이터셋별 ECE. A-TPT(빨간색)가 거의 모든 데이터셋에서 가장 낮고, 차이가 가장 큰 곳은 DTD, EuroSAT, ImageNet-K이다. 논문 Figure.
Reliability diagram은 같은 내용을 bin 단위로 보여 준다. DTD에서 C-TPT와 O-TPT는 중간~높은 confidence 구간에서 막대 위로 큰 gap을 남긴다. 즉 모델이 실제 accuracy보다 더 confident하다. A-TPT는 이 gap의 대부분을 메우지만, confidence 0.7~0.8 부근에는 overconfidence가 일부 남아 있다.
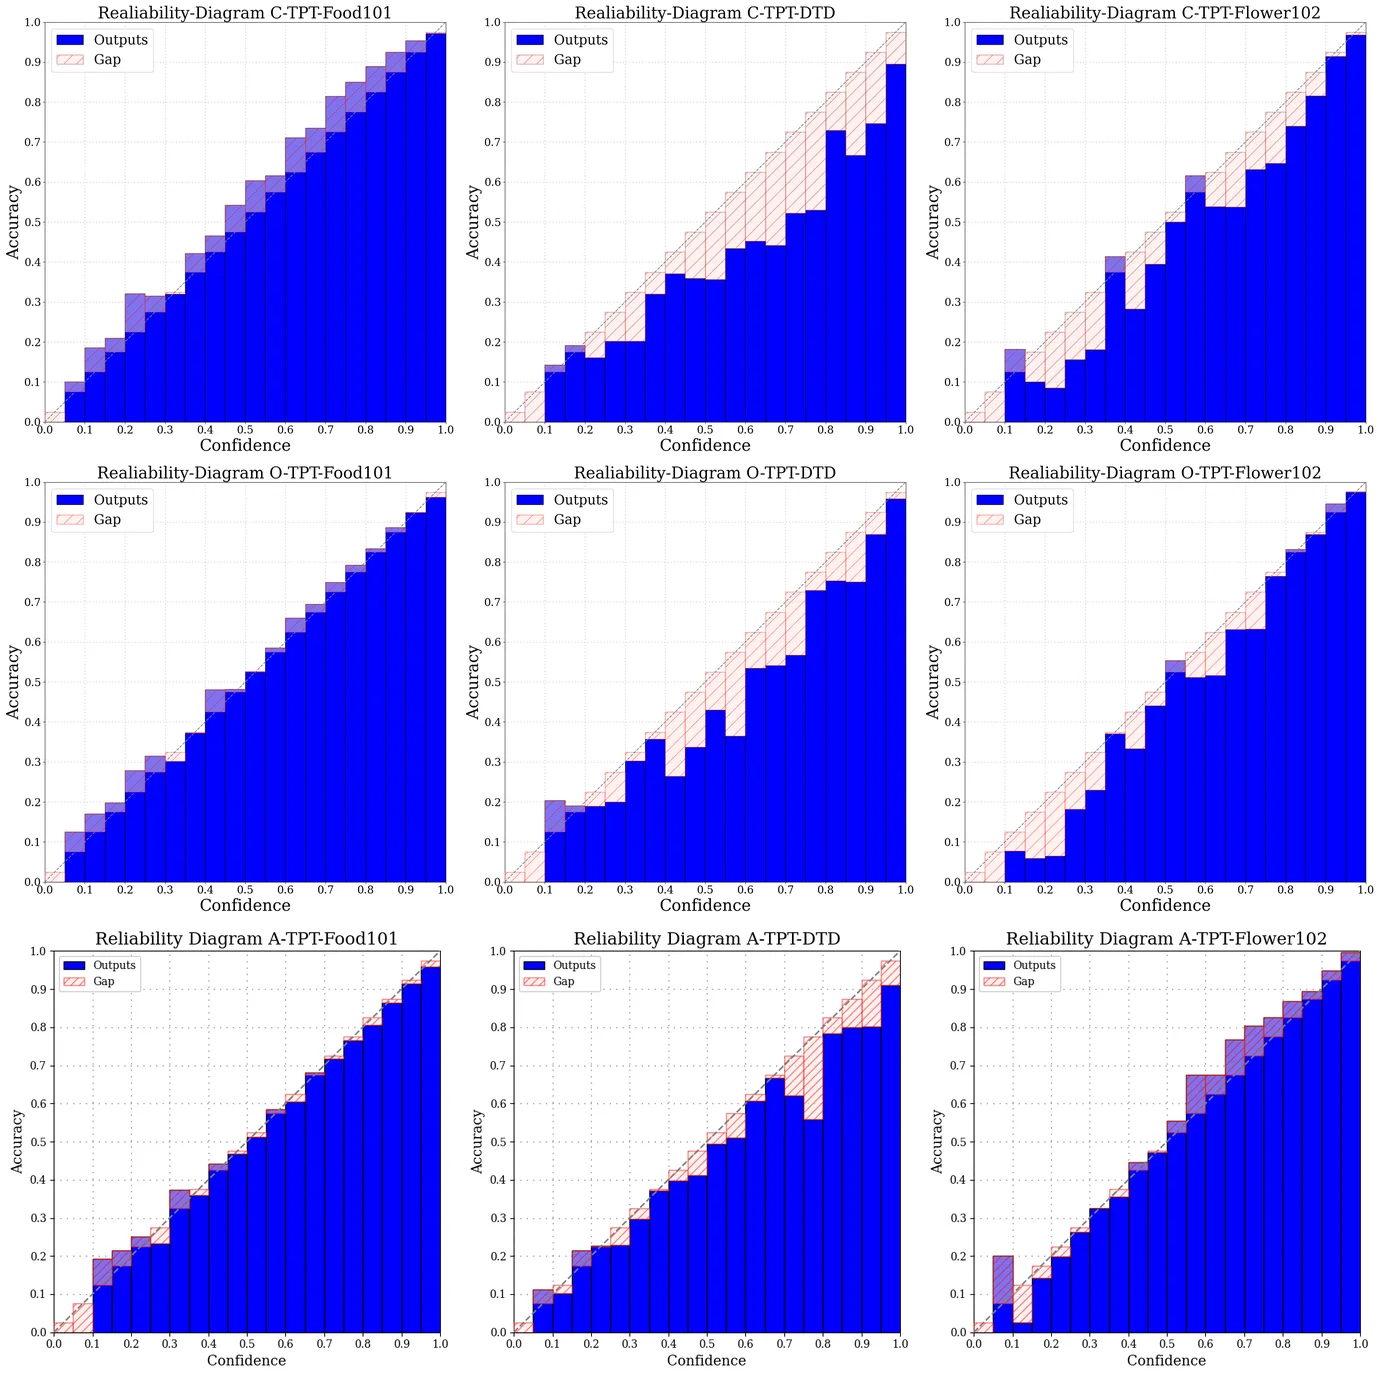 CLIP ViT-B/16으로 Food101, DTD, Flowers102에서 그린 reliability diagram. 행은 위에서부터 C-TPT, O-TPT, A-TPT. 빨간 빗금 영역은 완벽한 calibration과의 gap이며, A-TPT의 DTD와 Flowers102에서 가장 눈에 띄게 줄어든다. 논문 Figure(논문의 panel들을 모아 구성).
Limitations
- 소폭의 accuracy 하락 (저자들이 직접 언급). 일부 데이터셋에서는 accuracy가 떨어지며, 저자들은 그 폭을 1~2% 미만으로 본다. RN50의 natural distribution shift에서는 A-TPT의 평균 accuracy(40.57)가 zero-shot 수준(40.60)까지 내려가므로, 그곳에서는 TPT의 accuracy 향상이 사라진다.
- Label 없이 고정한 \(\lambda\) (저자들이 직접 언급). Trade-off는 하나의 weight로 정해지며, 저자들은 이를 ablation으로 고정했고 샘플별로 최적이 아닐 수 있다고 말한다. 실제로는 benchmark마다 값이 바뀌므로(fine-grained 데이터 80, ImageNet 변형 10), 대상 설정에 대한 어느 정도의 사전 지식이 필요하다.
- 항상 zero-shot보다 나은 것은 아니다. 논문은 A-TPT가 두 backbone 모두에서 natural distribution shift에 대해 zero-shot보다 calibration이 낫다고 말하지만, RN50에서 평균 ECE(7.82)는 zero-shot CLIP(7.46)보다 높다.
- 평균 향상이 일부에 집중되어 있다. O-TPT와의 평균 ECE 차이 중 상당 부분은 EuroSAT과 DTD에서 나온다. 나머지 9개 데이터셋에서의 향상은 일관되지만 더 작아서, 약 0.1~2 ECE 포인트이다.
- Loss 안의 hard minimum. 각 클래스는 단 하나의 nearest neighbor를 통해서만 gradient를 받으며, \(\arccos\)는 cosine 값이 \(\pm 1\) 근처일 때 기울기가 한없이 커진다. 논문은 이 둘로 인한 안정성 문제를 논의하지 않는다. 다만 부록에 여러 seed에 걸친 결과가 보고되어 있다.
- 본문 수치의 불일치. 결과 문단에 인용된 평균값이 Table 2와 맞지 않으므로, 독자는 표를 확인해야 한다.