Abstract
Hallucination은 multimodal LLM에서 여전히 큰 문제이다. VCD와 같은 contrastive decoding (CD) 방법은 vision-language model (VLM)에서 잘 작동한다. 이미지에 corruption을 가해 visual grounding 없이 모델이 무엇을 예측하는지 본 뒤, 그것을 빼는 방식이다. Audio-visual LLM (AV-LLM)은 video, audio, language의 세 입력을 가지므로 어느 것을 perturb해야 할지 분명하지 않다. 또한 hallucination은 이들 중 어느 하나에서, 혹은 이들 사이의 상호작용에서 생길 수 있다.
AVCD는 이러한 세 modality 설정을 위한 training-free decoding 방법이다. 현재 예측을 어떤 modality가 지배하는지 측정하고, 덜 지배적인 modality들을 masking한 뒤, 세 modality에 대해 유도한 CD 식으로 그 결과 branch들을 결합한다. 모델이 이미 확신하고 있을 때는 entropy gate가 추가 연산을 건너뛴다.
Motivation
논문은 AV-LLM의 hallucination이 VLM의 것과 어떻게 다른지 보여 주는 예시로 시작한다. 한 남자가 cello와 drum을 연주하는 clip을 설명하라고 하면, VideoLLaMA2는 화면에 없는 piano를 만들어 내고(visual 오류), 이어서 “cello와 piano가 동시에 소리를 낸다”고 말한다(audio와 video의 조합에서만 생기는 오류). VLM 방식의 CD는 고정된 하나의 modality, 즉 이미지만 perturb하므로 두 번째 종류의 실수는 겨냥하지 못한다.
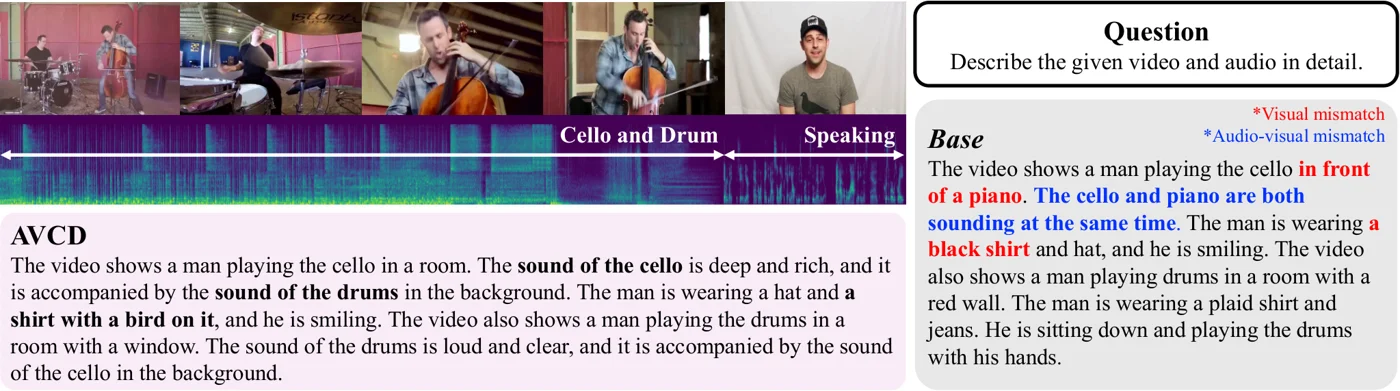 VideoLLaMA2의 captioning 예시. Base decoding(오른쪽)은 visual mismatch(빨간색: piano, 검은 셔츠)와 audio-visual mismatch(파란색: cello와 piano가 함께 소리 냄)를 만든다. AVCD(왼쪽)는 cello와 drum 소리, 새가 그려진 셔츠를 정확히 묘사한다. 논문 Figure.
두 번째 근거는 모델의 attention이 어디로 가는가이다. AVHBench 200개 샘플에서 audio-visual VideoLLaMA2의 마지막 query token은 attention의 70%를 language token에, 17%를 video에, 13%만을 audio에 준다. 200개 샘플 모두에서 language가 dominant modality이다. MSVD-QA의 video-only 변형에서는 language 56% 대 video 44%로 더 균형적이며, dominant modality가 샘플마다 바뀐다. 이것이 방법의 기반이다. VCD처럼 항상 이미지를 perturb하는 대신, attention으로 샘플마다 dominant modality를 찾고 나머지를 perturb한다.
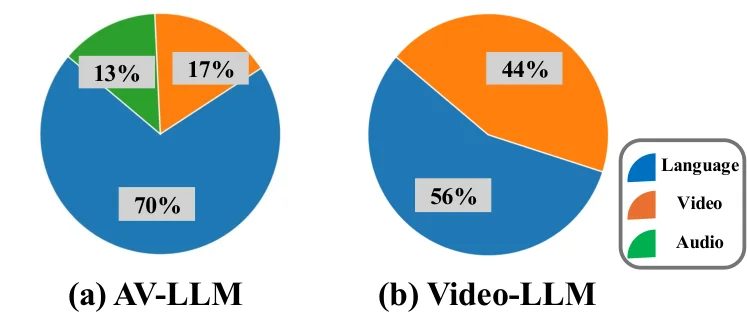 VideoLLaMA2의 평균 modality dominance. (a) AVHBench에서의 audio-visual 모델: 마지막 token의 attention 중 language가 70%, audio는 13%뿐이다. (b) MSVD-QA에서의 video-only 모델: 56% 대 44%로 더 균형적이다. 논문 Figure(appendix).
Method
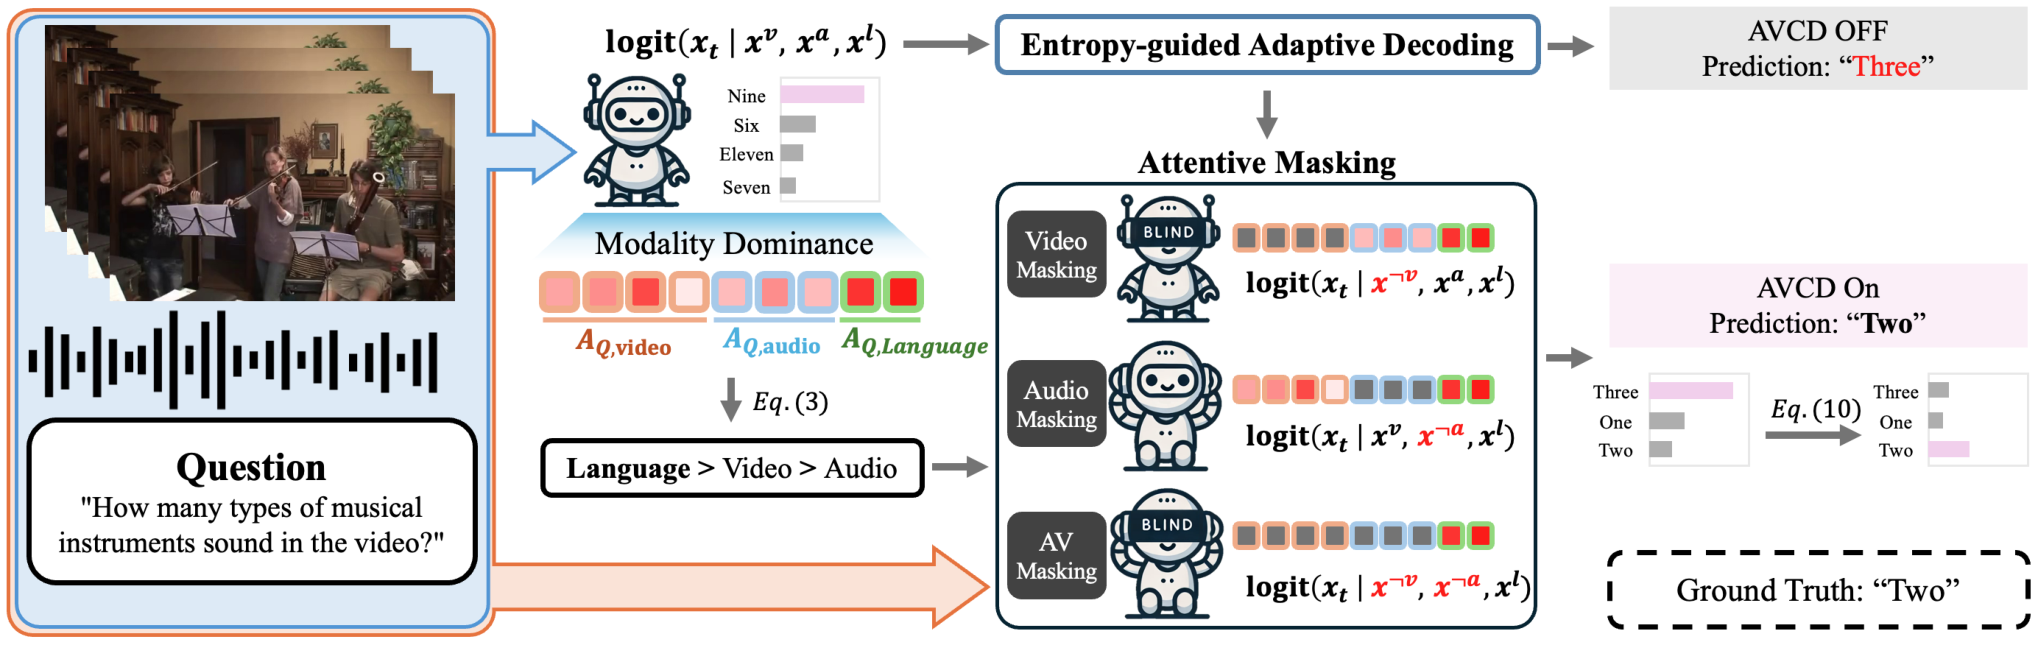 AVCD 파이프라인. Attention으로 modality dominance 순서를 구하고, 덜 지배적인 modality를 masking한 뒤, masking된 branch들을 trimodal CD로 결합한다. 그림은 논문에서 가져왔다.
Contrastive decoding recap
VLM에서 CD는 원래 branch와 visual input이 perturb된 branch를 대조한다.
\[\mathrm{logit} = (1+\alpha)\,\mathrm{logit}(y \mid x^v, x^l) - \alpha\,\mathrm{logit}(y \mid x^{\neg v}, x^l)\]Perturb된 branch는 모델이 language bias만으로 무엇을 예측하는지 보여 준다. 이를 빼면 예측 중 실제 visual grounding에서 나온 부분이 증폭된다.
1. Modality dominance (그림 왼쪽)
\(A^j_{Q_K, i}\)를 layer \(j\)에서 마지막 query token이 key token \(i\)에 주는 attention이라 하자. Modality \(M \in \{V, A, L\}\)의 dominance는 그 modality가 받는 전체 attention을 \(J\)개 layer 전체에 대해 평균한 값이다.
\[D_M = \frac{1}{J} \sum_{j=1}^{J} \sum_{i \in M} A^j_{Q_K, i}\]그림에서는 \(D_L > D_V > D_A\)이므로 language가 지배적이다.
2. Attentive masking (가운데)
AVCD는 지배적이지 않은 modality를 perturb한다. Token을 삭제하지는 않는다. 해당 modality에서 attention을 가장 많이 받은 상위 \(P\%\) token의 representation을 0으로 만든다. Language가 지배적이면 video masking, audio masking, 둘 다 masking의 세 가지 perturbed branch가 생긴다.
3. Trimodal contrastive decoding (오른쪽)
Video CD는 audio가 우연히 존재하는지 여부에 좌우되어서는 안 되므로, AVCD는 audio가 온전한 경우와 masking된 경우를 평균한다. 이 평균을 log space에서 근사하는데, 두 확률이 가까우면 이 근사는 정확하다. 네 branch
\[L_{VA},\quad L_{\neg V A},\quad L_{V \neg A},\quad L_{\neg V \neg A} \qquad (L_{\cdot} = \log p(y_t \mid \cdot, L))\]를 사용하면 video CD와 audio CD는 다음과 같다.
\[\mathrm{logit}_v \propto (1+\alpha_v)(L_{VA} + L_{V\neg A}) - \alpha_v (L_{\neg V A} + L_{\neg V \neg A})\] \[\mathrm{logit}_a \propto (1+\alpha_a)(L_{VA} + L_{\neg V A}) - \alpha_a (L_{V \neg A} + L_{\neg V \neg A})\]그리고 둘의 합이 최종 logit이다.
\[\mathrm{logit}_{\text{AVCD}} = (2 + \alpha_v + \alpha_a) L_{VA} + (1 - \alpha_v + \alpha_a) L_{\neg V A} + (1 + \alpha_v - \alpha_a) L_{V \neg A} - (\alpha_v + \alpha_a) L_{\neg V \neg A}\]4. Entropy-guided adaptive decoding (위)
원래의 forward pass가 먼저 실행된다. 그 entropy \(H_t = -\sum_v p_t(v) \log p_t(v)\)가 threshold \(\tau\)보다 낮으면 모델이 확신하고 있는 것이므로, AVCD는 해당 token에 대해 원래 예측을 유지한다.
Main Experiments
MUSIC-AVQA와 AVHBench의 accuracy(%), 그리고 AVHBench captioning 점수이다. VCD* 변형은 논문을 참고하라.
| Model | Decoding | MUSIC-AVQA | AVHBench | AVHBench-Cap |
|---|---|---|---|---|
| VideoLLaMA2 | Base | 81.30 | 70.52 | 2.84 |
| VCD | 77.66 | 65.18 | 2.86 | |
| VCD* | 81.49 | 69.18 | 3.00 | |
| AVCD | 81.58 | 72.15 | 3.03 | |
| video-SALMONN | Base | 48.50 | 58.19 | 1.83 |
| VCD | 41.57 | 60.61 | 2.41 | |
| VCD* | 49.00 | 60.66 | 2.44 | |
| AVCD | 49.73 | 62.18 | 2.47 |
AVCD는 video-only LLM에도 도움이 된다. MSVD-QA에서 VideoLLaMA2는 74.43에서 75.20으로, Video-LLaVA는 70.20에서 72.16으로 오른다.
- 일반 VCD는 AV-LLM의 성능을 오히려 떨어뜨리는 경우가 많다(VideoLLaMA2의 AVHBench에서 70.52 → 65.18). VLM 방식으로 단일 modality만 perturb하는 것은 그대로 옮겨지지 않는다.
- Ablation에서 masking된 단일 modality에 대한 two-branch CD는 조금만 도움이 되고, masking된 세 branch를 모두 단순히 빼면 70.94가 나온다. 유도된 trimodal 식은 72.15에 도달한다.
Qualitative 예시는 “무시된 modality” 오류가 어떤 모습인지 보여 준다. 첫 번째 예시에서 video에는 acoustic guitar를 든 남자가 나오지만 audio는 violin이다. Base와 VCD는 acoustic guitar 하나가 소리를 낸다고 답하고, AVCD는 0개라고 답한다. 두 번째 예시(video-only 모델)에서는 질문에 오해를 부르는 문장이 들어 있고, AVCD만 눈 덮인 frame을 근거로 답한다.
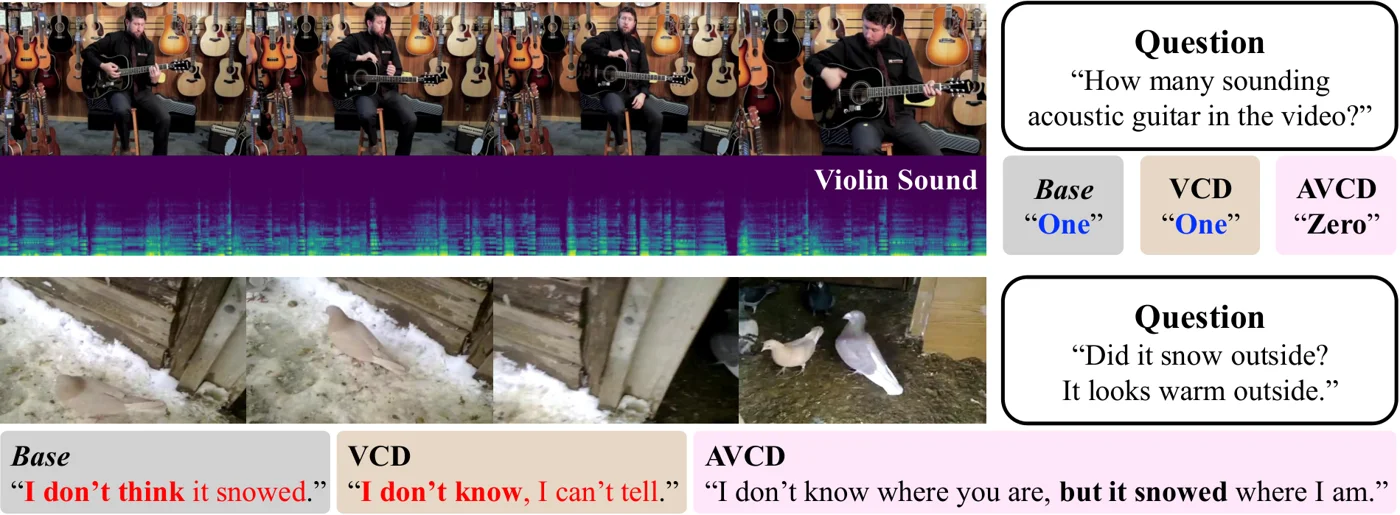 위: audio가 violin이므로 소리 나는 acoustic guitar가 없는 AV-LLM 예시로, AVCD만 “Zero”라고 답한다. 아래: 오해를 부르는 prompt가 있는 video-LLM 예시로, Base와 VCD는 text를 따르고 AVCD는 video 속 눈을 사용한다. 논문 Figure.
Entropy gate는 AVHBench validation split에서 평가한다. \(\tau\)가 낮을수록 더 많은 token이 모든 branch를 거치므로 accuracy는 오르지만 시간이 든다. \(\tau = 0.8\)에서 AVCD는 VCD보다 빠르면서도 Base보다 accuracy가 높다(78.05% → 80.98%). 반면 VCD 자체는 이 set에서 Base보다 크게 낮다.
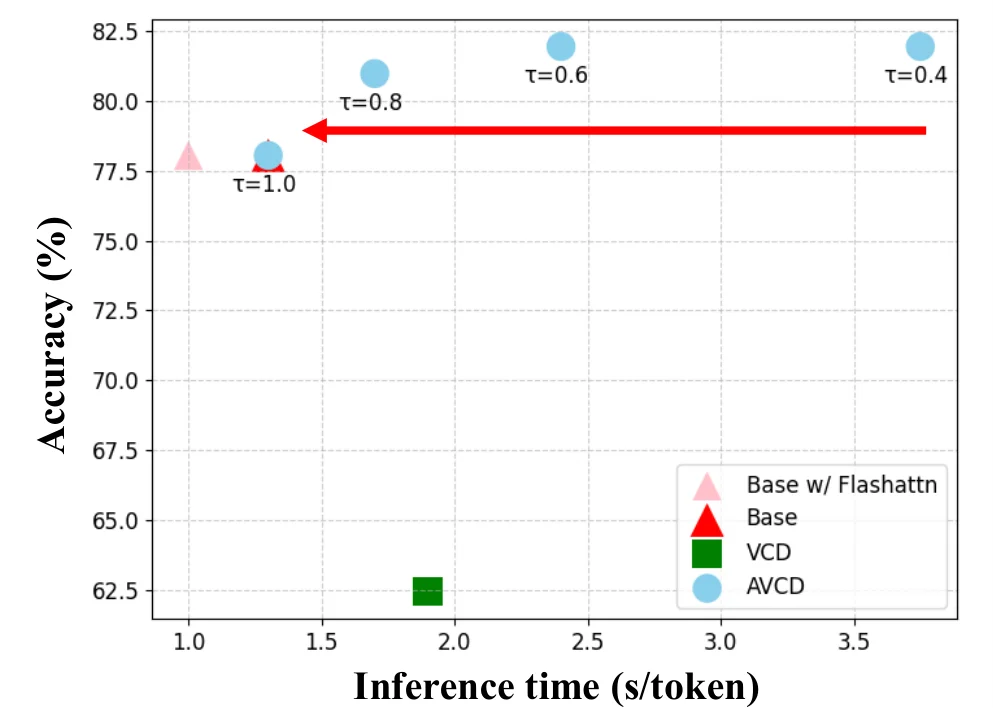 AVHBench validation set에서 VideoLLaMA2의 token당 inference time 대비 accuracy. 파란 원은 threshold \(\tau\)별 AVCD이며, \(\tau = 1.0\)이면 대략 Base의 속도와 accuracy로 돌아간다. VCD(초록색)는 더 느리면서 accuracy도 훨씬 낮다. 논문 Figure.
Limitations
- 비용. Entropy gate가 없으면 token마다 네 번의 forward pass가 필요하다. Gate는 accuracy와 속도를 맞바꾼다. 논문의 그래프에서 \(\tau\)를 낮추면 accuracy는 오르지만, latency는 token당 약 1.3 s에서 약 3.75 s로 늘어난다.
- Attention은 필요와 같지 않다. Dominance는 모델이 실제로 무엇에 attend하는지를 말해 줄 뿐, 질문이 무엇을 요구하는지는 말해 주지 않는다. 소리에 관한 질문이어도 attention의 대부분이 video token에 갈 수 있다. MAD는 질문에 어떤 modality가 필요한지 모델에게 직접 물어 이 문제를 다룬다.
- 일부 설정에서는 향상이 작다. VideoLLaMA2의 MUSIC-AVQA에서 base model 대비 향상은 0.3포인트 미만이다.