Abstract
3D point cloud의 test-time adaptation (TTA)은 보통 backpropagation으로 모델을 update한다. Pseudo-label 방법은 noisy label을 모델에 다시 넣을 수 있어, 테스트 스트림을 거치며 오류가 쌓이고 source 지식이 잊힌다. MATE 같은 self-supervised 방법은 더 잘 작동하지만 느리며, 이는 adaptation이 실시간으로 이루어져야 할 때 문제가 된다.
BFTT3D는 source model을 전혀 update하지 않는다. 대신 parameter가 없는 구성 요소들로 만든 두 번째 branch를 추가한다. Non-parametric point cloud encoder, source prototype을 담은 작은 memory, 그리고 closed-form subspace alignment가 그것이다. 이 branch는 target에 특화된 logit을 만든다. 이 logit은 두 예측 entropy로부터 계산한 weight를 사용해 고정된 source model의 logit과 섞인다.
Motivation
이 논문의 motivation은 3D TTA의 두 주요 계열 사이의 trade-off이다. Pseudo-label 방법(주로 teacher-student 방식)은 빠르지만, 모든 update가 모델 스스로 만든 label로 supervision된다. 틀린 label이 backpropagation으로 다시 들어가고, 스트림을 따라 오류가 쌓이며, source 지식이 덮어써진다. MATE 같은 self-supervised 방법은 noisy label을 피하고 더 잘 작동하지만, auxiliary task와 test time의 gradient update가 필요하다. 저자들은 이것이 날씨 변화에 맞춰 바로 adaptation해야 하는 LiDAR detector 같은 경우에는 너무 느리다고 본다. 논문 뒤쪽의 ScanObjectNN-C 결과는 첫 번째 계열이 작은 real-scan 데이터에서 얼마나 크게 실패할 수 있는지 보여 준다. SHOT은 CurveNet의 error를 64.77에서 85.35로 올린다.
저자들의 답은 source model을 완전히 고정해 아무것도 잊히지 않게 하고, target에 특화된 정보는 학습 가능한 parameter가 전혀 없는 branch에 모두 맡기는 것이다. 아래 그림은 두 pipeline을 대비한다. Baseline은 pseudo-label에서 나온 gradient를 source model로 되돌려 보내고, BFTT3D는 고정된 모델 옆에 backpropagation-free module을 두고 두 출력만 fusion한다.
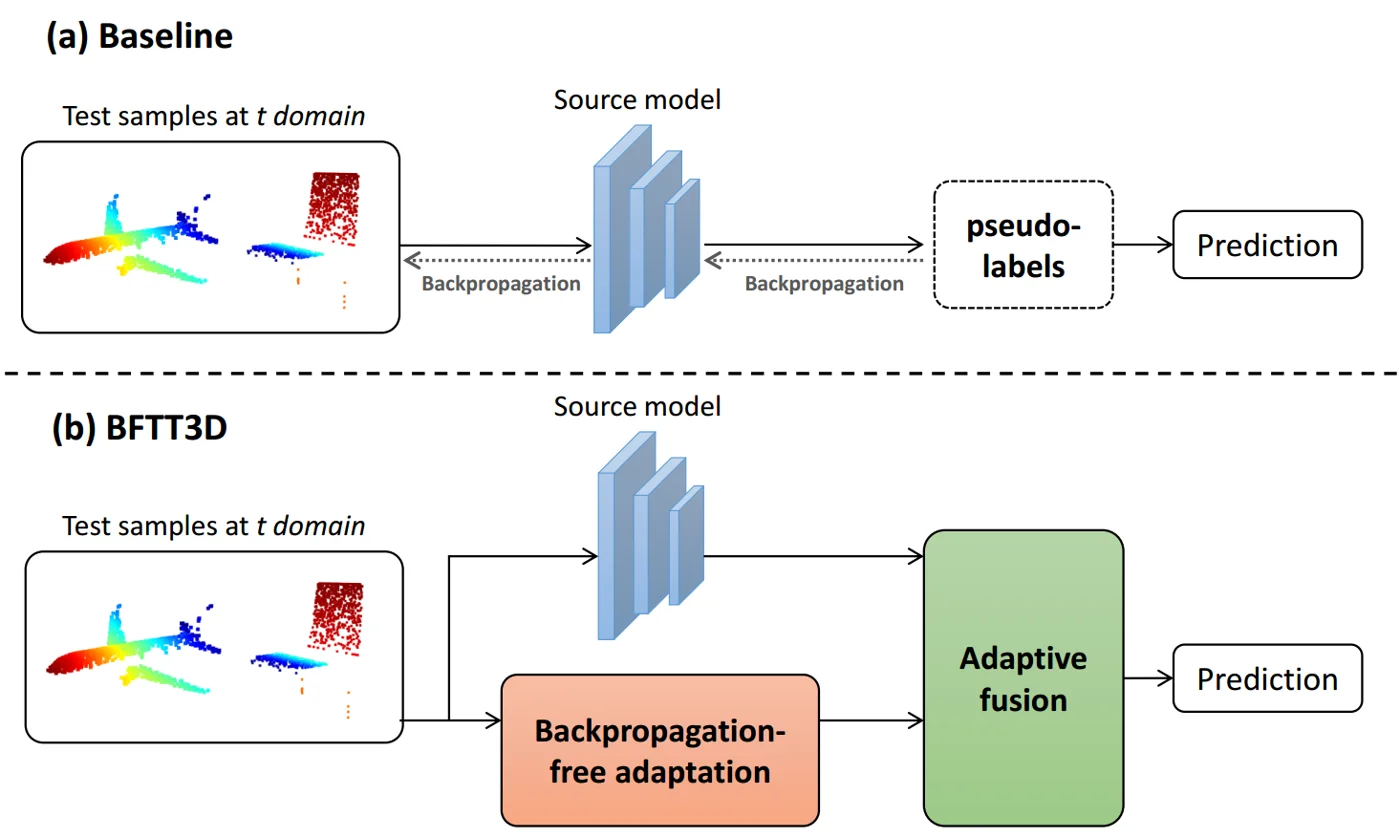 (a) 일반적인 3D TTA: source model이 pseudo-label을 만들고 이를 이용해 backpropagation으로 학습된다. (b) BFTT3D: source model은 고정되고, backpropagation-free adaptation module이 두 번째 예측을 만들며, adaptive fusion이 둘을 결합한다. 논문 Figure.
Method
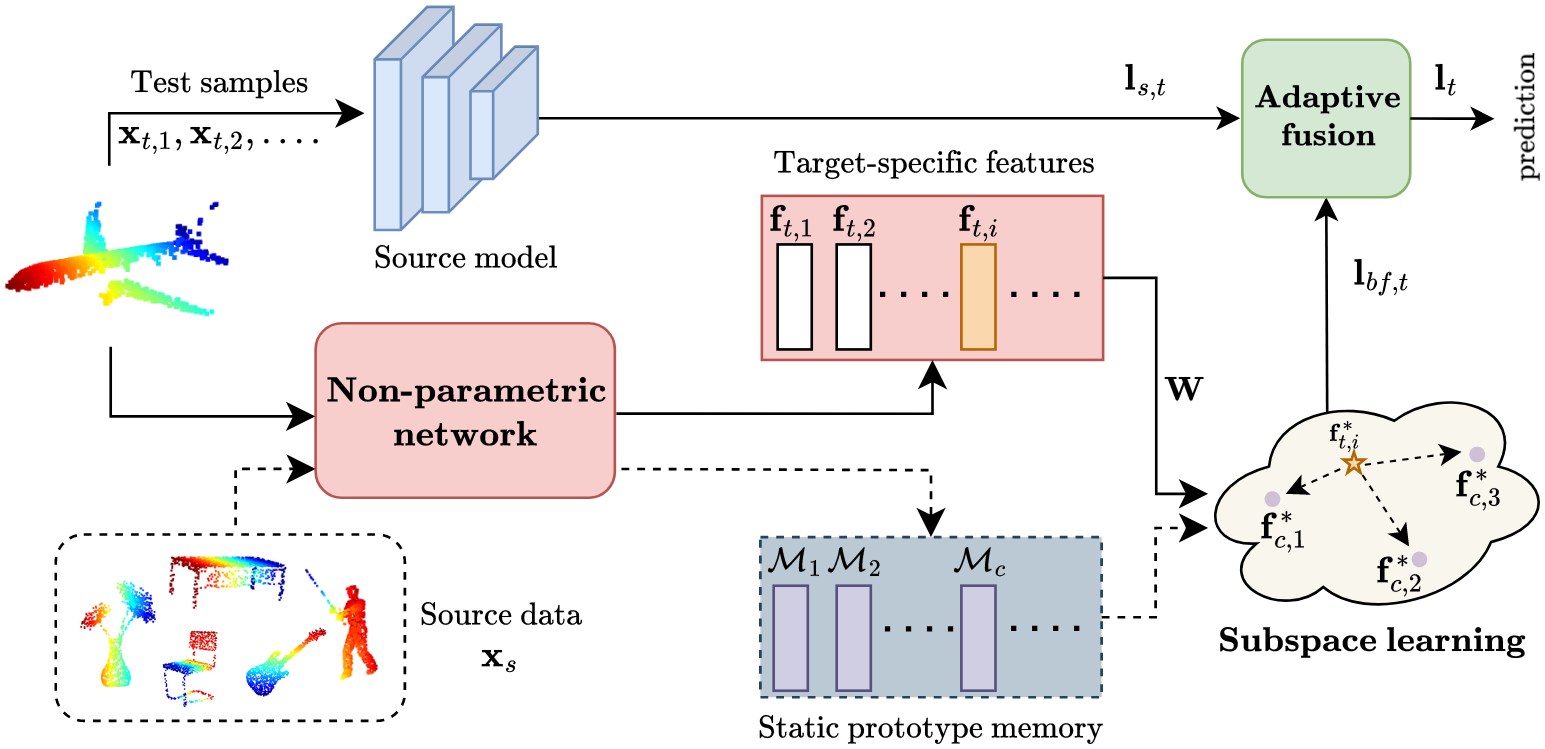 두 개의 stream: 고정된 source model이 \(\mathbf{l}_{s,t}\)를 주고, non-parametric network와 static prototype memory에 대한 subspace matching이 \(\mathbf{l}_{bf,t}\)를 준다. Adaptive fusion이 이 둘을 \(\mathbf{l}_t\)로 결합한다. 그림은 논문에서 가져왔다.
Source model \(h_{\theta_s}\)는 일반적인 pre-trained classifier(PointNet, DGCNN 또는 CurveNet)이다. 이 모델은 고정되어 source-specific logit \(\mathbf{l}_{s,t}\)를 준다. 그림의 나머지 모든 부분은 학습 가능한 weight 없이 두 번째 logit \(\mathbf{l}_{bf,t}\)를 만들기 위해 존재한다.
Non-parametric network
아래 branch는 Point-NN의 non-parametric encoder를 사용한다. 학습된 weight가 없다. Farthest point sampling, \(k\)-NN grouping, pooling, trigonometric positional embedding만으로 구성된다. 각 좌표는 sine과 cosine으로 인코딩되고, neighbor feature는 각 중심점에 concat한 뒤 relative positional encoding으로 reweighting되며, max pooling과 average pooling이 각 group을 압축한다. 이를 네 번 반복한 뒤 global pooling으로 테스트 샘플마다 feature \(\mathbf{f}_{t,i} \in \mathbb{R}^d\)를 얻는다. 아무것도 학습하지 않으므로, 저자들은 이 encoder가 source domain에 덜 편향되어 있다고 주장한다.
Static prototype memory
테스트 전에 같은 encoder를 source 데이터에 실행한다. 각 클래스 \(c\)에 대해 herding 알고리즘이 class mean에 가장 가까운 feature들을 남겨 고정된 memory \(\mathcal{M}_c\)를 만든다. 논문은 source feature의 25%를 유지한다. 이 memory는 한 번만 만들어지고 이후 바뀌지 않는다.
Subspace learning
Target feature를 source prototype과 직접 매칭하면 domain gap의 영향을 받는다. 그래서 둘 다 먼저 공유 subspace \(\mathbf{f}^* = \psi(\mathbf{f})\)로 projection하며, 이 projection은 prototype과 테스트 feature 사이의 Maximum Mean Discrepancy (MMD)를 최소화하도록 정한다.
\[\operatorname{Dist}(\mathcal{Q}_s, \mathcal{Q}_t) = \left\| \frac{1}{n_s}\sum_{i=1}^{n_s} \mathbf{f}_i^* - \frac{1}{n_t}\sum_{i=1}^{n_t} \mathbf{f}_{t,i}^* \right\|_{\mathcal{H}}^2\]Projection은 Transfer Component Analysis (TCA)로 구한다. 전체 \(n_s + n_t\)개의 prototype 및 테스트 feature에 대한 kernel matrix \(\mathbf{K}\), scaling matrix \(\mathbf{L}\), centering matrix \(\mathbf{H}\)를 두고 TCA는 다음을 푼다.
\[\min_{\mathbf{W}} \operatorname{tr}(\mathbf{W}^T \mathbf{K}\mathbf{L}\mathbf{K}\mathbf{W}) + \mu \operatorname{tr}(\mathbf{W}^T\mathbf{W}) \quad \text{s.t. } \mathbf{W}^T\mathbf{K}\mathbf{H}\mathbf{K}\mathbf{W} = \mathbf{I}\]해는 closed-form으로, \((\mathbf{KLK} + \mu\mathbf{I})^{-1}\mathbf{KHK}\)의 상위 \(m\)개 eigenvector이다. Projection된 feature는 \(\mathbf{W}^T\mathbf{K}\)의 열들이며, 논문에서는 \(m = 150\)이다. Gradient step은 전혀 쓰이지 않는다.
Subspace에서 테스트 feature는 cosine similarity \(\mathcal{J} = \tilde{\mathbf{F}}_t \cdot \tilde{\mathcal{M}}^T\)로 prototype과 비교되고, prototype label \(\mathbf{L}_m\)을 이용해 class score로 바뀐다.
\[\mathbf{l}_{bf,t} = \varphi(\mathcal{J}\mathbf{L}_m), \qquad \varphi(x) = \exp(-\gamma(1 - x))\]Adaptive fusion
두 logit은 weight \(p\)로 섞인다.
\[\mathbf{l}_t = p \cdot \mathbf{l}_{bf,t} + (1-p) \cdot \mathbf{l}_{s,t}, \qquad p = 1 - \frac{\text{E}(\mathbf{l}_{bf,t})}{\text{E}(\mathbf{l}_{s,t}) + \text{E}(\mathbf{l}_{bf,t})}\]여기서 \(\text{E}(\cdot)\)는 softmax entropy이다. Source model이 불확실하면(entropy가 높으면) \(p\)가 커지고 prototype branch가 더 큰 weight를 받는다. Target이 source에 가까우면 source model이 주도한다. Ablation에서 이 adaptive \(p\)는 validation 데이터 없이도 grid search로 찾은 최적의 고정 \(p\)에 가깝게 유지된다.
Main Experiments
Severity 5의 15가지 corruption에 대한 평균 classification error(%, 낮을수록 좋음)이다. 각 backbone은 깨끗한 데이터셋에서 학습되어 source model로 쓰인다. LAME과 DSS는 PointNet에서만 보고되었다. Table 1과 2의 일부이며, 논문에는 corruption 유형별 error도 실려 있다.
ModelNet-40C (Table 1)
| Method | PointNet | DGCNN | CurveNet |
|---|---|---|---|
| Source-only | 35.88 | 34.65 | 28.47 |
| TENT | 34.62 | 30.99 | 22.60 |
| BN | 34.89 | 31.36 | 24.03 |
| SHOT | 34.25 | 30.17 | 19.79 |
| LAME | 83.16 | – | – |
| DSS | 35.23 | – | – |
| BFTT3D | 33.78 | 29.33 | 19.23 |
ScanObjectNN-C (Table 2)
| Method | PointNet | DGCNN | CurveNet |
|---|---|---|---|
| Source-only | 59.35 | 46.09 | 64.77 |
| TENT | 58.18 | 45.17 | 65.77 |
| BN | 57.87 | 45.11 | 64.26 |
| SHOT | 65.63 | 57.53 | 85.35 |
| LAME | 55.67 | – | – |
| DSS | 56.53 | – | – |
| BFTT3D | 54.46 | 43.91 | 57.80 |
BFTT3D는 여섯 가지 설정 모두에서 평균 error가 가장 낮다. ModelNet-40C에서는 최고 baseline과의 차이가 작다(예: CurveNet에서 SHOT의 19.79 대 19.23). 더 작고 실제 스캔으로 만든 ScanObjectNN-C에서는 차이가 더 큰데, backpropagation 기반 baseline들이 그곳에서 개선에 실패하거나 오히려 나빠지는 경우가 많기 때문이다(CurveNet에서 SHOT은 85.35까지 오른다). 향상은 background, occlusion, LiDAR 같은 큰 distribution shift에 집중된다. 논문은 실행 시간이나 memory 수치를 보고하지 않는다.
Corruption별 전체 표를 보면 평균이 어디서 나오는지 알 수 있다. PointNet의 ModelNet-40C에서는 대부분의 열이 1포인트 미만으로 움직이고, 평균 향상은 background(95.30 → 80.75), rotation(72.81 → 68.56), LiDAR(59.00 → 55.88)가 이끈다. DGCNN의 shear는 BFTT3D가 source model보다 나쁜 칸 중 하나이다.
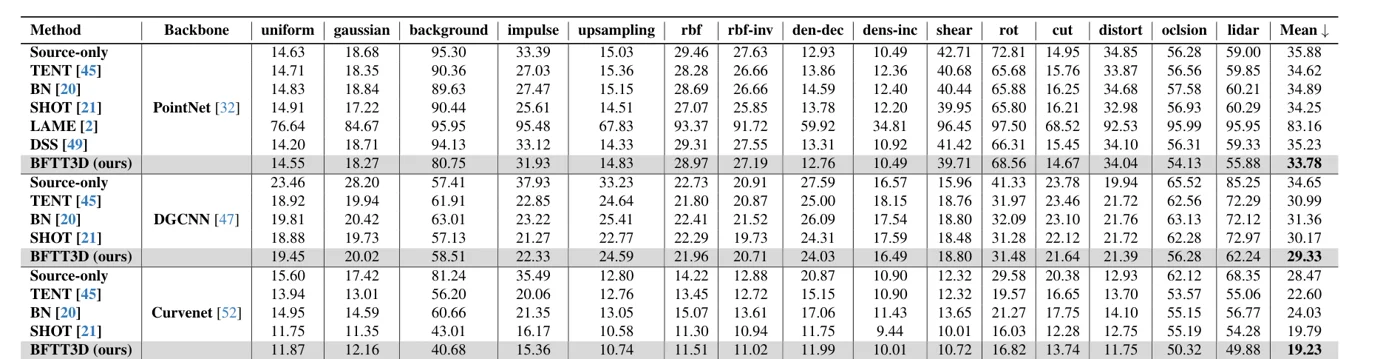 논문의 Table 1: PointNet, DGCNN, CurveNet에 대한 ModelNet-40C corruption별 classification error(%). BFTT3D 행은 음영 처리되어 있으며, 대부분의 향상은 몇 포인트 수준이고 가장 큰 것은 background noise이다. 논문 Figure.
ScanObjectNN-C에서는 baseline이 훨씬 불안정하다. SHOT은 세 backbone 모두에서 source model보다 나쁘고, BFTT3D는 거의 모든 열을 개선한다. CurveNet에서 background error는 81.93에서 68.85로, density decrease는 35.46에서 30.29로 내려간다.
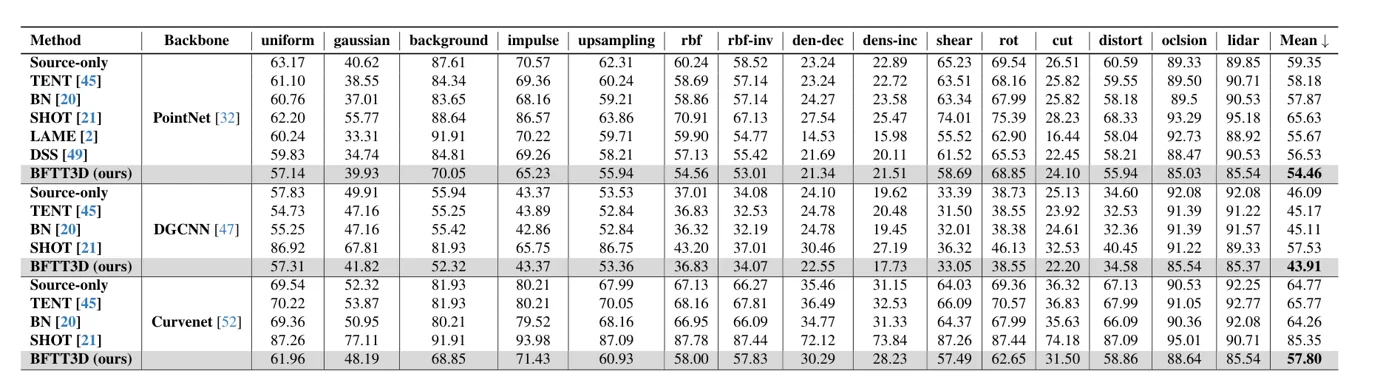 논문의 Table 2: ScanObjectNN-C corruption별 classification error(%). SHOT의 큰 증가(예: CurveNet impulse 93.98)와 BFTT3D의 꾸준한 향상을 비교해 볼 수 있다. 논문 Figure.
Fusion weight에 대한 ablation은 entropy 기반 \(p\)가 tuning을 대신할 만한지 확인한다. 모든 corruption 유형에서 adaptive \(p\)의 error는 exhaustive search로 찾은 최적의 고정 \(p\)보다 몇 포인트 높은 수준에 머물고, 두 곡선의 모양도 같다.
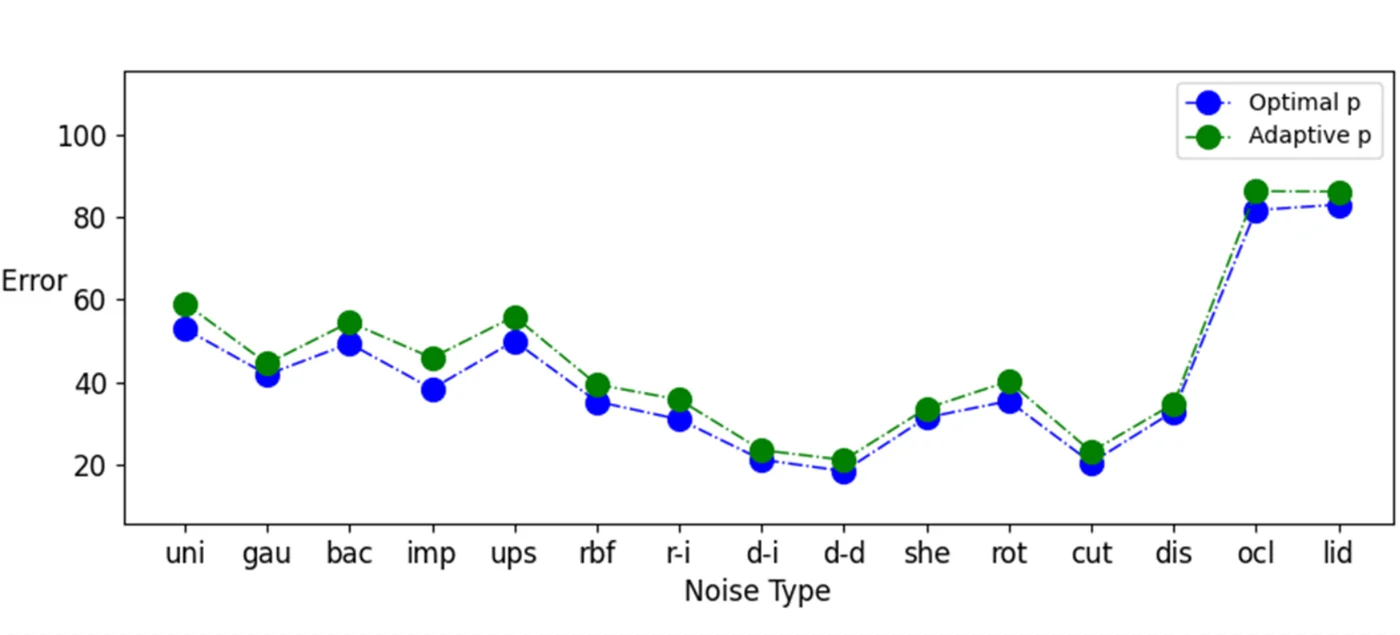 ModelNet40-C에서 PointNet으로 구한 corruption 유형별 error. Exhaustive search로 찾은 최적의 고정 \(p\)(파란색)와 entropy 기반 adaptive \(p\)(초록색). Adaptive ratio는 validation 데이터 없이도 oracle을 가깝게 따라간다. 논문 Figure.
Limitations
- 테스트 시점의 source 데이터. Prototype memory는 source feature(기본적으로 그중 25%)로 만든다. 이는 엄격한 source-free 설정에 맞지 않는다.
- Batch마다 TCA. Subspace는 모든 prototype과 현재 테스트 feature에 대한 kernel matrix로부터 풀며, 역행렬과 eigendecomposition이 뒤따른다. 비용은 memory 크기에 따라 늘어난다. 논문은 시간을 제시하지 않는다. 이후의 논문(Purge-Gate, ICCV 2025)은 Point-MAE backbone에서 BFTT3D가 batch당 173.94 ms와 7400 MiB의 GPU memory를 쓴다고 측정했다.
- 테스트 샘플 batch가 필요하다. MMD/TCA 단계는 \(n_t\)개 테스트 feature의 집합을 prototype과 정렬한다. 사용한 테스트 batch size는 명시되지 않았고, 단일 샘플에서의 동작은 연구되지 않았다.
- ModelNet-40C에서의 작은 향상. PointNet에서 평균 error는 35.88에서 33.78로 내려간다. 개별 corruption에서는 source model보다 나빠질 수도 있다(DGCNN의 ModelNet-40C shear: 15.96에서 18.80).
- 추론 시 두 개의 encoder. 모든 테스트 샘플이 source model과 non-parametric network를 모두 거친다.