Abstract
Multimodal LLM은 cross-modal hallucination을 겪는다. 한 modality가 다른 modality에 대한 생성에 간섭하는 현상으로, 예를 들어 video 때문에 모델이 audio에 없는 소리를 “듣는” 경우이다. 저자들은 이것이 각 modality 내부의 representation 문제가 아니라고 주장한다. 모델이 modality들이 서로 미치는 영향을 제어하지 못하는 것이다. 답해야 할 질문은 다음과 같다: 이 질문에 대해 모델은 audio를 얼마나, video를 얼마나 신뢰해야 하는가?
기존 contrastive decoding(CD) 방법은 모든 질문에 고정된 contrastive strength를 사용한다. MAD는 모델에게 추가로 한 가지 질문을 한다: 이 질문에는 audio, video, 혹은 둘 다가 필요한가? 그 답을 4-branch CD 수식의 branch별 가중치로 바꾼다. 학습은 필요 없다.
Motivation
논문은 구체적인 실패 사례로 시작한다. Video와 그 소리를 설명하라는 요청에, base audio-visual LLM은 visual content를 지어낼 뿐 아니라, 더 나쁘게는 장면에 어울리는 소리까지 지어낸다. 보트 옆에 선 남자는 낚시 요령을 알려주는 사람이 되고, audio에는 “가끔 물 밖으로 뛰어오르는 물고기의 첨벙 소리”가 들린다고 한다. 강한 visual cue가 audio 설명으로 새어 들어간 것이다.
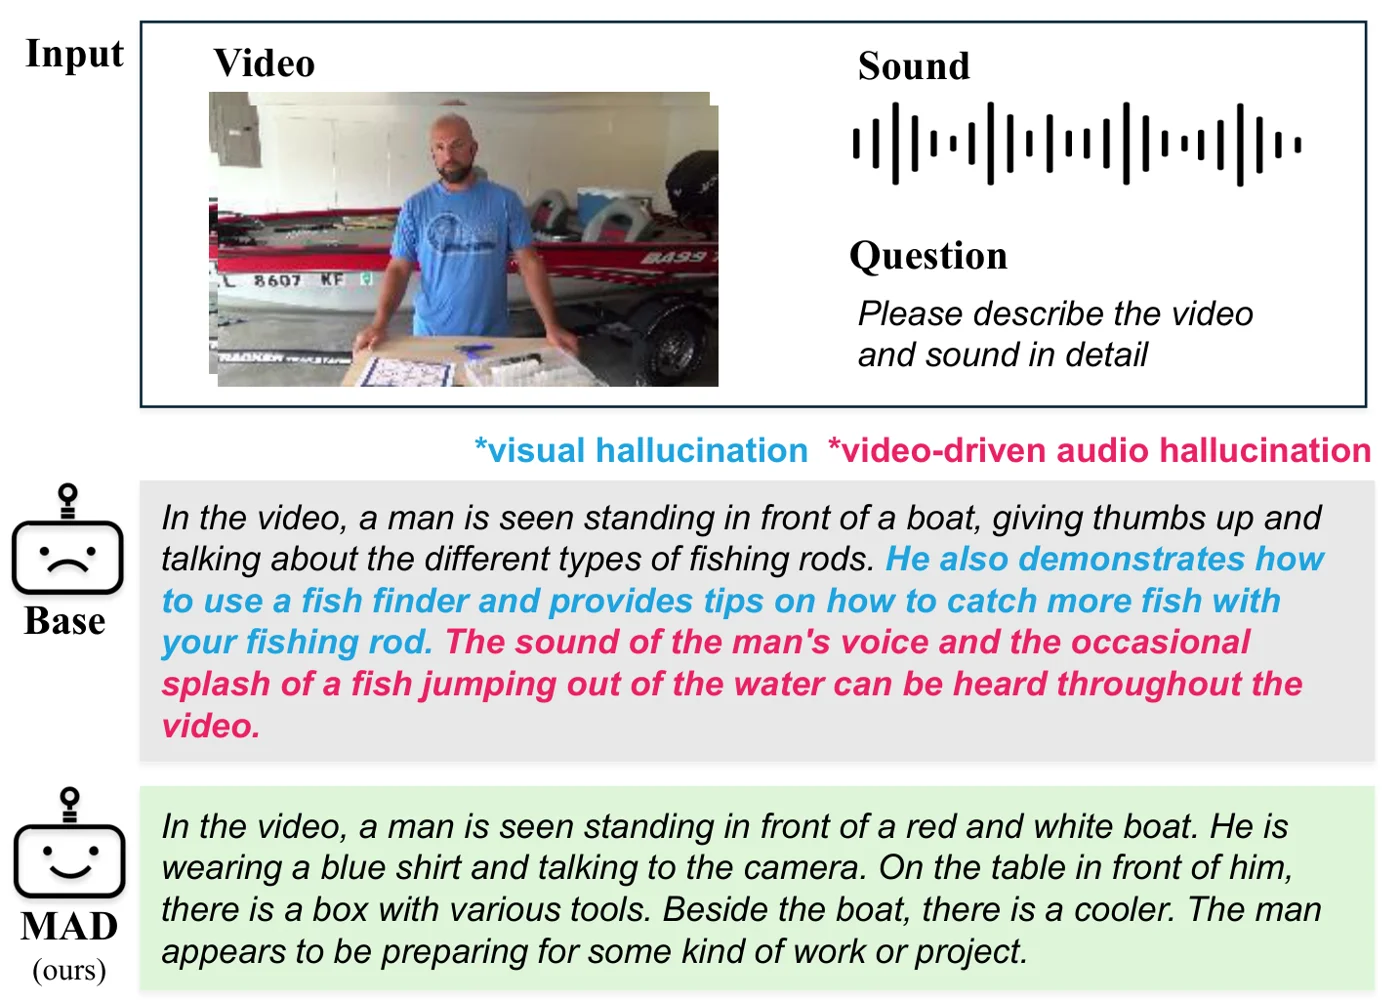 보트 앞에 선 남자의 video와 “video와 sound를 자세히 설명하라”는 prompt. Base model은 visual hallucination(파란색)과 물고기 첨벙 소리 같은 video-driven audio hallucination(빨간색)을 더한다. MAD의 설명은 실제로 있는 내용에 머문다. 논문 Figure.
저자들은 이것이 한 modality의 encoder가 약해서가 아니라 modality-interaction control의 실패라고 본다. 모델은 task에 어떤 modality가 신뢰할 만하고 관련 있는지 판단하고, 나머지가 새어 들어오지 않게 막아야 한다. 기존 training-free 해법은 이를 하지 못한다. VCD 계열 contrastive decoding은 hallucination이 visual input에서 온다고 가정하고, AVCD는 CD를 audio와 video로 확장하지만 질문이 무엇을 묻든 모든 modality에 같은 distortion과 strength를 적용한다. MAD의 insight는 질문에 어떤 modality가 필요한지를 모델 스스로 말할 수 있고, 이 self-assessment로 각 contrastive branch를 얼마나 강하게 적용할지 조절할 수 있다는 것이다.
Method
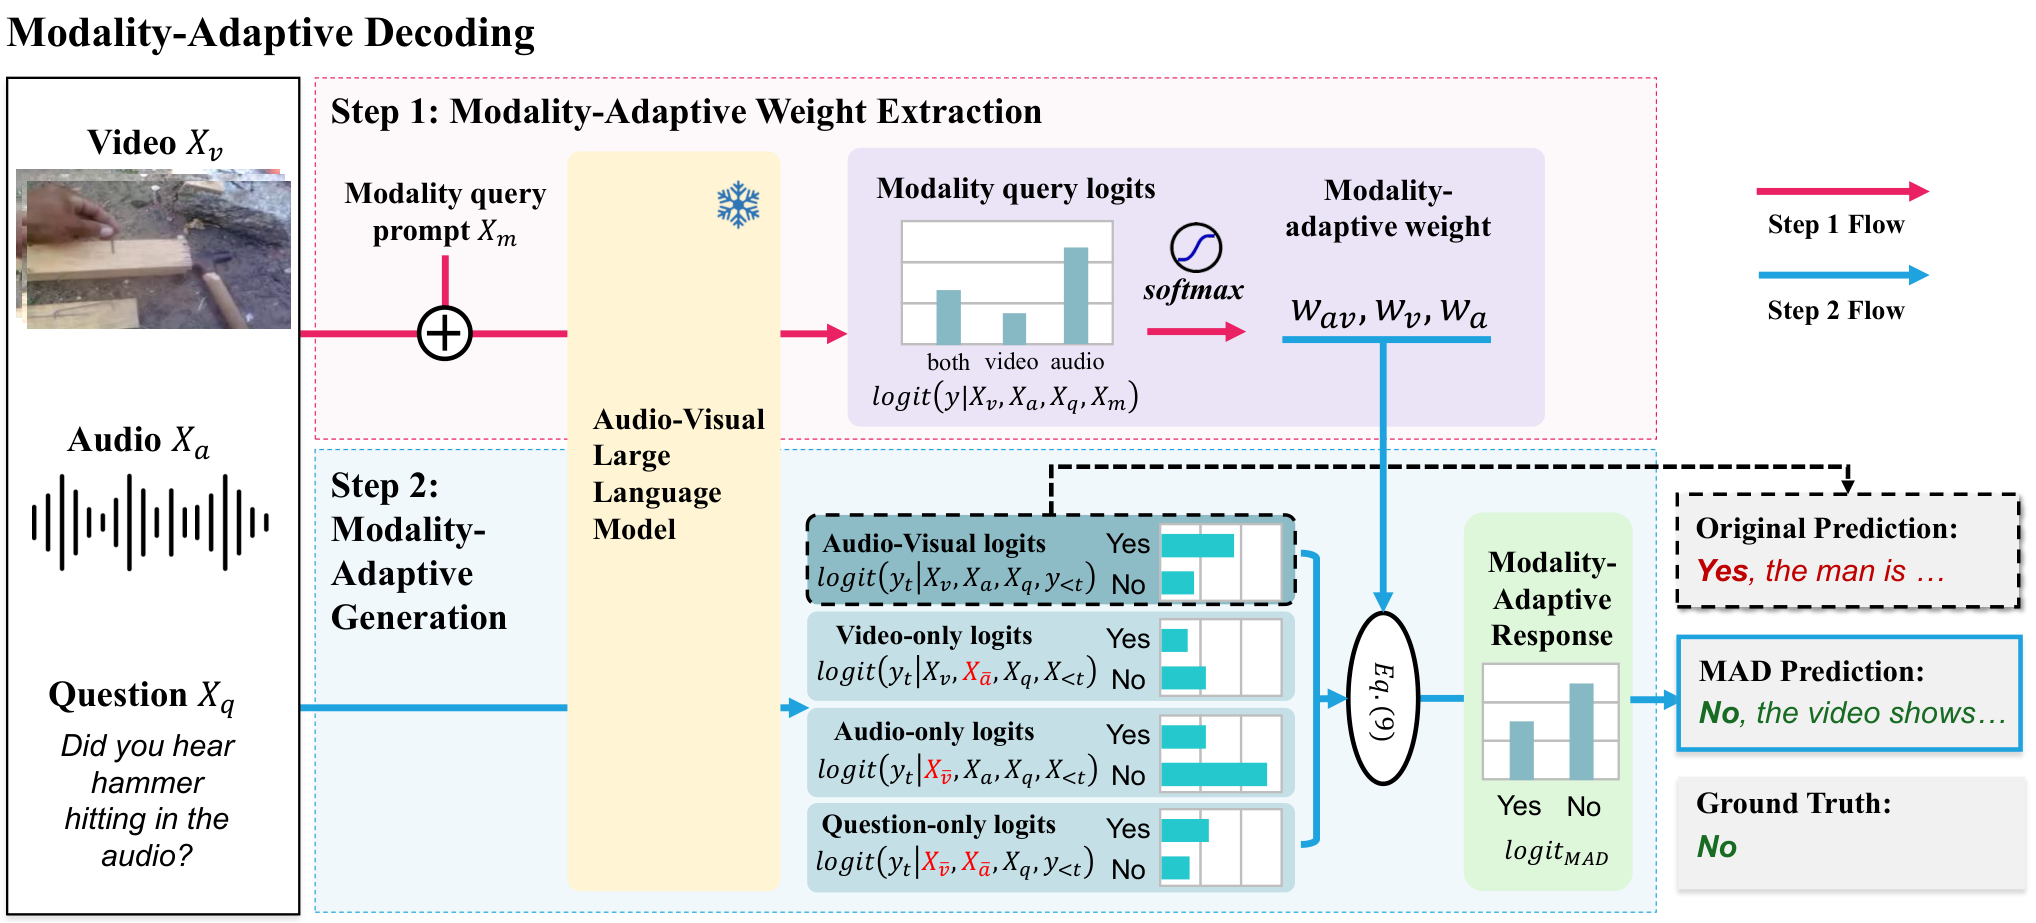 두 단계로 이루어진 MAD. Step 1은 modality query prompt로부터 modality weight를 추출한다. Step 2는 그 가중치로 네 branch의 logit을 결합한다. 그림은 논문에서 가져왔다.
Weighted contrastive decoding
Modality \(m\)에 대해 contrastive signal은 \(X_m\)이 있을 때의 logit에서 열화된 \(\tilde X_m\)이 있을 때의 logit을 뺀 것이다. 예를 들어 \(\Delta_a = z(A) - z(\tilde A)\)이다. MAD는 contrastive strength를 두 인자로 나눈다.
\[\mathrm{logit}^{(m)}(y_t) = \mathrm{logit}(y_t \mid X_m, X_q, y_{<t}) + \gamma\, w_m \Delta_m\]여기서 \(\gamma\)는 global strength이고, \(w_m\)은 이 질문에 대해 modality \(m\)이 얼마나 중요한지를 나타낸다.
Step 1: Modality-adaptive weight extraction (top)
모델은 입력과 함께, 질문에 어떤 modality가 필요한지 묻는 modality query prompt \(X_m\)을 받는다. 모델은 답을 생성하지 않는다. MAD는 세 후보 단어의 next-token logit을 읽고 softmax를 적용한다.
\[[w_{av}, w_v, w_a] = \mathrm{softmax}\big([z_{\text{both}}, z_{\text{video}}, z_{\text{audio}}]\big)\]가중치는 질문 유형을 따라간다. Benchmark 전체 평균으로 visual 질문은 \(w_v = 0.565\), audio 질문은 \(w_a = 0.482\), audio-visual 질문은 \(w_{av} = 0.464\)를 받는다.
Step 2: Modality-adaptive generation (bottom)
AVCD와 마찬가지로 MAD는 네 branch를 사용한다: audio-visual \(z_{VA}\), video-only \(z_{V\tilde A}\), audio-only \(z_{\tilde V A}\), question-only \(z_{\tilde V \tilde A}\). 이들은 정사각형을 이루며, 각 변이 하나의 CD 항이다. Audio가 있을 때와 없을 때의 visual CD, video가 있을 때와 없을 때의 audio CD이다. 다른 modality가 있는 상태에서 취한 항은 \(w_{av}\)를, 없는 상태에서 취한 항은 \(w_v\) 또는 \(w_a\)를 사용한다. 네 항을 더하고 계수를 정리하면 그림의 Eq. (9)가 된다.
\[z_{\text{MAD}} = (2 + 2\gamma w_{av})\, z_{VA} + (1 - \gamma w_{av} + \gamma w_a)\, z_{\tilde V A} + (1 - \gamma w_{av} + \gamma w_v)\, z_{V \tilde A} - \gamma (w_v + w_a)\, z_{\tilde V \tilde A}\]그림의 예시에서 질문은 망치 소리에 대해 묻는다. 가중치는 audio를 선호하고, audio-only branch는 “No”라고 답하며, MAD는 원래의 “Yes”를 올바른 “No”로 뒤집는다.
Main Experiments
CMM은 visual-dominant, audio-dominant, language-dominant subset에 대한 정확도를 보고한다. AVHBench는 video로 인한 audio hallucination과 audio로 인한 video hallucination에 대한 정확도를 보고한다.
| Model | Visual Dom. | Audio Dom. | Lang. Dom. | CMM Overall | V→A Hall. | A→V Hall. | AVHBench Overall |
|---|---|---|---|---|---|---|---|
| VideoLLaMA2-AV | 71.8 | 80.0 | 68.8 | 73.5 | 75.7 | 79.0 | 77.4 |
| + VCD (extended) | 71.3 | 83.3 | 74.8 | 76.4 | 66.0 | 74.8 | 70.4 |
| + AVCD | 71.8 | 84.0 | 71.5 | 75.8 | 78.3 | 80.3 | 79.3 |
| + MAD | 82.3 | 84.3 | 77.5 | 81.3 | 79.7 | 79.1 | 79.4 |
| Qwen2.5-Omni-7B | 64.5 | 72.3 | 81.3 | 72.7 | 73.0 | 80.7 | 76.9 |
| + VCD (extended) | 62.5 | 71.3 | 84.5 | 72.8 | 70.3 | 77.1 | 73.7 |
| + AVCD | 66.3 | 72.8 | 81.0 | 73.3 | 75.8 | 79.7 | 77.8 |
| + MAD | 76.8 | 84.3 | 83.3 | 81.4 | 78.7 | 84.4 | 81.6 |
- 가장 큰 도약은 CMM visual-dominant 질문에서 나타난다: VideoLLaMA2-AV는 +10.5, Qwen2.5-Omni는 +12.3. AVCD는 이 열을 거의 움직이지 못한다.
- 전체 softmax로 가중하는 방식(81.3)이 균등 가중치(79.4)와 argmax에 모든 가중치를 두는 방식(78.7)보다 낫다.
- MAD는 VideoLLaMA2-AV의 일반적인 audio-visual 이해를 해치지 않는다: OmniBench 36.3 → 36.8, WorldSense 23.3 → 25.6, MUSIC-AVQA 78.1 → 79.1.
Weight 자체도 타당해 보인다. VideoMME video 100개에 대해 직접 만든 질문 300개(visual 100, audio 100, audio-visual 100)에서, 가장 큰 평균 weight는 항상 질문 유형이 필요로 하는 modality에 놓인다.
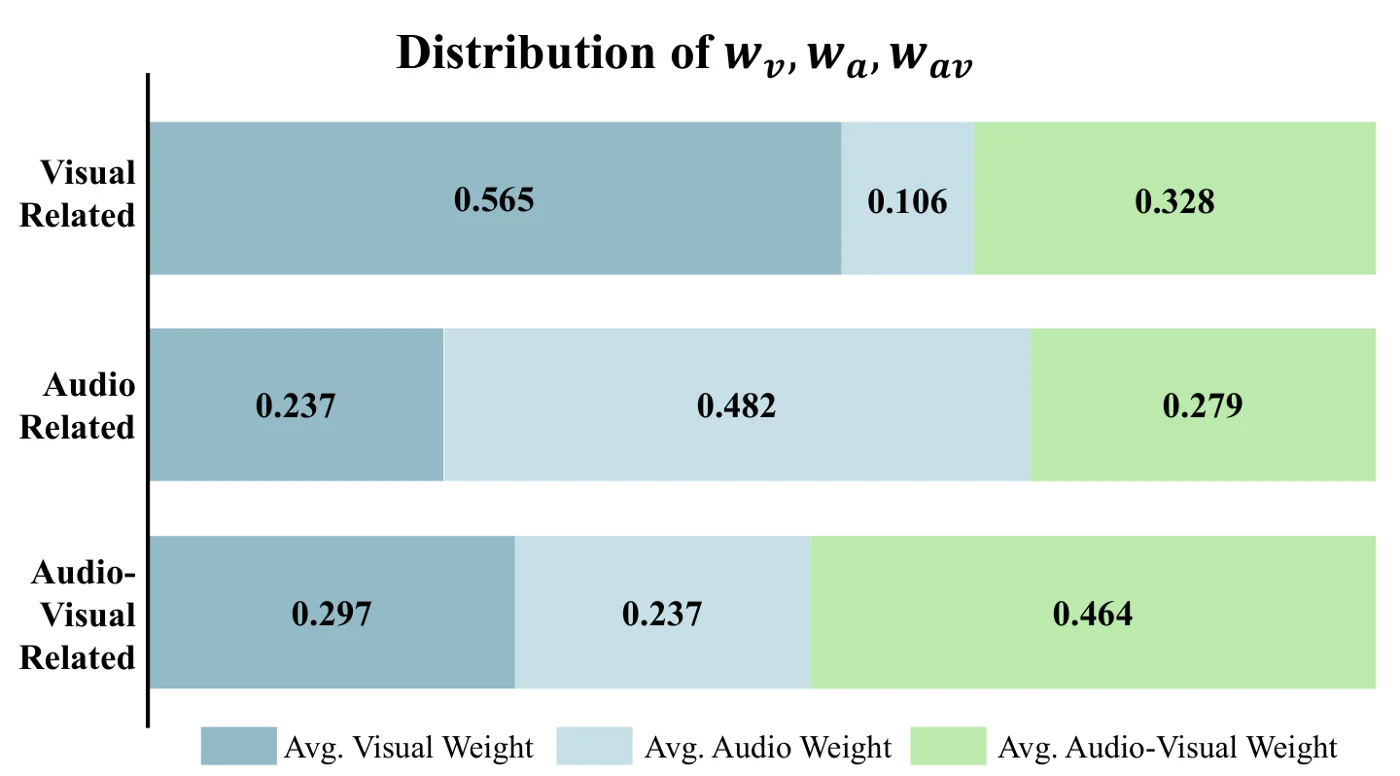 질문 유형별 평균 \(w_v\), \(w_a\), \(w_{av}\). Supervision 없이도 visual 질문은 video(0.565), audio 질문은 audio(0.482), audio-visual 질문은 둘 다(0.464)에 가장 큰 weight를 둔다. 논문 Figure.
Supplement는 이를 VideoLLaMA2-AV로 CMM에서 반복한다. Hallucination 관점에서 유용한 패턴이 나온다. Vision이 지배적이어서 audio hallucination이 위험한 경우 모델은 audio에 가장 큰 weight를 두고, audio-dominant 경우에는 그 반대이다.
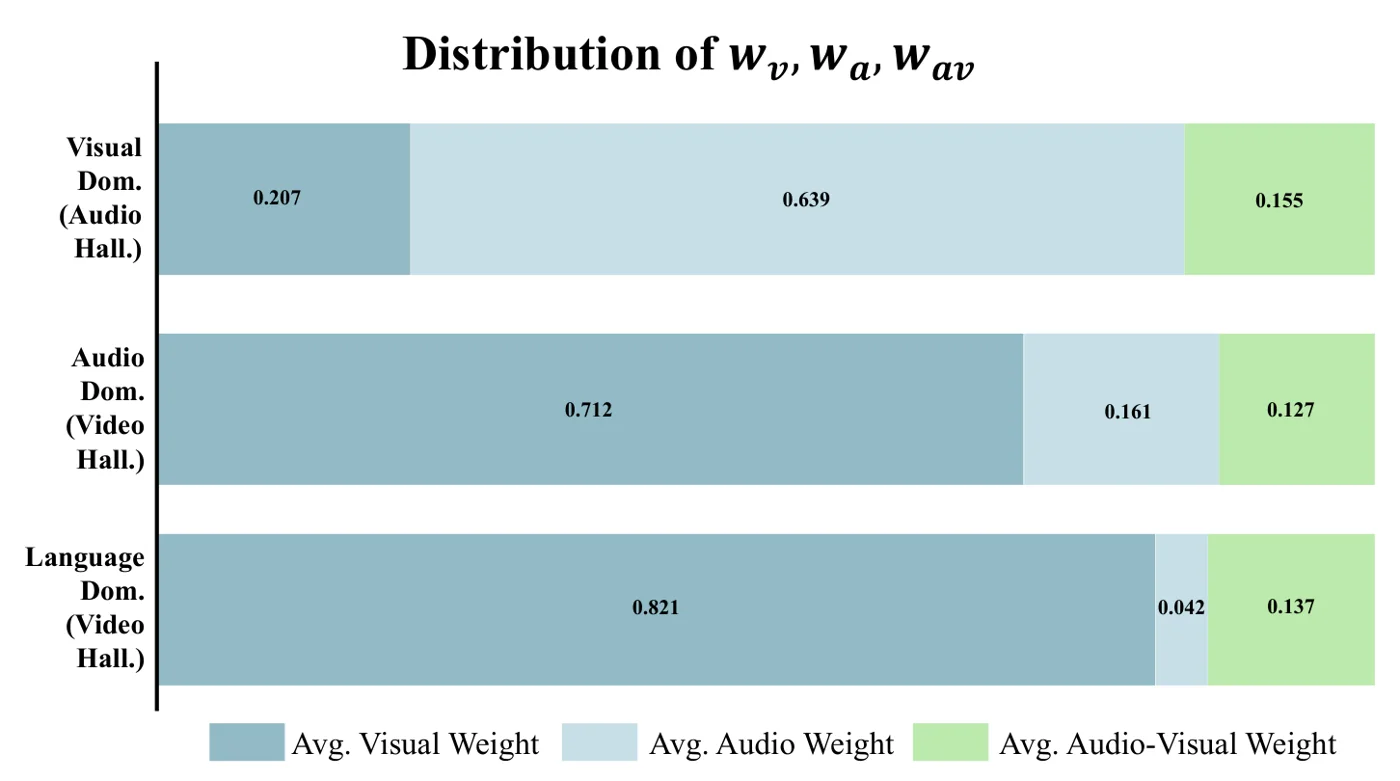 CMM에서의 weight. Visual-dominant 질문(audio hallucination)은 \(w_a = 0.639\)를, audio-dominant와 language-dominant 질문(video hallucination)은 \(w_v = 0.712\)와 \(0.821\)을 받는다. 논문 Figure.
Global strength \(\gamma\)는 0.5에서 3.0까지 바꿔 본다. Accuracy는 약 2.0까지 가파르게 오른 뒤 평평해지며, 모든 실험에서 \(\gamma = 2.5\)를 쓴다.
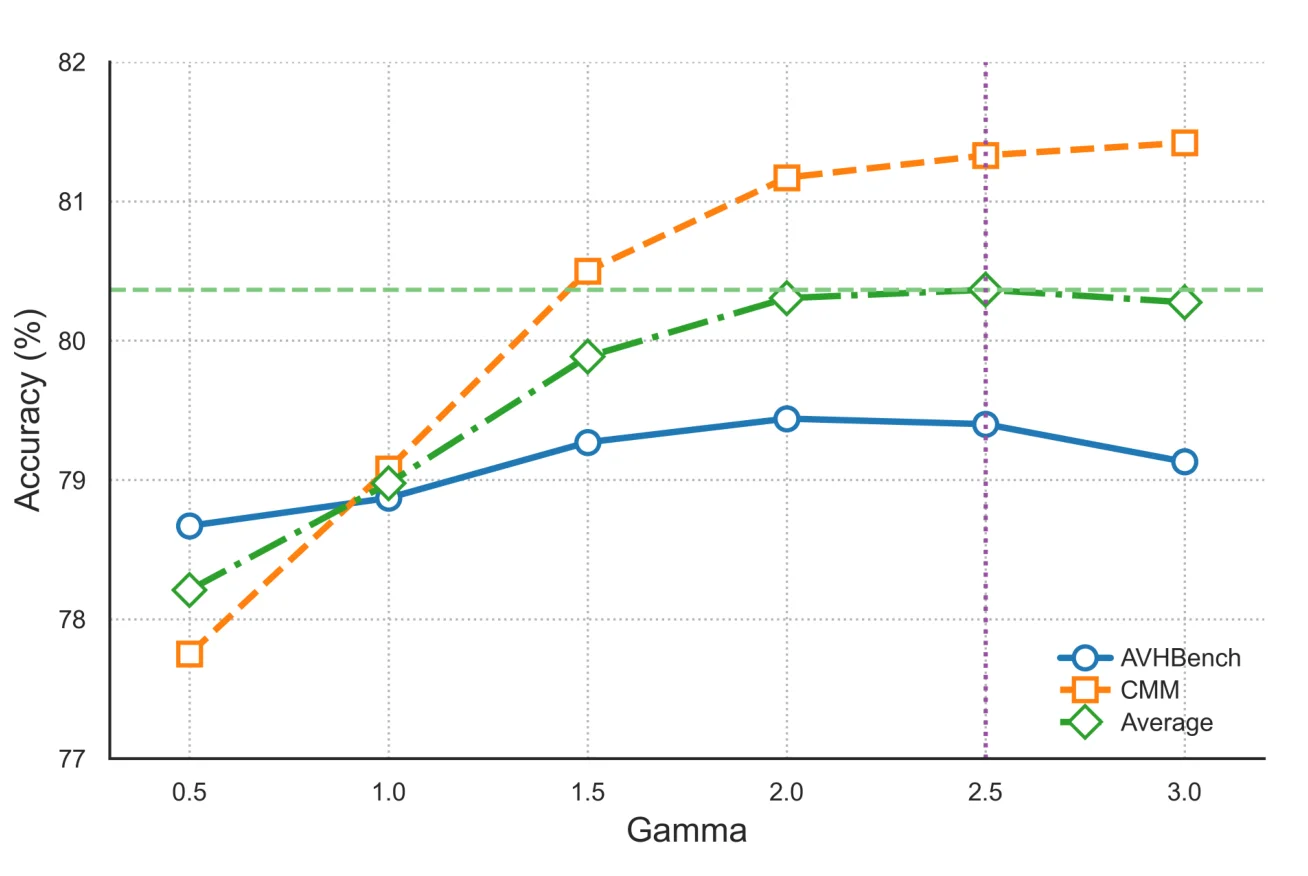 VideoLLaMA2-AV에서 \(\gamma\)에 따른 AVHBench, CMM, 그리고 둘의 평균 accuracy. CMM은 큰 \(\gamma\)에서 가장 이득을 보고, AVHBench는 2.0 근처에서 최고이며, 평균은 2.0과 3.0 사이에서 평평하다. 논문 Figure(supplement).
Limitations
- 비용. Token마다 네 branch가 필요하고, modality query prompt를 위한 추가 pass가 한 번 더 필요하다.
- Relevance는 agreement가 아니다. 가중치는 어떤 modality가 관련 있는지를 말해줄 뿐, unimodal branch들이 joint prediction과 일치하는지는 말해주지 않는다. 관련 있는 두 modality가 여전히 충돌할 수 있으며, MAD는 이를 감지하지 못한다.
- Self-assessment가 정확해야 한다. 모델이 질문에 필요한 modality를 잘못 판단하면, 가중치가 decoding을 잘못된 방향으로 민다.