Abstract
Test-time prompt tuning (TPT)은 label이 없는 각 테스트 이미지에서 entropy minimization objective로 prompt를 tuning해 CLIP의 zero-shot accuracy를 높인다. Entropy minimization은 예측을 더 확신하게 만들며, 논문은 이 때문에 TPT의 calibration이 나빠진다는 것을 보인다. 즉 confidence가 실제로 맞히는 빈도와 더 이상 일치하지 않는다. Temperature scaling이나 학습 가능한 calibration loss 같은 표준적인 해결책은 label이 있는 데이터가 필요한데, 테스트 시점에는 그런 데이터가 없다.
논문은 CLIP 내부에서 label 없이 쓸 수 있는 신호를 찾는다. Accuracy가 비슷한 여러 hand-crafted prompt를 비교해 보면, class text feature가 더 넓게 퍼진 prompt일수록 calibration error가 낮다. 저자들은 이 퍼짐을 Average Text Feature Dispersion (ATFD)으로 측정하고, \(-\text{ATFD}\)를 TPT의 regularization 항으로 추가한다. 그 결과인 C-TPT는 TPT의 accuracy 향상 대부분을 유지하면서, fine-grained benchmark에서 expected calibration error (ECE)를 대략 절반으로 줄인다.
Motivation
논문은 StanfordCars와 CLIP-ViT-B/16으로 세 단계에 걸쳐 논지를 쌓는다. 첫째는 문제 자체이다. Hard prompt “an example of {class}”로 zero-shot CLIP은 accuracy 64.6%, ECE 2.49를 얻는다. TPT 후에는 accuracy가 67.3%로 오르지만 ECE가 6.26으로 뛰고, reliability diagram에서는 거의 모든 confidence bin에서 막대가 대각선 아래로 내려간다. 즉 overconfidence이다. Entropy minimization은 confident한 예측에 보상을 주므로 예상할 수 있는 부작용이다.
둘째는 prompt가 calibration을 좌우한다는 단서이다. 80개 hand-crafted template에서 대부분의 prompt는 accuracy 약 60~66%에 모이지만, ECE는 약 2에서 8까지 퍼져 있다. 셋째는 그에 대한 설명 후보이다. Accuracy가 거의 같은(61.9~62.2) prompt들 중 ECE가 높은 것(8.55, 9.02)은 t-SNE에서 text feature가 좁은 영역에 몰려 있고, ECE가 낮은 것은 넓게 퍼져 있다.
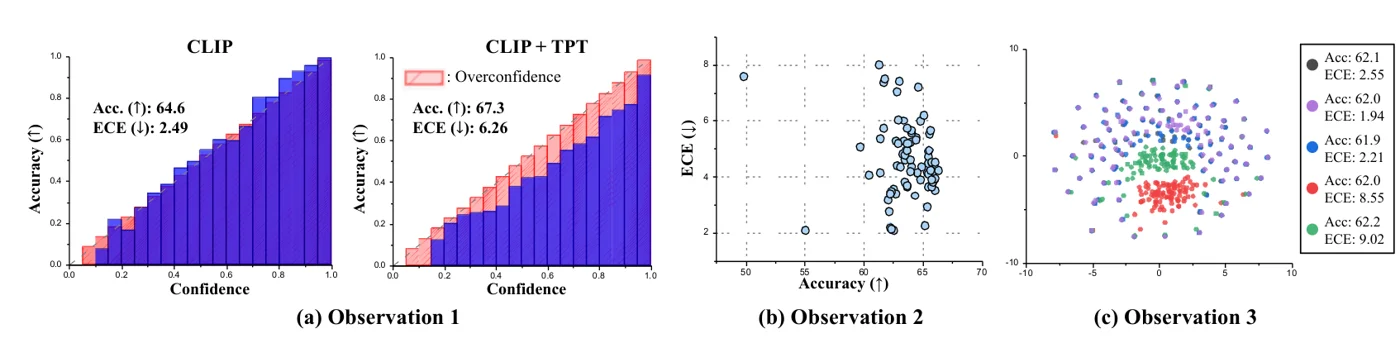 (a) StanfordCars에서 CLIP과 CLIP + TPT의 reliability diagram. 빨간 빗금 영역이 TPT가 더한 overconfidence이다. (b) 80개 hard prompt template의 accuracy 대 ECE: accuracy는 비슷하지만 ECE는 크게 다르다. (c) accuracy 약 62%인 다섯 prompt의 class text feature t-SNE. Calibration이 나쁜 두 prompt(빨강, 초록)가 가운데에 뭉쳐 있다. 논문 Figure.
t-SNE에서 받은 인상을 측정 가능한 양으로 바꾸기 위해, 저자들은 ATFD를 정의하고 여러 데이터셋에서 확인한다. 각 데이터셋 최고 accuracy와 3% 이내인 prompt들에서, 두 backbone 모두 거의 모든 데이터셋에서 ATFD가 높을수록 ECE가 낮다. 이 correlation이 방법에 필요한 label-free 신호이다. Dispersion은 test time에 text feature만으로 계산할 수 있다.
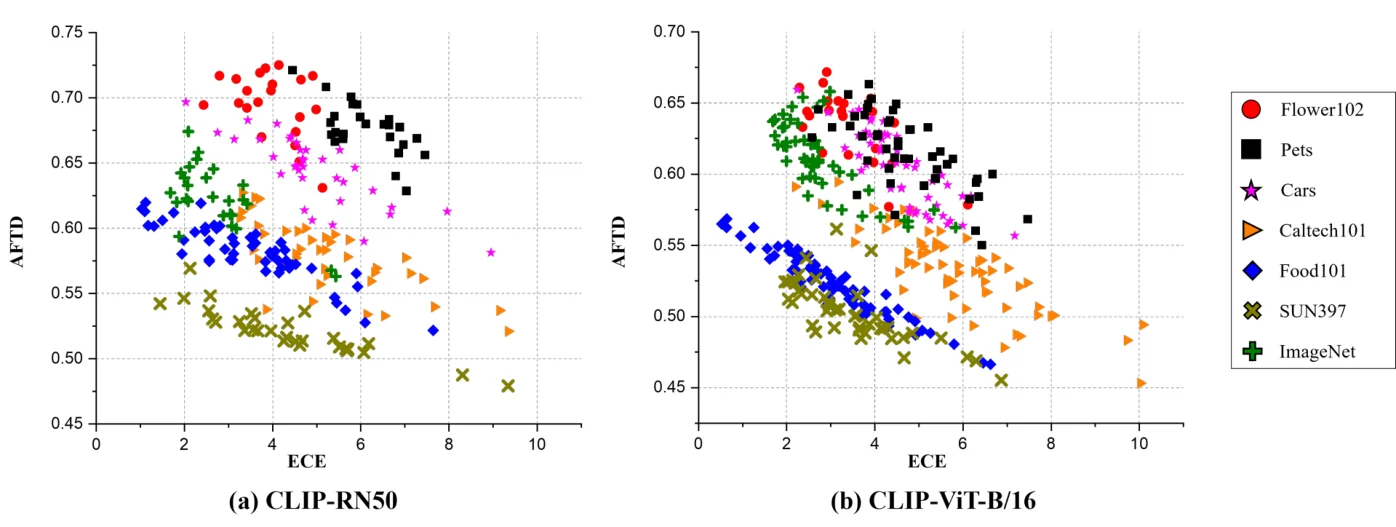 CLIP-RN50(a)과 CLIP-ViT-B/16(b)에서 accuracy가 최고 수준에 가까운 hard prompt들의 ATFD(y축, 그림에는 AFTD로 표기) 대 ECE, 7개 데이터셋. 각 데이터셋 안에서 점들이 오른쪽 아래로 기운다. Dispersion이 클수록 calibration error가 낮다. 평균 Pearson correlation은 -0.70과 -0.76이다. 논문 Figure.
Method
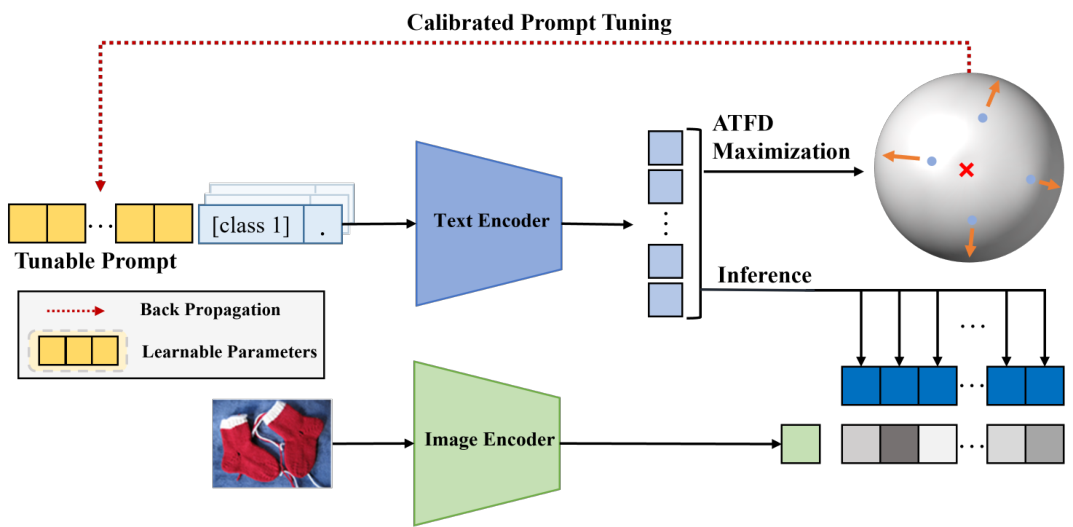 C-TPT. Tunable prompt를 모든 class name과 결합해 text encoder에 통과시킨다. Test-time tuning 동안, 그 결과로 얻은 class text feature의 dispersion(ATFD)을 TPT loss와 함께 최대화한다. Tuning된 text feature는 이후 image feature와 함께 inference에 쓰인다. 그림은 논문에서 가져왔다.
Three observations
이 방법은 주로 CLIP-ViT-B/16으로 보인 세 가지 관찰에 기반한다.
- TPT는 calibration error를 키운다. StanfordCars의 reliability diagram은 TPT가 hard prompt보다 accuracy를 높이지만 overconfident하게 됨을 보여 준다.
- Accuracy가 비슷한 prompt도 ECE는 크게 다를 수 있다. 80개의 hand-crafted CLIP template에 걸쳐, 같은 accuracy 수준에서도 ECE가 넓게 분포한다.
- Calibration이 잘 된 prompt는 text feature가 퍼져 있다. t-SNE 그림에서 calibration이 나쁜 prompt의 class text feature는 촘촘한 cluster로 뭉친다. Calibration이 잘 된 prompt의 feature는 퍼져 있고 각자의 클래스 근처에 놓인다.
Image feature는 prompt에 의존하지 않으므로, prompt 사이의 calibration 차이는 반드시 text 쪽에서 비롯된다. 그래서 논문은 text feature의 기하 구조에 집중한다.
Average Text Feature Dispersion
Prompt \(\mathbf{p}\)와 \(N\)개 클래스에 대해, \(\mathbf{t}_{[\mathbf{p};y_i]}\)를 “\(\mathbf{p}\) + 클래스 \(y_i\)“라는 설명의 text feature라 하자. Class feature들의 centroid는
\[\mathbf{t}_{\text{centroid}} = \frac{1}{N}\sum_{i=1}^{N} \mathbf{t}_{[\mathbf{p};y_i]},\]이고, ATFD는 그 centroid로부터의 평균 L2 distance이다.
\[\text{ATFD} = \frac{1}{N}\sum_{i=1}^{N} \left\| \mathbf{t}_{\text{centroid}} - \mathbf{t}_{[\mathbf{p};y_i]} \right\|_2 .\]저자들은 각 데이터셋에서 최고 prompt와 accuracy 차이가 3% 이내인 hard prompt들을 골라 ATFD와 ECE를 비교한다. ATFD와 ECE 사이의 Pearson correlation은 데이터셋 평균으로 CLIP-RN50에서 \(-0.70\), CLIP-ViT-B/16에서 \(-0.76\)이다.
Calibrated test-time prompt tuning
C-TPT는 TPT objective에 음의 ATFD를 더한다.
\[\mathbf{p}^{*} = \arg\min_{\mathbf{p}} \left[ \mathcal{L}_{\text{TPT}} + \lambda \cdot \mathcal{L}_{\text{C-TPT}} \right], \qquad \mathcal{L}_{\text{C-TPT}} = -\text{ATFD}\left(\mathbf{t}_{[\mathbf{p};y_1]}, \dots, \mathbf{t}_{[\mathbf{p};y_N]}\right).\]\(\mathcal{L}_{\text{TPT}}\)는 통상적인 TPT loss로, 테스트 이미지의 confidence 높은 augmented view들에 대한 평균 예측의 entropy이다. 새 항은 class 설명의 text feature만 필요로 하므로, label도 image 통계도 쓰지 않는다. 두 항 모두 prompt embedding만 update하며, CLIP의 두 encoder는 고정된다.
설정은 TPT를 따른다. Prompt는 “a photo of a”에서 시작해 learning rate 0.005의 AdamW 한 step을 받으며, 나머지 TPT 설정은 모두 유지한다. \(\lambda\)는 fine-grained 데이터셋에서 50.0, ImageNet 변형에서 20.0이다. 논문은 ensemble 설정도 보고하는데, 네 가지 hard prompt 초기화(“a photo of a”, “a photo of the”, “a picture of a”, “a picture of the”)를 각각 tuning하고 그 logit을 평균한다.
Caltech101에 대한 t-SNE 분석에서, 일반 TPT로 tuning한 prompt는 calibration이 나쁜 hard prompt처럼 text feature가 뭉친다. \(\lambda\)를 키우면 feature가 퍼지고 클래스별로 모인다.
Main Experiments
Backbone은 CLIP-RN50과 CLIP-ViT-B/16이다. 평가 지표는 top-1 accuracy(%, 높을수록 좋음)와 ECE(%, 낮을수록 좋음)이다. 표에는 hard prompt 및 ensemble 초기화에 대해 논문 Table 1과 2의 Average 열만 실었다.
Fine-grained classification, 11개 데이터셋 평균 (ImageNet, Caltech, Pets, Cars, Flower, Food101, Aircraft, SUN397, DTD, EuroSAT, UCF101)
| Setting | RN50 Acc. | RN50 ECE | ViT-B/16 Acc. | ViT-B/16 ECE |
|---|---|---|---|---|
| CLIP (hard prompt) | 55.9 | 5.61 | 63.7 | 4.43 |
| + TPT | 57.7 | 11.7 | 65.0 | 11.6 |
| + TPT + C-TPT | 57.8 | 6.20 | 64.8 | 5.13 |
| CLIP (ensemble) | 57.1 | 5.58 | 64.2 | 5.82 |
| + TPT | 58.2 | 10.7 | 65.5 | 9.91 |
| + TPT + C-TPT | 58.5 | 5.20 | 65.8 | 4.62 |
Natural distribution shift, ImageNet-A, -V2, -R, -Sketch 평균
| Setting | RN50 Acc. | RN50 ECE | ViT-B/16 Acc. | ViT-B/16 ECE |
|---|---|---|---|---|
| CLIP (hard prompt) | 40.6 | 7.46 | 57.2 | 5.04 |
| + TPT | 43.5 | 16.7 | 59.9 | 12.0 |
| + TPT + C-TPT | 42.8 | 12.1 | 59.6 | 5.82 |
| CLIP (ensemble) | 42.0 | 9.06 | 58.4 | 6.10 |
| + TPT | 44.5 | 15.8 | 61.2 | 10.9 |
| + TPT + C-TPT | 44.0 | 13.6 | 60.7 | 8.32 |
TPT는 모든 설정에서 ECE를 1.7배에서 2.6배까지 키운다. C-TPT를 더하면 fine-grained 데이터셋에서 TPT의 ECE가 약 절반으로 줄어들고(47%~56% 감소), 평균 accuracy는 거의 변하지 않는다. Natural distribution shift에서는 향상이 더 작고(ECE 14%~52% 감소), C-TPT가 평균 accuracy를 최대 0.7포인트 깎는다. 대부분의 설정에서 C-TPT의 ECE는 여전히 tuning하지 않은 CLIP prompt보다 높다. ViT-B/16에서의 별도 비교에서, C-TPT는 label이 있는 ImageNet으로 temperature를 학습한 TPT보다 평균 ECE가 낮다.
이 비교는 자세히 볼 가치가 있다. Temperature scaling은 표준적인 해결책이고, 여기서는 C-TPT가 전혀 보지 못하는 labeled 데이터까지 쓰기 때문이다. 학습된 temperature는 대부분의 데이터셋에서 TPT의 ECE를 낮추지만, C-TPT는 그중 대부분에서 더 낮으며, 차이가 가장 뚜렷한 곳은 Aircraft, SUN397, UCF101, ImageNet 변형들이다. Flower102와 Food101에서는 temperature scaling이 이긴다.
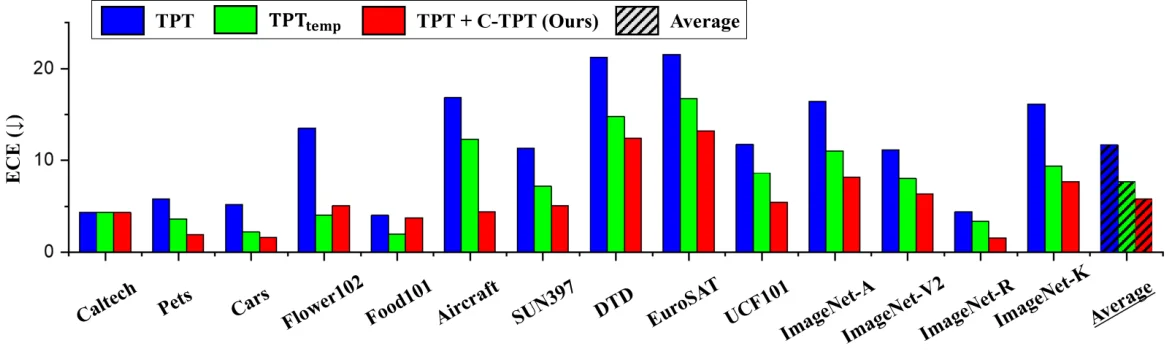 CLIP-ViT-B/16에서 TPT(파랑), labeled ImageNet으로 temperature를 학습한 TPT(초록), TPT + C-TPT(빨강)의 데이터셋별 ECE. C-TPT는 label을 전혀 쓰지 않고도 평균이 가장 낮다. 논문 Figure.
t-SNE 분석(7.2절)은 regularizer가 의도한 대로 기하 구조를 바꾸는지 확인한다. Caltech101의 hard prompt에서 calibration이 나쁜 template들은 class와 관계없이 빽빽한 덩어리를 이룬다. 일반 TPT도 비슷한 가운데 덩어리를 만든다(ATFD 0.423, ECE 5.04). C-TPT를 쓰고 \(\lambda\)를 45, 50, 55로 키우면 ATFD는 0.567까지 오르고 ECE는 1.98로 떨어지며, feature가 class별로 모인다.
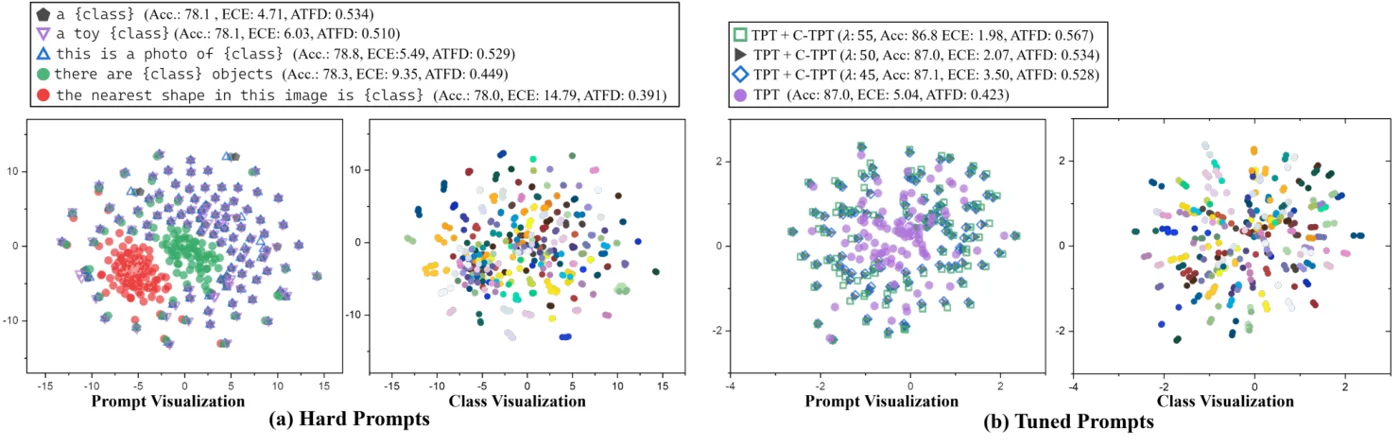 Caltech101에서 CLIP-RN50의 class text feature t-SNE. (a) accuracy가 비슷한 hard prompt들. Calibration이 나쁜 prompt(빨강, 초록)가 함께 뭉친다. (b) TPT(보라)는 가운데에 뭉치고, TPT + C-TPT는 \(\lambda\)가 커질수록 feature를 퍼뜨린다. 논문 Figure.
Limitations
- 소폭의 accuracy 하락 (저자들이 직접 언급). 다른 regularization 기반 calibration 방법처럼 C-TPT도 때때로 accuracy를 떨어뜨린다. 예로 ImageNet-A의 RN50(hard prompt 기준 25.2에서 23.4)과 UCF101의 ViT-B/16(67.3에서 65.7)이 있다.
- \(\lambda\)를 테스트 시점에 tuning할 수 없다 (저자들이 직접 언급). 저자들은 ECE와 ATFD가 포화되는 validation set 추세를 보고 값을 고르며, 샘플별로 최적이 아닐 수 있다고 언급한다. 부록은 50.0이라는 단일 값을 설명하지만 natural distribution shift 실험에서는 20.0을 사용하므로, 실제로는 benchmark마다 값이 다르다.
- Calibration은 개선되었을 뿐 해결되지 않았다. RN50의 ImageNet-A에서 ECE는 25.4(hard prompt)와 27.0(ensemble)에 머문다. DTD에서는 네 가지 설정에 걸쳐 11.9~19.8에 머문다.
- Correlation에 기반한 동기. ATFD/ECE 관계는 accuracy가 비슷한 hard prompt들에 대한 경험적 correlation이며, 7.2절의 설명은 t-SNE 그림에 기반한 정성적 설명이다.
- TPT의 비용을 그대로 물려받는다. 각 테스트 이미지에는 여전히 64개의 augmented view와 text encoder를 통한 backpropagation이 필요하다. ATFD 항은 모든 클래스의 text feature를 필요로 하지만, 이는 TPT forward pass에서 이미 계산된다.