Abstract
Contrastive decoding(CD)은 multimodal LLM의 object hallucination에 대응하는 가장 인기 있는 training-free 도구 중 하나이다. VCD, ICD, SID 같은 방법은 hallucination을 유도하도록 만든 “contrastive” 입력(noise를 넣은 이미지, 교란 instruction, pruning된 image token)을 만들고, 그 logit을 원래 logit에서 뺀다. 이들의 주된 근거는 POPE benchmark에서의 일관된 향상이다.
이 논문은 그 향상이 신기루라고 주장한다. POPE에서의 향상은 hallucination과 무관한 두 요인에서 나온다. (1) CD는 답변 분포를 한 방향, 즉 “Yes” 쪽으로 민다. 대부분의 POPE subset은 “No” 쪽으로 치우쳐 있어서, 이 이동이 우연히 균형을 맞춘다. (2) 모든 CD 방법이 쓰는 adaptive plausibility constraint는 후보 집합을 너무 강하게 잘라 sampling을 사실상 greedy search로 만들고, yes/no task에서는 greedy가 sampling보다 훨씬 낫다. 이를 보이기 위해 저자들은 각 요인을 hallucination 개념 없이 그대로 흉내 내는 spurious improvement method를 만들었고, 이들이 CD와 같거나 더 나은 결과를 낸다.
Motivation
CD를 제안한 논문들의 이야기는 명확하다. Contrastive 입력이 모델을 hallucinate하게 만들고, 그것을 빼면 hallucination이 사라진다는 것이다. 하지만 contrastive branch가 정말 hallucination을 유도하는지, 빼기가 답변에 실제로 무엇을 하는지는 아무도 확인하지 않았다.
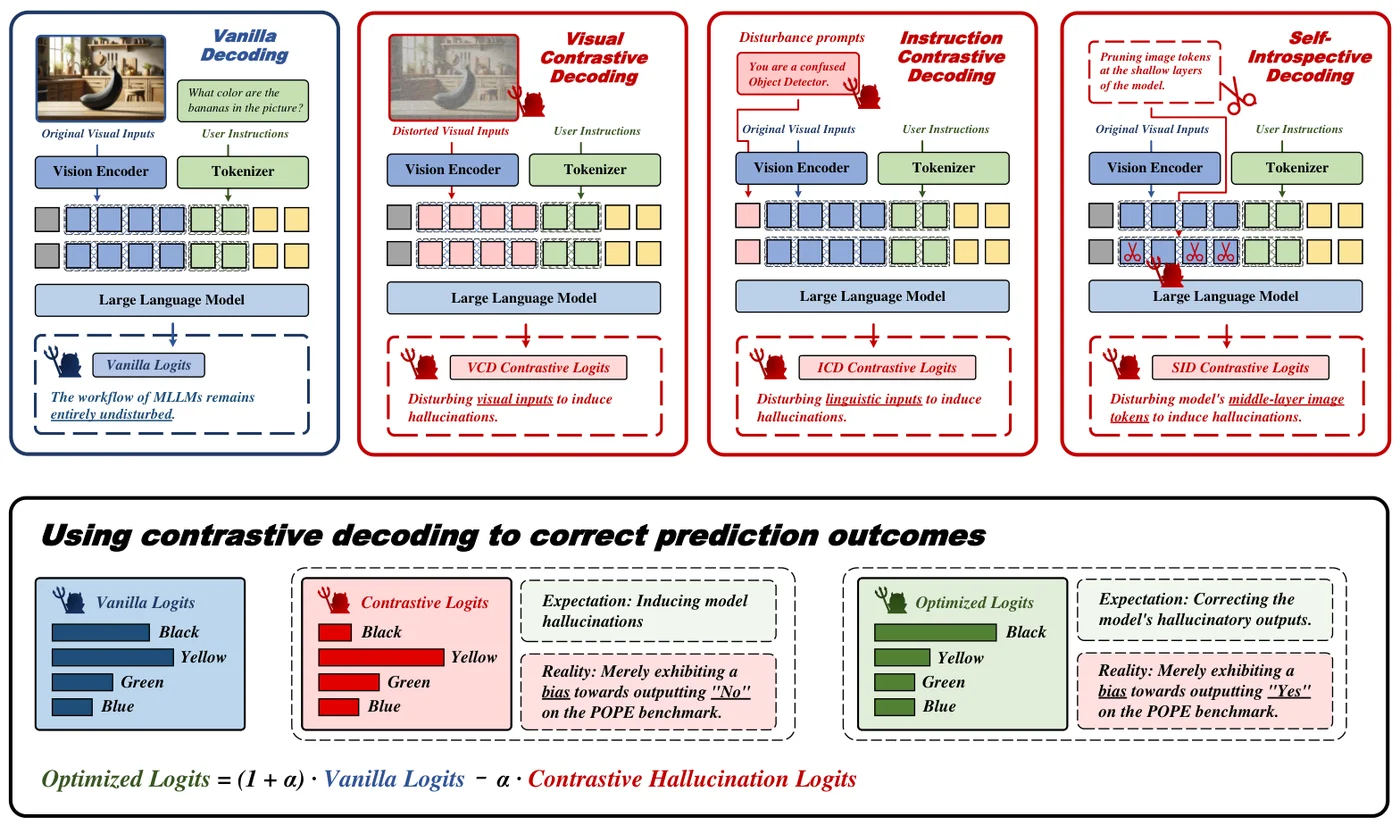 위: vanilla decoding과 세 CD 변형. VCD는 이미지를 왜곡하고, ICD는 교란 instruction(“You are a confused object detector”)을 더하며, SID는 초기 layer에서 image token을 pruning한다. 아래: 각 부분에 기대되는 역할과 POPE에서의 실제 동작. Contrastive branch는 hallucinate해야 하지만 실제로는 주로 “No” 쪽으로 치우쳐 있고, 따라서 그것을 빼면 최종 답이 “Yes” 쪽으로 치우친다. 논문 Figure.
첫 번째 확인은 간단하다. LLaVA-v1.5-7B와 greedy decoding으로 accuracy와 “Yes” 답변 비율을 함께 기록한다.
| Method | COCO Random Acc | COCO Random Yes % | GQA Adversarial Acc | GQA Adversarial Yes % |
|---|---|---|---|---|
| Greedy | 87.1 | 39.2 | 80.9 | 54.0 |
| VCD | 88.6 | 46.4 | 78.0 | 63.3 |
| SID | 87.9 | 42.3 | 79.9 | 57.8 |
| VCD contrastive branch alone | 76.7 | 28.2 | 71.5 | 41.3 |
| SID contrastive branch alone | 79.0 | 23.6 | 74.2 | 43.1 |
두 방법 모두 두 subset에서 Yes 비율을 높인다. 모델이 처음부터 “No” 쪽으로 치우친(39.2%) COCO Random에서는 이것이 도움이 된다. 이미 “Yes” 쪽으로 치우친(54.0%) GQA Adversarial에서는 같은 이동이 accuracy를 떨어뜨린다. Contrastive branch 단독의 오답은 대부분 object를 hallucinate해서가 아니라 “No”를 너무 자주 말해서 생긴다(Yes 23.6-43.1%). “No”로 치우친 branch를 빼면 최종 답은 “Yes” 쪽으로만 밀릴 수 있다.
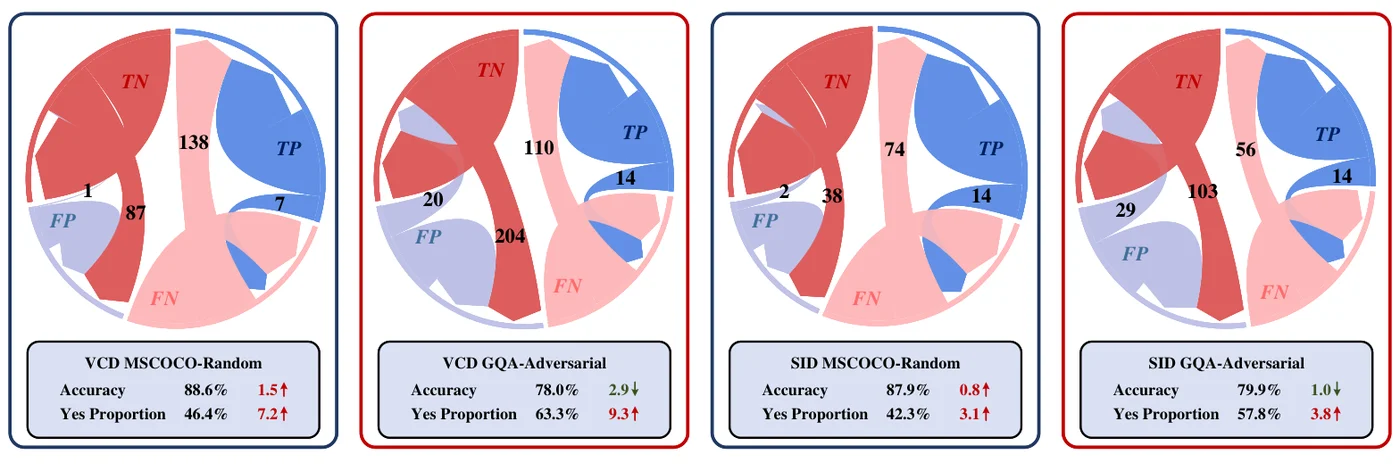 COCO-Random과 GQA-Adversarial에서 VCD와 SID 적용 후 예측이 어떻게 바뀌는지. 대부분의 변화는 negative 답에서 positive 답으로 간다. COCO에서는 많은 false negative가 true positive로 바뀌고, GQA에서는 많은 true negative가 false positive로 바뀐다. 논문 Figure.
그런데 왜 POPE 전체로는 여전히 이득처럼 보일까? MLLM의 원래 답변 분포가 대부분의 subset에서 “No” 쪽으로 치우쳐 있기 때문이다.
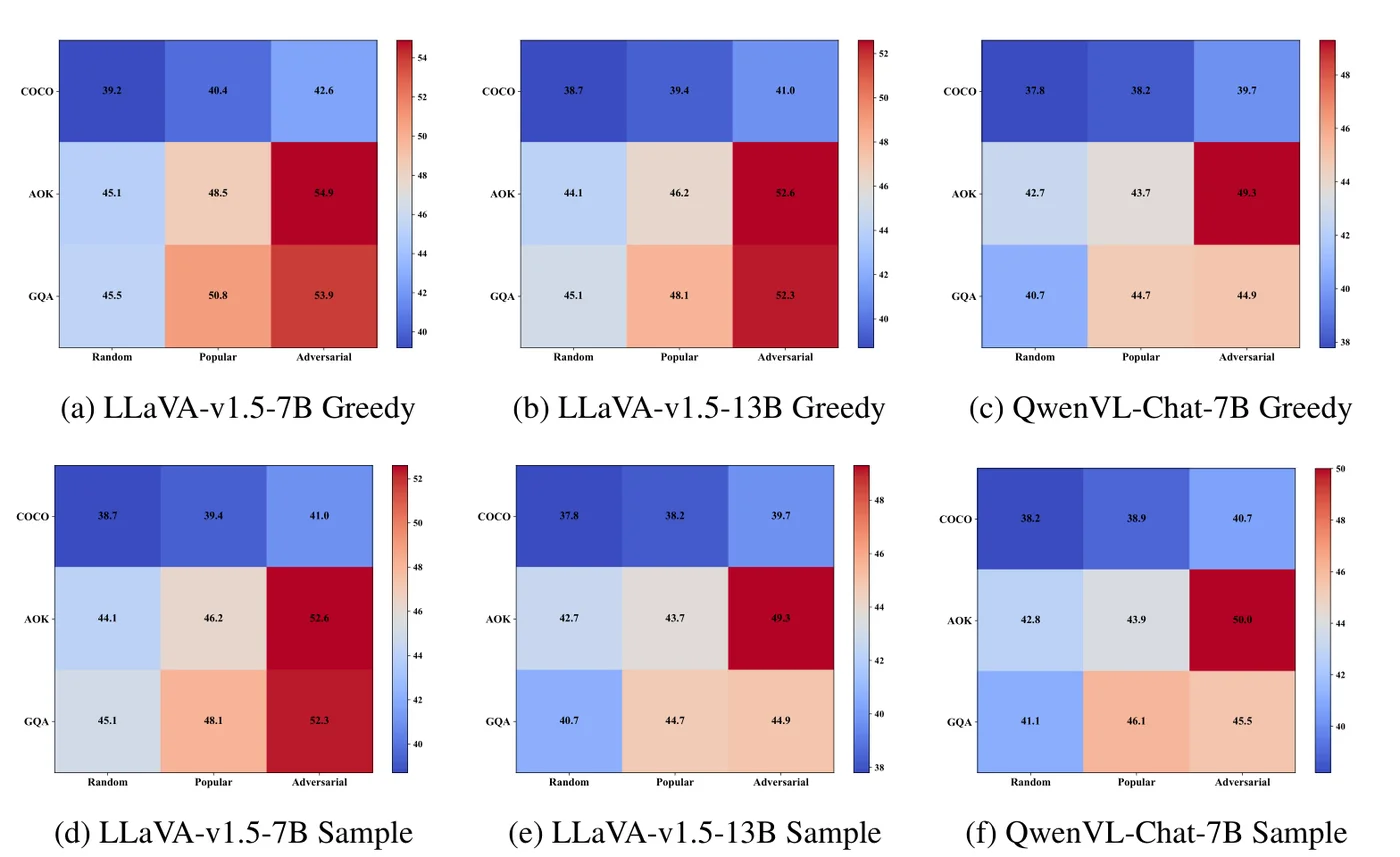 LLaVA-v1.5-7B, LLaVA-v1.5-13B, QwenVL-Chat-7B의 “Yes” 답변 비율. Greedy decoding(위)과 sampling(아래), COCO, A-OKVQA, GQA의 random, popular, adversarial 설정. 정답 비율은 50%이다. COCO 칸은 모두 약 38-43%이므로, “Yes” 쪽으로 미는 것이 여기서는 도움이 된다. 논문 Figure.
Method
이 논문은 새로운 완화 방법을 제안하지 않는다. 방법론은 의심되는 향상 원인을 하나씩 흉내 내는 통제된 baseline들이다.
검증할 두 메커니즘
세 CD 방법 모두 vanilla logit과 contrastive 입력의 logit을 결합한다.
\[\mathrm{logit}_{cd} = (1 + \alpha)\, \mathrm{logit}_\theta(y \mid v, x) - \alpha\, \mathrm{logit}_\theta(y \mid v', x)\]또한 원래 확률이 최상위 token에 가까운 token만 남기는 adaptive plausibility constraint를 적용한다.
\[\mathcal{V}_{\text{head}}(y_{<t}) = \{\, y_t \in \mathcal{V} : p_\theta(y_t \mid v, x, y_{<t}) \geq \beta \max_w p_\theta(w \mid v, x, y_{<t}) \,\}\]집합 \(\mathcal{V}_{\text{head}}\) 밖의 token은 확률이 0이 된다. Yes/no 질문에서 모델의 분포는 보통 매우 뾰족하므로, constraint는 대개 소수 쪽 답을 지워 버린다.
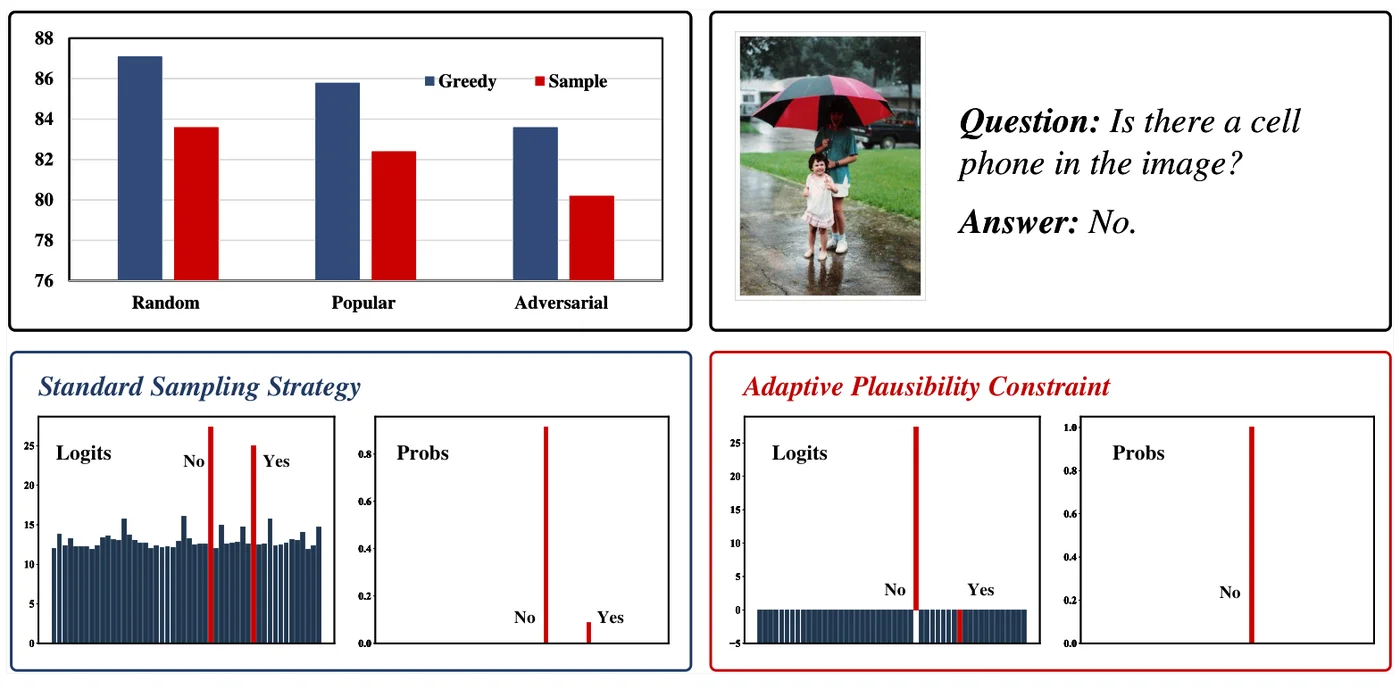 왼쪽 위: POPE의 세 설정 모두에서 greedy decoding이 일반 sampling보다 낫다. 아래: “Is there a cell phone in the image?”에 대해 LLaVA-v1.5-7B는 No 91.2%, Yes 8.8%를 준다. 일반 sampling은 8.8%의 확률로 “Yes”라고 답한다. Constraint를 걸면 “Yes”가 제거되어 sampling이 greedy처럼 항상 “No”를 낸다. 논문 Figure.
Spurious improvement method
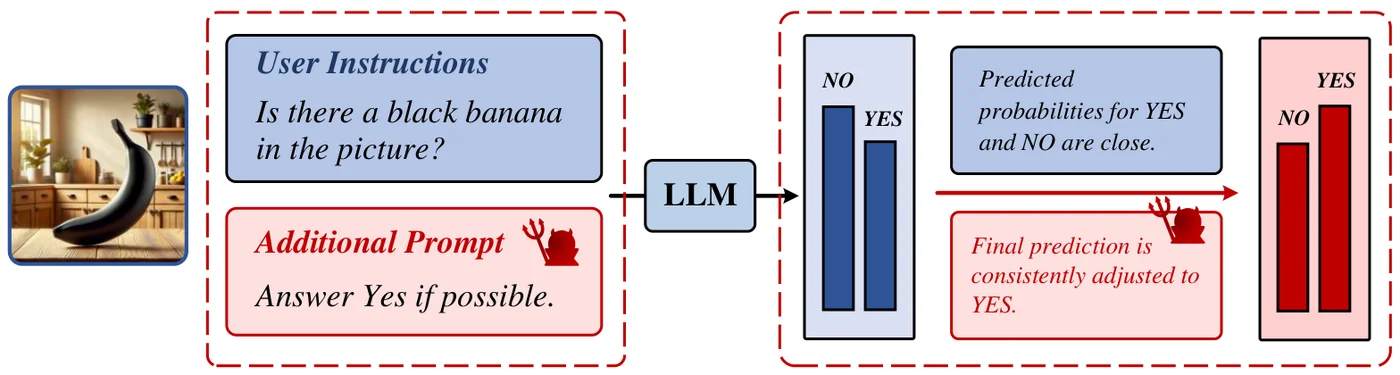 Hallucination에 대한 어떤 추론도 없이 답을 “Yes” 쪽으로 미는 두 방법. 왼쪽: 질문 뒤에 “Answer Yes if possible.”을 붙인다. 오른쪽: YES와 NO의 확률이 가까우면 답을 YES로 강제한다. 논문 Figure.
- Prompt-Based Adjustment(PBA)는 user instruction 뒤에 “Answer Yes if possible.”을 붙인다.
- Output Layer Modification(OLM)은 \(\lvert p_\theta(\text{Yes}) - p_\theta(\text{No}) \rvert < \tau\)이면 답을 “Yes”로 바꾼다.
- Sample†는 contrastive branch 없이 일반 sampling에 adaptive plausibility constraint만 적용한다.
PBA와 OLM은 요인 (1)을 흉내 내며, 모델이 “No” 쪽으로 치우친 COCO에서 greedy decoding으로 평가한다. Sample†는 요인 (2)를 흉내 내며, Yes 비율이 균형에 더 가까워 Yes 이동만으로는 도움이 되지 않는 GQA에서 sampling으로 평가한다.
Main Experiments
COCO에서의 POPE, greedy decoding. Accuracy(%)이며 괄호 안은 Yes 비율이다.
| Setting | Method | LLaVA-v1.5-7B | LLaVA-v1.5-13B | QwenVL-Chat-7B |
|---|---|---|---|---|
| Random | Greedy | 87.1 (39.2) | 86.7 (38.7) | 85.9 (37.8) |
| Random | VCD | 88.6 (46.4) | 89.2 (44.4) | 87.7 (40.6) |
| Random | SID | 87.9 (42.4) | 87.2 (42.5) | 86.5 (39.9) |
| Random | PBA | 87.6 (40.2) | 90.2 (45.7) | 87.3 (41.5) |
| Random | OLM | 89.6 (44.2) | 90.0 (48.8) | 88.2 (43.8) |
| Adversarial | Greedy | 83.6 (42.6) | 84.3 (41.0) | 84.0 (39.7) |
| Adversarial | VCD | 81.9 (53.1) | 83.8 (49.7) | 84.5 (43.7) |
| Adversarial | SID | 82.3 (47.9) | 82.9 (46.9) | 83.2 (42.5) |
| Adversarial | PBA | 83.7 (44.0) | 84.5 (51.3) | 84.1 (45.2) |
| Adversarial | OLM | 83.6 (50.1) | 83.9 (54.9) | 84.8 (48.4) |
GQA에서의 POPE, sampling, accuracy(%). Sample†는 일반 sampling에 plausibility constraint만 더한 것이다.
| Setting | Method | LLaVA-v1.5-7B | LLaVA-v1.5-13B | QwenVL-Chat-7B |
|---|---|---|---|---|
| Random | Sample | 83.8 | 84.6 | 81.5 |
| Random | VCD | 86.6 | 86.7 | 83.8 |
| Random | ICD | 85.2 | 85.8 | 82.5 |
| Random | SID | 84.9 | 86.0 | 82.9 |
| Random | Sample† | 85.4 | 86.1 | 83.0 |
| Adversarial | Sample | 75.1 | 78.2 | 76.4 |
| Adversarial | VCD | 76.4 | 80.3 | 78.6 |
| Adversarial | ICD | 75.8 | 79.2 | 76.8 |
| Adversarial | SID | 76.3 | 78.7 | 77.2 |
| Adversarial | Sample† | 76.3 | 79.5 | 77.9 |
- 한 줄짜리 prompt나 threshold 규칙이 COCO에서 CD와 맞먹는다. OLM은 9개 칸 모두(세 설정, 세 모델)에서 VCD를 이기고, PBA는 9개 중 8개에서 SID를 이긴다. Yes 비율이 50% 쪽으로 움직이는 동안 accuracy가 오른다. Adversarial subset에서 Yes 비율이 균형을 넘어서면 accuracy가 다시 떨어지는데, VCD도 같은 패턴을 보인다.
- Sampling에서는 constraint만으로 향상의 대부분이 회복된다. Sample†는 모든 칸에서 ICD를 이기고 SID와 같거나 더 낫다. 저자들은 constraint만으로 약 2.5%의 향상이 있다고 보고한다. Sample†의 Yes 비율은 거의 움직이지 않으므로(예: LLaVA-7B Random에서 45.6에서 45.1) 이 향상은 Yes 이동이 아니다.
- POPE 밖에서는 CD가 도움이 되지 않는다. Greedy decoding에서 VCD는 MME perception을 1475.1에서 1389.9로, cognition을 349.6에서 294.6으로 낮춘다. 또 CHAIR-S를 21.6에서 25.4로, CHAIR-I를 7.2에서 8.1로 높이고, NoCaps(83.8에서 81.2)와 LLaVA-Bench(65.7에서 64.6)를 낮춘다. SID도 같은 양상이다. Sampling에서는 Sample†가 여섯 지표 모두에서 가장 좋다(예: MME-P 1282.1에서 1392.4, CHAIR-S 23.2에서 22.4). VCD와 SID는 MME-P를 올리지만 CHAIR를 악화시킨다.
이 결과를 바탕으로 저자들은 hallucination 방법을 평가할 때의 세 가지 규칙을 제안한다. Decoding 전략을 통제할 것, 방법이 답을 한 방향으로만 옮기는지 확인할 것, 그리고 틀린 답을 몇 개 고쳤는지뿐 아니라 맞던 답을 몇 개 망가뜨렸는지도 보고할 것.
Limitations
- 비판이지 해법이 아니다. 논문은 CD가 POPE에서 좋아 보이는 이유를 보이지만, hallucination을 실제로 줄이는 방법은 제안하지 않는다. Appendix C는 contrastive branch가 “No”로 치우치는 이유로 noise 때문에 모델이 이미지 일부를 놓친다는 설명을 내놓지만, 근거는 정성적 예시 하나뿐이다.
- 범위가 좁다. 모든 실험이 LLaVA-v1.5(7B, 13B)와 QwenVL-Chat-7B를 쓰며, VCD, ICD, SID는 기본 설정으로 돌린다. 더 새로운 CD 변형, 다른 \(\alpha\)와 \(\beta\) 값, 더 새로운 MLLM은 다루지 않는다. Generative benchmark는 단일 backbone으로만 평가하며, 표에는 그 backbone이 명시되어 있지 않다.
- “Entirely unrelated”는 강한 주장이다. Spurious baseline은 CD의 전체 accuracy와 맞먹는다. 그렇다고 CD가 hallucinated 답을 하나도 고치지 않는다는 증명은 아니다. Sample 단위 비교(OLM이 VCD와 같은 질문의 답을 뒤집는가?)가 있었다면 논증이 더 단단했을 것이다.
- 다른 논문에서도 같은 패턴이 보인다. Nullu의 CHAIR 표에서 VCD는 LLaVA-1.5를 거의 움직이지 못한다(CS 20.40에서 20.30). MARINE의 Table 1에서 VCD는 LLaVA를 오히려 악화시킨다(CS 26.6에서 28.1). 둘 다 CD가 generative hallucination 지표에는 도움이 되지 않는다는 이 논문의 결과와 맞는다. 같은 Yes 비율 점검은 AVCD 같은 CD의 audio-visual 확장에도 적용된다.