Abstract
Test-time prompt tuning(TPT)은 entropy minimisation(EM) loss로 CLIP의 text prompt를 각 test image에 맞게 조정한다. 정확도는 높아지지만 예측이 overconfident해진다. C-TPT와 O-TPT는 class text feature를 서로 퍼뜨리는 regulariser를 더한다. 이는 calibration error를 낮추지만 정확도를 희생하는 경우가 많고, feature를 퍼뜨리는 것이 왜 calibration에 도움이 되는지 설명하지 못한다.
이 논문은 하나의 설명을 제시한다. TPT는 test sample마다 prompt를 초기화하고 한 번의 step만 밟기 때문에, regulariser의 gradient는 고정된 offset이 된다. 그러면 regularised TPT는 sharpness-aware minimisation(SAM)처럼 보인다. 즉 EM gradient를 perturb된 한 지점에서 계산하고 다른 지점에 적용하는 것이다. 저자들은 더 flat한 minimum이 더 낮은 calibration error와 함께 나타남을 보인다. 이들의 방법인 Flatness-aware Prompt Pretraining(FPP)은 regulariser를 버리고, 대신 이미지 없이 initial prompt를 pretraining하여 처음부터 flat region에 놓이게 한다. 기존 TPT pipeline은 initial prompt만 교체하면 된다.
Motivation
C-TPT와 O-TPT는 text feature에 대한 geometric constraint로 설계되었고 효과도 있지만, 그 constraint가 prompt 자체에 무엇을 하는지는 설명하지 않는다. FPP는 대신 prompt의 loss landscape를 본다. Adaptation된 각 prompt 주변 entropy loss의 sharpness를 재 보면, fine-grained 평균에서 깔끔한 순서가 나온다. TPT는 minimum이 가장 sharp하고 ECE도 가장 높으며(11.67%), C-TPT는 더 flat하고 ECE가 낮고, O-TPT는 더 flat하며 ECE가 또 낮다. Sharpness와 ECE가 함께 내려가므로, regularizer가 prompt를 flat minima 쪽으로 밀어 calibration을 돕는다는 해석이 나온다. 이는 sharpness-aware training이 generalization을 위해 노리는 성질과 같다.
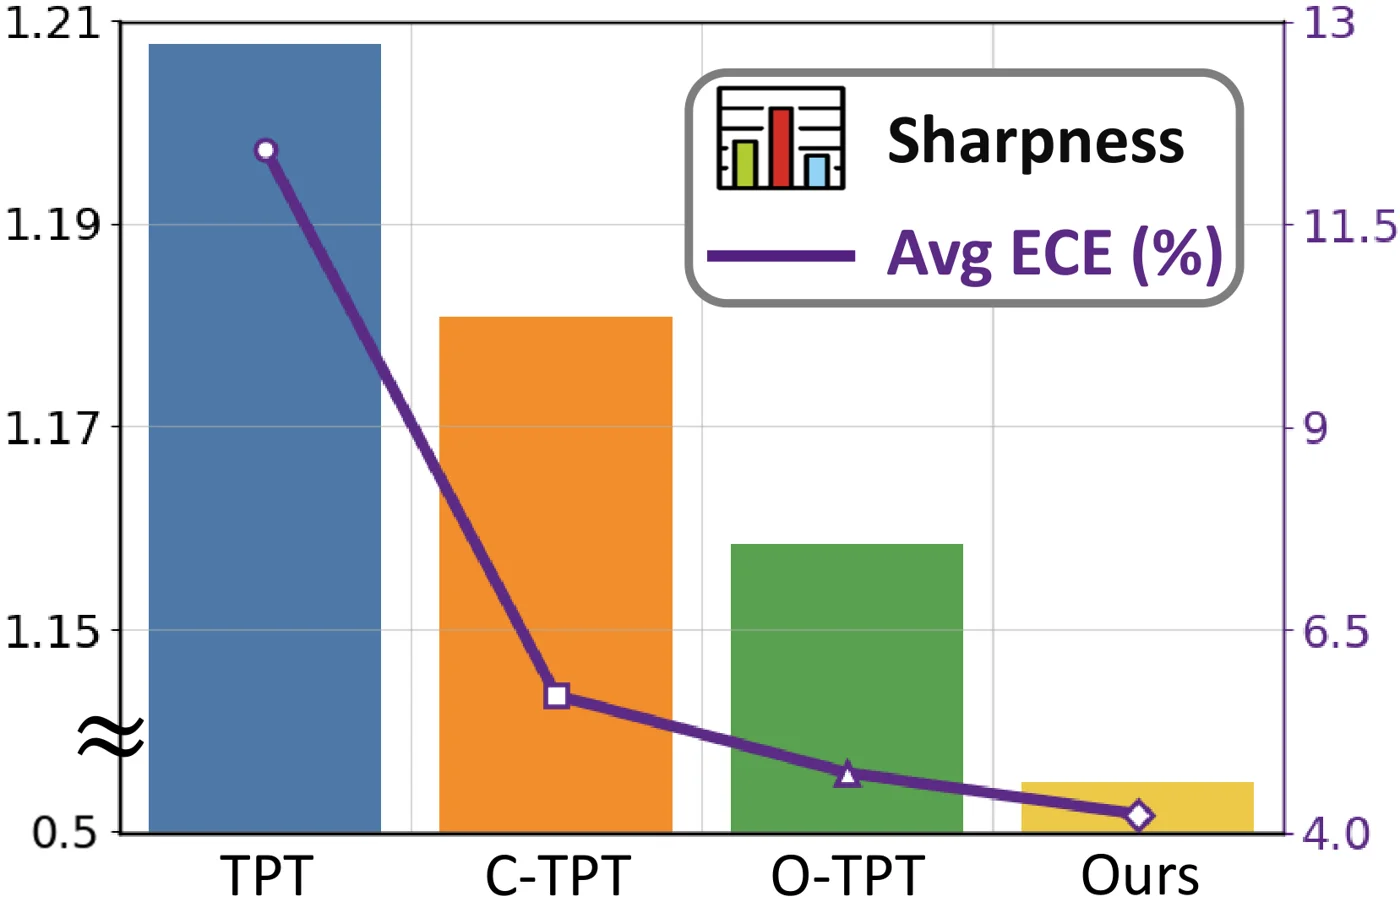 Fine-grained 데이터셋에서 adaptation된 prompt의 평균 sharpness(bar, 왼쪽 축, 아래쪽이 생략됨)와 평균 ECE(선, 오른쪽 축). C-TPT나 O-TPT의 regularizer를 더하면 둘 다 낮아지고, FPP(“Ours”)가 가장 flat하면서 ECE도 가장 낮다. 논문 Figure.
저자들은 이어서 이런 regularizer로 flatness를 얻는 방식의 두 가지 문제를 지적한다. Output feature를 직접 제약하면 accuracy를 잃는 경우가 많고, TPT의 한 step만으로는 prompt가 더 flat한 영역을 찾을 만큼 멀리 가지 못한다. Step을 늘리면 틀린 예측에 overconfident해질 위험이 커진다. FPP의 출발점은 flatness 탐색을 test time 밖으로 옮기는 것이다. 시작 prompt가 이미 flat한 영역에 있으면, 평소의 one-step entropy update만으로도 regularizer 없이 flat minimum에 도착한다.
Method
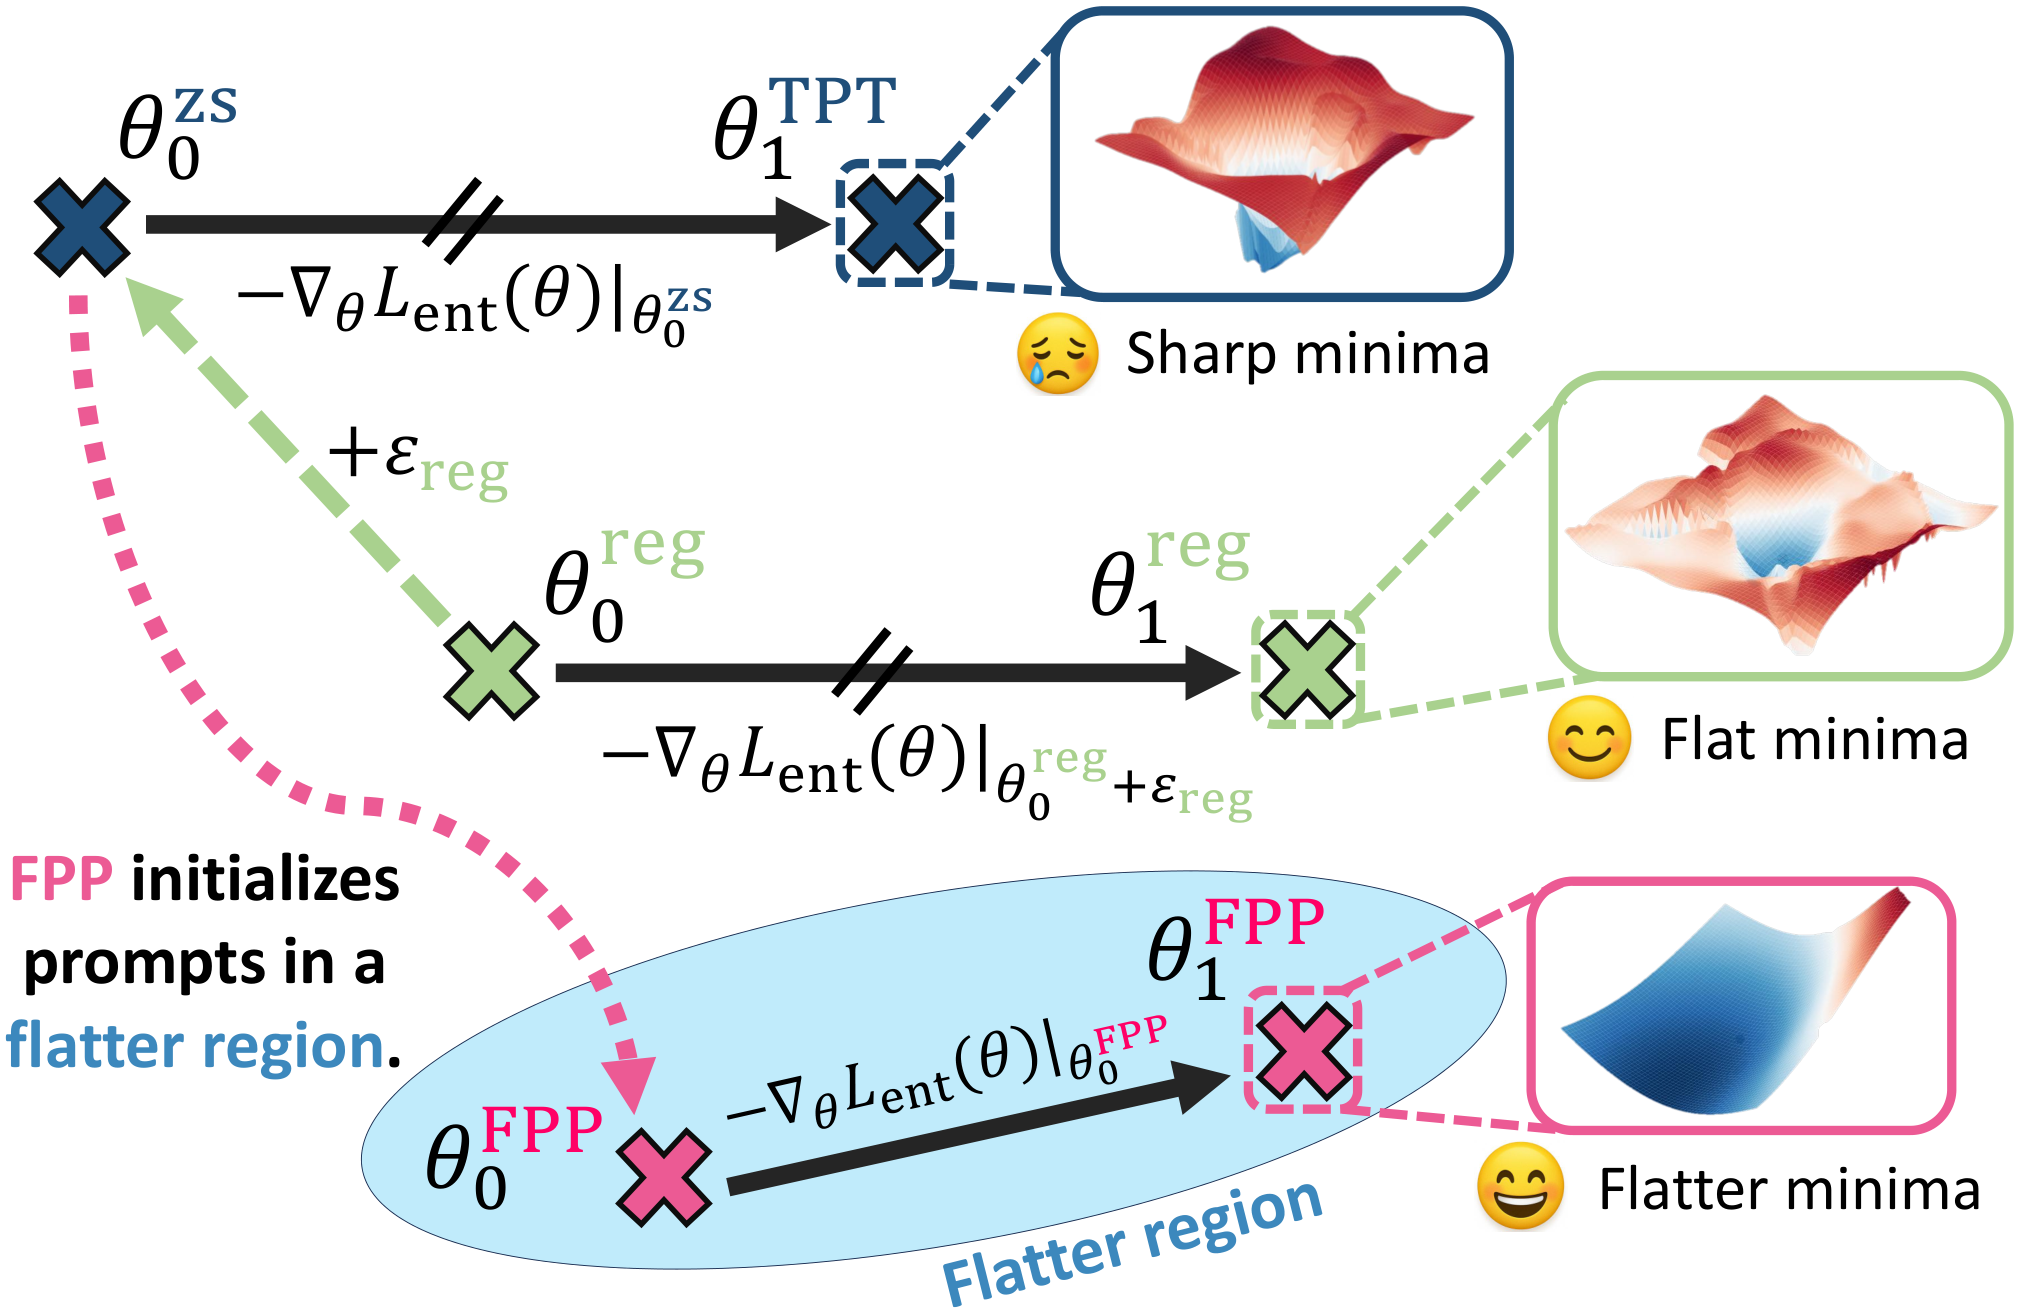 위: 일반 TPT는 zero-shot prompt에서 EM step을 한 번 밟아 sharp minimum에 도달한다. 가운데: regularised TPT는 이동된 prompt에서 시작해 perturb된 지점에서 EM gradient를 계산하는 것과 동등하며, 더 flat한 minimum으로 이어진다. 아래: FPP는 initial prompt를 더 flat한 region 안에서 pretraining하므로, 일반 EM step만으로도 훨씬 더 flat한 minimum에 도달한다. 그림은 논문에서 가져왔다.
Regularised TPT as SAM (top and middle rows)
TPT는 confidence가 높은 augmented view \(V\)에 대해 평균한 예측의 entropy \(L_{\text{ent}}(\theta, V)\)로 prompt \(\theta\)를 최적화한다. C-TPT와 O-TPT는 \(\lambda L_{\text{reg}}(\theta)\)를 더하는데, 여기서 \(L_{\text{reg}}\)는 고정된 class name \(C\)의 text feature \(f_T(C;\theta)\)에만 의존한다.
\[L_{\text{reg}}^{\text{C-TPT}} = -\frac{1}{K}\sum_{k=1}^{K}\|t_k - \mu\|_2, \qquad L_{\text{reg}}^{\text{O-TPT}} = \|TT^\top - I_K\|_2^2 .\]| 모든 test sample은 같은 prompt \(\theta_0^{\text{zs}}\)에서 시작하므로, $$\varepsilon_{\text{reg}} = \lambda \nabla_\theta L_{\text{reg}}\big | _{\theta_0^{\text{zs}}}$$는 모든 샘플에 대해 같은 상수이다. Learning rate가 1일 때 한 step은 다음과 같다. |
| 여기서 \(\theta_0^{\text{reg}} := \theta_0^{\text{zs}} - \varepsilon_{\text{reg}}\)이다. 따라서 regularised TPT는 이동된 시작점에서 출발하고 perturb된 지점에서 gradient를 취하는 일반 TPT이다. Theorem 1은 두 loss를 연결한다. Image feature가 unit sphere 위에서 균등하게 뽑힐 때, EM loss의 기댓값은 \(O(D^{-3/2})\) 오차 내에서 \(L_{\text{reg}}\)의 affine function이다. 따라서 perturb된 지점은 EM loss가 더 높은 경향이 있으며, 이는 SAM의 update $$w_{t+1} = w_t - \eta \nabla_w L(w, v)\big | _{w_t + \hat{\varepsilon}_t}$$와 같은 패턴이다. 실험적으로 C-TPT와 O-TPT는 TPT보다 낮은 sharpness에 도달하며, prompt를 sharpness에 따라 그룹으로 나누면 더 flat한 그룹일수록 ECE가 낮다. |
Flatness-aware prompt pretraining (bottom row)
FPP는 flatness 탐색을 test time 이전으로 옮긴다. 두 loss로 새로운 initial prompt \(\theta\)를 학습한다. Flatness loss는 class name embedding과 prompt를 작은 Gaussian noise \(\varepsilon_1, \varepsilon_2\)로 perturb해도 text feature가 그대로 유지되도록 요구한다.
\[\mathcal{L}_{\text{flat}} = \operatorname{dist}_{\cos}\big(f_T(C + \varepsilon_1;\, \theta + \varepsilon_2),\; f_T(C;\, \theta)\big).\]Output sensitivity가 낮으면 text feature 위에 놓인 임의의 미분 가능한 loss에 대해 sharpness가 낮아진다(appendix에서 증명). 이 loss만 쓰면 zero-shot feature가 망가지므로, alignment loss가 새 text feature를 원래 prompt의 feature 가까이에 유지시킨다.
\[\mathcal{L}_{\text{align}} = \operatorname{dist}_{L2}\big(f_T(C;\, \theta),\; f_T(C;\, \theta_0^{\text{zs}})\big), \qquad \mathcal{L}_{\text{FPP}} = \mathcal{L}_{\text{align}} + \lambda\, \mathcal{L}_{\text{flat}} .\]가중치는 \(\lambda = \gamma_1 + \gamma_2 / K\)이며 \(\gamma_1 = 1.0\), \(\gamma_2 = 0.15\)이다. 이는 클래스 수가 많을 때 flatness 가중치를 낮춘다. Pretraining은 lr 0.01의 AdamW로 1K iteration 실행하며, noise variance는 \(\varepsilon_1\)에 0.02, \(\varepsilon_2\)에 0.005이다. 두 loss 모두 prompt와 class name만 사용하므로 이미지가 필요 없다. Test time의 TPT 절차는 바뀌지 않는다. \(\theta_0^{\text{zs}}\)만 pretraining된 prompt로 교체되며, regulariser는 더해지지 않는다.
Main Experiments
설정: CLIP ViT-B/16, hard prompt “a photo of a”, C-TPT 및 O-TPT와 동일한 표준 TPT test-time 설정. 지표는 top-1 accuracy(%), ECE(%), SCE(static calibration error)이다. 여기서 FPP는 FPP prompt에서 시작한 TPT를 뜻한다. 표는 논문 Table 1(10개 fine-grained 데이터셋: Aircraft, Caltech, Cars, DTD, EuroSAT, Flowers, Food, Pets, SUN, UCF)과 Table 4(ImageNet-A, -V2, -R, -Sketch에 대한 OOD 평균)의 평균 열, 그리고 Table 4의 ImageNet 열만 보여준다.
| Method | Fine-grained Acc | ECE | SCE | ImageNet Acc | ECE | OOD Acc | ECE | SCE |
|---|---|---|---|---|---|---|---|---|
| CLIP | 63.41 | 4.67 | 1.06 | 66.7 | 2.12 | 57.18 | 5.04 | 0.15 |
| TPT | 64.62 | 11.67 | 1.15 | 69.0 | 10.6 | 59.95 | 11.99 | 0.14 |
| C-TPT | 64.48 | 5.32 | 1.11 | 68.5 | 3.15 | 59.55 | 5.82 | 0.14 |
| O-TPT | 64.12 | 4.46 | 1.15 | 67.3 | 1.97 | 57.82 | 4.88 | 0.15 |
| FPP | 65.37 | 4.13 | 0.96 | 67.8 | 2.97 | 59.53 | 4.63 | 0.12 |
공개된 CoOp 및 MaPLe checkpoint로 prompt를 초기화한 경우(논문 Table 2, fine-grained 평균):
| Method | Acc | ECE |
|---|---|---|
| CoOp+TPT | 63.91 | 18.36 |
| CoOp+C-TPT | 63.56 | 10.04 |
| CoOp+O-TPT | 63.29 | 7.91 |
| CoOp+FPP | 64.78 | 5.67 |
| MaPLe+TPT | 65.75 | 6.94 |
| MaPLe+O-TPT | 65.05 | 4.11 |
| MaPLe+FPP | 67.01 | 4.07 |
Fine-grained 평균에서 FPP는 정확도로 TPT를 앞서면서 동시에 가장 낮은 ECE와 SCE를 갖는 유일한 방법이다. OOD 데이터셋에서는 TPT 정확도의 대부분을 유지하면서(59.53 대 59.95) O-TPT보다 낮은 ECE를 보이지만, distribution shift 실험에서는 고정된 \(\lambda = 1.25\)를 사용한다. Ablation은 두 부분이 모두 필요함을 보여준다. Alignment loss만 쓰면 ECE가 7.05이고, flatness loss만 쓰면 zero-shot 정확도가 4.65%로 무너지며, 전체 loss는 4.13을 준다. TPT 안에서 SAM이나 ASAM을 직접 적용해도 ECE가 낮아지지만, SAM은 정확도를 61.59로 떨어뜨린다.
Sharpness group 분석은 flatness가 calibration과 함께 간다는 것을 논문이 직접 확인하는 부분이다. Test sample마다 prompt를 adaptation한 뒤 sharpness 순으로 세 group으로 나누고, group별 ECE를 계산해 fine-grained 데이터셋에 걸쳐 평균한다. TPT, C-TPT, O-TPT, FPP 모두에서 가장 flat한 group의 ECE가 가장 낮다. 이는 group 사이의 correlation이지 causal test는 아니다.
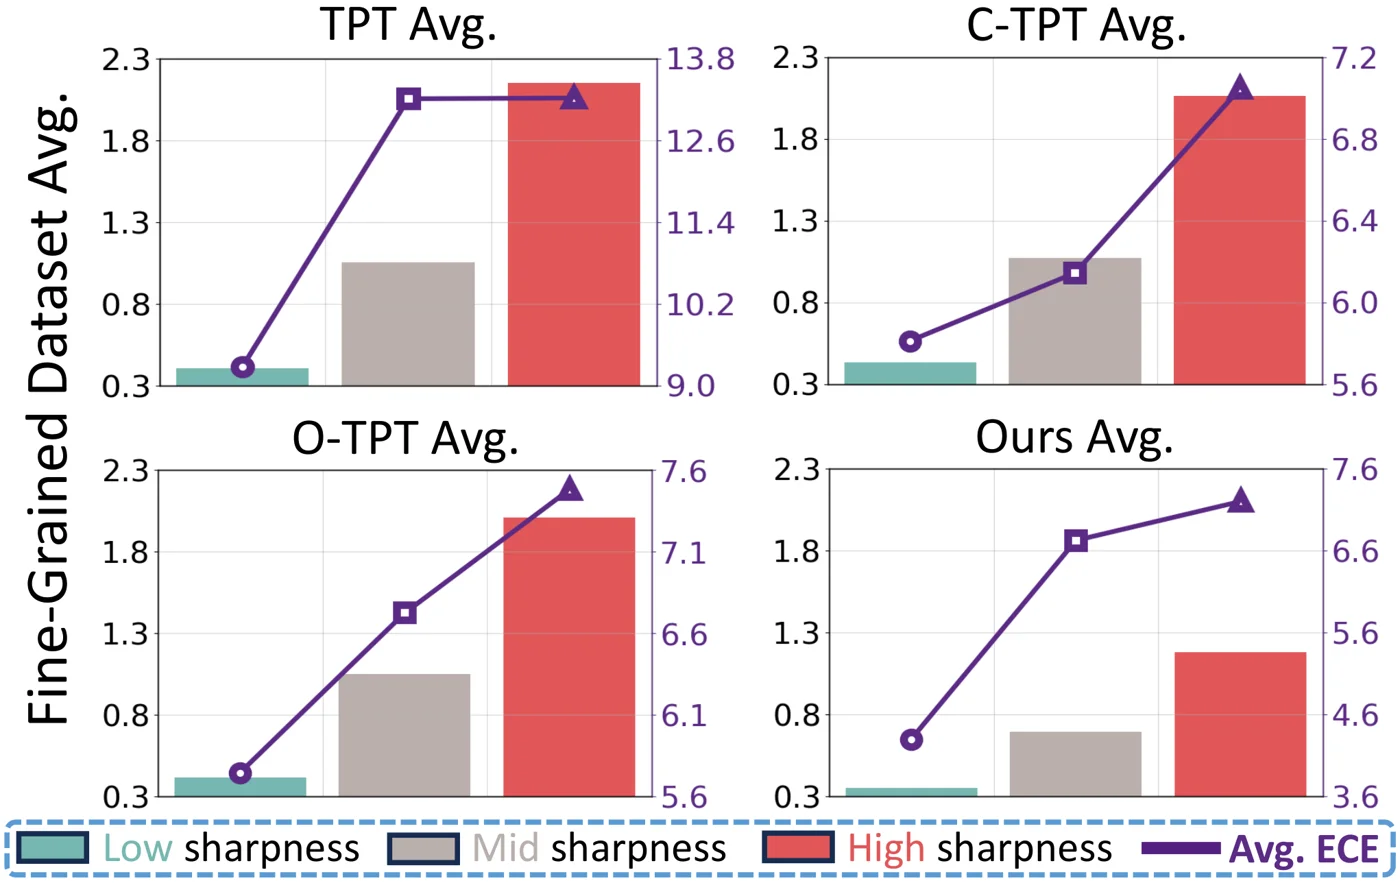 Fine-grained 데이터셋에서 TPT, C-TPT, O-TPT, FPP의 prompt를 low, mid, high sharpness 세 group(bar)으로 나누고 각 group의 평균 ECE(선)를 표시. 모든 방법에서 더 flat한 group이 calibration이 더 잘 되어 있다. 논문 Figure.
Reliability diagram은 세 데이터셋에서 O-TPT와 FPP를 비교한다. 가장 큰 변화는 EuroSAT으로, O-TPT는 중간 confidence bin에서 심하게 overconfident한데(ECE 12.98) FPP의 bar는 diagonal을 따라간다(5.19). DTD에서는 둘이 비슷하고(7.88 대 7.52), SUN397에서는 FPP가 O-TPT의 낮은 bin underconfidence를 없앤다.
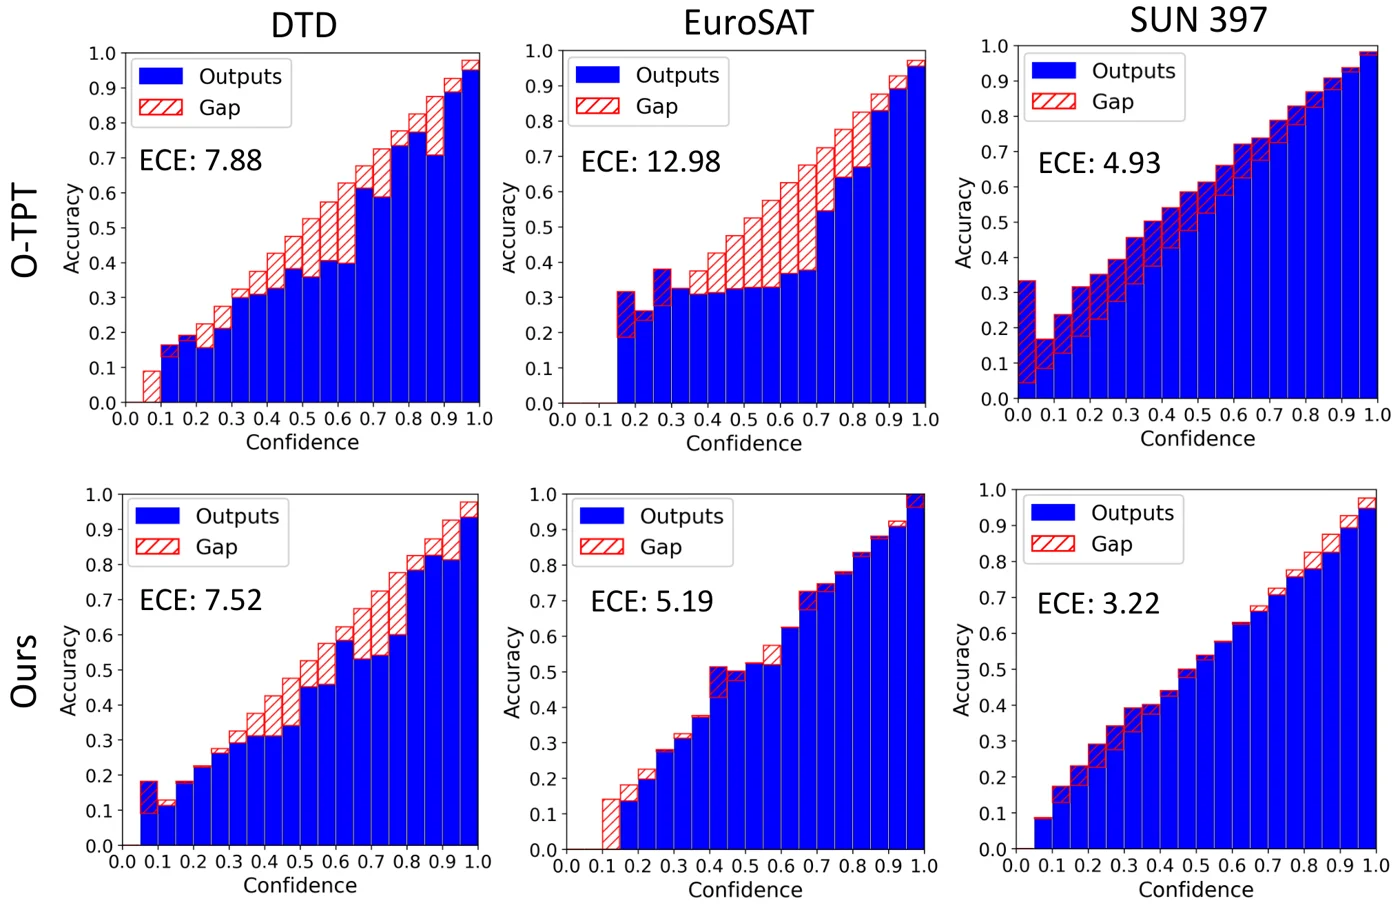 DTD, EuroSAT, SUN397에서 O-TPT(위)와 FPP(아래)의 reliability diagram과 각 ECE. FPP는 overconfidence(EuroSAT)와 underconfidence(SUN397)를 모두 바로잡지만, DTD에서는 거의 변화가 없다. 논문 Figure.
Limitations
- EuroSAT이 fine-grained 평균을 좌우한다. FPP는 EuroSAT에서 50.66%를 기록하는 반면 TPT는 42.4%이다. 논문 Table 1에서 나머지 9개 데이터셋만 평균하면 FPP는 약 67.0%, TPT는 약 67.1%이고, ECE는 FPP가 약 4.0, O-TPT가 3.5이다. 전체적인 우위는 이 한 데이터셋에 달려 있다.
- 데이터셋별 calibration 결과가 엇갈린다. FPP의 ECE는 Aircraft(7.26 대 3.68), Caltech(5.85 대 3.80), ImageNet(2.97 대 1.97), ImageNet-R(7.07 대 1.46)에서 O-TPT보다 확연히 나쁘다.
- Distribution shift에서의 정확도. OOD 평균에서 FPP는 정확도가 TPT와 C-TPT보다 약간 낮고, ImageNet에서는 둘 다보다 낮다.
- 강한 가정 아래의 이론. SAM 관점은 learning rate 1, momentum 없는 단일 step을 가정한다. Theorem 1은 image feature가 sphere 위에서 균등하다고 가정하며 \(O(D^{-3/2})\) 항까지만 성립한다. Flatness와 calibration 사이의 연결은 sharpness 그룹 간 correlation으로 제시될 뿐 증명되지 않았다.
- Task별 pretraining. Class set마다 새 prompt를 pretraining해야 하며, SUN397의 경우 약 10분이 걸린다. Table 6은 ImageNet class name이나 Gaussian noise를 대용으로 써도 거의 비슷하게 작동함을 보여주어, 이 부담을 다소 덜어준다.
- 단일 backbone. 모든 주요 결과는 CLIP ViT-B/16을 사용한다. DynaPrompt baseline은 재현 결과로, 원 논문의 정확도보다 낮다(64.22 대 65.43).