Abstract
Clean data로 학습된 point cloud classifier는 background clutter, occlusion, LiDAR 방식 sampling 같은 corruption이 있는 test data에서 정확도를 크게 잃는다. Test-time adaptation(TTA)은 label 없는 test batch만을 사용해 이를 online으로 바로잡으려 한다. 기존 3D TTA 방법은 대부분 spatial domain에서 작동한다. MATE는 source training 단계에서 추가 reconstruction task가 필요하다. BFTT3D는 source data의 feature prototype이 필요하다. CloudFixer와 3DD-TTA는 source data로 학습된 diffusion model이 필요하다. 그리고 point별 offset \(\Delta P \in R^{N\times 3}\)을 학습하는 방법들은 소수의 streaming test sample로 풀기 어려운 고차원 문제에 직면한다.
GSDTTA는 adaptation을 graph spectral domain으로 옮긴다. 각 test point cloud는 kNN graph가 되어 Graph Fourier Transform(GFT)으로 변환되고, 가장 낮은 \(M=100\)개의 frequency coefficient(약 10%)에만 learnable offset이 주어진다. Inverse GFT는 이 offset을 매끄럽고 전역적인 point shift로 바꾼다. 최적화를 위한 pseudo-label은 모델의 deep feature와 Laplacian eigenmap feature를 혼합하며, 저자들은 후자가 source domain에 덜 편향되어 있다고 주장한다.
Motivation
출발점은 일반적인 classifier가 얼마나 심하게 무너지는가이다. Clean ModelNet40으로 학습한 DGCNN은 background, occlusion, LiDAR corruption에서 accuracy를 35점 넘게 잃으며, 그 하락의 대부분은 가장 낮은 severity level에서 이미 일어난다.
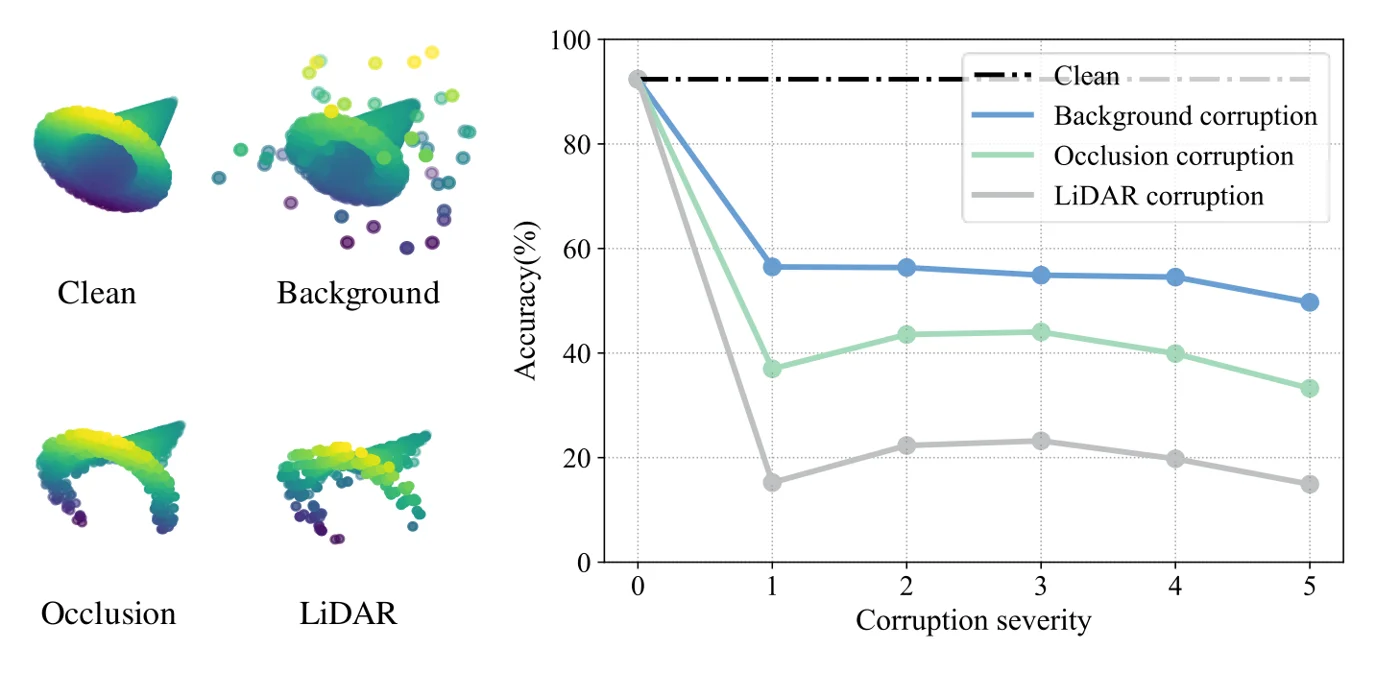 왼쪽: clean shape와 그 background, occlusion, LiDAR 버전. 오른쪽: severity가 커질수록 DGCNN accuracy가 약 92%에서 대략 50%, 35%, 15%로 떨어지며, 손실의 대부분은 level 1에서 생긴다. 논문 Figure.
저자들은 기존 3D TTA 방법들의 공통점을 지적한다. 모두 spatial domain에서 작동한다는 것이다. MATE는 masked patch reconstruction을 풀고, CloudFixer와 3DD-TTA는 \(N\)이 흔히 1024를 넘는 point별 transformation \(\Delta P \in R^{N\times 3}\)을 학습한다. CloudFixer와 3DD-TTA는 source data로 학습된 diffusion model도 필요하다. 소수의 streaming test sample만으로는 이런 고차원 문제를 최적화하기 어렵다.
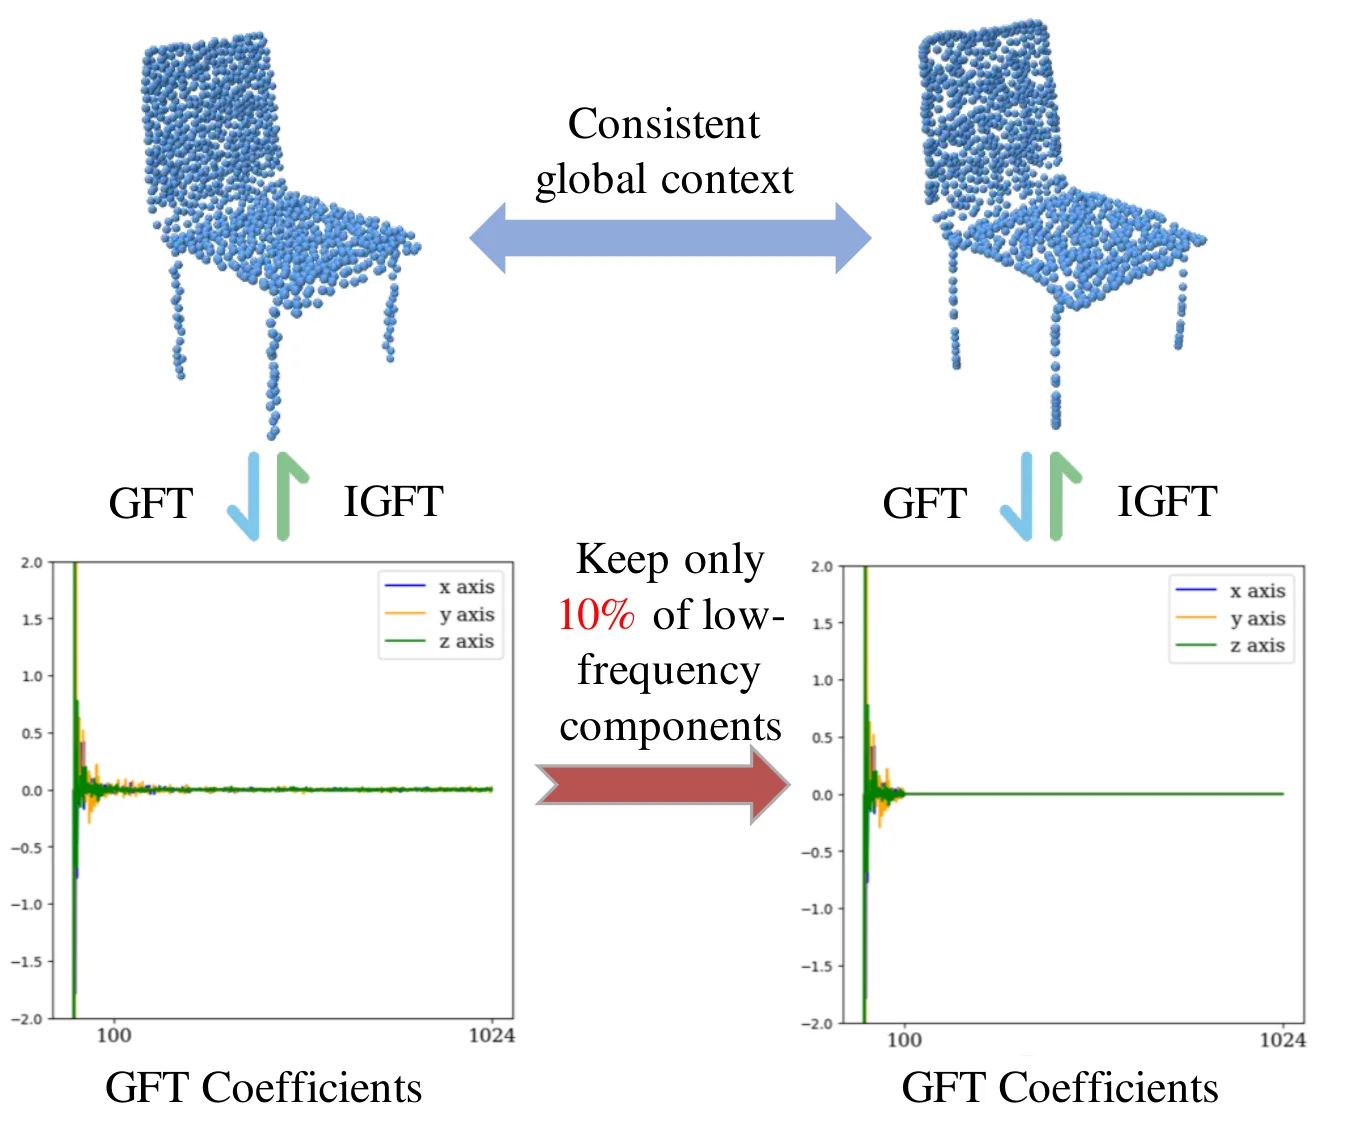 의자의 GFT coefficient(왼쪽)는 처음 ~100개 이후로 거의 모두 0에 가깝다. 가장 낮은 10%만 남기고 inverse GFT를 적용하면(오른쪽) 같은 전역 형상이 복원된다. 논문 Figure.
핵심 insight는 graph spectral domain에 대한 두 가지 관찰이다. 첫째, energy compaction이다. 의자의 spectral energy 약 95%가 가장 낮은 약 100개의 coefficient에 모여 있으므로, 이것만 편집해도 point를 직접 편집할 때보다 약 90% 적은 parameter로 전역 형상을 제어할 수 있다. 둘째, Laplacian eigenmap은 isometry에 불변인 shape descriptor로, 어떤 학습 domain에도 의존하지 않는다. Deep feature는 특히 adaptation 초기에 source bias를 지니므로, eigenmap은 pseudo-label을 만들 때 편향되지 않은 두 번째 의견 역할을 할 수 있다.
Method
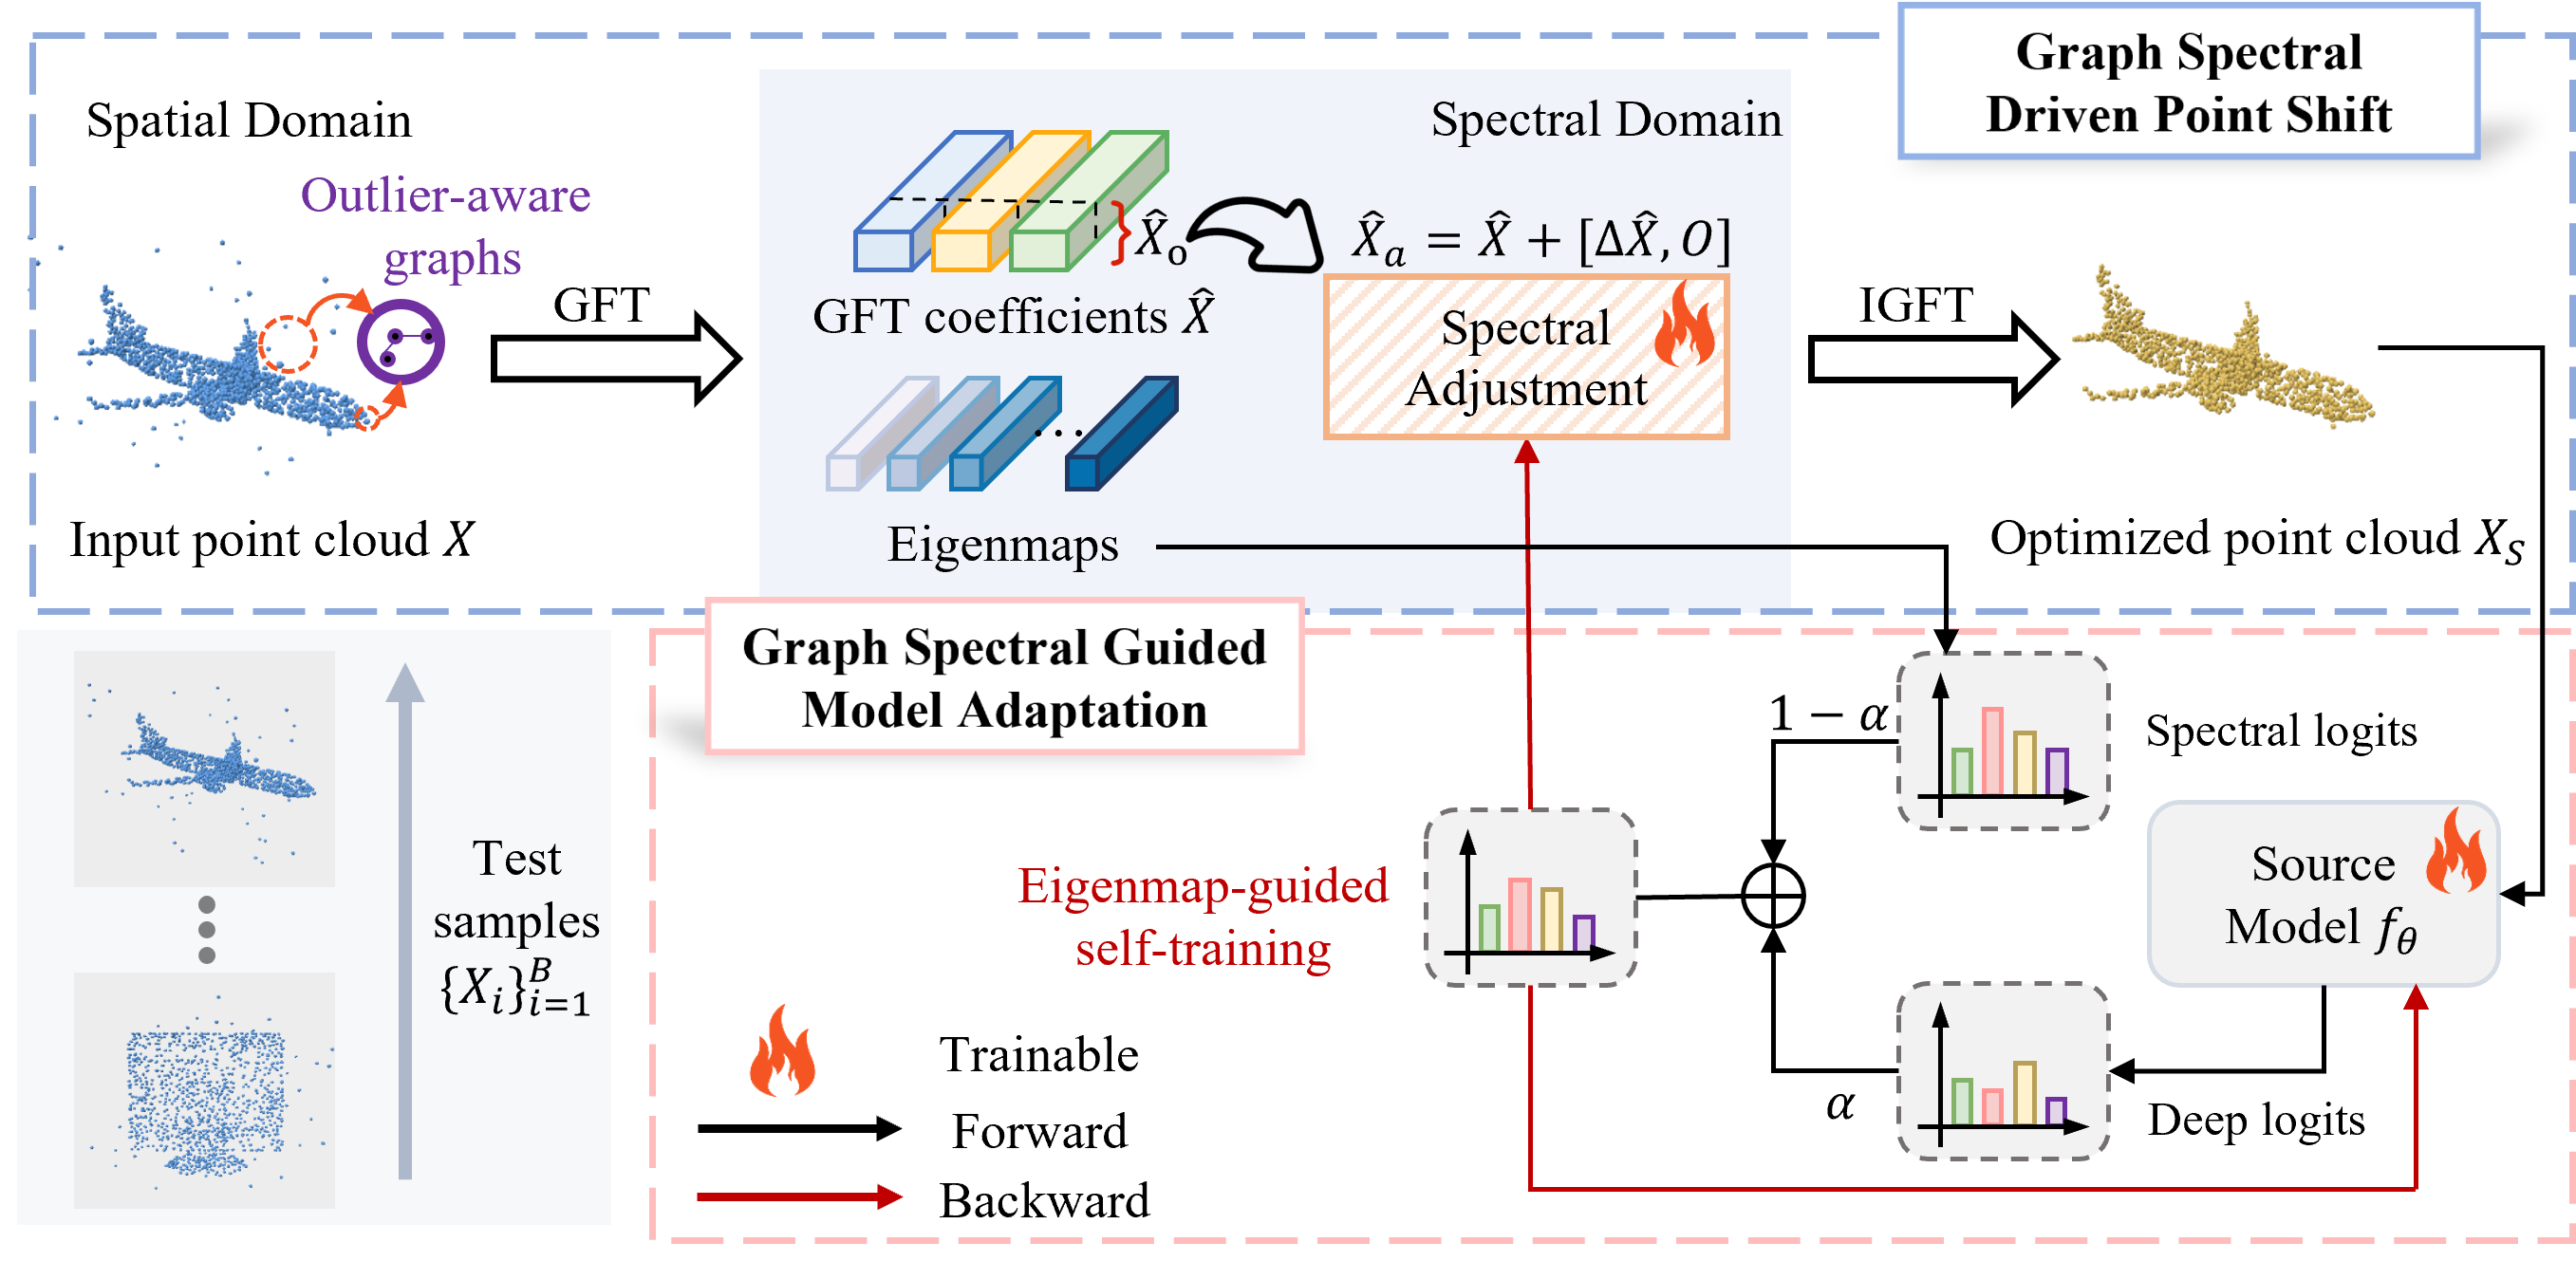 GSDTTA pipeline. 위쪽 절반(GSDPS)은 spectral domain을 통해 입력 point cloud를 이동시킨다. 아래쪽 절반(GSGMA)은 모델을 갱신한다. 둘 다 eigenmap 기반 pseudo-label로 학습된다. 그림은 논문에서 가져왔다.
이 방법은 각 test batch \(\{X_i\}_{i=1}^{B}\)에 대해 번갈아 작동하는 두 모듈로 구성된다. Graph Spectral Driven Point Shift(GSDPS)는 입력을 적응시키고, Graph Spectral Guided Model Adaptation(GSGMA)은 모델 \(f_\theta\)를 적응시킨다.
Outlier-aware graph
Point cloud \(X \in \mathbb{R}^{N\times 3}\)에 대해, edge는 각 점을 \(k\)개의 nearest neighbour와 연결하며 RBF kernel로 가중치가 매겨진다.
\[w_{ij} = \exp\left(-\frac{d^2(x_i, x_j)}{2\delta^2}\right), \qquad A_{ij} = w_{ij}\cdot \mathbb{I}(x_j \in \mathcal{N}(x_i)).\]Spectral analysis는 outlier에 민감하다. Outlier는 다른 점들과 멀리 떨어져 있으므로 degree(edge weight의 합)가 낮다. GSDTTA는 degree가 threshold \(\tau\)보다 낮은 vertex를 제거한다.
\[A^o_{ij} = w_{ij}\cdot \mathbb{I}(x_j \in \mathcal{N}(x_i)) \cdot \mathbb{I}\Big(\sum_{j=1}^{N} A_{ij} > \tau\Big), \qquad \tau = \frac{\gamma}{Nk}\sum_{i=1}^{N}\sum_{j=1}^{N} A_{ij}.\]Spectral adjustment and point shift
Laplacian \(L_o = D_o - A_o\)는 \(L_o = U_o \Lambda_o U_o^T\)로 eigen-decomposition된다. 좌표의 GFT는 다음과 같다.
\[\hat{X} = U_o^T X, \qquad \hat{X} \in \mathbb{R}^{N\times 3}.\]\(M \ll N\)인 learnable offset \(\Delta\hat{X} \in R^{M\times 3}\)을 low-frequency 행에만 더하고, 그 결과를 inverse GFT로 되돌린다.
\[\hat{X}_a = \hat{X} + [\Delta\hat{X}, O], \qquad X_s = U_o \hat{X}_a.\]여기서 \(O\)는 \((N-M)\times 3\) zero matrix이다. 동기는 energy compaction이다. 의자 형상의 경우 spectral energy의 약 95%가 low frequency에 있으며, 가장 낮은 10%의 coefficient만으로 전역 형상을 재구성할 수 있다. 따라서 최적화는 point cloud당 \(N\times 3\)개 대신 \(M\times 3 = 300\)개의 parameter만 가진다.
Eigenmap-guided self-training
Eigenvector는 shape descriptor도 제공한다. \(\lambda_1 = 0\)에 대응하는 eigenvector를 버리고 나머지 \(m\)개를 남기면 각 node를 \(E(v_i) = [u_1(v_i), \dots, u_m(v_i)]\)로 embedding할 수 있다. Node들에 대해 max-pooling을 하면 global spectral descriptor \(f_s\)를 얻으며, 이는 Global Point Signature를 단순화한 것이다. 모델 자체의 global feature는 deep descriptor \(f_d\)이다.
두 공간 모두에서 각 샘플을 예측 확률로 가중하여 class centroid를 만든다.
\[q_d^c = \frac{\sum_{i=1}^{B} (f_\theta(X_i))_c\, f_d^i}{\sum_{i=1}^{B} (f_\theta(X_i))_c}, \qquad q_s^c = \frac{\sum_{i=1}^{B} (f_\theta(X_i))_c\, f_s^i}{\sum_{i=1}^{B} (f_\theta(X_i))_c}.\]Pseudo-label은 두 centroid 집합에 대한 cosine similarity를 가중치 \(\alpha\)로 혼합한다.
\[\hat{y}_i = \arg\max_c \left( \alpha \frac{(f_d^i)^T q_d^c}{\|f_d^i\|\|q_d^c\|} + (1-\alpha)\frac{(f_s^i)^T q_s^c}{\|f_s^i\|\|q_s^c\|} \right).\](논문의 Eq. 16은 \(\arg\min\)으로 적혀 있다. 각 항이 similarity이므로, 여기서는 가장 유사한 centroid를 고르는 형태로 적었다.)
What is optimised
Input step은 spectral offset만 최적화한다.
\[\arg\min_{\Delta\hat{X}} \mathcal{L}_{IA} = \mathcal{L}_{pl} + \beta_1(\mathcal{L}_{ent} + \mathcal{L}_{div}) + \beta_2 \mathcal{L}_{cd},\]여기서 \(\mathcal{L}_{pl}\)은 \(f_\theta(X_s)\)와 \(\hat{y}\) 사이의 cross-entropy, \(\mathcal{L}_{ent} + \mathcal{L}_{div}\)는 일반적인 information-maximisation loss, \(\mathcal{L}_{cd}\)는 \(X\)에서 \(X_s\)로의 단방향 Chamfer distance로 이동된 cloud를 입력 가까이에 유지시킨다. Model step은 Chamfer 항을 뺀 같은 loss로 \(\theta\)를 갱신한다.
\[\arg\min_{\theta} \mathcal{L}_{MA} = \mathcal{L}_{pl} + \beta_3(\mathcal{L}_{ent} + \mathcal{L}_{div}).\]Batch마다 GSDTTA는 input step 4번 후 model step 1번을 실행하며, 이를 반복해 총 10 step을 진행한다(AdamW, lr 0.0001, batch size 32, \(k=10\), \(M=100\)).
Main Experiments
Backbone은 DGCNN, CurveNet, PointNeXt이며, clean 데이터셋으로 학습한 뒤 batch size 32로 적응시킨다. 지표는 15개 corruption에 대해 평균한 classification accuracy(%)이다. 아래 표는 논문 Table 1과 2의 평균 열만 보여준다. 3DD-TTA는 DGCNN에 대해서만 보고된다. Baseline 수치는 저자들이 각 방법의 공개 코드를 같은 pre-trained weight로 실행해 얻은 것이다.
ModelNet40-C, mean accuracy (%)
| Method | DGCNN | CurveNet | PointNeXt |
|---|---|---|---|
| Source-only | 66.51 | 71.38 | 66.99 |
| BN | 73.34 | 77.45 | 80.02 |
| PL | 75.02 | 78.56 | 80.81 |
| DUA | 73.81 | 77.41 | 80.57 |
| TENT | 75.91 | 77.88 | 81.08 |
| SHOT | 77.36 | 81.24 | 80.46 |
| BFTT3D | 65.86 | 70.95 | 68.39 |
| CloudFixer | 76.54 | 77.91 | 76.04 |
| 3DD-TTA | 71.69 | – | – |
| GSDTTA | 79.07 | 82.63 | 82.51 |
ScanObjectNN-C, mean accuracy (%)
| Method | DGCNN | CurveNet | PointNeXt |
|---|---|---|---|
| Source-only | 55.72 | 53.06 | 50.66 |
| BN | 57.15 | 57.33 | 56.68 |
| PL | 57.68 | 57.90 | 56.41 |
| DUA | 57.47 | 58.35 | 58.13 |
| TENT | 57.31 | 58.71 | 58.05 |
| SHOT | 56.32 | 58.17 | 57.06 |
| BFTT3D | 56.47 | 52.57 | 51.10 |
| CloudFixer | 60.73 | 58.96 | 59.01 |
| 3DD-TTA | 57.08 | – | – |
| GSDTTA | 61.83 | 62.59 | 60.84 |
ModelNet40-C의 corruption별 전체 표를 보면 평균 향상이 어디서 오는지 알 수 있다. GSDTTA는 background와 shape 수준의 corruption(shear, rotation, distortion)에서 강하고, noise 열 대부분은 CloudFixer가, occlusion은 SHOT이 앞선다.
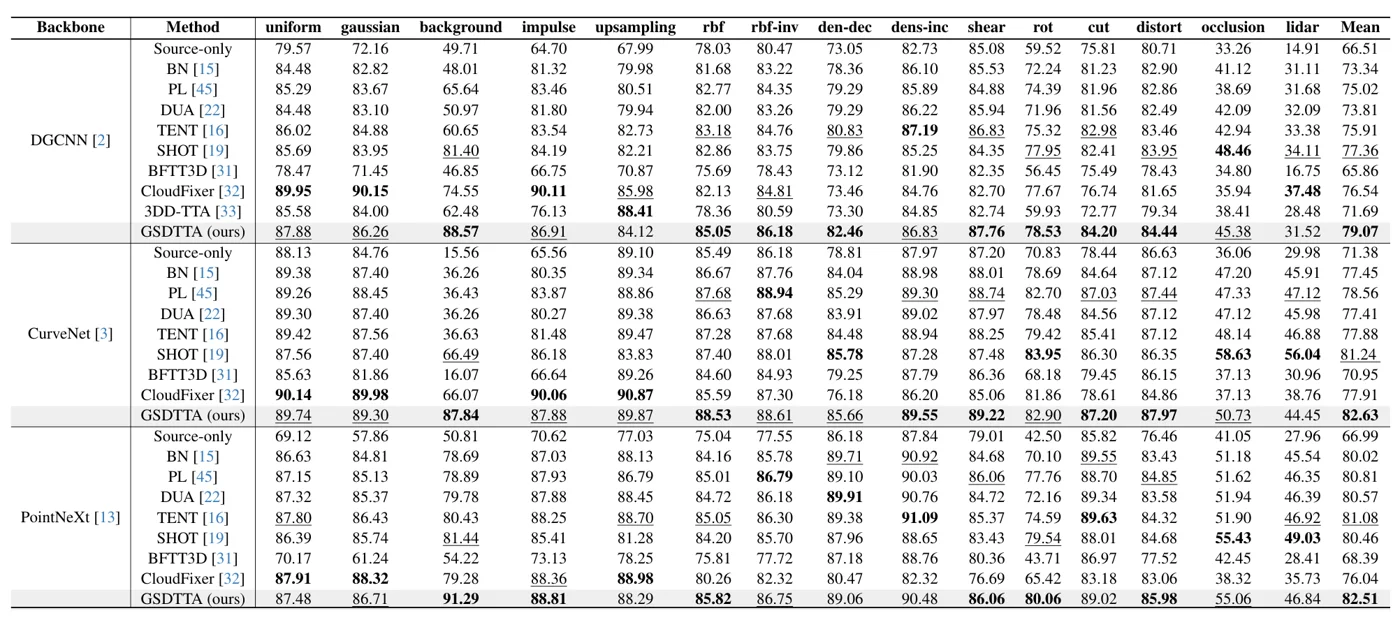 논문의 Table 1: DGCNN, CurveNet, PointNeXt에서 ModelNet40-C의 15개 corruption 각각에 대한 accuracy(%). Background 열(DGCNN에서 GSDTTA 88.57 vs. source-only 49.71)과, occlusion과 LiDAR가 모든 방법에서 얼마나 낮게 남는지에 주목하자. 논문 Figure.
GSDTTA는 두 benchmark와 세 backbone 모두에서 가장 좋은 평균을 기록한다. 단일 항목으로 가장 큰 향상은 background corruption에서 나타나며(예: ModelNet40-C의 DGCNN에서 source-only 49.71 대비 88.57), ablation은 이를 outlier-aware graph와 연결한다. \(\gamma=0\)이면 ScanObjectNN-C의 background 정확도가 69.54%에서 18.24%로 떨어진다. ScanObjectNN-C의 단순 noise corruption(uniform, gaussian, impulse, upsampling)에서는 diffusion 기반 denoiser를 사용하는 CloudFixer가 여전히 평균 8.35% 더 좋다. ScanObjectNN-C에 대한 DGCNN ablation에서 input shift를 제거하면 4.55점, model adaptation을 제거하면 3.48점, eigenmap 기반 pseudo-label을 deep feature만 쓰는 pseudo-label로 바꾸면 0.63점이 떨어진다.
Eigenmap 아이디어를 직접 확인하기 위해, 저자들은 deep descriptor만으로, spectral descriptor만으로, 그리고 Eq. 16의 eigenmap-guided 혼합으로 얻은 pseudo-label을 네 가지 corruption에서 비교한다.
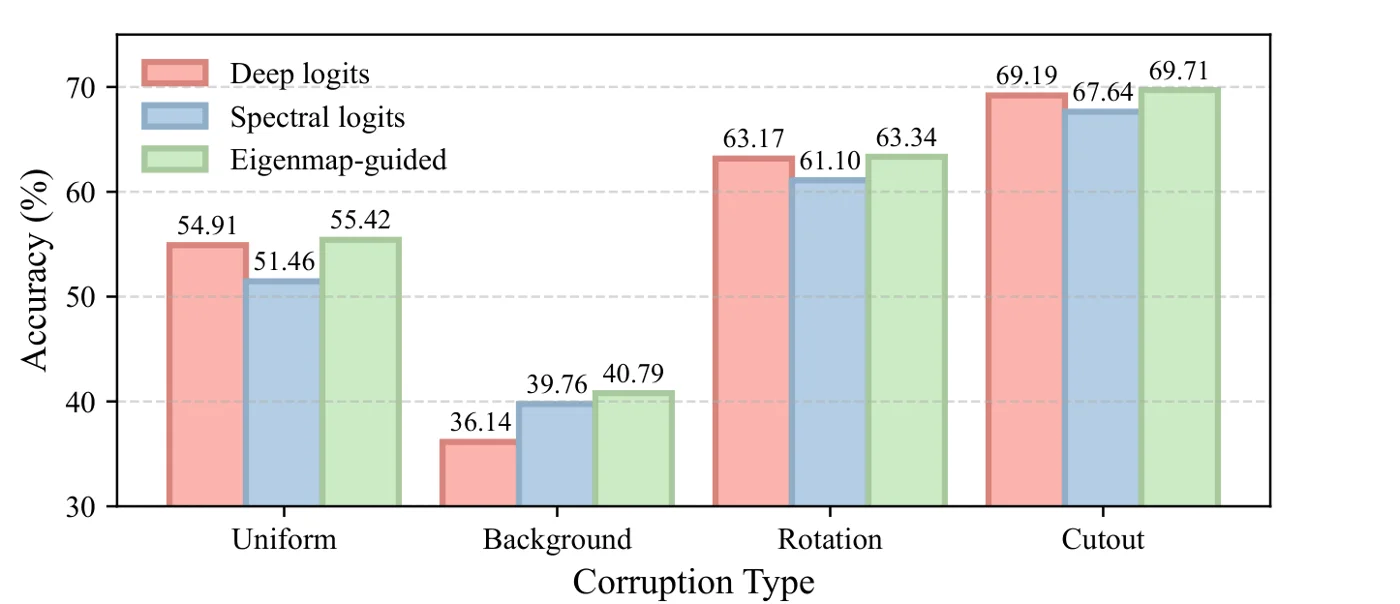 Uniform, background, rotation, cutout에서 deep logit, spectral logit, eigenmap-guided 혼합으로 얻은 pseudo-label의 accuracy. Spectral logit 단독은 background를 제외하면 deep logit보다 나쁘지만, 혼합은 네 경우 모두에서 가장 좋다. 논문 Figure.
Limitations
- Scalability (저자들이 명시). 전역 spectral 연산은 비용이 커서 대규모 point cloud에 적용하기 어렵다. 저자들은 segmentation과 multi-scale local spectral analysis를 향후 과제로 제시한다.
- 샘플마다 eigen-decomposition. 모든 test point cloud마다 Laplacian eigen-decomposition이 필요하다. \(N\times N\) 행렬의 완전한 eigen-decomposition은 \(O(N^3)\)으로 늘어나며, eigenvector 일부만 계산하더라도 \(N\)에 따라 증가하는 비용이 추가된다.
- Batch당 많은 최적화 step. 각 batch는 backpropagation step을 10번 거친다(input 8번, model 2번). 본문에는 runtime이나 memory가 보고되지 않아, TENT나 BN 대비 latency 비용이 분명하지 않다.
- Batch 가정. Class centroid와 diversity loss는 batch 단위로 계산된다(모든 실험에서 크기 32). 작은 batch나 single-sample stream에서의 동작은 본문에 나와 있지 않다.
- 어려운 corruption은 여전히 어렵다. Occlusion과 LiDAR는 모든 방법에서 낮게 유지된다. 예를 들어 ModelNet40-C의 DGCNN에서 GSDTTA는 45.38과 31.52이고, ScanObjectNN-C에서는 10% 안팎이다.
- 많은 hyperparameter. \(k\), \(\delta\), \(\gamma\), \(M\), \(\alpha\), \(\beta_1\), \(\beta_2\), \(\beta_3\)는 수동으로 고정된다. Sensitivity는 세 \(\beta\) 가중치에 대해서만, 하나의 corruption(shear)과 하나의 backbone에서만 제시된다.