Abstract
LVLM은 강한 language prior가 약한 visual evidence를 덮어쓸 때 object hallucination을 일으킨다. 기존 training-free 해법은 각자 대가를 치른다. Contrastive decoding(VCD, ICD, DoLa)은 두 번째 forward pass나 reference distribution이 필요해 latency가 늘어난다. Static subspace editing(Nullu)은 dataset 전체에 대해 하나의 “hallucination subspace”를 offline으로 만들고 매 token마다 이를 projection으로 제거하므로, 현재 sample에 적응하지 못하고 prior와 함께 실제 visual signal까지 지울 수 있다.
HulluEdit은 마지막 layer의 hidden state를 single pass로 편집한다. 매 token마다 image token으로부터 visual evidence subspace \(U\)를, 최근 text token으로부터 anti-prior subspace \(P\)를 online으로 추정하는데, \(P\)는 \(U\)의 orthogonal complement 안에서 만든다. 그러면 hidden state는 visual, prior, residual의 세 orthogonal 성분으로 나뉜다. HulluEdit은 prior와 residual 성분을 closed-form update로 줄이고 visual 성분은 정확히 그대로 둔다. 학습도, reference model도, 추가 forward pass도 필요 없다.
Motivation
논문은 문제를 그림 하나로 정리한다. 일반적인 LVLM에서 hidden state \(h\)는 visual-evidence 방향과 language-prior 방향이 섞여 있다. Prior가 강하면 decoding이 prior를 따라가 이미지에 없는 object를 만들어낸다(laptop 옆의 “a dog”, “a cup of coffee”). 두 방향을 분리할 수 있다면, 이미지가 실제로 뒷받침하는 내용은 건드리지 않고 prior만 약하게 만들 수 있다.
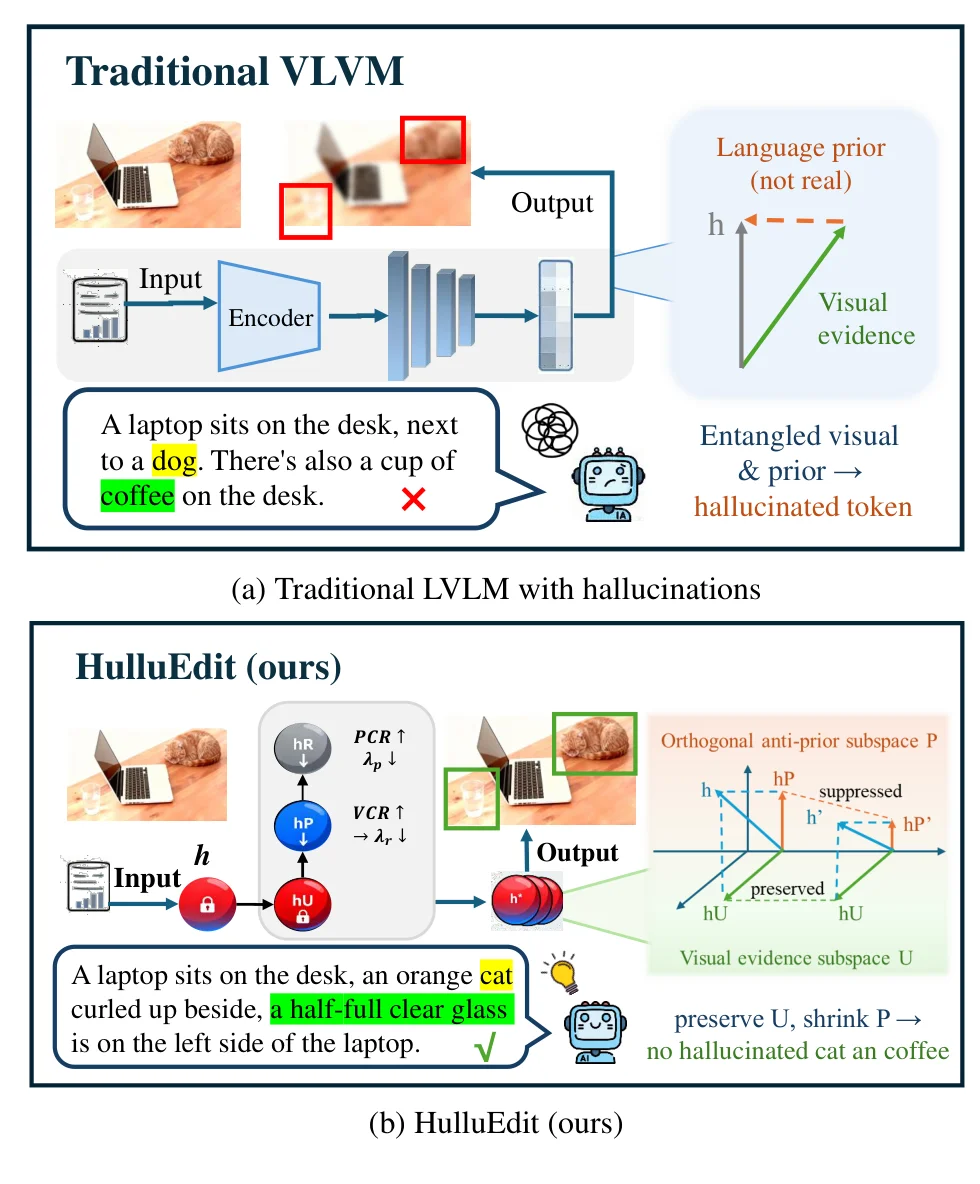 (a) 일반 LVLM에서는 visual evidence와 language prior가 hidden state 안에서 얽혀 있고, prior가 hallucinated token을 만든다. (b) HulluEdit은 \(h\)를 \(h_U\)(visual evidence), \(h_P\)(anti-prior), \(h_R\)(residual)로 나누고, \(h_U\)는 유지하며 \(h_P\)를 줄인다. 논문 Figure.
설계를 이끄는 관찰은 두 가지이다. 첫째, 기존 방법에는 이런 분리가 없다. Contrastive decoding은 output distribution 전체에 작용해 prior와 함께 실제 visual cue까지 약하게 만들 수 있고, Nullu의 subspace는 sample이나 token 단위가 아니라 dataset 단위로 고정되어 있다. 둘째, 저자들은 DeCo를 따라 중간 layer가 마지막 layer보다 visual evidence의 더 믿을 만한 출처라고 본다. DeCo는 중간 layer로 output logit을 보정한다. HulluEdit은 대신 중간 layer(anchor layer, LLaVA에서는 layer 26)로 visual subspace를 만들고, 마지막 layer의 hidden state를 편집한다.
Method
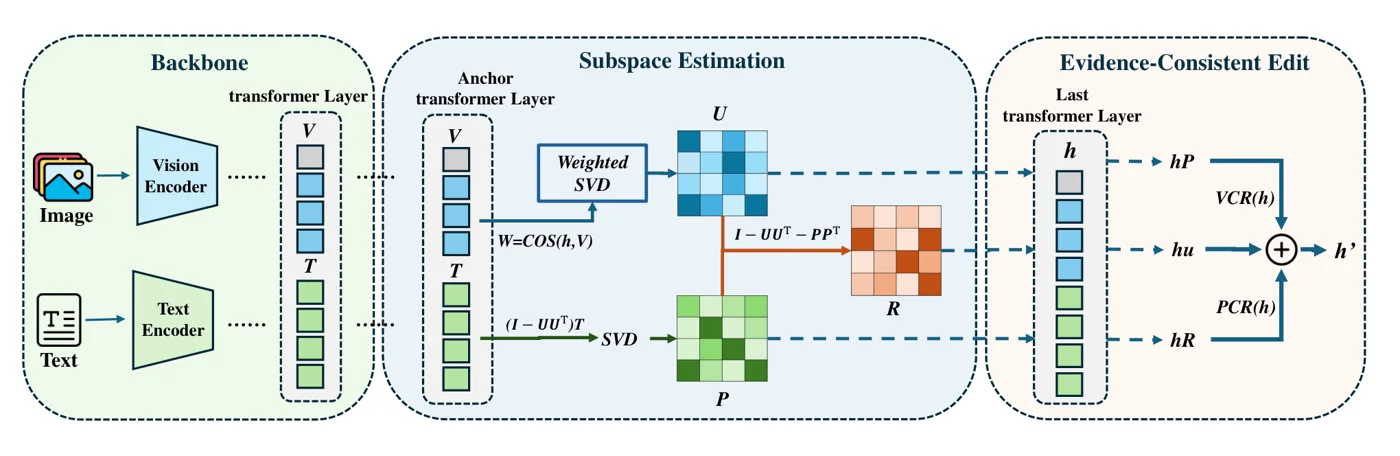 Visual token \(V\)와 text cache \(T\)는 anchor layer에서 가져온다. \(V\)의 weighted SVD가 \(U\)를, \(U\)에서 projection으로 떼어낸 \(T\)의 SVD가 \(P\)를 주고, 나머지가 \(R\)이다. 마지막 layer의 hidden state \(h\)는 \(h_U, h_P, h_R\)로 나뉜 뒤 VCR과 PCR로 정해진 강도로 다시 합쳐진다. 논문 Figure.
Subspace construction
Visual feature \(V \in \mathbb{R}^{n_v \times d}\)는 image마다 한 번 anchor layer에서 추출한다. Text cache \(T \in \mathbb{R}^{n_t \times d}\)는 최근 decoding step들의 non-visual hidden state를 sliding window로 유지한다.
Visual evidence subspace. 매 step마다 visual token은 현재 hidden state \(h\)와의 cosine similarity로 가중된다: \(w_i = \mathrm{softmax}_i\big(v_i^\top h / (\lVert v_i \rVert \lVert h \rVert + \epsilon)\big)\). 가중된 행렬의 truncated SVD에서 상위 \(r\)개의 left singular vector를 얻는다.
\[U, \Sigma, V^\top = \mathrm{SVD}(W^{1/2} V), \qquad U = U_{[:,1:r]}\]따라서 \(U\)는 sample-adaptive이면서 token-adaptive이다. 지금 생성 중인 내용과 가장 관련 있는 image token을 강조한다.
Anti-prior subspace. Text cache를 먼저 \(U\)에서 projection으로 떼어내고, 그 상위 \(q\)개의 singular vector가 \(P\)가 된다.
\[\tilde T = T (I_d - U U^\top), \qquad P = \mathrm{SVD}_q(\tilde T)\]구성상 \(U^\top P = 0\)이다. 둘 모두에 orthogonal한 나머지가 residual \(\Pi_R = I_d - UU^\top - PP^\top\)이다. Hidden state는 \(h = h_U + h_P + h_R\)로 나뉘며 \(\lVert h \rVert^2 = \lVert h_U \rVert^2 + \lVert h_P \rVert^2 + \lVert h_R \rVert^2\)이 성립한다.
Certificate-aware editing
두 비율이 현재 state가 얼마나 visual한지, 얼마나 prior에 끌려가는지를 잰다.
\[\mathrm{VCR}(h) = \frac{\lVert h_U \rVert^2}{\lVert h \rVert^2 + \epsilon}, \qquad \mathrm{PCR}(h) = \frac{\lVert h_P \rVert^2}{\lVert h \rVert^2 + \epsilon}\]이 비율로 두 강도를 정한다. \(\lambda_n = \min\big(\kappa (1 - \mathrm{VCR}) / \mathrm{VCR}, \lambda_{\max}\big)\)는 visual evidence가 약할 때 커지고, \(\lambda_p = \min\big(\lambda_0\, \mathrm{PCR} / (1 - \mathrm{PCR}), \lambda_{\max}\big)\)는 prior가 강할 때 커진다. 편집은 non-visual 성분과 prior 성분을 줄이는 minimum-norm perturbation \(\delta\)이다.
\[\min_{\delta}\; \tfrac{1}{2}\lVert \delta \rVert^2 + \tfrac{\lambda_n}{2}\lVert \Pi_\perp (h+\delta) \rVert^2 + \tfrac{\lambda_p}{2}\lVert \Pi_P (h+\delta) \rVert^2\]여기서 \(\Pi_\perp = \Pi_P + \Pi_R\)이다. Projector들이 orthogonal하므로 해는 closed form이다.
\[h' = h_U + \frac{1}{1 + \lambda_n + \lambda_p}\, h_P + \frac{1}{1 + \lambda_n}\, h_R\]Visual 성분은 정확히 유지되고, prior 성분은 가장 많이, residual은 더 완만하게 줄어든다. Gate는 위험이 클 때만 편집을 적용한다. \(\mathrm{VCR} < \gamma_v\) 또는 \(\mathrm{PCR} > \gamma_p\)이면 \(h'\)을 쓰고, 아니면 \(h\)를 그대로 둔다. 논문은 closed form으로부터 편집 후 VCR은 오르기만 하고 PCR은 내리기만 함을 증명한다.
Token당 overhead는 작은 SVD 두 번과 몇 번의 projection이다. \(r = 8\), \(q = 5\), \(d = 4096\), \(n_v \le 576\), \(n_t \le 512\)일 때 저자들은 이를 transformer layer 하나의 2% 미만으로 추정한다. LLaVA-1.5-7B의 다른 설정은 anchor layer 26, 마지막 layer에서 편집, \(\kappa = 0.60\), \(\lambda_0 = 0.26\), \(\lambda_{\max} = 3.6\)이다.
Main Experiments
세 split에서의 POPE accuracy와 F1(greedy decoding). HulluEdit은 18개 설정 모두에서 최고이다.
| Split | Method | LLaVA-1.5-7B Acc | F1 | LLaVA-1.5-13B Acc | F1 | Qwen-VL-Chat-7B Acc | F1 |
|---|---|---|---|---|---|---|---|
| Random | Greedy | 87.8 | 87.5 | 87.6 | 87.4 | 88.2 | 87.9 |
| VCD | 88.4 | 87.7 | 88.9 | 87.8 | 89.1 | 88.4 | |
| VAF | 89.6 | 89.3 | 90.1 | 89.9 | 90.0 | 89.7 | |
| DeCo | 89.1 | 89.8 | 82.2 | 84.9 | 87.8 | 87.2 | |
| HulluEdit | 90.4 | 90.5 | 90.6 | 90.8 | 90.2 | 89.9 | |
| Popular | Greedy | 82.5 | 83.2 | 82.7 | 84.1 | 82.4 | 83.1 |
| VCD | 83.1 | 84.1 | 83.7 | 85.1 | 83.0 | 84.1 | |
| VAF | 84.5 | 84.9 | 85.2 | 86.4 | 84.9 | 85.1 | |
| DeCo | 84.6 | 85.8 | 78.4 | 81.7 | 85.5 | 84.9 | |
| HulluEdit | 87.5 | 87.6 | 88.0 | 88.3 | 88.2 | 87.7 | |
| Adversarial | Greedy | 77.6 | 79.4 | 77.8 | 79.5 | 77.2 | 78.9 |
| VCD | 78.1 | 79.6 | 78.2 | 79.7 | 78.8 | 80.1 | |
| VAF | 80.1 | 81.0 | 80.7 | 81.7 | 80.4 | 81.2 | |
| DeCo | 78.3 | 81.1 | 72.6 | 77.9 | 81.5 | 81.5 | |
| HulluEdit | 82.5 | 83.4 | 82.7 | 84.0 | 84.3 | 84.2 |
MSCOCO 이미지 500장에 대한 CHAIR(최대 64 token), 낮을수록 좋다. BLEU는 caption 품질을 잰다.
| Method | LLaVA-1.5 CHAIRs | CHAIRi | BLEU | MiniGPT-4 CHAIRs | CHAIRi | BLEU | mPLUG-Owl2 CHAIRs | CHAIRi | BLEU |
|---|---|---|---|---|---|---|---|---|---|
| Greedy | 20.40 | 7.08 | 15.72 | 32.40 | 12.20 | 14.57 | 22.90 | 8.62 | 15.01 |
| OPERA | 17.50 | 6.07 | 16.02 | 29.70 | 11.96 | 14.82 | 20.07 | 7.18 | 15.41 |
| VCD | 20.30 | 7.28 | 14.53 | 29.00 | 12.64 | 14.42 | 22.80 | 8.68 | 15.14 |
| HALC | 16.90 | 5.72 | 16.02 | 25.20 | 9.42 | 14.91 | 18.80 | 7.00 | 15.33 |
| Nullu | 15.20 | 5.30 | 15.69 | 21.40 | 8.99 | 14.81 | 15.60 | 5.77 | 15.45 |
| HulluEdit | 13.00 | 4.18 | 15.49 | 23.60 | 8.28 | 14.76 | 13.60 | 3.35 | 15.34 |
- 이득은 prior가 가장 크게 작용하는 곳에서 가장 크다. POPE Adversarial에서 greedy 대비 LLaVA-1.5-7B는 accuracy +4.9, Qwen-VL-Chat은 +7.1이다.
- CHAIR에서 HulluEdit은 LLaVA-1.5의 CHAIRi를 7.08에서 4.18로, mPLUG-Owl2는 8.62에서 3.35로 낮춘다. MiniGPT-4에서는 CHAIRs(23.60)가 Nullu(21.40)보다 나쁘다. BLEU는 greedy와 비슷하게 유지된다.
- LLaVA-1.5-7B ablation에서 가장 중요한 것은 gate이다. Gate를 빼면 CHAIRs가 22.90으로 올라 plain greedy보다도 나빠진다. Orthogonal complement를 빼거나(15.90), 추정과 편집에 같은 layer 하나를 쓰거나(18.20), anchor layer를 20으로 두는 것(19.72)도 성능을 떨어뜨린다.
- MME에서 Existence(+13.33), Position(+22.23), Color(+7.22)는 오르지만 Count는 13.33 떨어진다. 저자들은 count 정보가 줄어드는 residual subspace에 들어 있을 수 있다고 본다.
속도도 장점이다. 두 번째 forward pass가 없으므로 HulluEdit은 초당 22.31 token으로 DoLa와 비슷하고, VCD, OPERA, HALC보다 빠르다.
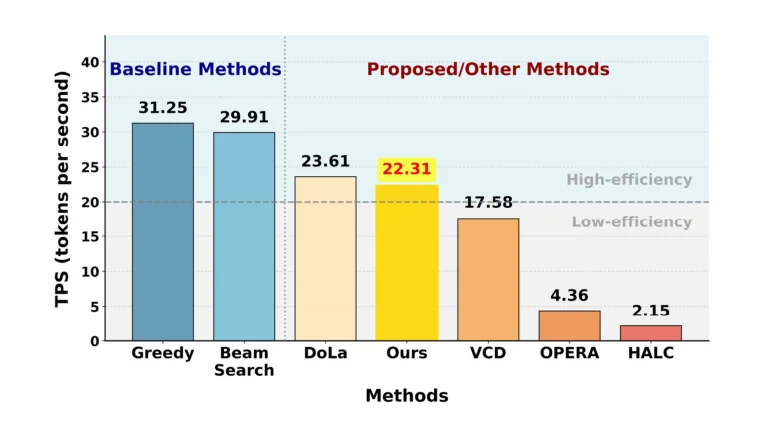 MSCOCO 이미지 500장에서의 throughput. Greedy 31.25, DoLa 23.61, HulluEdit 22.31, VCD 17.58, OPERA 4.36, HALC 2.15 tokens/s. 논문 Figure.
Appendix는 각 편집이 hidden state를 \(U\) 안에서와 \(P\) 안에서 얼마나 움직이는지를 측정해 non-interference 주장을 직접 확인한다.
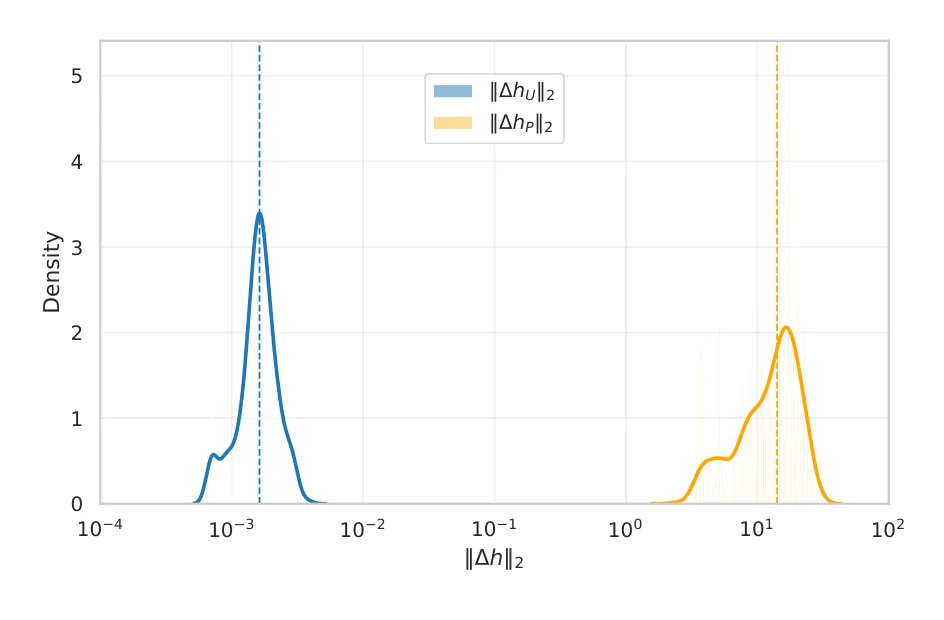 Token별 변화량 \(\Delta h\)를 \(U\)(파란색)와 \(P\)(주황색)에 projection한 norm. Visual subspace 안의 변화는 \(10^{-3}\) 근처, anti-prior subspace 안의 변화는 \(10^{1}\) 근처에 있다. 논문 Figure(appendix).
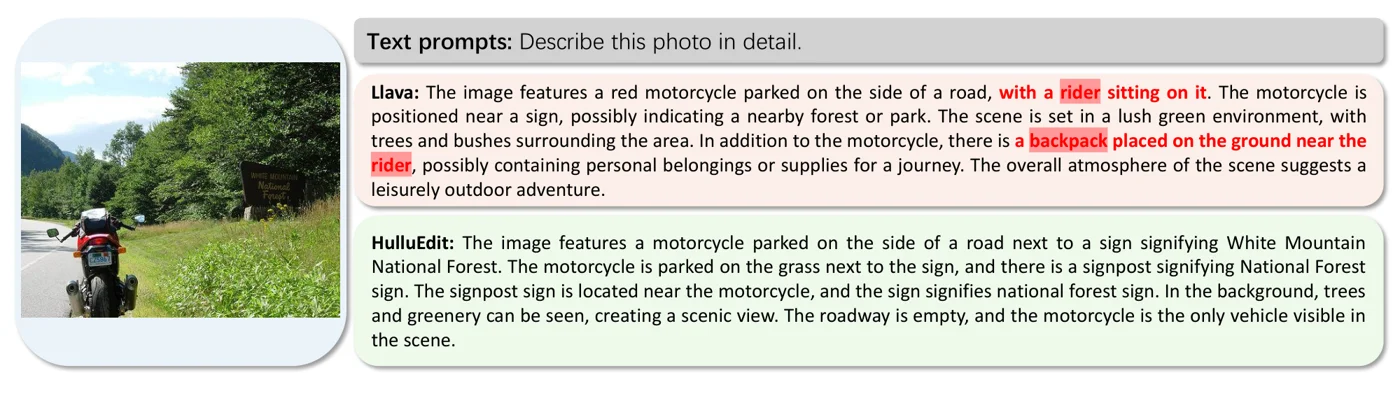 LLaVA-1.5는 rider와 backpack을 지어낸다(빨간색). HulluEdit은 둘 다 빼고 White Mountain National Forest 표지판을 언급하지만, caption에서 “sign”을 여러 번 반복한다. 논문 Figure.
Limitations
- Count가 나빠진다. MME에서 Count가 118.33에서 105.00으로 떨어진다. Residual subspace를 줄이면 \(U\)에는 없지만 여전히 필요한 정보가 사라진다.
- “Visual subspace”는 가정이다. \(U\)는 anchor layer의 image token에서 오지만, 마지막 layer의 hidden state를 분해하는 데 쓰인다. 이 방향들이 두 layer에서 같은 의미를 가진다는 보장은 없다. “편집이 visual evidence를 절대 건드리지 않는다”는 보장은 \(U\)에 대해 성립할 뿐, visual evidence 자체에 대해 성립하는 것은 아니다.
- 정확히 0이 아니다. Appendix는 \(U\) 안의 변화가 \(10^{-3}\) 수준임을 보여주는데, closed form대로라면 정확히 0이어야 한다. 논문은 이 차이를 설명하지 않는다.
- Fluency. 논문 자신의 qualitative 예시에서 두 문장 안에 “sign”이 네 번 반복된다. BLEU는 보고하지만 fluency나 repetition 지표는 없다.
- 조정할 값이 많다. Anchor layer, \(r\), \(q\), \(\kappa\), \(\lambda_0\), \(\lambda_{\max}\), \(\gamma_v\), \(\gamma_p\), text cache window가 있다. Gate threshold의 영향이 크고(gate 없이 CHAIRs 22.90), anchor layer는 architecture마다 골라야 한다. Sensitivity 분석은 \(r\), \(q\), \(\kappa\)만 다룬다.
- 짧은 출력. 모든 captioning 실험은 생성을 64 token으로 제한하는데, 이는 CHAIR에 유리하고 긴 출력에서의 동작은 검증되지 않는다.