Abstract
대부분의 test-time adaptation(TTA) 기법은 Batch Normalization(BN)을 사용하는 CNN에서 비롯되었다. 이들은 batch statistics를 다시 추정하거나 entropy minimization으로 BN의 affine parameter를 갱신한다. Point-MAE 같은 point cloud classifier는 Transformer이고, Transformer는 Layer Normalization(LN)을 사용한다. LN은 각 token을 feature 축 방향으로 normalize하고 batch 축은 전혀 보지 않으므로, BN 방식의 해결책이 깔끔하게 이전되지 않는다. 기존 point cloud TTA 방법들에는 실용적인 비용도 있다. TENT는 backpropagation이 필요하고, MATE는 특수한 pretraining objective가 필요하며, BFTT3D는 source prototype이 필요하고, multi-sampling 방법은 많은 추가 pass가 필요하다.
이 논문은 batch(domain) 관점에서 LN을 분석한다. Feature dimension과 batch size가 클 때 LN의 pre-affine output이 이미 batch에 걸쳐 feature별로 평균 0, 분산 1에 가깝다는 것을 보인다. 따라서 다시 standardize할 필요가 없다. 조정할 가치가 있는 것은 post-affine의 평균과 gain뿐이다. LN-TTA는 pretrained [cls] token에서 읽은 prototype을 사용해, 한 번의 forward pass로 gradient도 source data도 없이 이를 수행한다.
Motivation
저자들은 기존 point cloud TTA의 약한 성능을 normalization의 불일치에서 찾는다. BN re-estimation이나 TENT 같은 기법은 BN을 전제로 한다. BN은 각 feature를 batch에 걸쳐 normalize하므로 downstream weight가 안정적인 feature별 statistics를 보게 되고, 이것이 바로 이 방법들이 조작하는 손잡이다. Point-MAE를 비롯한 point Transformer는 LN을 쓰는데, LN은 각 token을 자기 feature에 걸쳐 normalize하고 batch 축은 건드리지 않는다. 그래서 LN 모델에서 BN 방식의 수정이 무엇을 바꿔야 하는지조차 분명하지 않다.
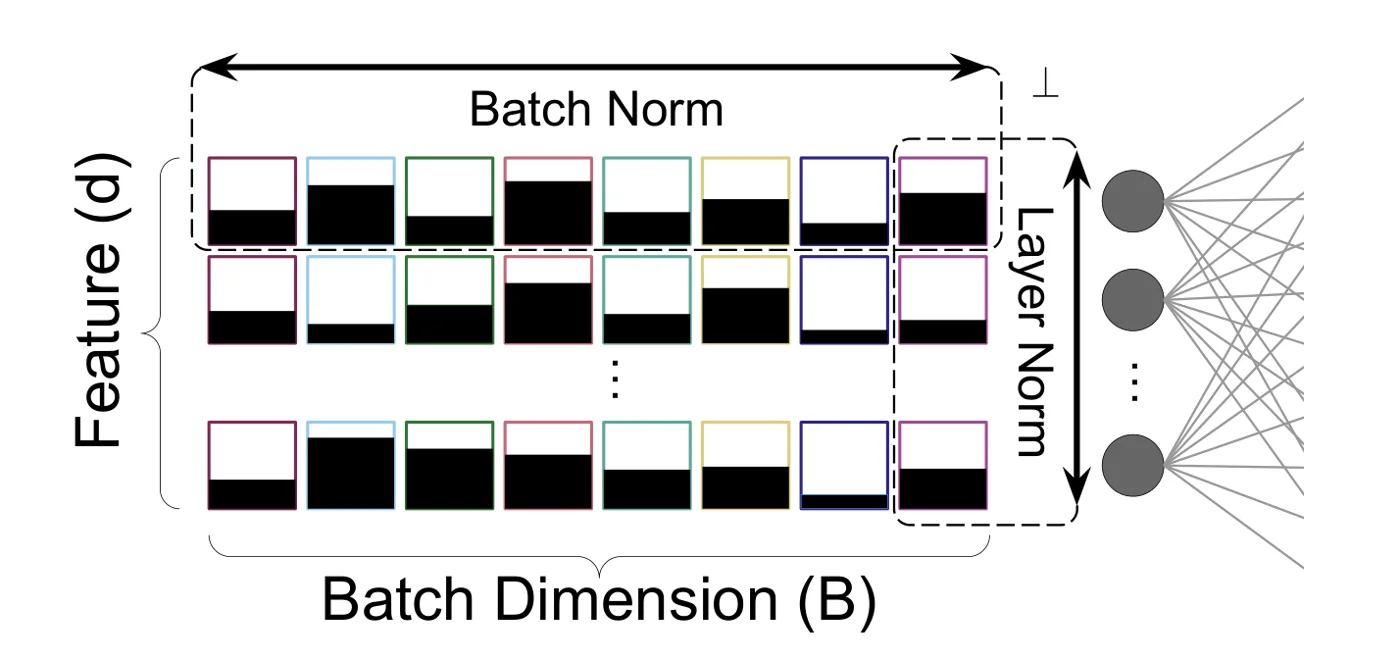 BN은 하나의 feature를 batch에 걸쳐(가로 상자), LN은 하나의 sample을 feature에 걸쳐(세로 상자) 처리한다. 두 방식은 test-time adaptation에 서로 다른 손잡이를 준다. 논문 Figure.
실용적인 한계도 더해진다. TENT는 point cloud에서 성능이 낮고 backpropagation이 필요하며, MATE는 adaptation을 특수한 MAE pretraining에 묶고, multi-sampling 방법은 추가 pass가 많이 필요하고, BFTT3D는 test time에 class 수준 source prototype이 필요하다. 논문의 답은 LN을 batch 쪽에서 보는 것이다. LN은 이미 token별 shift와 scale을 정확히 제거하며, \(d\)와 \(B\)가 커지면 pre-affine output의 feature별 batch marginal이 \((0, 1)\)에 가까워진다. 즉 LN은 BN 방식 TTA가 더하려는 안정화를 이미 하고 있으므로, 다시 standardize하는 것은 불필요하거나 오히려 해롭다. 남은 수정 대상은 post-affine의 평균과 gain이다.
Method
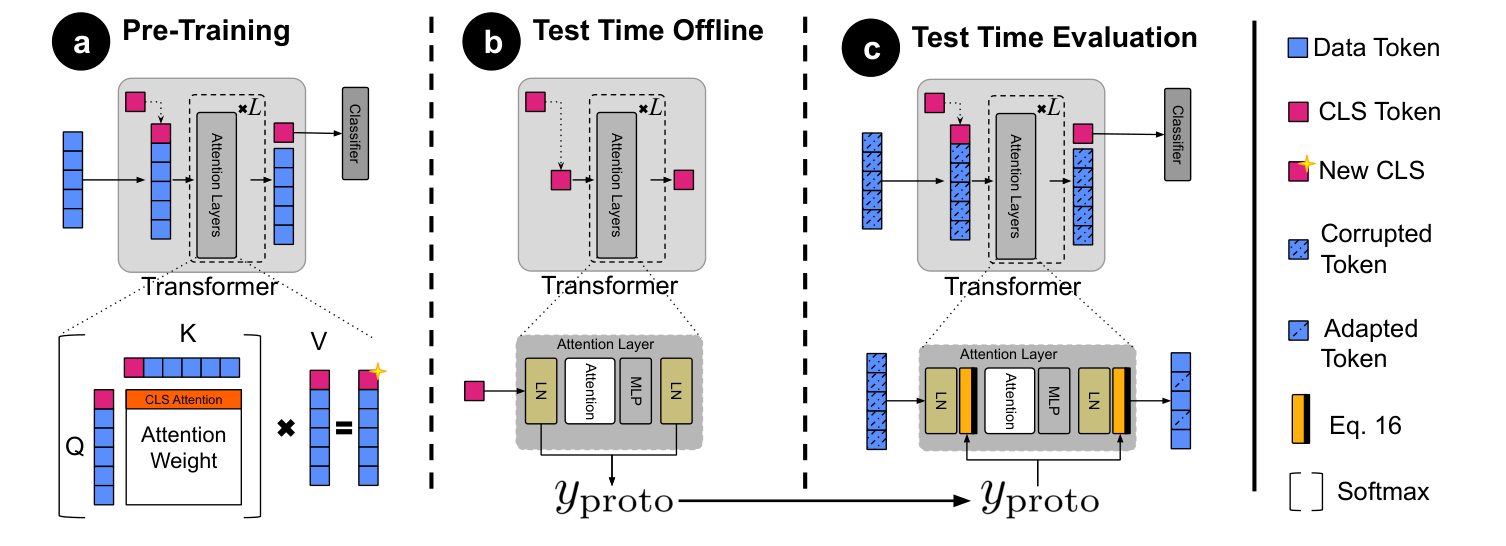 (a) Pretraining 동안 [cls] token은 data token들의 정보를 모은다. (b) 오프라인에서 [cls] token만으로 forward pass를 한 번 하여 모든 LN layer의 prototype \(y_{\text{proto}}\)를 기록한다. (c) Test time에는 저장된 prototype을 사용해 각 LN output을 Eq. 16으로 recolour한다. 논문의 Figure 2.
Background: LN as projection plus rescaling
Token \(x_t \in \mathbb{R}^d\)에 대해 LN은 다음과 같다.
\[\mathrm{LN}(x_t) = \gamma \odot \frac{x_t - \mu_d(x_t)\mathbf{1}}{\sqrt{\sigma_d^2(x_t) + \varepsilon}} + \beta .\]논문은 이를 pre-affine map과 feature별 affine으로 나눈다. \(u = \mathbf{1}/\sqrt{d}\)와 (token 평균을 제거하는) \(C = I - uu^\top\)를 두면,
\[\widehat{\mathrm{LN}}(x_t) = \sqrt{d}\,\frac{C x_t}{\sqrt{\|C x_t\|^2 + d\varepsilon}}, \qquad \mathrm{LN}(x_t) = \Gamma\,\widehat{\mathrm{LN}}(x_t) + \beta, \quad \Gamma = \mathrm{diag}(\gamma).\]즉 LN은 먼저 평균이 0인 hyperplane \(H\)로 projection하고, 반지름을 normalize한 다음, \((\gamma, \beta)\)를 적용한다. Pre-affine 부분은 모든 feature에 상수를 더하는 것에 invariant하며, (\(\varepsilon = 0\)일 때) global rescaling에도 invariant하다.
Theory: LN already standardizes across the batch
Token별로 \(\widehat{\mathrm{LN}}\)은 feature에 걸쳐 정확히 평균 0, second moment 1을 준다(Proposition 1, \(\varepsilon = 0\)). 핵심 결과는 batch 축에 관한 것이다. Token \(t\)와 feature \(j\)를 고정하고 \(H_{b,t} = \widehat{\mathrm{LN}}(x_{b,t})\)라 하자. Theorem 1은 \(d \to \infty\)이고 \(B = B(d) \to \infty\)일 때 다음이 성립한다고 말한다.
\[\bar H_{j,B} \xrightarrow{P} 0, \qquad S^2_{j,B} \xrightarrow{P} 1,\]여기서 \(\bar H_{j,B}\)와 \(S^2_{j,B}\)는 feature \(j\)의 batch 평균과 분산이다. Affine 이후에는 feature별 batch 극한이 \((\beta_j, \gamma_j^2)\)가 된다. 말하자면 LN은 BN의 일을 암묵적으로 수행하며, post-affine의 평균과 scale은 오직 \((\gamma, \beta)\)로만 제어된다. 설계 원칙은 pre-affine 단계는 유지하고 affine만 조정하는 것이다.
(a)-(b) A prototype from the [cls] token
Source의 post-affine moment를 알 수 있다면 feature별로 이를 맞출 수 있을 것이다(논문의 Eq. 13-14). Source-free 설정에서는 이를 알 수 없다. 저자들은 [cls] token이 pretraining 동안 domain 정보를 모은다는 점에 주목한다. 그래서 모델을 고정한 채 [cls] token만으로 forward pass를 한 번 하고(길이 1인 sequence에 대한 attention은 \(V\)에 대한 identity map이다), 각 LN layer에서 다음을 기록한다.
\[y_{\text{proto}} = \mathrm{LN}([\text{cls}]_{\text{emb}}), \quad m^{\text{proto}}_\star = \bar m(y_{\text{proto}}), \quad s^{\text{proto}}_\star = \frac{\|y_{\text{proto}} - m^{\text{proto}}_\star \mathbf{1}\|}{\sqrt{d}} .\]Layer마다 이 두 scalar가 source의 평균과 scale을 대신한다. 이 작업은 한 번만 수행되며 source나 target sample이 필요 없다.
(c) Test-time recolouring
Test time에는 target token의 모든 LN output을, common mode와 global gain만 바꾸는 고정된 affine으로 사상한다.
\[y^{(T)}_{\text{adapt},b,t} = \frac{s^{\text{proto}}_\star}{\bar s(\gamma^S_0)}\, y^{(T)}_{b,t} + \left( m^{\text{proto}}_\star - \frac{s^{\text{proto}}_\star}{\bar s(\gamma^S_0)}\, \bar m(\beta^S_0) \right)\mathbf{1},\]여기서 \(\bar m(\beta^S_0) = d^{-1}\mathbf{1}^\top \beta^S_0\), \(\bar s(\gamma^S_0) = (d^{-1}\|\gamma^S_0\|_2^2)^{1/2}\)이다. 근거는 target LN output의 feature 방향 평균과 scale이 \(\bar m(\beta^S_0)\)와 \(\bar s(\gamma^S_0)\) 주변에 집중된다는 것이며, 따라서 이는 “standardize한 뒤 prototype으로 recolour하는” 단계이다. 동등하게, 각 LN layer의 parameter를 다음으로 교체하는 것이다.
\[\gamma'^T = \frac{s^{\text{proto}}_\star}{\bar s(\gamma^S_0)}\,\gamma^S_0, \qquad \beta'^T = \frac{s^{\text{proto}}_\star}{\bar s(\gamma^S_0)}\,\beta^S_0 + \left( m^{\text{proto}}_\star - \frac{s^{\text{proto}}_\star}{\bar s(\gamma^S_0)}\,\bar m(\beta^S_0) \right).\]Feature 간 상대적 gain은 변하지 않으므로 \(H\) 내부의 geometry는 보존된다. 이 절차는 stateless하며 token당 \(O(d)\)의 연산만 추가한다. 아무것도 갱신되지 않으므로 “standard”(episodic) 예측과 “online” 예측은 동일하다.
Main Experiments
Backbone: Point-MAE(MATE 공개 버전). 지표: 15개 corruption에 대한 평균 top-1 accuracy(%). Batch size 32. 논문 표는 모든 corruption을 나열하지만, 여기서는 “Mean” 열만 보여준다. *로 표시된 결과는 저자들이 재현한 것이고, 나머지는 MATE에서 가져온 것이다.
| Method | Type | ScanObjectNN-C | ModelNet40-C | ShapeNet-C |
|---|---|---|---|---|
| Source Only | - | 36.96 | 54.16 | 61.35 |
| MATE | TTT, backprop | 36.90 | 58.90 | 63.10 |
| SMART-PC | TTT, backprop | 39.60 | 63.10 | 64.40 |
| T3A | TTA | 42.46 | 57.22 | 54.18 |
| TENT* | TTA, backprop | 43.45 | 63.53 | 54.98 |
| AdaBN | backprop-free | 42.69 | 67.91 | 60.44 |
| DUA | backprop-free | 38.66 | 54.73 | 60.77 |
| BFTT3D* | backprop-free, source prototypes | 33.00 | 57.16 | 60.73 |
| LN-TTA | backprop-free, source-free | 49.31 | 69.74 | 64.38 |
| TENT* (online) | TTA, backprop | 45.70 | 64.22 | 63.00 |
초당 처리 point cloud 수(PPS)로 측정한 throughput(같은 표):
| Method | ScanObjectNN-C | ModelNet40-C | ShapeNet-C |
|---|---|---|---|
| Source Only | 88.78 | 112.41 | 93.89 |
| TENT* | 40.72 | 69.17 | 56.90 |
| BFTT3D* | 1.67 | 2.20 | 1.90 |
| LN-TTA | 64.24 | 93.03 | 73.12 |
ScanObjectNN-C 전체 표를 보면 향상이 특정 corruption 하나에서 오는 것이 아니라 고르게 나타난다. LN-TTA는 backprop-free 방법 중 15개 열 가운데 13개에서 굵게 표시되며, AdaBN과 DUA가 조금 더 높은 occlusion과 LiDAR에서만 진다.
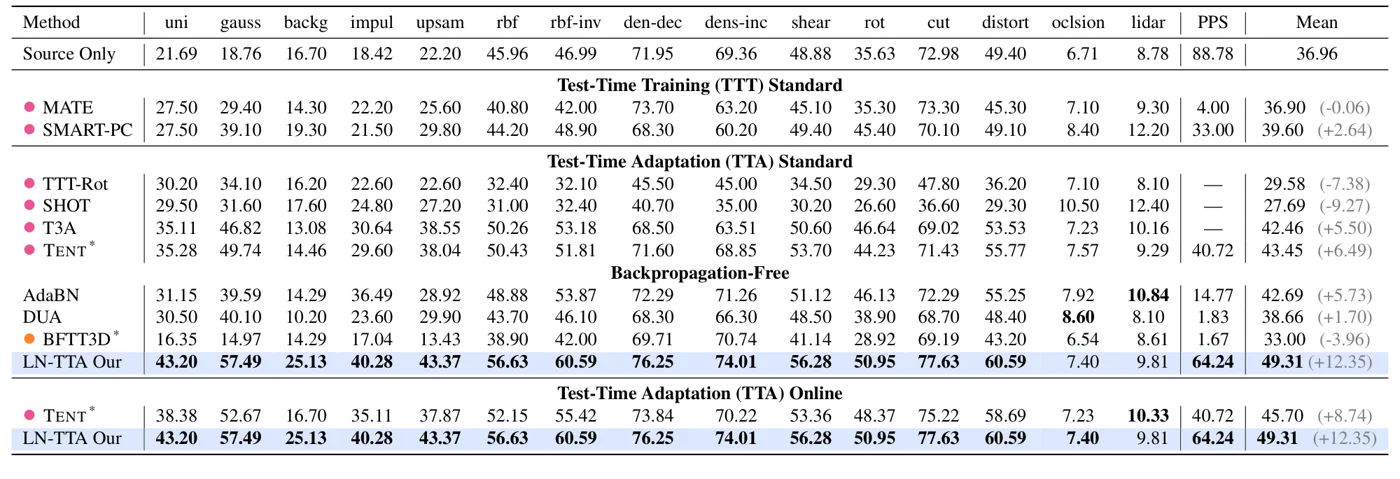 논문의 Table 1: TTT, TTA, backprop-free, online 그룹별로 ScanObjectNN-C의 모든 corruption에 대한 top-1 accuracy(%). LN-TTA는 state를 유지하지 않으므로 standard 행과 online 행이 같다. 논문 Figure.
LN-TTA는 ScanObjectNN-C와 ModelNet40-C에서 가장 좋은 평균을 기록하며, Source Only 대비 +12.35점과 +15.58점 향상되고, standard와 online 두 모드 모두에서 backpropagation 기반 TENT를 앞선다. ShapeNet-C에서는 향상이 +3.03에 그치며, pretraining을 바꾸는 TTT 방법인 SMART-PC가 0.02점 더 높다(64.40 대 64.38). 그곳에서 LN-TTA는 backprop-free 방법 중에서 가장 좋다. 속도는 Source Only의 상당 부분 수준이며, batch size 32에서 최대 GPU memory는 1.468 GB로 TENT의 2.890 GB, BFTT3D의 7.443 GB보다 작다.
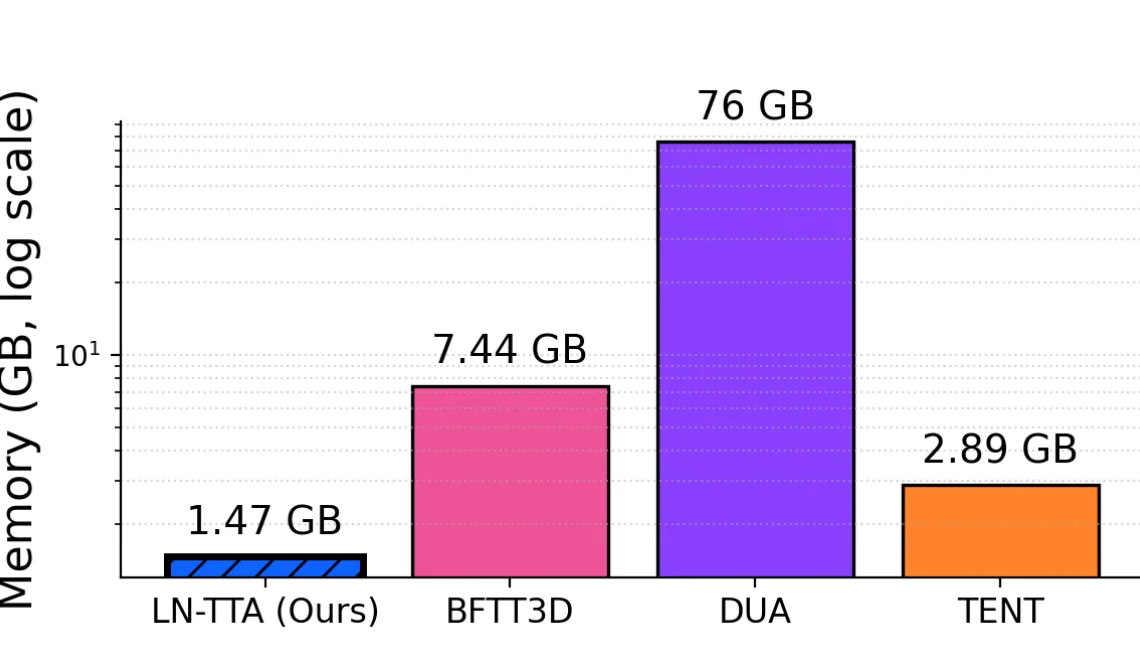 \(B = 32\)에서의 전체 GPU memory(backbone과 data 포함, log scale). LN-TTA는 backward graph, optimizer state, feature bank를 저장하지 않으므로 Source Only 근처에 머무는 반면, DUA는 76 GB에 이른다. 논문 Figure.
논문은 이론도 실험으로 확인한다. Batch size \(B\)와 feature dimension \(d\)를 바꿔 가며, 평균한 feature별 post-LN batch marginal과 \(\mathcal{N}(0,1)\) 사이의 Jensen-Shannon distance를 측정한다.
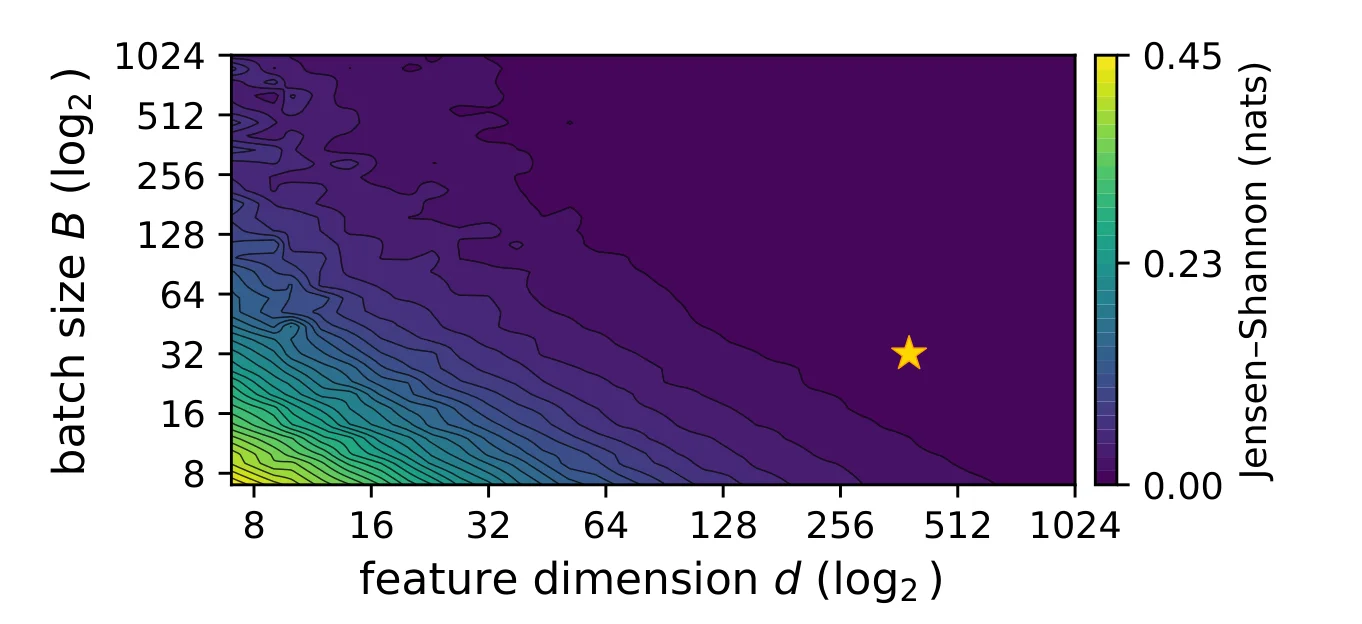 \(B\)나 \(d\)가 커질수록 distance가 줄어들며, \(d\) 방향으로 더 빠르게 줄어든다. 별은 TTA 실험에 쓰인 설정으로, 이미 거의 0인 영역에 있다. 논문 Figure.
Limitations
- 저자들은 성능이 여전히 batch size에 의존하며, 다른 modality와 backbone으로의 확장은 향후 과제라고 밝힌다. Supplementary는 ShapeNet-C에서 batch size가 커질수록 정확도가 오르는 것을 보여준다.
- 모든 실험은 단일 backbone(Point-MAE)을 사용한다. 이 방법은 LN layer와 [cls] token이 필요하므로, PointNet이나 DGCNN 같은 BN 전용 point network에는 적용되지 않는다.
- Eq. 16의 recolouring은 prototype과 source LN parameter만 사용한다. 모든 target domain에 대해 같은 고정된 reparameterization이며, test batch의 statistics는 전혀 읽지 않는다.
- Supplementary에 따르면 설정은 TENT를 따라 BN statistics를 초기화한다. AdaBN만으로도 ModelNet40-C에서 이미 67.91에 도달한다. 논문에는 BN 초기화와 LN 편집을 분리하는 ablation이 없어, 향상의 얼마가 각 부분에서 오는지 불분명하다.
- 이론은 asymptotic하다(\(d, B \to \infty\), \(\varepsilon = 0\), i.i.d. sample). [cls] 전용 forward pass를 source moment의 proxy로 쓰는 것은 동기가 제시되었을 뿐 증명되지 않았다.
- Occlusion과 LiDAR는 매우 낮게 유지되며(ScanObjectNN-C에서 7.40과 9.81), ShapeNet-C에서는 이 두 corruption에서 DUA가 더 좋다.