Abstract
Zero-shot CLIP은 비교적 calibration이 잘 되어 있다. 이를 적응시키는 일반적인 방법들, 즉 few-shot adapter(CLIP-Adapter, TIP-Adapter, TaskRes), prompt learning(CoOp, CoCoOp, MaPLe), test-time prompt tuning(TPT)은 accuracy를 높이지만 confidence를 더 나쁘게 만들며, 그 격차는 ImageNet distribution shift 같은 out-of-distribution 데이터에서 가장 크다. 표준적인 해결책은 이 설정에 맞지 않는다. Temperature scaling은 test distribution에서 온 labeled validation set이 필요하고, supervised training에서의 miscalibration에 대한 최근 설명(logit norm 증가, LogitNorm이 다루는 문제)은 여기서 일어나는 현상과 맞지 않는다.
논문은 원인이 logit norm이 아니라 logit range(최대 logit 빼기 최소 logit)의 증가라고 주장한다. 그런 다음 각 sample의 logit이 그 sample 자신의 zero-shot logit range 안에 머물도록 제약한다. 세 가지 버전이 제시된다. ZS-Norm과 Penalty는 adaptation 과정에서 작용하고, SaLS(Sample-adaptive Logit Scaling)는 inference 시점의 post-hoc rescaling으로서 TPT를 포함한 어떤 adapted model에도 적용된다.
Motivation
출발점은 adaptation이 calibration을 대가로 accuracy를 얻는다는 관찰이며, 이는 특정 방법 하나가 아니라 CLIP adaptation의 모든 계열에서 나타난다. 저자들은 두 ImageNet shift에서의 reliability diagram으로 이를 보여 준다. Zero-shot CLIP은 diagonal에 가깝다(ImageNet-V2에서 ECE 2.87, Sketch에서 3.14). CoOp, CLIP-Adapter, TPT를 거치면 막대가 diagonal 아래로 내려가는데, 이는 model이 실제 accuracy보다 더 confident하다는 뜻이다. ECE는 V2에서 9.40(CLIP-Adapter), 13.77(TPT)로, Sketch에서는 최대 15.28(TPT)까지 오른다.
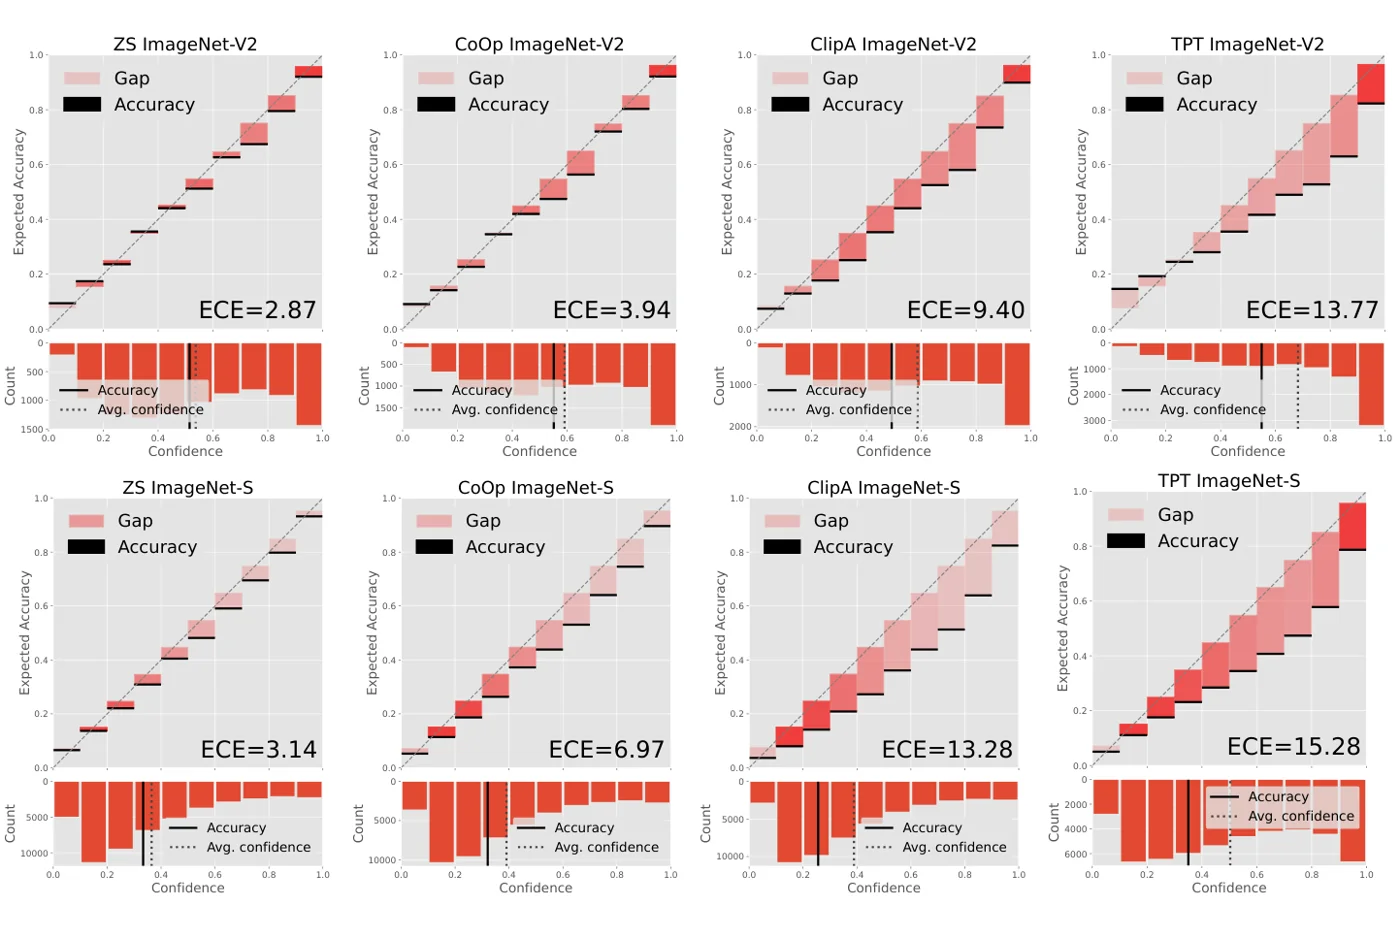 ImageNet-V2(위)와 ImageNet-Sketch(아래)에서 zero-shot CLIP, CoOp, CLIP-Adapter, TPT의 reliability diagram. 모든 adaptation 계열이 막대를 diagonal 아래로 밀어내며(overconfidence), TPT가 가장 심하다. 논문 Figure.
선행 연구의 두 가지 공백 때문에 이를 고치기 어렵다. Temperature scaling 같은 post-hoc 방법은 test distribution의 labeled data가 필요한데, distribution shift 상황이나 test time에는 그런 data가 없다. 또 supervised training에서 나온 설명, 즉 overconfidence가 logit norm 증가에서 온다는 설명은 CLIP adaptation과 맞지 않는다. Method 절의 norm-vs-range 그림처럼 adaptation 후 norm은 자주 줄어드는데 ECE는 오른다. ECE와 함께 움직이는 것은 logit range이다. 여기서 method의 핵심 insight가 나온다. Zero-shot CLIP이 이미 sample마다 calibration이 잘 된, label 없이 얻을 수 있는 reference range를 제공하므로, adapted logit을 그 range에 묶어 두면 된다.
Method
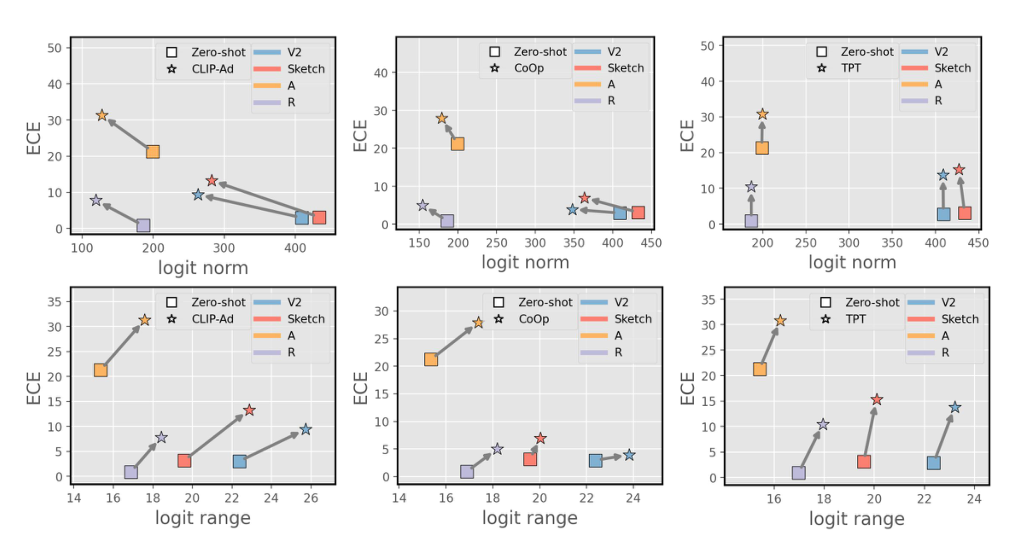 ImageNet-V2/Sketch/A/R에서 zero-shot CLIP(사각형)과 adapted model(별: CLIP-Adapter, CoOp, TPT)의 logit norm(위)과 logit range(아래)에 따른 ECE. Adaptation 후 norm은 자주 줄어드는 반면 ECE는 오르지만, range는 ECE와 함께 오른다. 논문에는 pipeline 그림이 없으며, 이 motivating figure가 핵심 논지이다. 그림은 논문에서 가져왔다.
Norm or range?
Logit 벡터를 \(\boldsymbol{l} = \lVert\boldsymbol{l}\rVert\,\hat{\boldsymbol{l}}\)로 쓴다. Supervised network에 대한 선행 연구는 overconfidence의 원인을 \(\lVert\boldsymbol{l}\rVert\)의 증가로 보았다. 두 가지 단순한 사실이 norm과 range를 구분한다.
- 음이 아닌 모든 logit에 상수 \(a>0\)를 더하면 norm은 커지지만 softmax는 변하지 않는다(Proposition 1). 따라서 norm이 크다는 것만으로 confidence가 높다는 뜻은 아니다.
- Range \(R(\boldsymbol{l})=\max(\boldsymbol{l})-\min(\boldsymbol{l})\)에 대해, \(a>1\)로 scaling하면 range와 top-class probability가 모두 커진다(Proposition 2).
위 그림은 이를 실험적으로 확인한다. 세 계열 모두에서 zero-shot(사각형)에서 adapted model(별)로 갈 때 ECE와 logit range가 함께 증가하는 반면, logit norm은 자주 감소한다. Entropy minimization은 이긴 logit을 다른 logit들로부터 멀어지게 하므로, 같은 논리가 TPT에도 적용된다.
The constraint
목표는 통상적인 objective \(\mathcal{H}\)(few-shot 방법에서는 cross-entropy, TPT에서는 entropy)로 학습하면서, 모든 logit을 같은 sample의 zero-shot min과 max 안에 두는 것이다.
\[\min\ \mathcal{H}(\boldsymbol{Y},\boldsymbol{P}) \quad \text{s.t.} \quad l^{\text{ZS-min}}_{i}\mathbf{1}\leq\boldsymbol{l}_{i}\leq l^{\text{ZS-max}}_{i}\mathbf{1}\quad\forall i.\]Lagrangian 방법은 deep model에 쓰기 어려우므로, 논문은 세 가지 근사를 제시한다.
ZS-Norm and Penalty (during adaptation)
ZS-Norm은 loss를 계산하기 전에 logit을 zero-shot range로의 min-max map으로 rescale한다.
\[\boldsymbol{l}^{\prime}_{i}=\frac{l^{\text{ZS-max}}_{i}-l^{\text{ZS-min}}_{i}}{l^{\text{max}}_{i}-l^{\text{min}}_{i}}\left(\boldsymbol{l}_{i}-l^{\text{min}}_{i}\mathbf{1}\right)+l^{\text{ZS-min}}_{i}\mathbf{1}.\]Penalty는 원래 logit을 유지하고, zero-shot range를 벗어나는 모든 logit에 대해 ReLU penalty를 더한다(\(\lambda=10\)).
\[\mathcal{H}(\boldsymbol{Y},\boldsymbol{P})+\lambda\sum_{i}\sum_{k=1}^{K}\left(\text{ReLU}(l_{ik}-l^{\text{ZS-max}}_{i})+\text{ReLU}(l^{\text{ZS-min}}_{i}-l_{ik})\right).\]SaLS (at inference)
SaLS는 같은 min-max map \(\boldsymbol{l}^{\prime}_{i}\)를 test time에만, 이미 adapt된 모델의 logit에 적용한다. 각 test sample에 대해 zero-shot 모델을 한 번 실행하여 \(l^{\text{ZS-min}}_{i}\)와 \(l^{\text{ZS-max}}_{i}\)를 얻고, adapted logit을 그 구간으로 rescale한 뒤 softmax를 취한다. 이 map은 sample별 positive affine transform이므로 predicted class는 바뀌지 않으며, accuracy는 base method와 정확히 같다. 저자들은 이를 unsupervised 방식의 sample별 temperature scaling으로 설명한다. Temperature는 zero-shot range와 adapted range의 비율로 정해지며, validation data가 필요 없다.
Range를 더 줄인다고 더 좋아지지는 않는다. SaLS에서 zero-shot range를 1/2이나 1/4로 줄이면 예측이 uniform distribution에 가까워져 ECE가 다시 증가한다.
Main Experiments
Test-time prompt tuning, 11개 fine-grained dataset(평균). Accuracy와 ECE는 % 단위이다. RN50 수치는 본문(Table 3), ViT-B/16 수치는 appendix(Table 9)에서 가져왔다. SaLS는 구성상 accuracy를 바꾸지 않는다.
| Method | RN50 Acc | RN50 ECE | ViT-B/16 Acc | ViT-B/16 ECE |
|---|---|---|---|---|
| Zero-shot | 56.03 | 5.04 | 63.92 | 3.91 |
| TPT | 58.03 | 11.27 | 65.18 | 11.36 |
| TPT w/ ZS-Norm | 57.94 | 10.57 | 65.13 | 10.82 |
| TPT w/ Penalty | 57.69 | 9.58 | 65.22 | 9.27 |
| TPT w/ SaLS | 58.03 | 9.26 | 65.18 | 9.88 |
| C-TPT | 57.54 | 6.33 | 64.59 | 4.81 |
| C-TPT w/ ZS-Norm | 57.63 | 5.74 | 64.41 | 5.03 |
| C-TPT w/ Penalty | 57.52 | 3.14 | 64.68 | 4.61 |
| C-TPT w/ SaLS | 57.54 | 5.22 | 64.59 | 4.48 |
참고: 논문의 RN50 표에서 C-TPT 평균 ECE 값은 나열된 dataset별 값의 평균과 일치하지 않는다(C-TPT w/ Penalty의 경우 dataset별 값의 평균은 5.93이며, 이는 ImageNet 열에 인쇄된 숫자이다. TPT 행들은 일치한다). 위 수치는 인쇄된 그대로 옮겼다.
이 표의 dataset별 버전(RN50)을 보면 TPT에서의 이득이 어디서 오는지 알 수 있다. SaLS는 TPT의 calibration이 가장 나쁜 dataset, 예를 들어 EuroSAT(21.00에서 12.31)과 DTD(25.29에서 21.09)에서 가장 크게 도움이 되고, TPT가 이미 zero-shot에 가까운 곳(Caltech, Pets)에서는 변화가 작다.
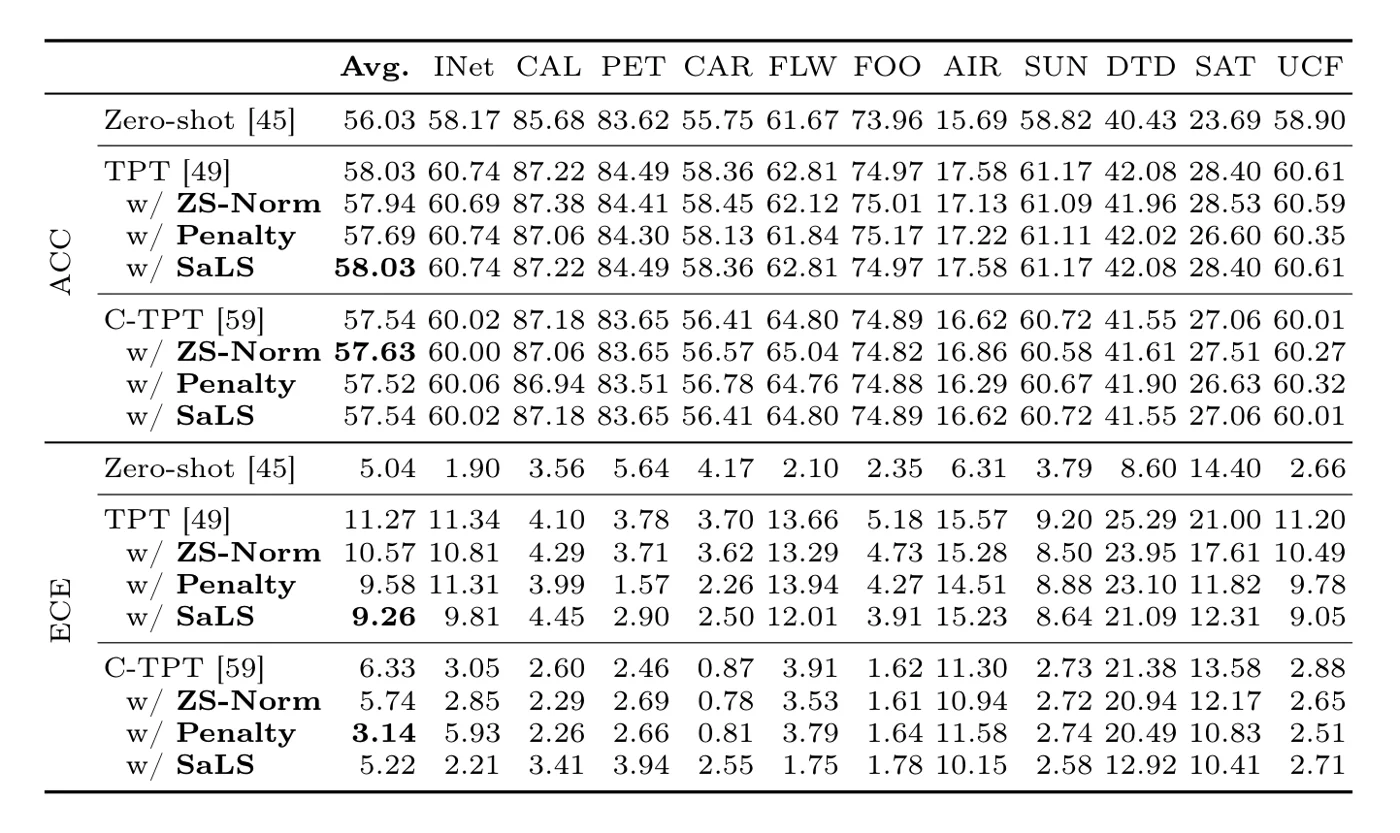 논문의 Table 3: RN50으로 ImageNet과 10개 fine-grained dataset에서 TPT와 C-TPT에 ZS-Norm, Penalty, SaLS를 적용한 accuracy(위)와 ECE(아래). SaLS의 accuracy 행은 base method와 동일하다. 논문 Figure.
ViT-B/16에서 TPT의 reliability diagram도 같은 내용을 시각적으로 보여 준다. StanfordCars에서는 차이가 작지만, EuroSAT에서는 TPT가 심하게 overconfident하고(ECE 20.42) SaLS가 막대를 diagonal 쪽으로 되돌린다(13.88). 다만 Penalty가 더 낫다(8.53).
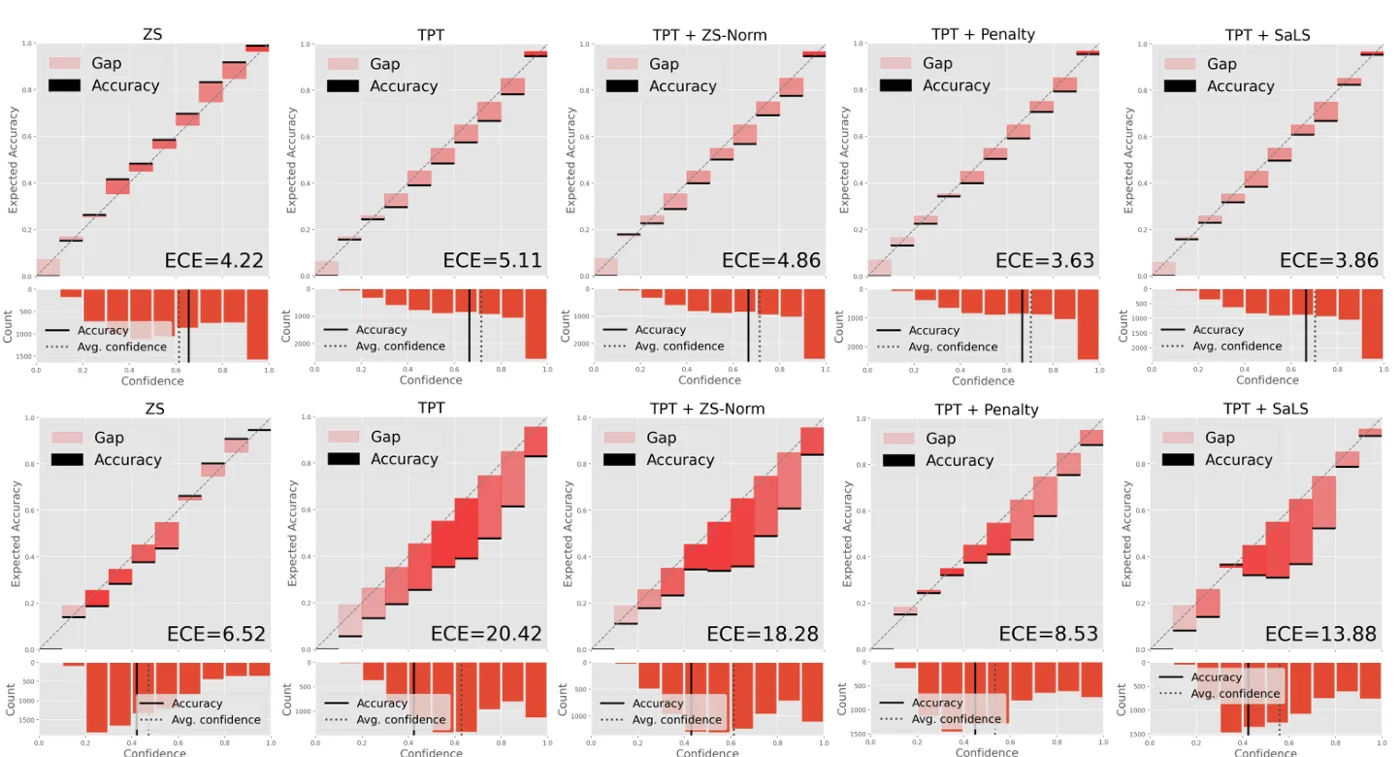 StanfordCars(위)와 EuroSAT(아래)에서 zero-shot, TPT, TPT + ZS-Norm, TPT + Penalty, TPT + SaLS의 reliability diagram(ViT-B/16). EuroSAT에서 confidence와 accuracy 사이의 gap이 Penalty로는 크게, SaLS로는 그보다 덜 줄어든다. 논문 Figure.
Few-shot adaptation(16-shot ImageNet), ViT-B/16, ImageNet-V2/Sketch/A/R 평균. Table 1(b)와 2(d)에서 가져왔다. Zero-shot은 57.15 / 4.78이다. 각 칸은 Acc / ECE이다.
| Method | Base | w/ Penalty | w/ SaLS |
|---|---|---|---|
| CLIP-Adapter | 50.61 / 7.82 | 51.59 / 6.38 | 50.61 / 4.38 |
| TIP-Adapter(f) | 25.86 / 63.63 | 49.23 / 40.98 | 25.86 / 44.37 |
| TaskRes | 58.01 / 7.52 | 58.31 / 6.65 | 58.01 / 6.21 |
| CoOp | 58.41 / 6.61 | 59.18 / 4.91 | 58.41 / 4.90 |
| CoCoOp | 59.74 / 4.83 | 60.20 / 3.89 | 59.74 / 4.81 |
| MaPLe | 60.07 / 4.13 | 60.62 / 3.78 | 60.07 / 4.38 |
TPT에서 SaLS는 fine-grained 데이터에서 accuracy 변화 없이 ECE를 약 1.5~2포인트 낮추지만, 그 결과(9.26과 9.88)는 여전히 zero-shot보다 훨씬 높고 C-TPT보다도 높다. C-TPT 위에 적용하면 표에서 가장 낮은 ViT-B/16 ECE(4.48)를 얻는다. TPT를 사용한 ImageNet distribution shift(appendix Table 8)에서는 효과가 더 작다. RN50에서 ECE가 17.58에서 16.74로, ViT-B/16에서 11.81에서 10.86으로 줄어든다. Few-shot adaptation에서는 adapter에서 향상이 더 크지만(예: CLIP-Adapter 7.82에서 4.38), CoCoOp이나 MaPLe 같은 강한 prompt learning 방법에서는 변화가 거의 없거나 ECE가 약간 나빠지며, Penalty가 같거나 더 나은 경우가 많다.
저자들은 이 fix가 그들이 원인으로 지목한 양에 실제로 작용하는지도 확인한다. SaLS로 calibration한 뒤, CLIP-Adapter, CoOp, TPT 모두에서 네 ImageNet shift의 평균 logit range가 줄어드는 반면, CLIP-Adapter와 CoOp의 logit norm은 오히려 커진다. 이는 norm이 아니라 range가 중요하다는 주장과 일치한다.
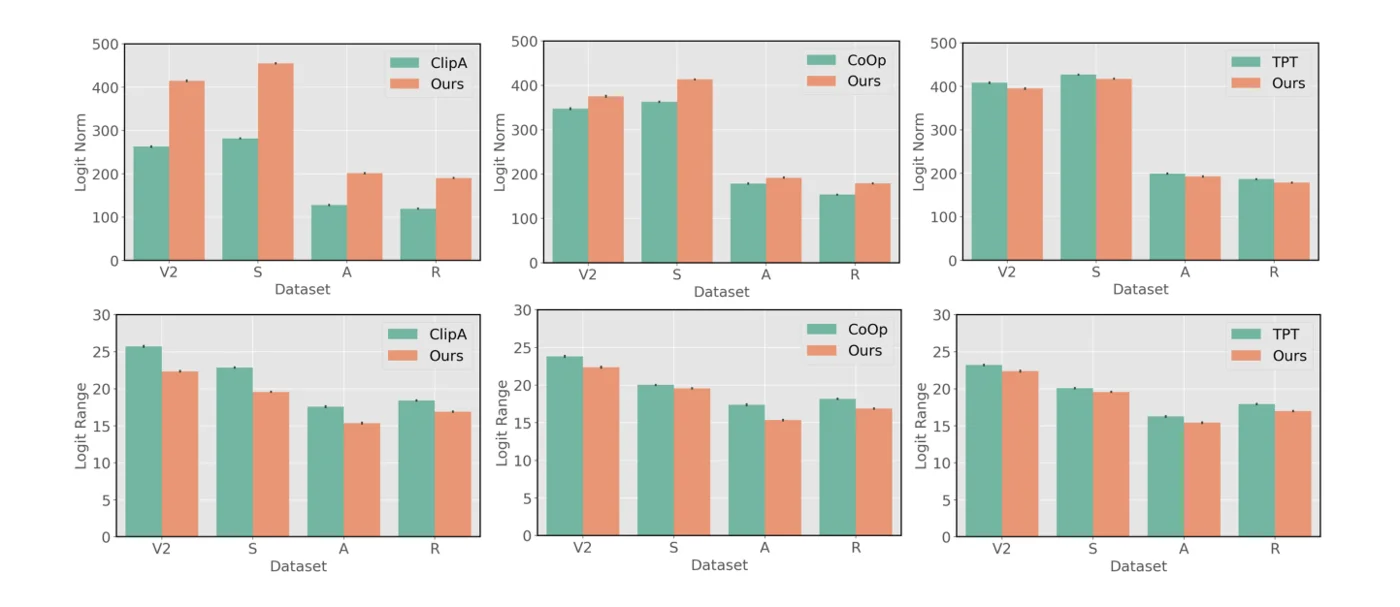 ImageNet-V2/Sketch/A/R에서 CLIP-Adapter, CoOp, TPT의 평균 logit norm(위)과 logit range(아래), SaLS 적용 전과 후(“Ours”). Calibration은 모든 경우에 range를 낮추지만 norm은 자주 커진다. 논문 Figure.
Limitations
- Zero-shot이 좋은 reference라고 가정. 목표 range는 zero-shot CLIP에서 온다. Zero-shot 자체의 calibration이 나쁜 경우(ImageNet-A에서 RN50 zero-shot의 ECE는 21.32), 그 range에 맞추는 것으로는 크게 개선할 수 없다.
- TPT 단독에는 효과가 제한적. TPT w/ SaLS는 fine-grained dataset에서 여전히 zero-shot의 약 두 배 ECE를 가지며, ImageNet distribution shift에서는 ECE가 훨씬 높다. 후속 연구(CoTS)는 비교한 TPT calibration baseline들 중 SaLS를 가장 약한 것으로 보고한다.
- 항상 도움이 되지는 않음. SaLS는 MaPLe의 ECE를 높이고(4.13에서 4.38) CoCoOp은 거의 그대로 둔다. ZS-Norm은 CLIP-Adapter의 accuracy와 ECE를 해친다. 가장 좋은 변형은 방법에 따라 다르다.
- Range만 통제됨. Rescaling은 최대 logit과 최소 logit 사이의 간격을 정하지만, 나머지 logit들이 그 구간 안에서 어떻게 퍼져 있는지는 정하지 않는다.
- 추가 zero-shot forward pass. 각 test sample마다 adapted logit 외에 zero-shot logit이 필요하다. TPT에서는 zero-shot logit이 이미 계산되어 있고 CoTS는 SaLS로 인한 추가 시간을 측정하지 못했지만, 다른 adapted model에서는 두 번째 forward pass가 된다.
- 보고 불일치. Table 3의 일부 RN50 C-TPT 평균이 dataset별 값과 맞지 않아, RN50에서의 C-TPT 비교를 해석하기 어렵다.