Abstract
Point cloud classifier는 noise, density 변화, occlusion, LiDAR 방식의 sparsity 같은 corruption 하에서 accuracy를 잃는다. 이 논문이 나올 당시에는 3D classification을 위한 test-time adaptation(TTA) 방법이 거의 없었다. MATE는 pretraining 중 masked autoencoder objective가 필요하므로 실제로는 test-time training이다. BFTT3D는 source prototype memory를 유지하므로 완전히 source-free하지 않다. TENT는 어떤 pretrained model에도 적용되지만 각 batch의 단일 view에서만 적응하므로, 모델을 sharp하고 불안정한 solution으로 몰아갈 수 있다.
논문은 SWA와 SWAD의 weight averaging 아이디어를 빌려온다. 이들에서는 학습 과정을 따라 weight를 평균하면 더 flat minima에 도달하는 경향이 있다. 여기서는 다양성이 training step이 아니라 입력에서 나온다. 같은 point cloud를 서로 다른 FPS/KNN sampling으로 여러 번 tokenize한다. 각 sampling에 TENT를 실행하고, 그 결과 얻은 normalization parameter를 평균한다. 논문은 방법에 이름을 붙이지 않았으며, 이 글에서는 저자들의 코드 저장소 이름을 따라 SVWA라고 부른다.
Motivation
논문이 지적하는 공백은 accuracy보다 setting에 관한 것이다. 2D에서는 fully test-time adaptation(평범하게 학습된 model을 unlabeled test data만으로 adaptation하는 것)이 잘 연구되어 있고, entropy minimization(TENT, SHOT)과 BN statistics update가 표준 도구이다. 3D point cloud classification에서 저자들이 꼽는 TTA 방법은 두 개뿐이며, 둘 다 이 setting에 맞지 않는다. MATE는 masked autoencoder branch를 더해 source pretraining 자체를 바꾸므로 test-time training이고, BFTT3D는 source prototype memory를 adaptation에 가져간다. Source data 없이 기성 pretrained classifier에 바로 쓸 수 있는 방법이 비어 있었다.
두 번째 관찰은 그런 방법이 어떻게 adaptation해야 하는가에 관한 것이다. TENT는 각 test batch의 단일 view로 normalization layer를 update하는데, 한 view에 대한 entropy objective는 그 batch의 noise에 overfit한 sharp minimum에 머물 수 있다. SWA와 SWAD는 optimization trajectory의 여러 지점에서 weight를 평균하면 더 flat하고 robust한 minimum에 도달한다는 것을 보였다. 핵심 insight는 point cloud가 이를 위한 값싸고 label 없는 diversity 원천을 제공한다는 점이다. FPS와 KNN tokenization은 stochastic하므로, 같은 object를 global shape는 유지한 채 조금씩 다른 patch set으로 여러 번 다시 sampling할 수 있다. 각 sampling에서 adaptation하고 그 weight를 평균하면 training trajectory 없이도 SWAD 방식의 averaging을 얻는다. 논문에는 이 논지를 위한 pilot figure가 없으며, Main Experiments의 augmentation ablation이 generic augmentation이 아니라 sampling variation이 유용한 diversity 원천이라는 가장 가까운 근거이다.
Method
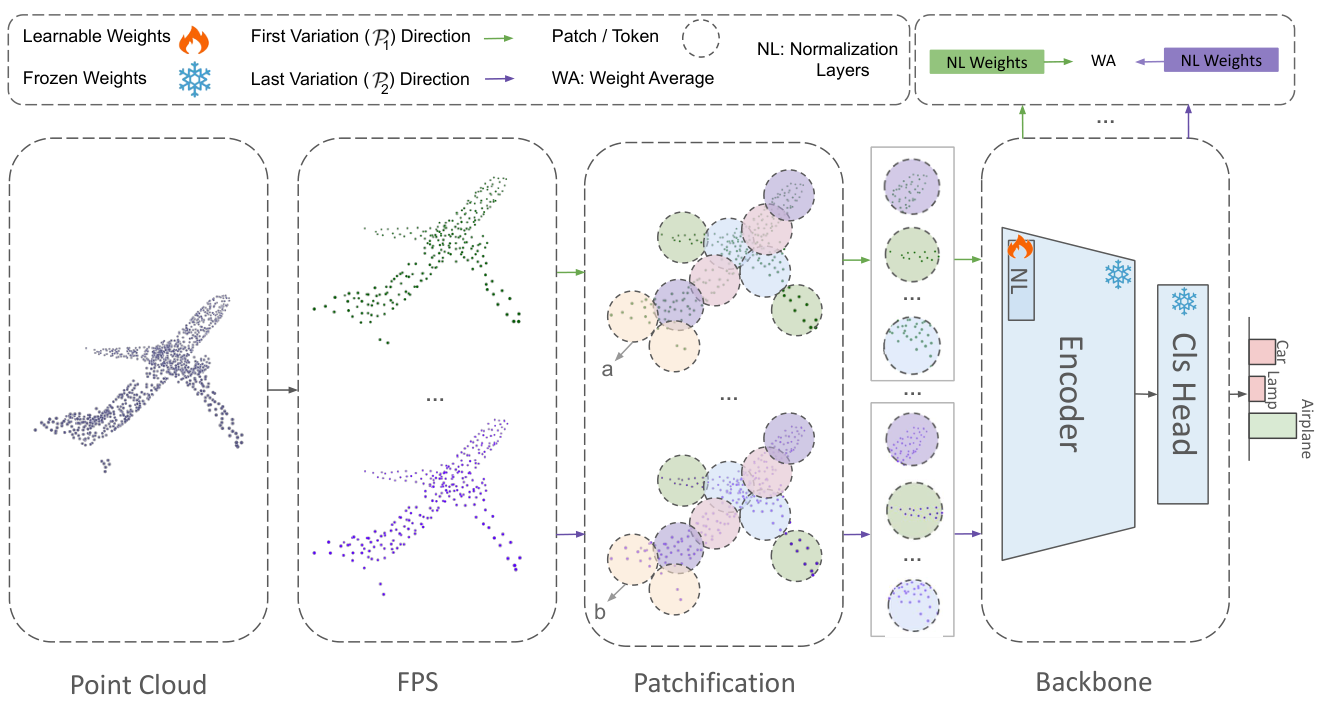 입력 point cloud를 FPS로 여러 번 sampling하고 KNN으로 patchify한다(patch a와 b는 sampling마다 다르다). Normalization layer(NL)만 학습 가능하다. 각 sampling마다 TENT로 따로 adapt시킨 뒤, adapt된 NL weight를 평균한다(WA). 논문의 Figure 1.
Sampling variation
Point cloud는 \(P \in \mathbb{R}^{N^p \times 3}\)이다. Patch center는 Farthest Point Sampling(FPS)으로 고른다.
\[c_i = \arg\max_{p \in P} \min_{c_j \in \{c_1, \dots, c_{i-1}\}} \|p - c_j\|_2 .\]각 center는 \(K\)개의 nearest neighbor로 이루어진 patch를 가진다.
\[P_i = \Bigl\{ p \in P \mid p \in \mathrm{KNN}(c_i) \Bigr\},\]이로써 \(\mathcal{P} \in \mathbb{R}^{N \times K \times 3}\)를 얻는다. FPS는 시작점에 의존하므로, 다른 center와 neighbor로 다시 실행하면 같은 물체의 \(N^V\)개 버전 \(\{\mathcal{P}_1, \dots, \mathcal{P}_V\}\)를 얻는다. 각 버전은 local patch geometry를 조금씩 바꾸지만 global shape은 유지한다. Transformer가 아닌 backbone(PointNet, DGCNN)에서는 \(K = 1\)로 두므로, 각 “patch”는 FPS로 선택된 점 하나일 뿐이다.
TENT on each variation
각 \(\mathcal{P}_v\)에 대해 TENT와 같이 prediction entropy \(\mathcal{H}\)를 최소화하여 normalization parameter \(\gamma, \beta\)만 갱신한다.
\[\gamma^*_i, \beta^*_i = \arg\min_{\gamma, \beta} \mathbb{E}\left[ \mathcal{H}\left( f_\theta(\mathcal{P}_v) \right) \right].\]다른 모든 weight는 고정된다. Point-MAE에서는 BN과 LN layer를 모두 adapt시키며, PointNet과 DGCNN에는 BN만 있다.
Weight averaging
각 variation에서 adapt한 후, weight \(\theta_v\)를 저장하고 평균한다.
\[\theta_{\text{avg}} = \frac{1}{N^V} \sum_{v=1}^{V} \theta_v .\]동기는 SWAD의 robust risk minimization \(\hat{\mathcal{E}}^\gamma_{\mathcal{D}}(\theta) = \max_{\|\Delta\| \le \gamma} \hat{\mathcal{E}}_{\mathcal{D}}(\theta + \Delta)\)에서 나온 flat minima 논거이다. 논문은 이 objective를 최적화하지는 않는다. 서로 다른 sampling에서 adapt한 모델들을 평균하면 더 flat한 영역에 도달하고, 개별 adaptation의 오차가 완화된다고 주장한다.
Parallel implementation
기본 “parallel” 모드에서는 각 variation 전에 모델을 reset하므로, \(N^V\)개의 adaptation은 서로 독립적이다. Normalization parameter만 바뀌므로 backbone은 공유되고, \((\gamma, \beta)\)의 \(N^V\)개 사본은 하나의 “weight average normalization layer” 안에 존재한다. 기본값은 \(N^V = 6\), TENT 1회 iteration, learning rate \(10^{-3}\)의 AdamW, Point-MAE와 PointNet에서 batch size 128이다.
Main Experiments
Top-1 accuracy(%)로, Table 1-3에서 가져온 15개 corruption의 평균이다(논문은 모든 corruption별 결과도 제시한다). Backbone은 Point-MAE, PointNet, DGCNN 세 가지이다. Baseline의 일부만 실었으며, 가장 강한 source-free 방법들과 BFTT3D이다. *로 표시된 결과는 저자들이 재현하지 않은 것이고, 나머지는 모두 재현되었다. †는 adaptation 중 source data를 사용한다. “-“는 논문에 해당 항목이 없음을 뜻한다.
| Backbone | Method | ModelNet40-C | ShapeNet-C | ScanObjectNN-C |
|---|---|---|---|---|
| Point-MAE | Source-Only | 53.9 | 61.3 | 33.1 |
| MATE* | 64.3 | 63.1 | 47.0 | |
| PL | 71.0 | 66.2 | 45.8 | |
| MEMO | 69.4 | 42.3 | 46.1 | |
| TENT | 72.1 | 66.1 | 45.9 | |
| Ours | 75.0 | 67.0 | 46.1 | |
| PointNet | Source-Only | 46.5 | 49.8 | 29.7 |
| PL | 59.6 | 54.3 | 39.5 | |
| BFTT3D† | 66.2 | - | 45.5 | |
| MEMO | 58.5 | 28.0 | 40.2 | |
| TENT | 60.4 | 55.5 | 39.7 | |
| Ours | 61.3 | 56.9 | 40.6 | |
| DGCNN | Source-Only | 58.8 | 63.6 | 37.9 |
| PL | 70.7 | 67.0 | 48.1 | |
| BFTT3D† | 70.7 | - | 56.1 | |
| MEMO | 63.5 | 28.7 | 45.0 | |
| TENT | 71.6 | 67.0 | 48.3 | |
| Ours | 74.2 | 66.0 | 49.9 |
이 방법은 9개의 backbone-dataset 조합 중 8개에서 TENT를 앞선다. 가장 뚜렷한 향상은 ModelNet40-C에서 나타난다(Point-MAE에서 +2.9, DGCNN에서 +2.6). 그 외에는 차이가 1포인트 미만인 경우가 많고, DGCNN의 ShapeNet-C에서는 TENT보다 1포인트 낮다. BFTT3D는 PointNet과 DGCNN/ScanObjectNN-C에서 더 높지만, source prototype을 사용한다. Ablation에서 Point-MAE의 ModelNet40-C accuracy는 \(N^V\)가 2에서 12로 늘어남에 따라 약 74.0%에서 76.0%로 오르며, sampling variation을 flip이나 rotation으로 대체하면 성능이 나빠지고 때로는 Source-Only보다 낮아진다.
ModelNet40-C의 corruption별 전체 표를 보면 Point-MAE에서 TENT 대비 향상이 거의 모든 corruption에 고르게 퍼져 있고, upsampling(78.2에서 87.0), LiDAR(51.2에서 55.3), background noise(26.7에서 33.0)에서 가장 크게 오른다. PointNet과 DGCNN에서는 결과가 더 엇갈리며, 여러 corruption에서 여전히 TENT가 더 좋다.
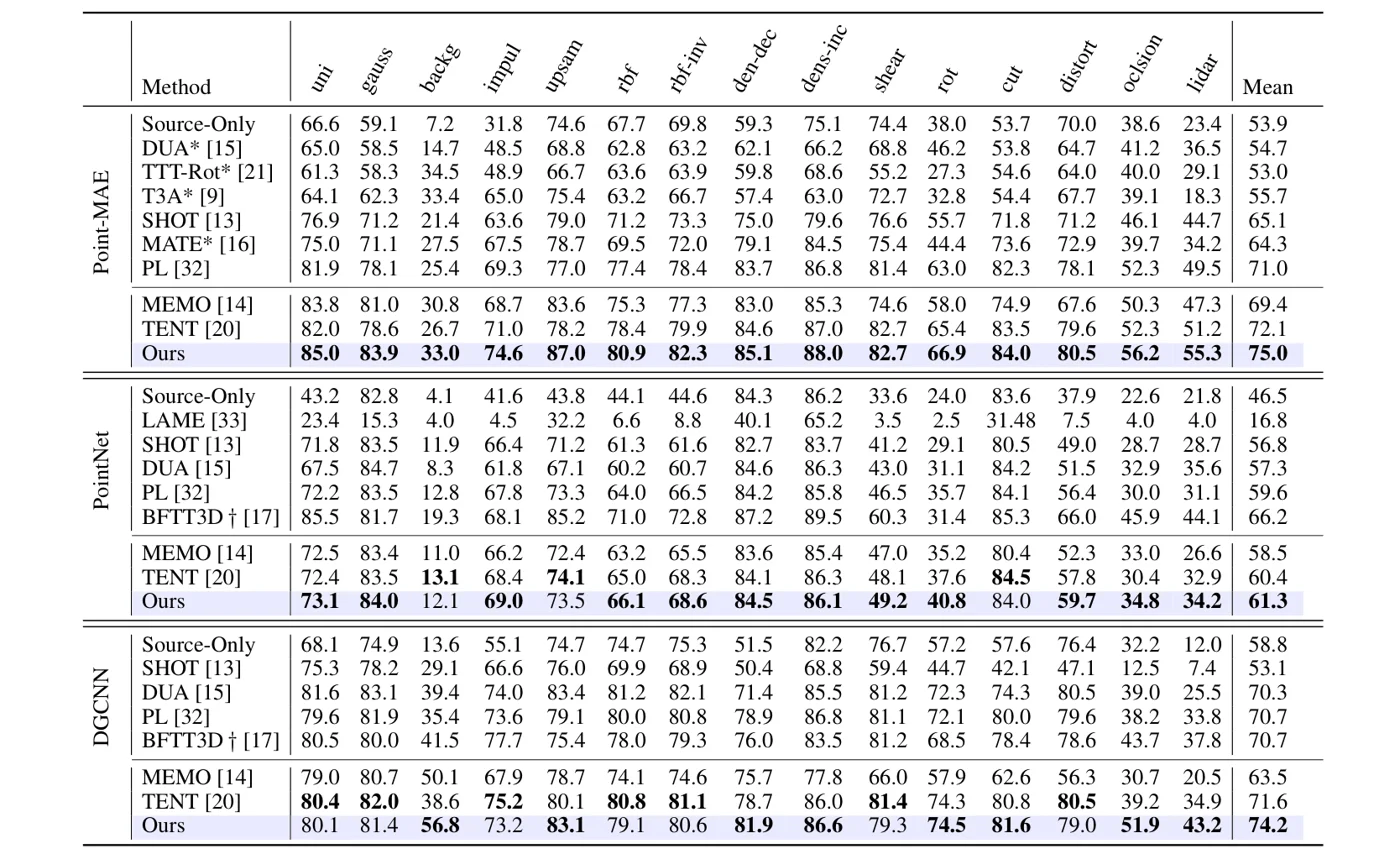 논문의 Table 1: Point-MAE, PointNet, DGCNN에서 ModelNet40-C의 15개 corruption 각각에 대한 top-1 accuracy. “Ours”(강조된 행)는 Point-MAE의 대부분 열에서 최고이고, 다른 backbone에서는 TENT 대비 차이가 작고 고르지 않다. 논문 Figure.
Point-MAE로 ModelNet40-C에서 수행한 두 ablation이 설계를 뒷받침한다. Accuracy는 sampling 수 \(N^V\)에 따라 꾸준히 오르고, 같은 weight averaging pipeline을 re-sampling 대신 표준 augmentation으로 구동하면 horizontal flip과 rotation은 Source-Only(53.95)보다 낮아지며, jitter는 68.97, sampling variation은 75.03에 이른다.
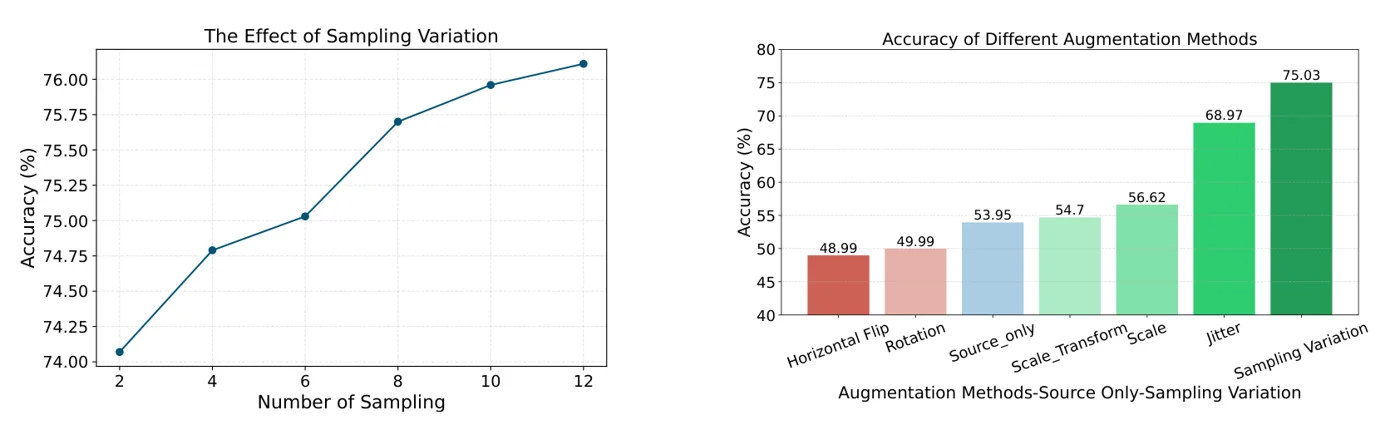 왼쪽: sampling 수 \(N^V\)에 따른 accuracy(2에서 약 74.1%, 12에서 76.1%). 오른쪽: 서로 다른 variation 원천을 쓴 weight averaging pipeline. Jitter와 sampling variation만 Source-Only를 크게 앞선다. Batch size 128, iteration 1회. 논문 Figure.
TENT 대비 우위는 batch size와 adaptation step 수가 달라져도 유지된다. Batch size 8에서 이 방법은 약 69%, TENT는 약 66%이며, iteration을 늘리면 둘 다 좋아지지만 차이는 약 3포인트로 유지된다.
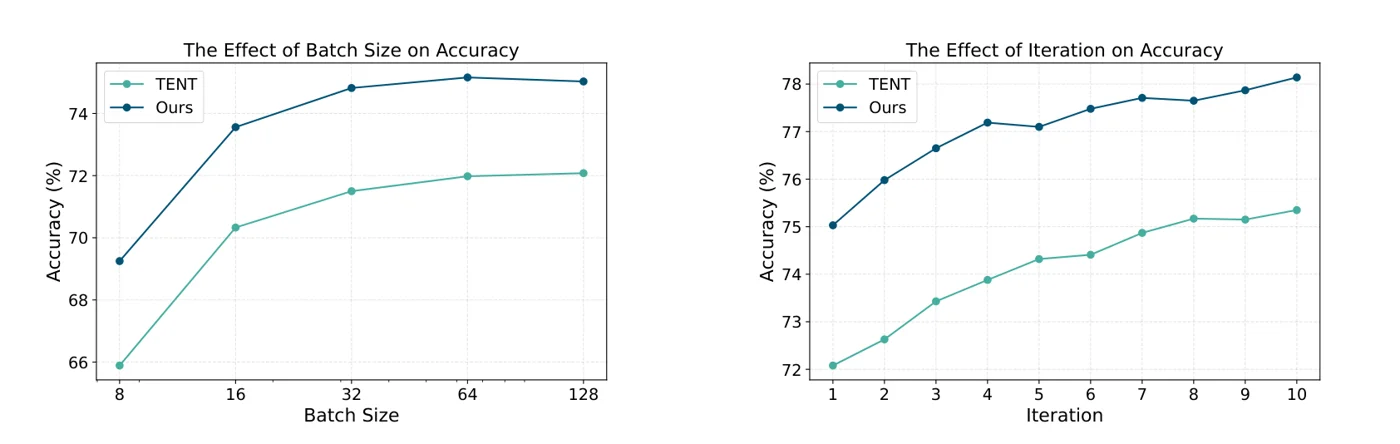 Point-MAE로 ModelNet40-C에서 batch size(왼쪽, 8~128)와 iteration 수(오른쪽, 1~10)를 바꿀 때 TENT와 이 방법(“Ours”)의 accuracy. 이 방법이 전 구간에서 TENT보다 높다. 논문 Figure.
Limitations
- 논문에는 limitations 섹션이 없다.
- 여전히 backpropagation이 필요하며, batch마다 \(N^V\)번의 forward pass와 backward pass를 실행한다. PointNet에서 \(N^V = 6\)일 때 보고된 adaptation 시간은 TENT의 21 ms에 비해 약 26 ms이고, memory overhead는 약 1.8%이다. 이 수치는 parallel 모드의 PointNet에 대해서만 제시된다.
- 기본 batch size가 크다(Point-MAE와 PointNet에서 128). Batch size ablation은 batch size 8까지 TENT 대비 향상이 유지됨을 보여주지만, Point-MAE의 ModelNet40-C에서만 확인되었다.
- 많은 설정에서 TENT 대비 향상이 작고 DGCNN의 ShapeNet-C에서는 오히려 음수이므로, 이점이 backbone과 dataset에 걸쳐 균일하지 않다.
- Flat minima에 의한 설명은 유추에 기댄 것이다. 논문은 flatness를 측정하거나 robust risk를 최적화하지 않는다.
- Sampling variation은 FPS/KNN tokenization에 의존한다. PointNet과 DGCNN에서는 서로 다른 FPS subset을 고르는 것으로 축소된다.