Abstract
MATE는 network가 masking된 각 test sample을 분류하기 전에 reconstruct하도록 하면 3D point cloud에 대한 test-time training(TTT)이 효과가 있음을 보였다. 저자들은 두 가지 문제를 지적한다. 첫째, MATE는 surface point를 reconstruct하므로 그 feature가 noise 같은 surface 수준 corruption에 여전히 민감하다. 둘째, test time에 backpropagation으로 network의 모든 parameter를 갱신하므로 frame rate가 낮다.
SMART-PC는 reconstruction task를 skeleton prediction으로 바꾼다. 각 patch는 local shape을 요약하는 sphere(skeletal point와 radius)를 예측한다. 이러한 추상화는 high-frequency noise를 평균화해 없애므로, encoder는 corruption 하에서 더 잘 버티는 feature를 학습한다. 이런 feature가 있으면 online adaptation에서 backpropagation을 생략하고 BatchNorm의 running mean과 variance만 갱신할 수 있다.
Motivation
논문은 3D point cloud의 대표적인 TTT 방법인 MATE에서 출발해 두 가지 약점을 지적한다. 첫째는 self-supervised task가 무엇을 가르치느냐이다. MATE는 masking된 surface point를 reconstruct하므로, encoder는 noise, dropout, LiDAR sparsity 같은 corruption이 망가뜨리는 바로 그 surface detail을 modeling하도록 학습된다. Surface를 재현하도록 만들어진 feature는 surface 변화에 민감하게 남는다. 둘째는 cost이다. MATE는 test sample마다 network의 모든 parameter로 backpropagation하여 adaptation하므로 약 10 frames per second에 머물고 real-time 사용과는 거리가 멀다.
핵심 insight는 pretext task를 바꿔서 feature가 충분히 robust해지면 adaptation에 gradient가 더 이상 필요 없게 만드는 것이다. Skeleton은 중심이 shape 내부에 있고 radius가 surface까지 닿는 sphere들의 집합으로, geometry의 abstraction이다. 전체 구조는 유지하면서 high-frequency noise와 local distortion은 평균화해 없앤다. 저자들은 encoder가 surface 대신 skeleton을 예측하도록 학습되면 feature가 근본적인 shape에 의존하게 되고, 2D의 BN adaptation 연구처럼 BatchNorm statistics만 값싸게 update해도 shift를 따라갈 수 있다고 주장한다.
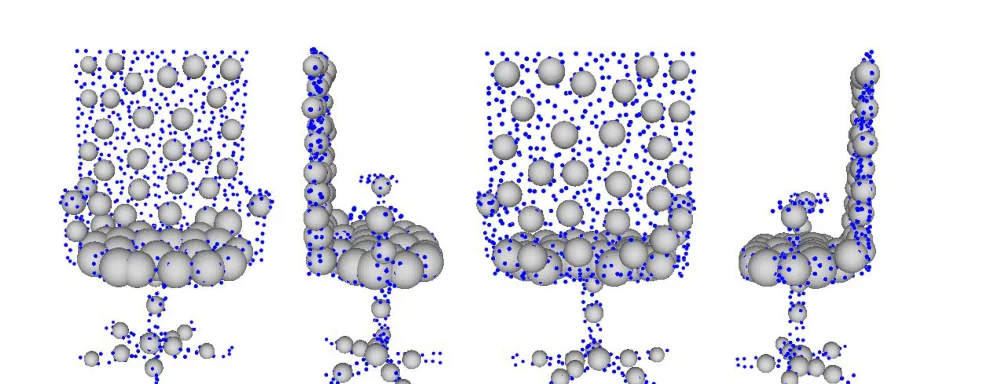 앞과 옆에서 본 chair point cloud. 회색 sphere는 radius와 함께 그린 skeletal point, 파란 점은 sphere surface에서 sampling한 point이다. 수십 개의 sphere만으로 seat, back, leg가 표현된다. 논문 Figure.
Method
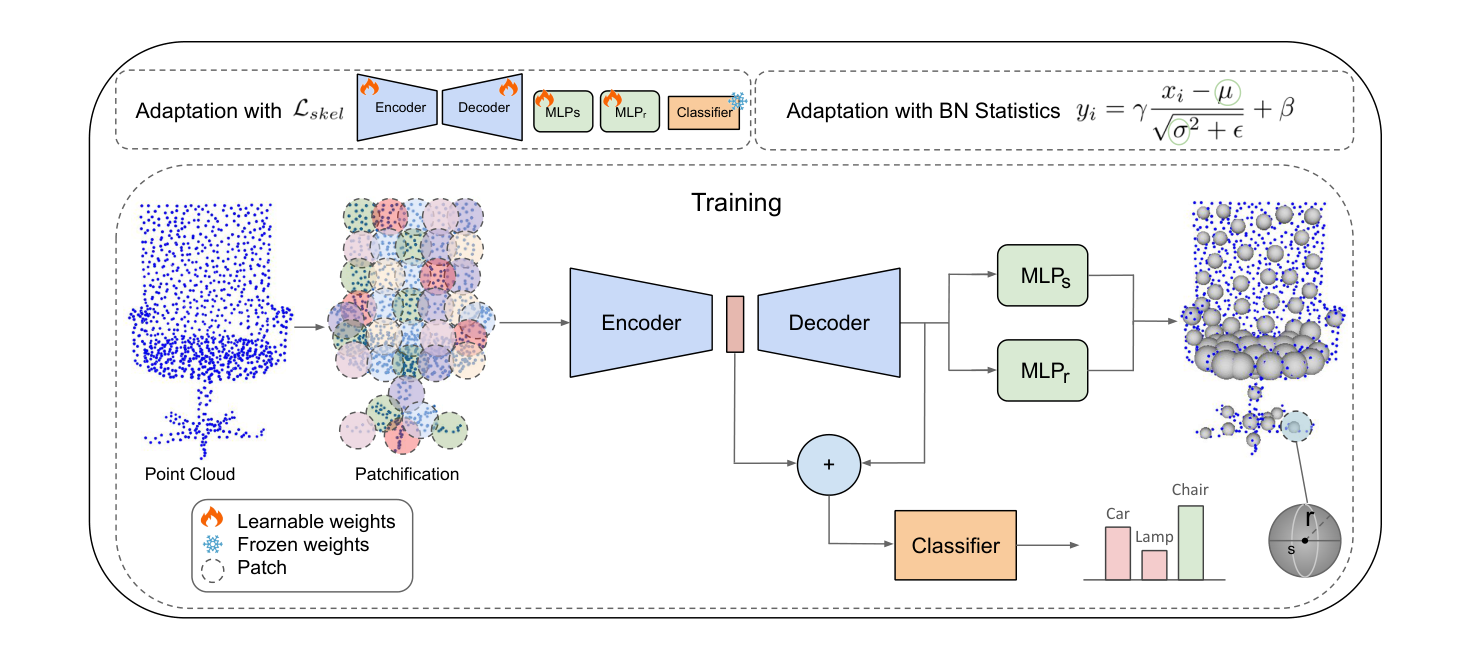 SMART-PC: 공유된 Point-MAE encoder-decoder가 skeletal sphere의 center와 radius를 예측하는 두 MLP, 그리고 encoder와 decoder feature의 합을 입력으로 받는 classifier에 feature를 공급한다. Test time에 모델은 skeletal loss와 backpropagation으로 adapt하거나, BatchNorm statistics만 갱신하여 adapt한다. 그림은 논문에서 가져왔다.
Patchification
Point cloud \(P\in\mathbb{R}^{N\times 3}\)를 patch로 나눈다. Farthest point sampling으로 \(M\)개의 center를 고르고, 각 center는 \(K\)개의 nearest neighbor를 취한다.
\[C = \mathit{FPS}(P)\in\mathbb{R}^{M\times 3}, \qquad P_{local} = \mathit{kNN}(C,P)\in\mathbb{R}^{M\times K\times 3}\]Skeletal branch
Skeletal sphere는 \(s=\big(c_s, r(c_s)\big)\in\mathbb{R}^4\)로, center \(c_s\)와 shape surface까지 닿는 radius \(r(c_s)\)로 이루어진다. Sphere 위의 임의의 점은 unit vector \(v\)에 대해 \(p = c_s + r(c_s)\cdot v\)이므로, sphere들의 집합으로 전체 shape을 기술할 수 있다.
Encoder와 decoder가 patch를 처리하고, 두 MLP가 patch마다 sphere 하나를 예측한다.
\[F_{enc}=E(P_{local}), \quad F_{dec}=D(F_{enc}), \quad c_s=\mathit{MLP}_s(F_{dec})\in\mathbb{R}^{M\times 3}, \quad r=\mathit{MLP}_r(F_{dec})\in\mathbb{R}^{M\times 1}\]Point2Skeleton 같은 이전의 skeleton 방법들은 skeletal point를 input point들의 convex combination으로 만든다. SMART-PC는 feature로부터 이를 직접 예측한다. 저자들은 raw point를 prediction에 입력하면 task가 너무 쉬워져 encoder가 robust feature를 학습하지 못한다고 주장한다.
Classification branch
Classifier는 encoder와 decoder feature의 합을 사용하므로, skeleton과 관련된 decoder feature도 함께 본다.
\[F_{combined} = F_{enc} + F_{dec}, \qquad p = \mathit{Softmax}\big(\mathit{MLP}_{cls}(F_{combined})\big)\]Training losses
Skeletal branch는 세 가지 loss로 self-supervised 학습된다. Point-to-sphere loss는 input point들을 sphere surface로, sphere들을 input point 쪽으로 끌어당긴다.
\[\mathcal{L}_{p2s} = \sum_{p\in P}\Big(\min_{s\in S}\|p-c_s\|_2 - r(c_s)\Big) + \sum_{s\in S}\Big(\min_{p\in P}\|c_s-p\|_2 - r(c_s)\Big)\]Sampling loss는 입력 \(P\)와 sphere surface에서 sampling한 점 \(T\) 사이의 Chamfer distance이다. Radius loss \(\mathcal{L}_{radius} = -\sum_{s\in S} r(c_s)\)는 radius를 키우도록 밀어서, 각 sphere가 더 넓은 영역을 덮고 개별 noisy point의 영향이 줄어들게 한다. 전체 loss는 다음과 같다.
\[\mathcal{L}_{total} = \underbrace{\mathcal{L}_{p2s} + \lambda_1\mathcal{L}_{sampling} + \lambda_2\mathcal{L}_{radius}}_{\mathcal{L}_{skel}} + \mathcal{L}_{cls}\]여기서 \(\mathcal{L}_{cls}\)는 labeled source data에 대한 cross entropy이다. Ablation에서 가장 좋은 계수는 Point2Skeleton을 따른다.
Test-time adaptation
그림의 위쪽 행은 두 가지 adaptation 방식을 보여준다. 둘 다 MATE의 protocol을 따른다(batch size 1로, sample을 augmented view들의 batch로 복사하며, 여기서는 random mask 대신 random rotation을 사용한다).
- Online, BatchNorm only(† 표시): sample 사이에는 모델을 reset하지 않고, corruption 종류가 바뀔 때만 reset한다. Gradient는 계산하지 않는다. \(y_i = \gamma \frac{x_i-\mu}{\sqrt{\sigma^2+\epsilon}} + \beta\)에서 BatchNorm의 running mean \(\mu\)와 variance \(\sigma^2\)만 target data로 갱신된다.
- \(\mathcal{L}_{skel}\)를 사용하는 Online 또는 Standard: classifier를 고정한 채, skeletal loss를 backpropagate하여 encoder, decoder, skeletal MLP를 갱신한다. Standard 모드는 batch마다 모델을 reset하고 20회 iteration을 실행하므로, 여기서는 BatchNorm statistics만으로는 도움이 되지 않는다.
Main Experiments
Backbone: Point-MAE. 지표: 15개 corruption에 대한 평균 top-1 accuracy(%). Batch size 1, 1회 iteration(online) 또는 20회 iteration(standard). Table 1에서 옮겼으며, 논문의 MATE 대비 차이는 생략했다. *는 저자들이 재현한 결과, †는 backpropagation-free adaptation, ‡는 diffusion 기반 방법을 나타낸다.
| Method | ModelNet-40C | ScanObjectNN-C | ShapeNet-C |
|---|---|---|---|
| Org-SO* | 54.0 | 37.0 | 61.3 |
| MATE-SO* | 54.4 | 34.5 | 56.5 |
| SMART-PC-SO | 61.7 | 38.7 | 64.5 |
| DUA | 54.7 | 38.7 | 60.8 |
| TTT-Rot | 53.0 | – | 60.9 |
| SHOT | 26.6 | 29.6 | 36.2 |
| T3A | 55.7 | – | 54.4 |
| TENT | 26.5 | 27.7 | 37.4 |
| CloudFixer-Standard‡ | 68.0 | - | - |
| CloudFixer-Online‡ | 77.2 | - | - |
| DDA-Standard‡ | 68.1 | - | - |
| SVWA-Standard* | 57.1 | 37.4 | 50.5 |
| MATE-Standard* | 63.0 | 36.9 | 63.1 |
| SMART-PC-Standard | 63.1 | 39.6 | 64.4 |
| BFTT3D* | 57.2 | 33.0 | 60.7 |
| MATE-Online* | 70.6 | 36.9 | 69.1 |
| SMART-PC-Online† | 70.8 | 46.7 | 65.9 |
| SMART-PC-Online | 72.9 | 47.4 | 67.1 |
ModelNet40-C에서의 adaptation 속도(appendix Table 4):
| Method | DDA | CloudFixer | BFTT3D | SVWA (Nv=2) | MATE | SMART-PC |
|---|---|---|---|---|---|---|
| FPS | 0.04 | 1.07 | 6.83 | 10.86 | 10.79 | 59.52 |
가장 뚜렷한 향상은 adaptation 이전에 나타난다. Skeleton pre-training만으로도 MATE-SO 대비 source-only accuracy가 ModelNet-40C에서 7.3포인트, ShapeNet-C에서 8.0포인트 오른다. Standard 모드에서 SMART-PC와 MATE는 비슷하다(ModelNet-40C에서 63.1 vs 63.0). BatchNorm만 사용하는 변형은 ModelNet-40C에서 MATE-Online과 비슷하고, ScanObjectNN-C에서는 약 5.5배의 frame rate로 약 10포인트 앞서지만, ShapeNet-C에서는 MATE-Online보다 뒤처진다(65.9 vs 69.1). CloudFixer-Online은 ModelNet-40C에서 여전히 더 높지만(77.2), 약 1 FPS로 동작한다.
속도에 대한 주장은 ScanObjectNN-C의 online setting에서 직접 확인된다. BatchNorm-only update를 쓰면 SMART-PC는 각 sample을 48개든 24개든 augmented copy로 늘려도 약 46.6%의 accuracy를 유지하고, 24개일 때 30 frames per second를 넘는다. MATE는 sample마다의 backpropagation이 cost를 지배하므로 약 8~10 FPS에서 약 37%에 머문다.
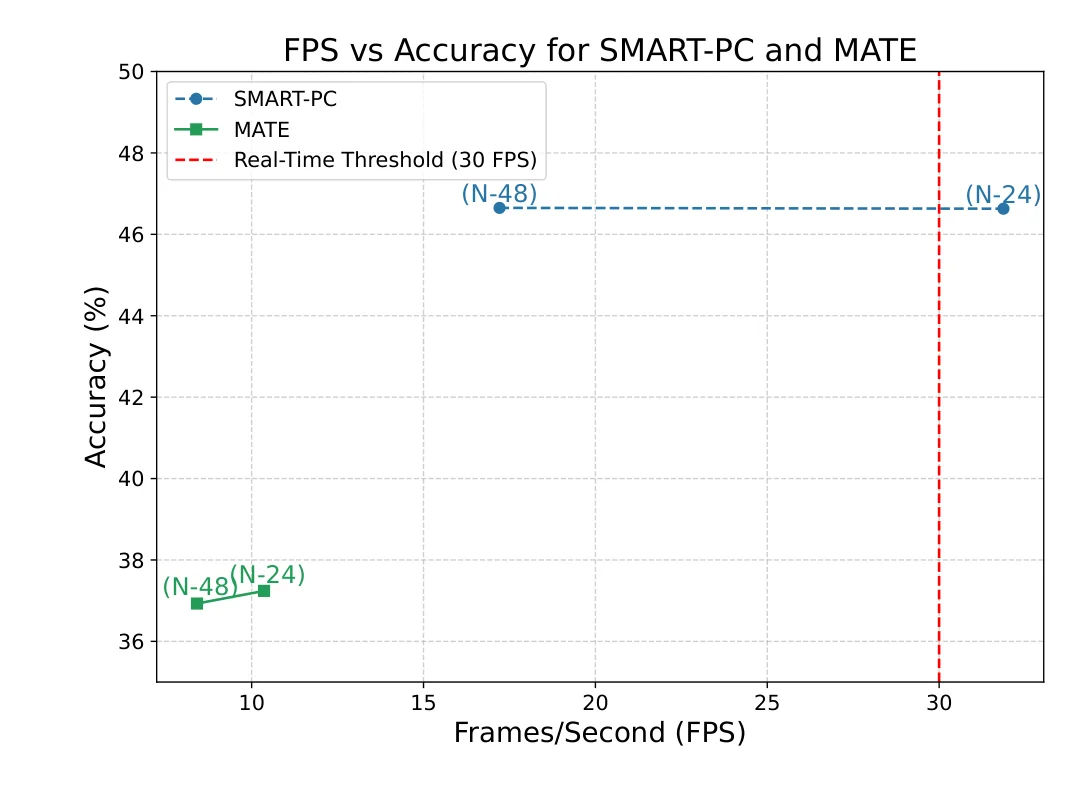 ScanObjectNN-C에서 sample당 48개 또는 24개의 augmented copy(N-48, N-24)로 수행한 online adaptation. SMART-PC(BatchNorm-only)는 N-24에서 accuracy 손실 없이 30 FPS real-time 선을 넘고, MATE는 약 10포인트 낮고 약 3배 느리다. 논문 Figure.
두 ablation은 adaptation protocol을 살펴본다. ScanObjectNN-C의 online mode에서 SMART-PC는 adaptation 중 augmentation이 없어도 46.42%에 이르러 이미 MATE(36.93%)보다 훨씬 높고, rotation을 쓰면 약 1포인트 더 오른다(47.36%). ModelNet40-C의 standard mode에서는 batch size가 8일 때 67.94%에서 128일 때 73.42%로 오르지만, main result는 MATE와 맞추기 위해 batch size 1을 쓴다.
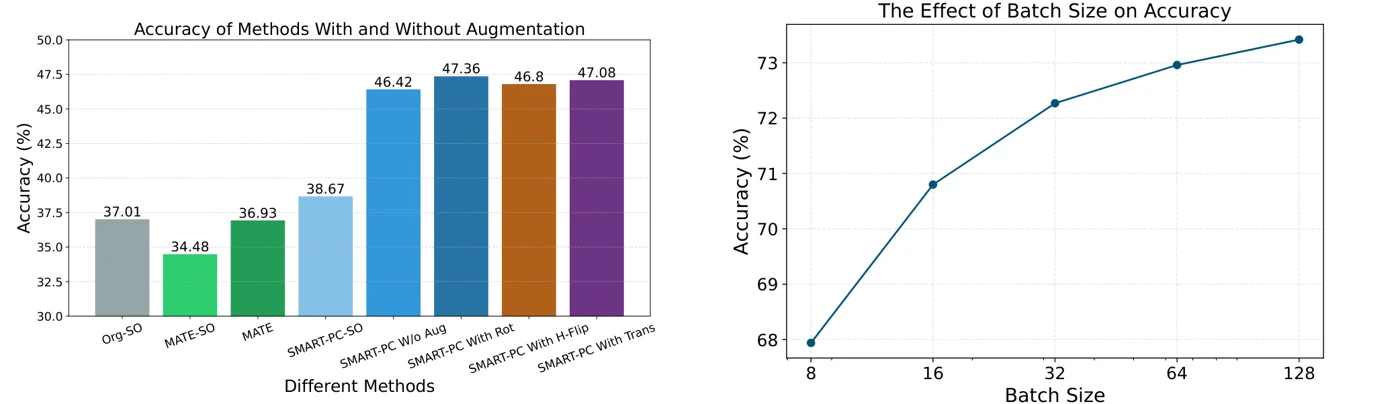 왼쪽: ScanObjectNN-C에서 source-only baseline, MATE, 그리고 adaptation 중 augmentation 없음, rotation, horizontal flip, translation을 쓴 SMART-PC의 online accuracy. 오른쪽: standard mode에서 batch size가 ModelNet40-C 평균 accuracy에 주는 영향. 논문 Figure.
Appendix는 BatchNorm statistics update만으로 충분한 이유도 시각화한다. Clean data에서는 첫 BN layer들의 feature distribution이 pretrained running statistics와 맞는다. Corrupted data에서는 distribution이 그로부터 벗어나며(특히 classifier의 BN layer에서 뚜렷하다), adapted statistics는 learned weight를 전혀 바꾸지 않고도 corrupted distribution 위로 다시 옮겨 간다.
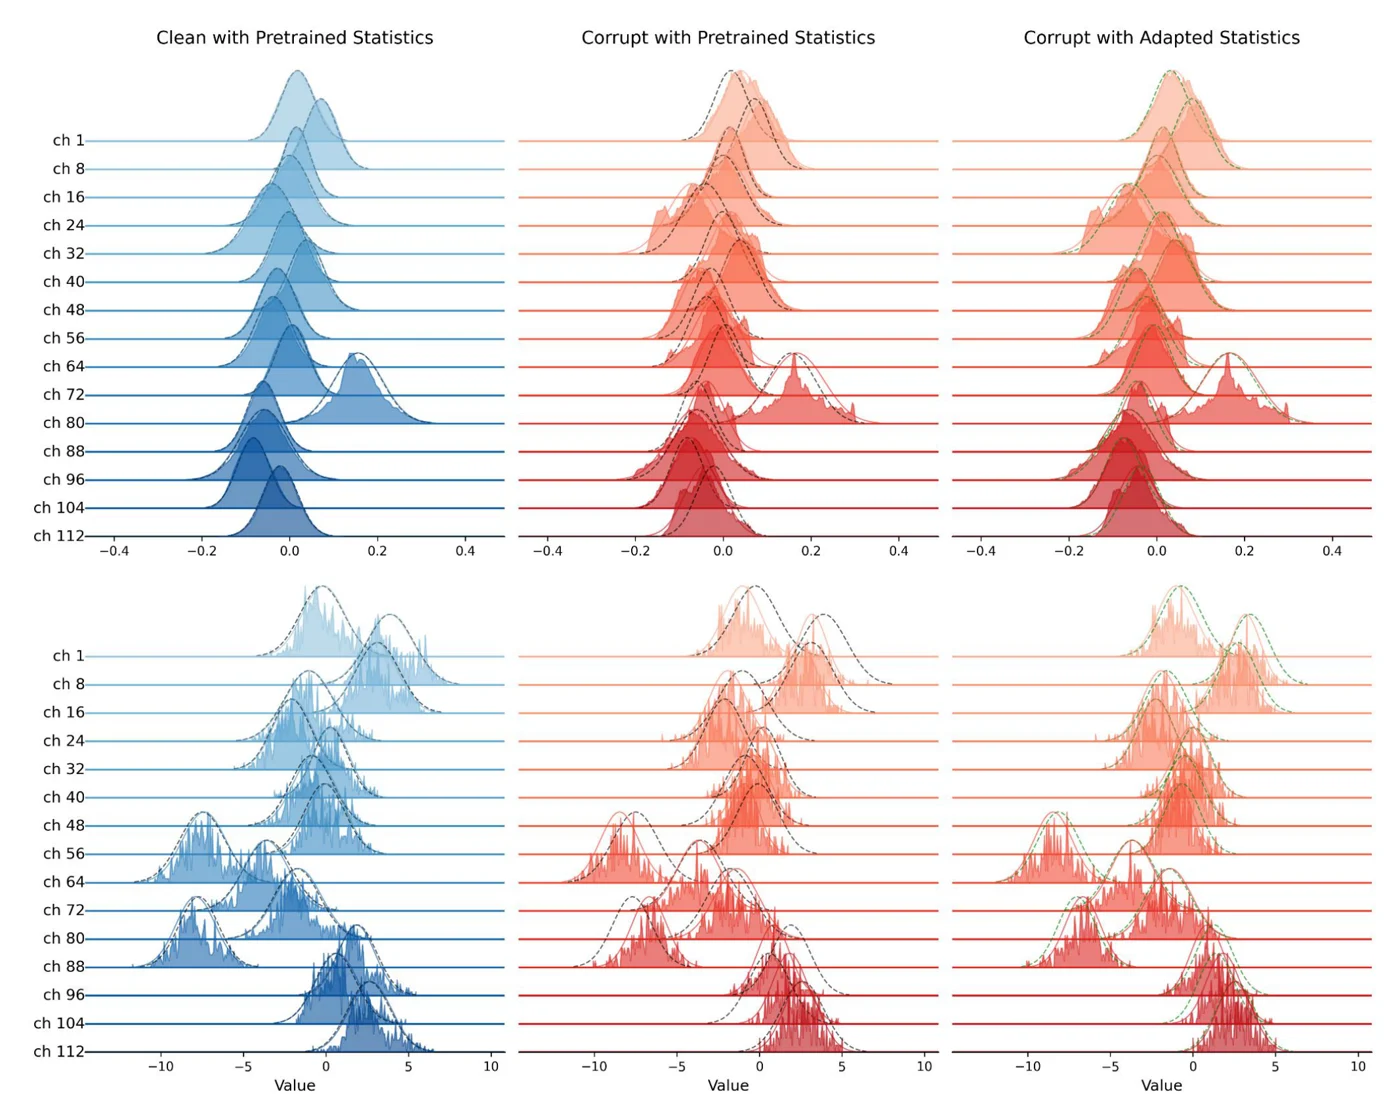 Encoder(위)와 classifier(아래)의 첫 BN layer에서 channel별 input distribution(실선)과 BatchNorm running statistics(점선). 파란색: pretrained statistics를 쓴 clean source data. 빨간색: pretrained statistics(검은 점선, 불일치)와 adapted statistics(초록 점선, 일치)를 쓴 corrupted data. 논문 Figure.
Limitations
- 논문에는 limitations 섹션이 없다. 결론에서 다른 3D task(segmentation, detection)를 향후 연구로 언급하므로, classification만 시험되었다.
- Skeletal branch를 포함한 특별한 pre-training 단계가 필요하다. BatchNorm만 사용하는 모드는 이러한 feature 덕분에 동작하므로, 임의의 pretrained model에는 적용되지 않는다.
- ShapeNet-C에서 두 online 변형 모두 MATE-Online보다 낮다(67.1과 65.9 vs 69.1).
- MATE baseline은 재현된 것이며 MATE 논문보다 약간 낮게 나온다(ModelNet-40C에서 MATE-Online 70.6 vs 71.3, MATE-Standard 63.0 vs 64.3). 원래 보고된 71.3과 비교하면 SMART-PC-Online†(70.8)는 더 이상 앞서지 않는다. 본문도 곳곳에서 표와 다른 MATE 수치(53.7과 69.6)를 인용한다.
- Batch size 1이라도 각 step마다 sample당 48개 또는 24개의 rotate된 사본을 사용하며, BatchNorm만 사용하는 모드는 stream에 걸쳐 running statistics를 갱신한다. 유용한 statistics를 만들려면 sample stream이 필요하다. Protocol은 또한 새로운 corruption 종류마다 모델을 reset하는데, 이는 distribution shift가 바뀌는 시점을 안다고 가정하는 것이다. 혼합되거나 계속 변하는 distribution shift는 시험되지 않았다.
- 속도에 대한 주장은 주로 BatchNorm만 사용하는 online 모드에 해당한다. 전체 모델을 통해 \(\mathcal{L}_{skel}\)를 backpropagate하는 모드들은, 20-step standard 모드를 포함하여, MATE와 비슷한 비용이 든다.