Abstract
Test-time prompt tuning(TPT)은 augmented view들에 대한 평균 prediction의 entropy를 최소화하여 CLIP의 text prompt를 각 test image에 맞게 조정한다. Entropy minimization은 모델을 overconfident하게 만들어 calibration을 악화시킨다. C-TPT와 O-TPT는 class text embedding(prototype)에 regularizer를 두어 이를 해결한다. C-TPT는 prototype을 centroid에서 멀어지게 퍼뜨린다. O-TPT는 모든 prototype 쌍을 orthogonality 쪽으로 민다. 저자들은 EuroSAT의 “annual crop land”와 “permanent crop land”처럼 실제로 비슷한 class에 대해서는 완전한 orthogonality가 너무 공격적이라고 주장한다. 이런 쌍을 억지로 떼어 놓으면 모델이 틀렸을 때조차 확신하게 된다.
SoC(Semantic Orthogonal Calibration)는 prototype을 분리한다는 아이디어는 유지하되, pairwise cosine similarity에 Huber penalty를 사용한다. 이 penalty는 작은 similarity에서는 quadratic, 큰 similarity에서는 linear이므로, 매우 비슷한 class 사이의 repulsion에 상한이 생긴다. 논문은 이를 최대 pairwise similarity로 표현한 confidence의 lower bound와, O-TPT가 SoC보다 그 similarity를 더 빠르게 줄인다는 one-step 분석으로 뒷받침한다.
Motivation
출발점은 TPT 자체가 아니라 calibration fix의 failure case이다. Entropy minimization은 TPT를 overconfident하게 만들고, C-TPT와 O-TPT는 class text prototype을 서로 떨어뜨려 이를 상쇄한다. O-TPT는 가장 멀리 가서 모든 pair가 orthogonal하도록 요구한다. 저자들은 이것이 어떤 class들은 실제로 semantic하게 가깝다는 사실을 무시한다고 주장한다. EuroSAT에서 “annual crop land” image는 “permanent crop land”와 쉽게 혼동된다. Zero-shot CLIP은 그런 image를 틀리지만 uncertain한 상태로 남아 softmax를 두 class에 나눠 준다. O-TPT는 두 prototype을 밀어내므로 같은 틀린 prediction이 confident해진다(Method 절의 teaser figure가 이 예시를 보여 준다).
논문은 이 예시를 EuroSAT 분석으로 뒷받침한다. 순서가 있는 모든 class pair \((i, j)\)에 대해 틀린 prediction(예측 \(i\), 정답 \(j\))만 모아 ECE를 계산하고, 이를 두 class prototype의 zero-shot cosine similarity에 대해 그린다. O-TPT에서는 similarity가 클수록 ECE가 커지며(correlation \(r=+0.69\)), sample도 가장 많은 가장 similar한 pair들의 ECE는 90 가까이 된다. SoC는 이 경향을 없앤다(\(r=-0.20\)).
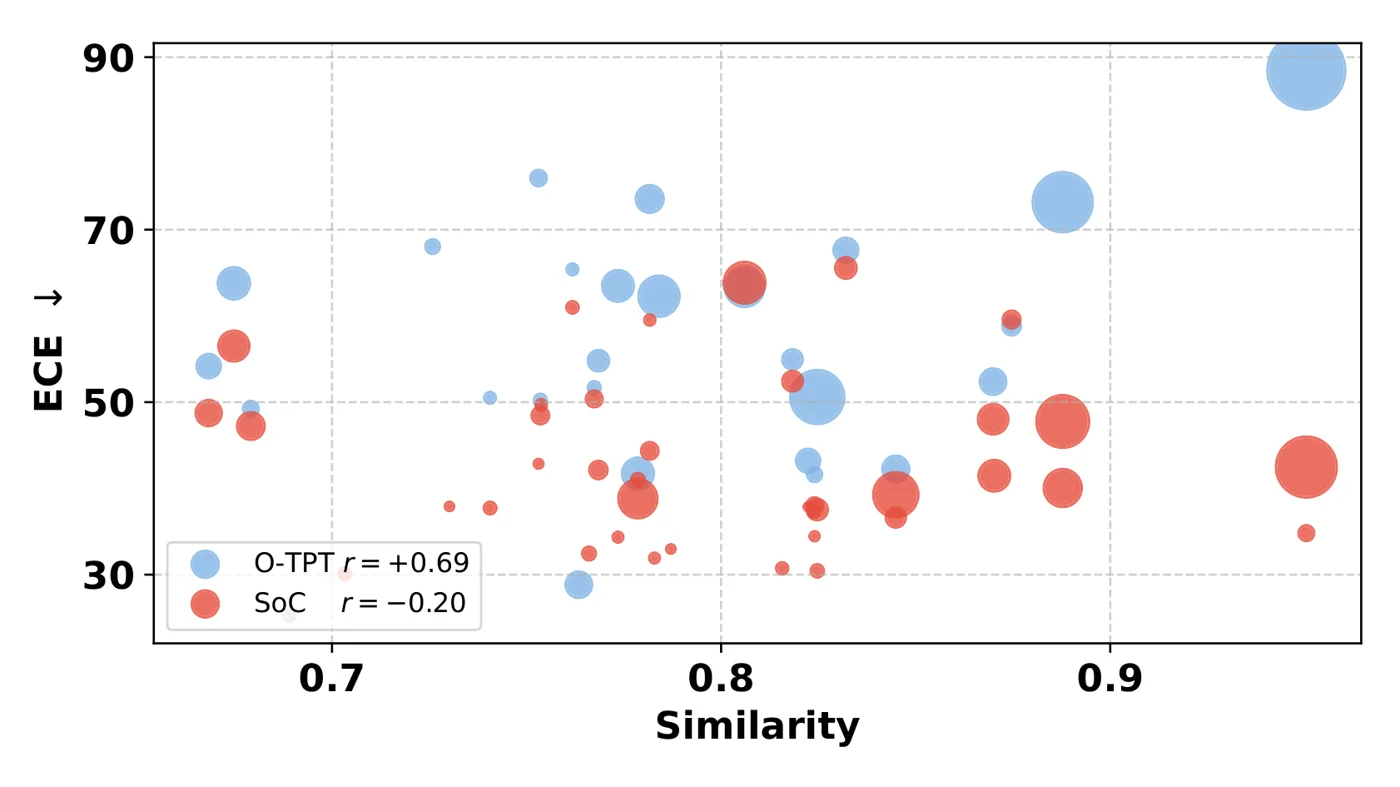 EuroSAT에서 class pair별 틀린 prediction의 ECE를 그 pair의 zero-shot cosine similarity에 대해 그린 것. 원 크기는 sample 수이다. O-TPT(파랑)는 가장 similar한 pair에서 가장 overconfident하고, SoC(빨강)는 그렇지 않다. 논문 Figure.
핵심 insight는 prototype 사이의 repulsion이 similarity에 따라 달라져야 한다는 것이다. Entropy minimization이 일으키는 collapse를 되돌릴 만큼은 강해야 하지만, 실제 semantic한 이유로 similar한 pair에 대해서는 상한이 있어야 한다. Pairwise cosine similarity에 대한 Huber penalty가 바로 이 역할을 하며, 논문의 confidence bound와 one-step 분석이 이 논지를 형식화한다.
Method
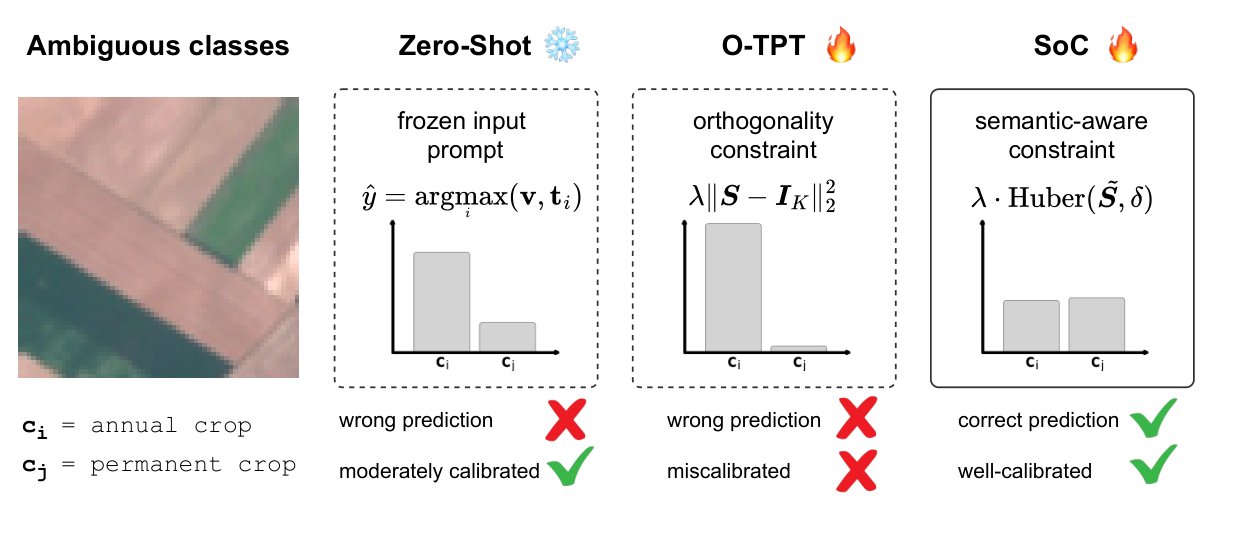 EuroSAT에서의 motivating example. Zero-shot CLIP은 틀렸지만 가까운 두 class 사이에서 불확실해한다. O-TPT의 orthogonality constraint는 모델을 틀리면서도 확신하게 만든다. SoC의 semantic-aware Huber constraint는 두 class의 confidence를 가깝게 유지한다. 그림은 논문에서 가져왔다.
논문에는 별도의 architecture diagram이 없다. SoC는 TPT loss에 항 하나를 바꾼 것이며, 위 그림은 그것이 겨냥하는 효과를 보여준다.
Setting
CLIP은 image embedding \(\mathbf{v}\)와 class prototype \(\mathbf{t}_k = f_\phi(\text{"a photo of a [CLASS]"})\)를 주며, 모두 unit norm이다. Logit은 CLIP이 학습한 scale \(\alpha\)를 사용해 \(z_k = \alpha\,\mathbf{v}^\top \mathbf{t}_k\)이다. Prototype을 \(\mathbf{E} \in \mathbb{R}^{K\times d}\)로 쌓으면 원소가 \(s_{ij} = \mathbf{t}_i^\top \mathbf{t}_j\)인 similarity matrix \(\mathbf{S} = \mathbf{E}\mathbf{E}^\top\)를 얻는다. 두 baseline은 TPT entropy loss에 regularizer를 더한다.
\[\mathcal{L}_{\text{C-TPT}} = \mathcal{L}_{\text{TPT}} - \lambda \frac{1}{K}\sum_{k=1}^{K} \|\bar{\mathbf{t}} - \mathbf{t}_k\|_2, \qquad \mathcal{L}_{\text{O-TPT}} = \mathcal{L}_{\text{TPT}} + \lambda \|\mathbf{S} - \mathbf{I}_K\|_2^2 .\]The SoC regularizer
O-TPT의 penalty는 \(s_{ij}\)에 대해 quadratic이므로, gradient가 similarity에 따라 커진다. 가장 비슷한 쌍이 가장 세게 밀린다. SoC는 margin \(\delta \in [0,1]\)을 가진 Huber function을 사용한다.
\[\mathcal{L}_{\text{Huber}}(s,\delta) = \begin{cases} \frac{s^2}{2} & \text{if } s \le \delta \\ \delta\left(s - \frac{\delta}{2}\right) & \text{otherwise} \end{cases}\] \[\mathcal{L}_{\text{SoC}} = \mathcal{L}_{\text{TPT}} + \lambda \cdot \frac{2}{K(K-1)} \sum_{i<j} \mathcal{L}_{\text{Huber}}(s_{ij}, \delta).\]\(\mathbf{t}_i\)에 대한 gradient는 \(g_\delta(s) = \min(s, \delta)\)일 때 \(\sum_{k\neq i} g_\delta(s_{ik})\,\mathbf{t}_k\)이다. 따라서 margin을 넘는 쌍들은 모두 동일하고 bounded된 힘을 받는다.
실제로는 similarity를 min-max normalize하여 \(\tilde{\mathbf{S}} = (\mathbf{S} - \mathbf{S}_{\min}) / (\mathbf{S}_{\max} - \mathbf{S}_{\min})\)로 두고, \(\delta\)는 dataset마다 \(\tilde{\mathbf{S}}\)의 20th percentile로 정한다. 가중치는 \(\lambda = 30\)(ImageNet distribution shift 실험에서는 14)이며, 두 loss 크기의 비율로 rescale된다.
Why this should help calibration
\(\mu = \max_{i\neq j} \mathbf{t}_i^\top \mathbf{t}_j\)(worst-case similarity)라 하면, Proposition 1은 임의의 unit vector \(\mathbf{v}\)에 대해 top softmax probability의 lower bound를 준다.
\[p_{\max}(\mathbf{v}) \ge \frac{1}{1 + (K-1)\exp(-\alpha(1-\mu))}.\]\(\mu\)가 낮을수록 confidence의 lower bound가 높아진다. TPT 방법들은 한 번의 gradient step을 취한다. 가장 비슷한 쌍만 남기고 first-order expansion을 사용하면, 크기 \(\eta\)의 한 step은 다음을 준다.
\[\mu'_{\text{O-TPT}} \approx (1-4\eta)\mu, \qquad \mu'_{\text{Huber}} \approx \begin{cases} (1-2\eta)\mu & \mu \le \delta \\ \mu - 2\eta\delta & \mu > \delta . \end{cases}\]O-TPT는 두 영역 모두에서 \(\mu\)를 더 많이 줄이므로 confidence의 lower bound를 더 많이 높인다(Corollary 1). 저자들은 이를 의미적으로 가까운 class 쌍에서 O-TPT가 보이는 overconfidence와 연결하며, EuroSAT에서 zero-shot similarity에 따른 pair별 ECE로 이를 보여준다.
Main Experiments
설정: 별도 언급이 없으면 CLIP ViT-L/14, prompt는 “a photo of a”로 초기화, learning rate 0.005의 AdamW 한 step, 이미지당 augmented view 64개. 지표는 top-1 accuracy(%)와 ECE(%)이다. “11개 dataset” 평균은 ImageNet과 10개의 fine-grained 및 specialized dataset(DTD, Flowers, Food101, SUN397, Aircraft, Pets, Caltech, UCF101, EuroSAT, Cars)을 포함한다. 아래 표는 논문 Table 1, 2, 3의 평균 열만 모은 것이다.
| Method | 11 datasets, ViT-L/14 Acc | ECE | 11 datasets, ViT-B/16 Acc | ECE | ImageNet-A/v2/R/Sketch, ViT-L/14 Acc | ECE |
|---|---|---|---|---|---|---|
| Zero-Shot | 71.1 | 5.1 | 63.9 | 4.2 | 70.0 | 4.4 |
| TPT | 72.0 | 14.9 | 65.2 | 11.2 | 72.9 | 14.2 |
| C-TPT | 72.1 | 10.0 | 64.6 | 5.0 | 72.0 | 12.6 |
| O-TPT | 71.4 | 7.7 | 64.0 | 4.8 | 71.3 | 9.9 |
| SoC | 72.3 | 5.4 | 64.6 | 4.3 | 71.3 | 8.4 |
ViT-L/14에서의 dataset별 ECE(논문 Table 1), SoC vs. O-TPT:
| Method | ImgNet | DTD | Flowers | Food101 | SUN397 | Aircraft | Pets | Caltech | UCF101 | EuroSAT | Cars |
|---|---|---|---|---|---|---|---|---|---|---|---|
| O-TPT | 5.5 | 13.8 | 7.0 | 2.8 | 7.6 | 16.8 | 1.4 | 2.0 | 8.5 | 17.7 | 2.2 |
| SoC | 7.2 | 10.9 | 5.3 | 2.1 | 7.2 | 12.7 | 0.5 | 1.3 | 6.5 | 3.2 | 2.2 |
SoC는 모든 설정에서 adapted 방법들 중 가장 낮은 평균 ECE를 기록하며, ViT-L/14에서는 ECE(5.4)가 zero-shot CLIP(5.1)에 가까우면서 accuracy는 약간 더 높다. 가장 큰 단일 변화는 EuroSAT로, ECE가 17.7에서 3.2로 떨어지고 accuracy는 53.6에서 58.3으로 오른다. ImageNet distribution shift에서는 accuracy가 O-TPT와 같고 TPT와 C-TPT보다 낮다. Gradient step을 한 번이 아니라 두 번 취하면 SoC의 ECE는 약 23% 나빠지는 반면 O-TPT는 39% 나빠지며, 이는 one-step 분석과 일치한다.
세 dataset의 reliability diagram을 보면 ECE 개선이 어디서 오는지 알 수 있다. O-TPT의 막대는 high-confidence bin에서 diagonal 아래에 있으며, 이는 overconfidence이다. SoC에서는 막대가 diagonal에 더 가까워지고, EuroSAT에서 가장 뚜렷하다(ECE 17.7에서 3.2). Aircraft는 여전히 overconfident하다(16.8에서 12.7).
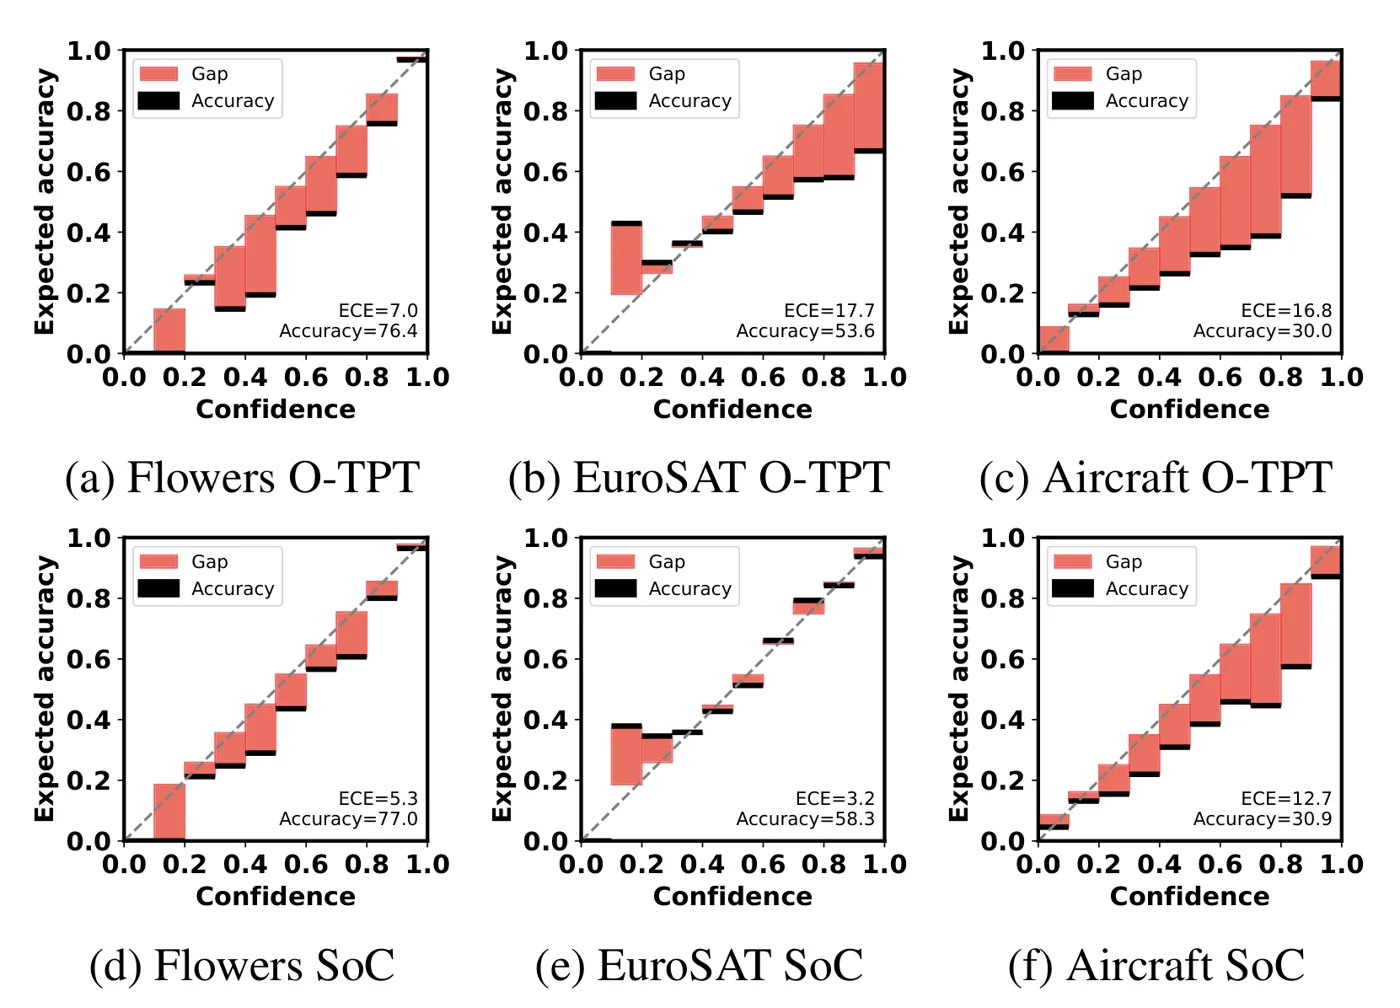 Flowers102, EuroSAT, FGVC Aircraft에서 O-TPT(위)와 SoC(아래)의 reliability diagram. 각 panel에 ECE와 accuracy가 표시되어 있다. SoC는 세 dataset 모두에서 diagonal에 더 가깝고, 가장 큰 변화는 EuroSAT에서 나타난다. 논문 Figure.
Two-step 실험은 one-step 분석을 직접 검증한다. Gradient step을 하나 더 취하면 세 regularizer 모두 ECE가 오르지만, C-TPT는 +44.2%, O-TPT는 +39.2%, SoC는 +22.8%이고 accuracy 변화는 1포인트 미만이다.
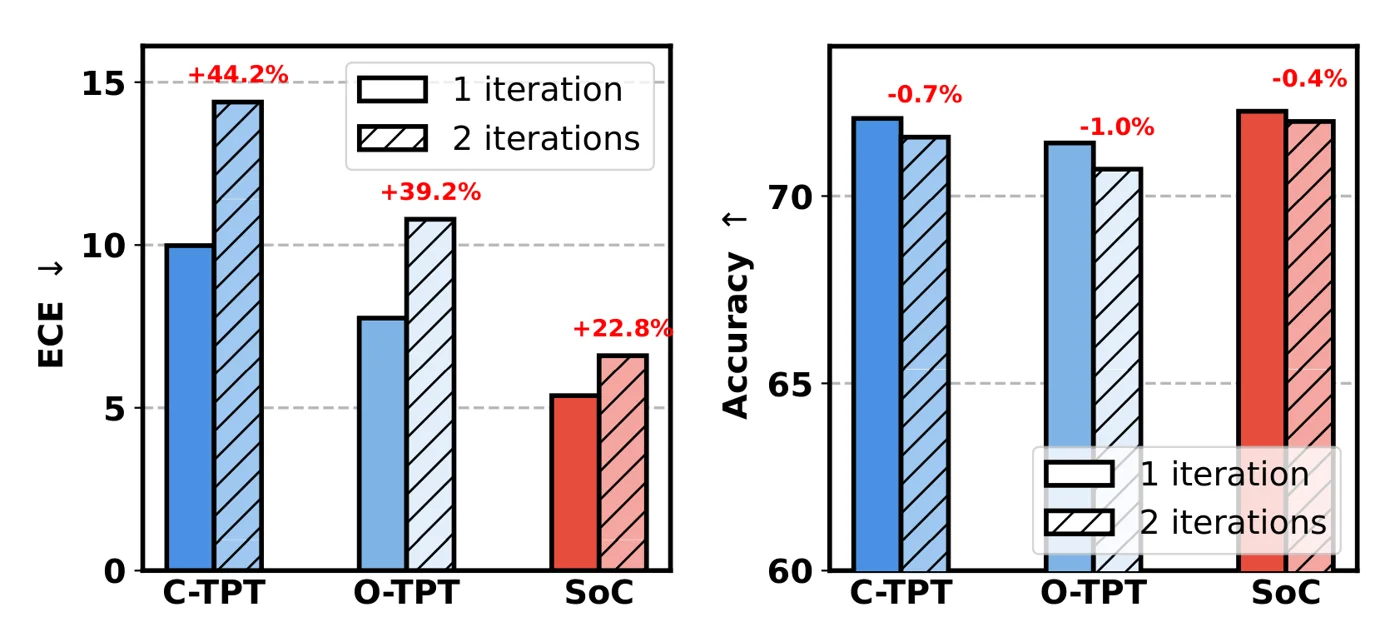 C-TPT, O-TPT, SoC의 11개 dataset 평균 ECE(왼쪽)와 accuracy(오른쪽), gradient step 1회(실선)와 2회(빗금). ECE의 상대 증가가 SoC에서 가장 작다. 논문 Figure.
Calibration은 initial prompt에도 의존한다. 18개의 CLIP prompt template에 대해 SoC는 DTD에서는 모든 template에서, Aircraft에서는 대부분의 template에서 O-TPT보다 ECE가 낮으므로, 개선이 “a photo of a”라는 선택에 의존하지 않는다.
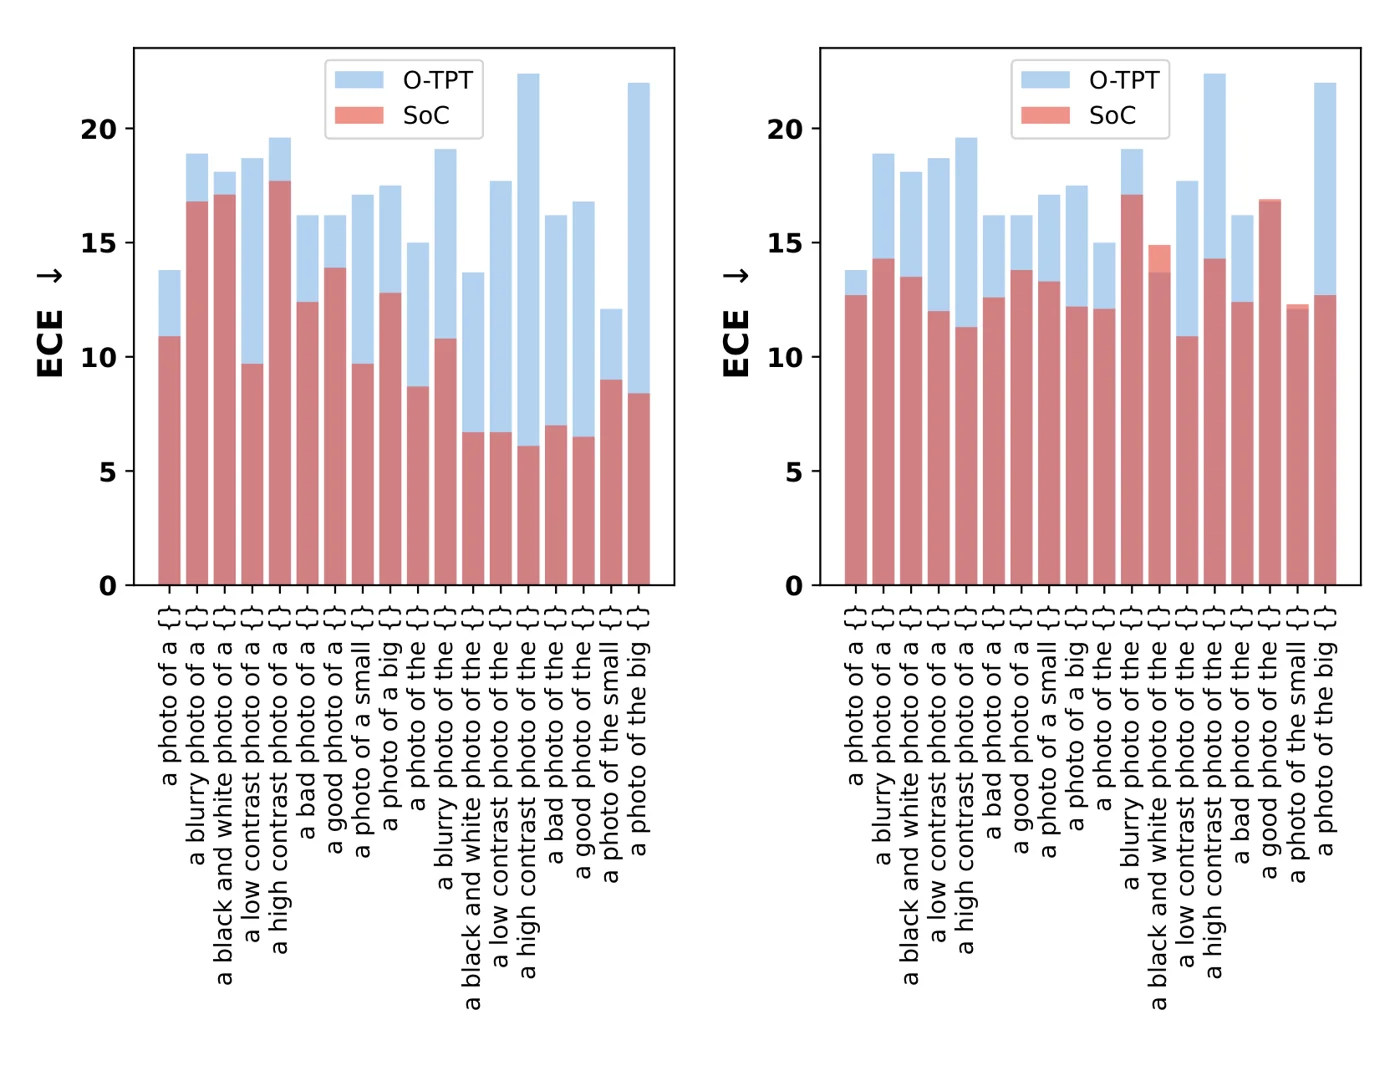 18개의 서로 다른 CLIP initial prompt template에 대해 DTD(왼쪽)와 Aircraft(오른쪽)에서 O-TPT(파랑)와 SoC(빨강)의 ECE. SoC는 거의 모든 prompt에서 더 낮고, O-TPT의 최악의 경우(20 이상)가 사라진다. 논문 Figure.
Limitations
- 향상은 accuracy가 아님. ImageNet 변형에서 SoC는 O-TPT와 같고(71.3) TPT(72.9)와 C-TPT(72.0)보다 낮다. ViT-B/16에서는 TPT보다 낮다(64.6 vs. 65.2).
- 모든 곳에서 더 낫지는 않음. ImageNet에서 SoC의 ECE는 O-TPT보다 나쁘며(7.2 vs. 5.5), Cars에서는 같다.
- 한 dataset이 평균의 상당 부분을 차지. 11개 dataset 중 EuroSAT 하나가 14.5포인트의 ECE 감소를 차지한다. 나머지 10개 dataset에서 O-TPT와의 ECE 차이는 최대 4.1포인트이다.
- 단순화된 이론. 분석은 가장 비슷한 쌍만 남기고, 한 gradient step의 first-order expansion을 사용하며, confidence의 lower bound를 준다. 변화의 방향을 설명할 뿐, calibration error의 크기를 설명하지는 않는다.
- 추가적인 선택 사항. Margin은 min-max normalize된 similarity의 dataset별 percentile이고, \(\lambda\)는 benchmark마다 다르며(30 vs. 14), loss는 loss 크기의 비율로 rescale된다. Appendix는 네 개 dataset에서 \(\lambda\)에 대한 ablation을 제시하지만, \(\delta\)에 쓰인 percentile에 대한 ablation은 보고되지 않는다.
- 여전히 TPT의 비용에 묶임. SoC는 64개의 augmented view를 사용하는 TPT의 이미지별 optimization을 그대로 유지한다. Regularizer의 비용은 class 수에 대해 \(O(n^2)\)로 O-TPT의 \(O(n^3)\)보다 작지만, 주된 inference 비용은 변하지 않는다.