Abstract
CLIP은 이미지를 “a photo of a dog” 같은 텍스트와 비교하여 zero-shot으로 분류할 수 있다. Prompt 선택이 중요하며, hand-crafted prompt는 domain별 heuristic이 필요하다. CoOp과 CoCoOp 같은 prompt tuning 방법은 대신 prompt를 학습하지만, downstream task의 labeled training data가 필요하고, 학습된 prompt는 그 task의 distribution에 맞춰지는 경향이 있다. 논문은 distribution shift가 더 큰 dataset에서 이 방법들이 hand-crafted prompt ensemble보다 나은 점이 없음을 발견한다.
Test-time prompt tuning(TPT)은 지금 분류하려는 단일 test sample로부터 prompt를 학습한다. Training data도 label도 사용하지 않는다. Image classification에서 TPT는 test image의 augmented view를 많이 만들고, 그중 confidence가 가장 높은 것들을 남긴 뒤, 그 view들에 대한 평균 prediction의 entropy가 낮아지도록 prompt를 갱신한다. 같은 아이디어를 context-dependent visual reasoning task(Bongard-HOI)에도 적용한다.
Motivation
Prompt tuning은 prompt embedding을 model weight처럼 다루어 downstream task의 labeled data에 맞춘다. 저자들은 그 결과 학습된 prompt가 training distribution에 묶이게 된다고 주장한다. Table 1에서 이미 그 징후가 보인다. ImageNet으로 학습한 CoOp과 CoCoOp은 training data와 가까운 ImageNet과 ImageNet-V2에서 가장 많이 오르지만, ImageNet-A, -R, -Sketch에서는 hand-crafted prompt 80개의 ensemble보다 나을 것이 없다.
더 분명한 근거는 cross-dataset transfer 실험이다. 한 fine-grained dataset에서 prompt를 tuning(16-shot)한 뒤 다른 dataset에서 평가하고, hand-crafted prompt를 쓴 zero-shot CLIP 대비 상대 accuracy 변화 \((acc - acc_{\text{base}})/acc_{\text{base}}\)를 보고한다. 예를 들어 CLIP-RN50은 “a photo of a”로 Flower102에서 61.75%를 얻지만, DTD에서 학습한 CoOp은 Flower102에서 33.41%에 그쳐 상대 변화가 \(-0.46\)이다.
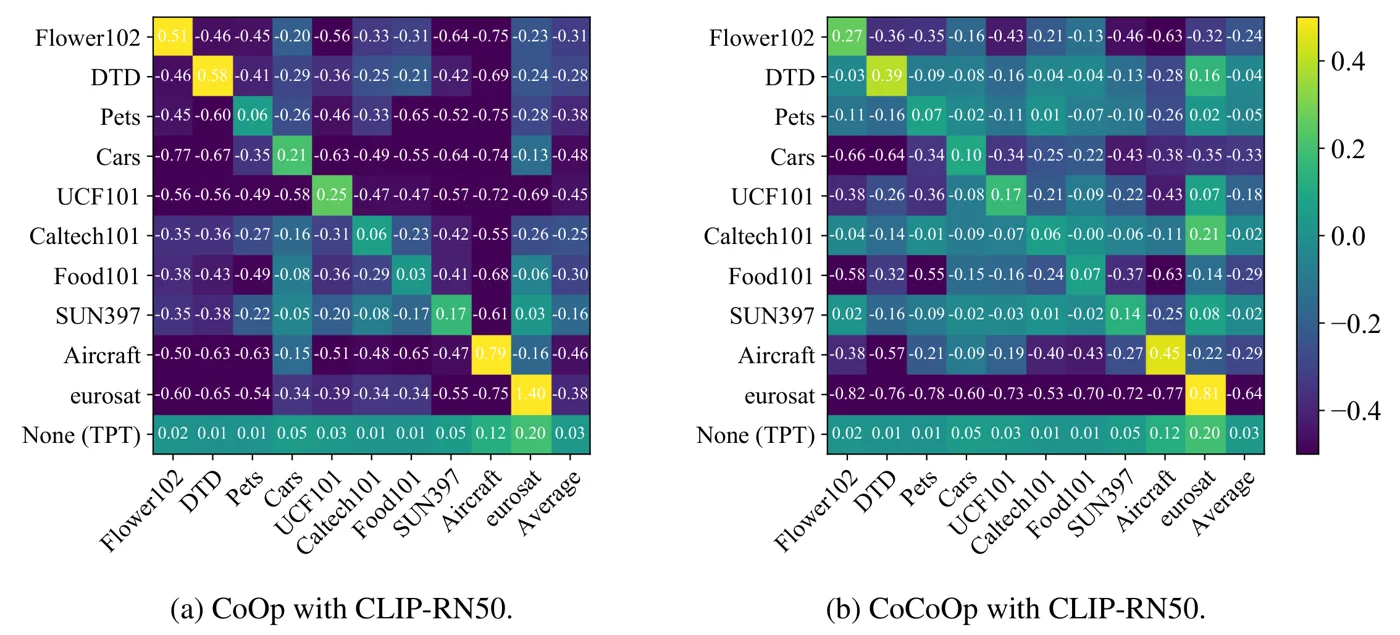 행 dataset에서 tuning한 prompt를 열 dataset에서 test했을 때 zero-shot CLIP-RN50 대비 상대 accuracy 변화. (a) CoOp, (b) CoCoOp. 대각선만 양수이고, source dataset이 없는 맨 아래 행(TPT)은 모든 열에서 양수다. 논문 Figure.
대각선을 벗어난 칸은 거의 모두 음수다. 즉 한 dataset에서 tuning한 prompt는 대개 다른 dataset에서 성능을 떨어뜨리며, Average 열은 모든 source dataset에서 음수다. CoCoOp의 image-conditioned prompt는 대부분의 칸을 덜 음수로 만들지만 하락 자체를 없애지는 못한다. 여기서 핵심 아이디어가 나온다. Training distribution에서 prompt 하나를 배우는 대신, 각 test sample에 대해 그 sample만으로 prompt를 배운다. Label이 없으므로 신호는 unsupervised여야 하며, 논문은 augmented view 사이의 prediction consistency를 사용한다. 맨 아래 행의 TPT는 10개 dataset 모두에서 향상된다.
Method
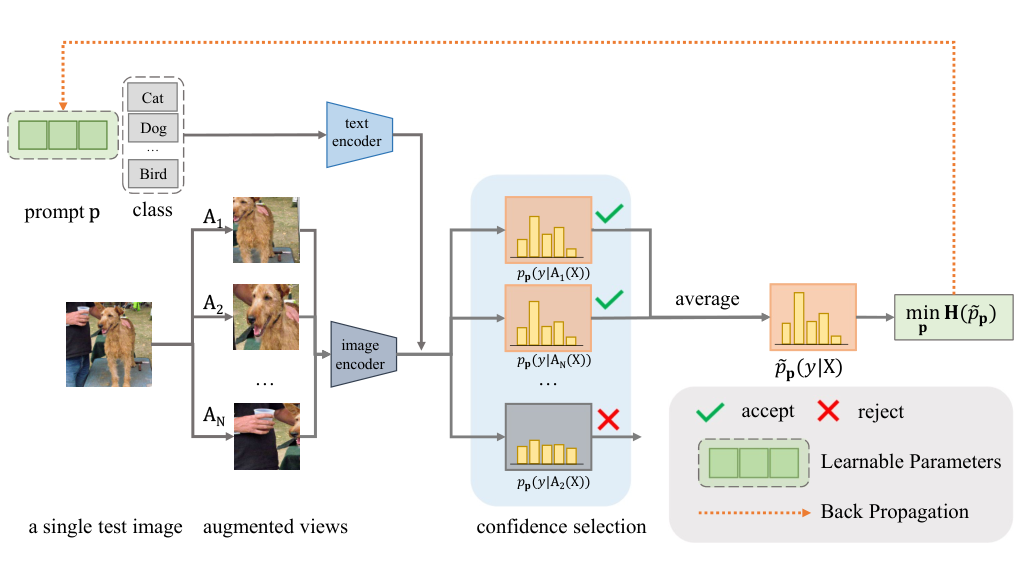 Image classification을 위한 TPT. 단일 test image를 N개의 view로 augment하고, confidence가 낮은 view를 제거한 뒤, 평균 prediction의 entropy를 최소화하도록 prompt를 갱신한다. 그림은 논문에서 가져왔다.
CLIP with a prompt
CLIP은 image encoder와 text encoder를 가진다. \(K\)-class 문제에서 prompt \(\mathbf{p}\)를 각 class name \(y_i\) 앞에 붙이면, text encoder는 class마다 하나의 feature \(\mathbf{t}_i\)를 준다. Image feature \(\mathbf{v}\)를 각 text feature와 cosine similarity로 비교하고, scale된 similarity에 대한 softmax로 \(p(y_i \mid X)\)를 얻는다. Zero-shot CLIP에서 \(\mathbf{p}\)는 고정된 텍스트 “a photo of a”이다. Prompt tuning에서 \(\mathbf{p} \in \mathbb{R}^{L\times D}\)는 text input space에 있는 \(L\)개의 학습 가능한 token embedding 집합이다. Prompt만 학습되며, 두 encoder는 모두 고정된다.
저자들이 adapt할 parameter로 prompt를 택한 이유는, pre-trained feature를 건드리지 않고 input context를 바꿀 수 있기 때문이다. MEMO 방식의 test-time optimization을 사용한 ablation(Figure 4a)에서 prompt tuning은 전체 모델, text encoder, visual encoder를 tuning하는 것보다 낫다. Visual encoder를 tuning하는 것이 가장 나쁘다.
Marginal entropy over augmented views
Test time에는 label이 없으므로 TPT에는 unsupervised objective가 필요하다. \(N\)개의 augmented view \(\mathcal{A}_i(X_{\text{test}})\)를 생성하고 predicted class distribution을 평균한다.
\[\tilde{p}_{\mathbf{p}}(y \mid X_{\text{test}}) = \frac{1}{N}\sum_{i=1}^{N} p_{\mathbf{p}}(y \mid \mathcal{A}_i(X_{\text{test}})).\]Prompt는 이 평균의 entropy를 최소화하도록 갱신된다.
\[\mathbf{p}^{*} = \arg\min_{\mathbf{p}} -\sum_{i=1}^{K} \tilde{p}_{\mathbf{p}}(y_i \mid X_{\text{test}}) \log \tilde{p}_{\mathbf{p}}(y_i \mid X_{\text{test}}).\]각 view의 entropy가 아니라 평균의 entropy를 최소화하면, 모델이 view들에 걸쳐 같은 답을 확신 있게 내도록 유도된다. 이는 일종의 consistency regularization이다.
Confidence selection
일부 augmentation은 오해를 부른다. Random crop은 물체를 잘라낼 수 있다. TPT는 sample별 threshold \(\tau\)로 이런 view를 버린다. \(\tau\)는 \(N\)개의 view를 entropy가 낮은 순으로 정렬했을 때 \(\rho\)-percentile에 해당하는 entropy이다. Threshold 아래의 view만 평균에 들어간다.
\[\tilde{p}_{\mathbf{p}}(y \mid X_{\text{test}}) = \frac{1}{\rho N}\sum_{i=1}^{N} \mathbf{1}[\mathbf{H}(p_i) \le \tau]\, p_{\mathbf{p}}(y \mid \mathcal{A}_i(X_{\text{test}})),\]여기서 \(\mathbf{H}(p_i)\)는 view \(i\)에 대한 prediction의 entropy이다. 논문에서 이 단계는 CLIP-RN50을 사용한 ImageNet benchmark에서 단순 TPT 대비 평균 accuracy를 1.38포인트 높이며, ImageNet-A에서의 향상은 3.02포인트이다.
Default setting
Prompt는 “a photo of a”로 초기화되며 그 4개의 token embedding이 tuning된다. Test image와 63개의 augmented view가 64개짜리 batch를 이룬다. 가장 confidence가 높은 상위 10%의 view를 남긴다(\(\rho = 0.1\)). Prompt는 learning rate 0.005의 AdamW 한 step으로 갱신되며, 갱신된 prompt로 예측한다. Augmentation은 ImageNet 변형에는 random resized crop을, fine-grained dataset에는 AugMix를 사용한다.
Bongard-HOI에서는 support image들이 test sample의 일부로서 positive·negative label과 함께 주어진다. 이 경우 TPT는 support image에 대한 cross-entropy로 prompt와 두 개의 label token을 처음부터 64 step 동안 tuning한 뒤, query image를 분류한다.
Main Experiments
지표는 top-1 accuracy(%)이다. CoOp과 CoCoOp은 class당 16-shot으로 ImageNet에서 학습된다. CLIP(hand-crafted prompt), Ensemble(hand-crafted prompt 80개), TPT는 training data를 사용하지 않는다.
Natural distribution shift, top-1 accuracy(%), Table 1에서 발췌
| Backbone | Method | ImageNet | -A | -V2 | -R | -Sketch | Average | OOD Average |
|---|---|---|---|---|---|---|---|---|
| RN50 | CLIP | 58.16 | 21.83 | 51.41 | 56.15 | 33.37 | 44.18 | 40.69 |
| RN50 | Ensemble | 59.81 | 23.24 | 52.91 | 60.72 | 35.48 | 46.43 | 43.09 |
| RN50 | CoOp | 63.33 | 23.06 | 55.40 | 56.60 | 34.67 | 46.61 | 42.43 |
| RN50 | CoCoOp | 62.81 | 23.32 | 55.72 | 57.74 | 34.48 | 46.81 | 42.82 |
| RN50 | TPT | 60.74 | 26.67 | 54.70 | 59.11 | 35.09 | 47.26 | 43.89 |
| RN50 | TPT + CoOp | 64.73 | 30.32 | 57.83 | 58.99 | 35.86 | 49.55 | 45.75 |
| ViT-B/16 | CLIP | 66.73 | 47.87 | 60.86 | 73.98 | 46.09 | 59.11 | 57.2 |
| ViT-B/16 | Ensemble | 68.34 | 49.89 | 61.88 | 77.65 | 48.24 | 61.20 | 59.42 |
| ViT-B/16 | CoOp | 71.51 | 49.71 | 64.20 | 75.21 | 47.99 | 61.72 | 59.28 |
| ViT-B/16 | CoCoOp | 71.02 | 50.63 | 64.07 | 76.18 | 48.75 | 62.13 | 59.91 |
| ViT-B/16 | TPT | 68.98 | 54.77 | 63.45 | 77.06 | 47.94 | 62.44 | 60.81 |
| ViT-B/16 | TPT + CoOp | 73.61 | 57.95 | 66.83 | 77.27 | 49.29 | 64.99 | 62.83 |
TPT + CoCoOp 행은 여기서 생략했다(ViT-B/16: 평균 64.30, OOD 평균 62.61).
ImageNet에서 10개 fine-grained dataset으로의 cross-dataset generalization, 평균 top-1 accuracy(%), Table 2에서 발췌
| Method | CLIP-RN50 | CLIP-ViT-B/16 |
|---|---|---|
| CLIP | 55.82 | 63.58 |
| Ensemble | 56.63 | 64.59 |
| CoOp | 56.18 | 63.88 |
| CoCoOp | 57.23 | 64.63 |
| TPT | 57.66 | 65.10 |
Average 열만 표시했다. 10개 dataset은 Flower102, DTD, Pets, Cars, UCF101, Caltech101, Food101, SUN397, Aircraft, EuroSAT이다.
Training data 없이도 TPT는 두 backbone 모두에서 단일 방법들 중 가장 높은 OOD 평균을 기록한다. 가장 큰 향상은 ImageNet-A에서 나타난다(ViT-B/16에서 CLIP 대비 +6.90포인트). CoOp과 CoCoOp은 in-distribution ImageNet과 ImageNet-V2에서는 여전히 앞서며, TPT는 그 위에 더해 쓸 수 있다. Bongard-HOI에서 CLIP-RN50을 사용한 TPT는 Bongard-HOI training split을 사용하지 않고도 평균 accuracy 66.59%를 달성하며, HOITrans는 62.46%이다.
아래 ablation은 CLIP-RN50을 사용하며, Table 1의 다섯 ImageNet benchmark에 대한 평균 top-1 accuracy를 보고한다.
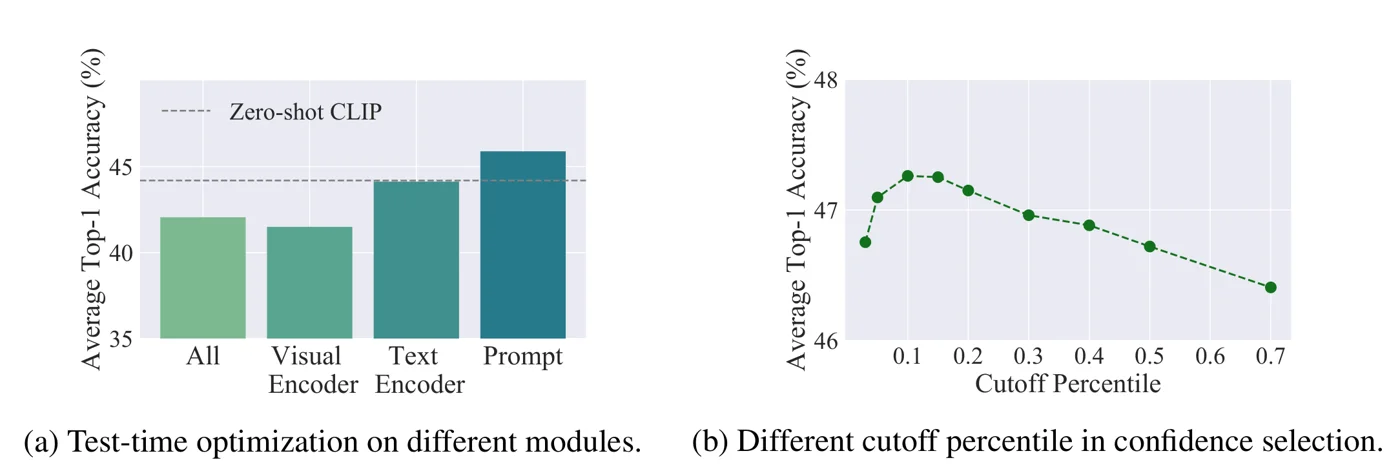 (a) CLIP의 서로 다른 부분에 대한 MEMO 방식 test-time optimization. Prompt tuning만 zero-shot CLIP(점선)을 분명히 넘고, text encoder는 비슷한 수준이며, visual encoder가 가장 나쁘다. (b) Confidence selection의 cutoff percentile \(\rho\). Accuracy는 \(\rho = 0.1\)에서 최고이고, confidence가 낮은 view를 더 많이 남길수록 떨어진다. 논문 Figure.
(a)는 adapt할 parameter로 prompt만 고른 선택을 뒷받침한다. 단일 이미지로 전체 모델이나 visual encoder를 tuning하면 zero-shot baseline보다 낮아진다. (b)는 view를 너무 적게 남겨도(\(\rho\)가 0에 가까움) 성능이 떨어짐을 보여 준다. 따라서 cutoff는 noisy crop을 걸러내는 것과 안정적인 평균을 위해 충분한 view를 남기는 것 사이의 trade-off이다.
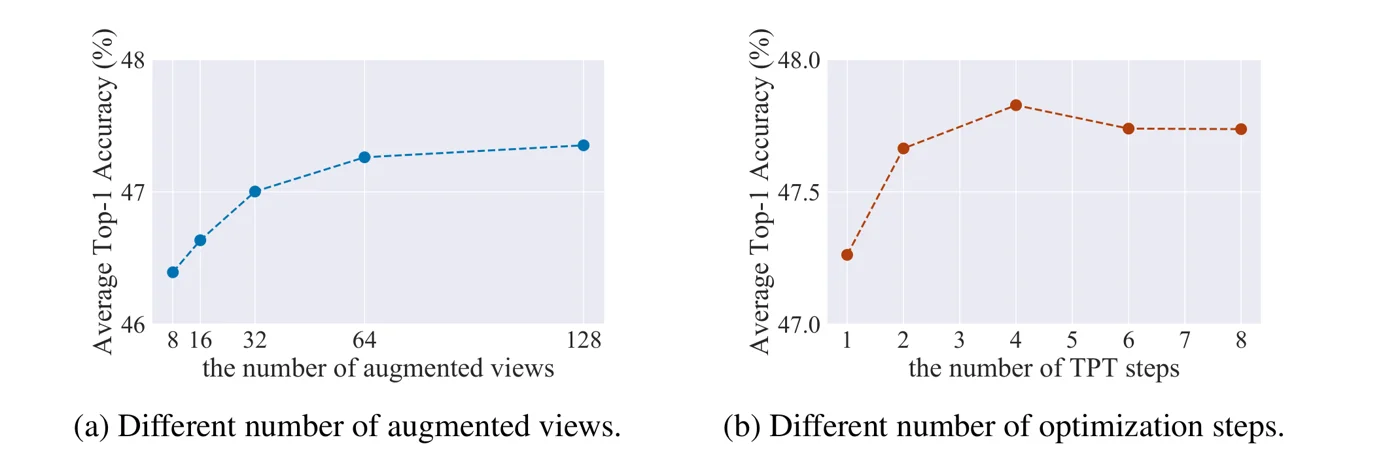 (a) Augmented view 수가 늘수록 accuracy가 오르다가 N = 64 근처에서 plateau에 이른다. (b) 1 step에서 2 step으로 늘리면 약 0.4포인트 오르고, 그 이상은 거의 오르지 않는다. 논문 Figure.
이 곡선들이 default setting(64개 view, 1 step)의 근거다. View와 step을 늘리면 inference 시간이 대략 선형으로 늘지만, 그 지점을 넘어서는 이득이 작다.
Limitations
- Test image마다 backward pass 필요(저자들이 명시). 모든 prediction에 text encoder를 통해 backpropagate하는 optimization step이 한 번 필요하다. Appendix에 따르면 inference 시간은 hand-crafted prompt의 0.10 s/iter에 비해 0.25 s/iter이다.
- Augmentation으로 인한 memory(저자들이 명시). 각 이미지가 64개 view의 batch가 되므로 inference memory가 늘어난다.
- Step을 늘려도 이득이 적음. 1 step에서 2 step으로 늘리면 accuracy가 약 0.4% 오르고, 그 이상은 거의 오르지 않는 반면 비용은 선형으로 증가한다. View 수를 줄이면 accuracy도 떨어지지만, RN50에서는 8개 view로도 2% 이상의 향상이 있다.
- Calibration 분석 없음. Objective는 모델을 확신 있는 prediction 쪽으로 몰아가지만, 논문은 accuracy만 보고한다. 후속 연구(C-TPT)는 TPT가 expected calibration error를 크게 높인다는 것을 보인다.
- 수작업으로 고른 설정. \(\rho\), step 수, learning rate, augmentation 종류는 validation split에서 선택된다(OOD set에는 ImageNet validation set, fine-grained set에는 각 dataset의 validation split). 두 benchmark 그룹에 서로 다른 augmentation이 사용된다.
- 항상 더 낫지는 않음. 일부 fine-grained dataset에서는 CoCoOp이나 prompt ensemble이 앞선다(예: ViT-B/16의 Flower102, Pets, EuroSAT).