- MIT 6.006 Introduction to Algorithms (Spring 2020) 1강 정리
- 강의: Erik Demaine, Jason Ku, Justin Solomon
- MIT OpenCourseWare, CC BY-NC-SA
- ▶ 강의 영상
- Recitation 1 notes (PDF)
이 과목의 목표는 계산 문제를 푸는 법, 그리고 그 풀이가 정확하고(correct) 효율적(efficient) 이라는 것을 다른 사람에게 설명하는 법을 배우는 것이다.
문제와 알고리즘
문제
문제(problem) 는 입력에서 올바른 출력으로 가는 이항 관계(binary relation)다. 한 입력에 올바른 출력이 여러 개일 수 있다. 모든 입력에 대해 올바른 출력을 일일이 나열할 수는 없으므로, 보통은 올바른 출력이 만족해야 하는 검증 가능한 술어(predicate), 즉 성질을 제시한다.
6.006은 크기가 임의로 큰 일반적인 입력 공간 위의 문제를 다룬다.
- 일반적이지 않은 예: “이 강의실에 생일이 같은 학생 쌍이 있는가?” (작은 고정 입력)
- 일반적인 예: “임의의 학생 \(n\)명이 주어질 때 생일이 같은 쌍이 있는가?”
생일이 365가지뿐이라면 \(n > 365\)일 때 비둘기집 원리로 답은 항상 “있다”가 된다. 그래서 생일의 해상도(연도, 시각 등 포함)가 \(n\)보다 크다고 가정한다.
알고리즘
알고리즘(algorithm) 은 각 입력을 하나의 출력으로 대응시키는 (결정적) 절차다. 알고리즘이 모든 입력에 대해 올바른 출력을 내면 그 알고리즘은 문제를 푼다고 한다. 문제는 관계이고 알고리즘은 함수다.
생일 짝 찾기 알고리즘은 다음과 같다.
- 이름과 생일을 기록하는 기록부(record)를 빈 상태로 둔다.
- 학생을 한 명씩 면담한다.
- 그 생일이 기록부에 이미 있으면 찾은 쌍을 반환한다.
- 없으면 이름과 생일을 기록부에 추가한다.
- 마지막 학생까지 찾지 못하면 None을 반환한다.
정확성
프로그램의 크기는 고정되어 있지만 입력은 임의로 클 수 있다. 작은 입력이라면 경우 분석으로 증명할 수 있지만, 임의 크기의 입력을 다루려면 알고리즘이 반복문이나 재귀를 써야 하고, 그 정확성은 귀납법(induction) 으로 증명해야 한다. 컴퓨터 과학에서 재귀가 핵심 개념인 이유가 여기에 있다.
생일 짝 찾기 알고리즘의 정확성 증명은 다음과 같다.
- 기록부에 들어간 학생 수 \(k\)에 대한 귀납법을 쓴다.
- 가설: 처음 \(k\)명 안에 짝이 있으면, 알고리즘은 \(k+1\)번째 학생을 면담하기 전에 짝을 반환한다.
- 기저: \(k = 0\)이면 처음 \(k\)명에는 짝이 없으므로 가설이 자명하게 성립한다.
- 귀납 단계: \(k = k'\)일 때 가설이 성립한다고 하고 \(k = k'+1\)을 본다. 처음 \(k'\)명 안에 짝이 있으면 귀납 가설에 의해 이미 반환했다. 그렇지 않다면, 처음 \(k'+1\)명에 짝이 있을 경우 그 짝은 반드시 \(k'+1\)번째 학생을 포함한다. 알고리즘은 바로 이 학생의 생일이 앞의 \(k'\)명에 있는지를 직접 확인하므로 짝을 찾는다.
효율
연산 횟수 세기
알고리즘이 얼마나 빨리 올바른 출력을 내는가? 실제 시간을 잴 수도 있지만, 성능은 기계와 무관하게 비교하고 싶다. 그래서 알고리즘이 반환할 때까지 수행하는 고정 시간 연산의 개수를 센다. 이 수는 입력 크기에 따라 달라지며, 입력 크기는 흔히 \(n\)으로 쓰지만 항상 그렇지는 않다.
알고리즘이 입력 크기에 대한 다항 시간(polynomial time) 에 끝나면 효율적이라고 한다. 효율적인 알고리즘이 존재하지 않는 문제도 있다(19강 Complexity에서 다룬다).
점근 표기법
점근 표기법(asymptotic notation) 은 상수 배와 낮은 차수 항을 무시한다. 상한은 \(O\), 하한은 \(\Omega\), 꼭 맞는 한계(tight bound)는 \(\Theta\)로 쓴다. “\(f(n) = O(g(n))\)“처럼 등호를 쓰거나 “is”, “order”라고 읽지만, 정확한 의미는 집합 포함 \(f(n) \in O(g(n))\)이다. Recitation의 정의는 다음과 같다.
- \(g(n) \in O(f(n))\): 어떤 양수 \(c\)와 \(n_0\)이 있어 모든 \(n \ge n_0\)에서 \(g(n) \le c \cdot f(n)\)이다.
- \(g(n) \in \Omega(f(n))\): 어떤 양수 \(c\)와 \(n_0\)이 있어 모든 \(n \ge n_0\)에서 \(c \cdot f(n) \le g(n)\)이다.
- \(g(n) \in \Theta(f(n))\): \(g(n) \in O(f(n)) \cap \Omega(f(n))\)이다.
\(n = 1000\)이고 1 GHz 단일 코어에서 사이클마다 연산 하나를 한다고 하면 다음과 같다. 참고로 우주의 입자 수는 \(10^{100}\)보다 적다고 추정된다.
| 이름 | 상수 | 로그 | 선형 | 로그 선형 | 이차 | 다항 | 지수 |
|---|---|---|---|---|---|---|---|
| 점근 | \(\Theta(1)\) | \(\Theta(\log n)\) | \(\Theta(n)\) | \(\Theta(n \log n)\) | \(\Theta(n^2)\) | \(\Theta(n^c)\) | \(2^{\Theta(n^c)}\) |
| \(n = 1000\)일 때 값 | 1 | \(\approx 10\) | 1000 | \(\approx 10{,}000\) | 1,000,000 | \(1000^c\) | \(2^{1000} \approx 10^{301}\) |
| 시간 | 1 ns | 10 ns | 1 µs | 10 µs | 1 ms | \(10^{3c-9}\) s | \(10^{281}\) 천년 |
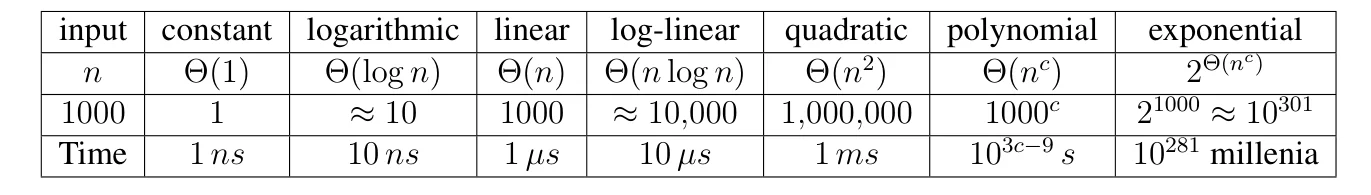 강의 노트의 점근 증가율 표. 열은 상수에서 지수까지 증가 속도 순으로 놓여 있고, 아래 두 행은 \(n = 1000\)에서의 연산 수와 1 GHz 기계에서의 소요 시간이다. 출처: MIT 6.006 Lecture 1 notes (CC BY-NC-SA 4.0).
표는 위에서 아래로 읽는다. 첫 행은 증가율의 이름, 둘째 행은 그 점근 표기, 셋째 행은 \(n = 1000\)을 대입한 연산 수, 넷째 행은 연산 하나에 1 ns가 걸린다고 했을 때의 실제 시간이다. 왼쪽 다섯 열(상수부터 이차까지)은 모두 1 ms 이하에 끝난다. 반면 지수 열은 \(2^{1000} \approx 10^{301}\)번의 연산이 필요해 \(10^{281}\) 천년이 걸리며, 이는 우주의 입자 수보다도 큰 수다.
같은 다항 시간 안에서도 차이는 크다. 로그 선형 \(\Theta(n \log n)\)은 선형보다 약 10배 느릴 뿐이지만, 이차 \(\Theta(n^2)\)은 선형보다 1000배 느리다. \(n\)이 \(10^6\)으로 커지면 이 차이는 각각 약 20배와 \(10^6\)배로 벌어진다. 이 때문에 이후 강의는 이차 알고리즘을 로그 선형이나 선형으로 줄이는 데 많은 노력을 들인다.
로그, 선형, 지수 사이의 차이는 엄청나다. 이 과목은 주로 작은 \(c\)에 대한 다항 시간 알고리즘을 다룬다.
계산 모델: Word-RAM
계산 모델(model of computation) 은 기계에서 어떤 연산을 \(O(1)\) 시간에 할 수 있는지를 정한 명세다. 이 과목의 모델은 Word-RAM이다.
- 기계 워드(machine word): \(w\)비트 블록이다. \(w\)를 워드 크기라 하고, 이 기계를 \(w\)-비트 Word-RAM이라 한다.
- 메모리: 주소로 접근하는 기계 워드의 열이다.
- 프로세서는 \(O(1)\)개의 워드(정수)에 대해 다음 연산을 상수 시간에 한다.
- 정수 산술:
+,-,*,//,% - 논리 연산과 비교:
&&,||,!,==,<,>,<=,>= - 비트 연산:
&,|,<<,>>등 - 워드 \(a\)가 주어지면 주소 \(a\)의 워드를 읽거나 쓰기
- 정수 산술:
메모리 주소로 메모리의 모든 위치에 접근할 수 있어야 하므로, \(w\)는 가장 큰 메모리 주소를 표현할 비트 수 이상이어야 한다. 입력이 \(n\)개의 워드에 저장된다면 \(w \ge \log_2 n\)이다. 32비트 워드로는 약 4 GB, 64비트 워드로는 약 16 엑사바이트까지 주소를 지정할 수 있다.
Python은 Word-RAM 위에 구현된 더 복잡한 계산 모델이다.
자료구조
자료구조(data structure) 는 상수 크기가 아닌 데이터를 저장하고, 그 데이터에 대한 연산 집합을 지원하는 방법이다. 지원하는 연산의 모음을 인터페이스(interface) 라 한다.
- 시퀀스(sequence): 항목에 외재적(extrinsic) 순서가 있다(첫째, 마지막, \(n\)번째).
- 집합(set): 항목에 내재적(intrinsic) 순서가 있다(항목의 키에 기반한 질의).
같은 인터페이스를 서로 다른 성능으로 구현하는 자료구조가 여럿 있을 수 있다.
예: 정적 배열(static array) 은 고정 폭 슬롯과 고정 길이를 가지며 정적 시퀀스 인터페이스를 지원한다.
StaticArray(n): 0으로 초기화된 크기 \(n\)의 정적 배열을 \(\Theta(n)\) 시간에 할당한다.StaticArray.get_at(i): 인덱스 \(i\)의 워드를 \(\Theta(1)\) 시간에 반환한다.StaticArray.set_at(i, x): 인덱스 \(i\)에 워드 \(x\)를 \(\Theta(1)\) 시간에 쓴다.
각 슬롯이 한 워드라서 상수 시간 접근이 가능하다. 더 큰 객체는 슬롯에 그 객체의 주소를 저장하면 된다. Python tuple은 set_at이 없는 정적 배열과 비슷하고, Python list는 동적 배열(2강)이다.
예: 생일 짝 찾기의 실행 시간
기록부를 정적 배열로 구현하면 다음과 같다. 이름과 생일은 상수 개의 워드에 들어간다고 가정한다.
def birthday_match(students):
    '''
    Find a pair of students with the same birthday
    Input:  tuple of student (name, bday) tuples
    Output: tuple of student names or None
    '''
    n = len(students)                       # O(1)
    record = StaticArray(n)                  # O(n)
    for k in range(n):                       # n
        (name1, bday1) = students[k]         # O(1)
        # Return pair if bday1 in record
        for i in range(k):                   # k
            (name2, bday2) = record.get_at(i)  # O(1)
            if bday1 == bday2:               # O(1)
                return (name1, name2)        # O(1)
        record.set_at(k, (name1, bday1))     # O(1)
    return None                              # O(1)
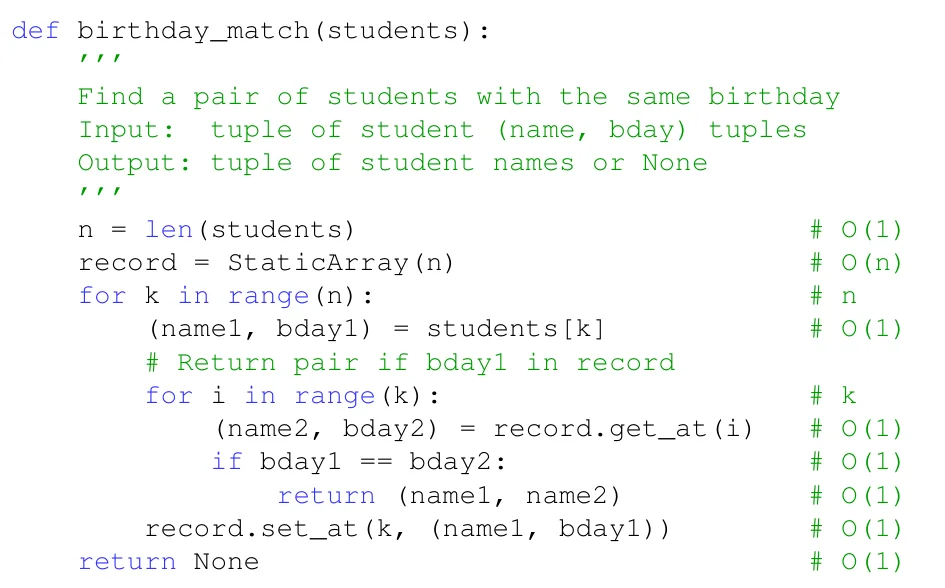 강의 노트에 실린
birthday_match 코드. 각 줄 오른쪽 주석이 그 줄 한 번 실행의 비용이거나(O(1), O(n)) 반복 횟수(n, k)다. 출처: MIT 6.006 Lecture 1 notes (CC BY-NC-SA 4.0).
그림의 주석은 실행 시간 분석의 출발점이다. 주석이 O(1)인 줄은 한 번 실행에 상수 시간이 들고, 주석이 O(n)인 줄(StaticArray(n)으로 기록부를 할당하는 줄)은 한 번만 실행되지만 \(\Theta(n)\)이 든다. 주석이 n과 k인 줄은 비용이 아니라 반복 횟수를 뜻한다. for k in range(n)의 바깥 반복은 \(n\)번 돌고, for i in range(k)의 안쪽 반복은 지금까지 기록부에 들어간 \(k\)명만큼 돈다.
따라서 전체 비용은 “반복 바깥의 비용”과 “반복 안쪽 비용의 합”으로 나뉜다. 반복 바깥은 len, StaticArray(n), 마지막 return None으로 \(O(n)\)이다. 바깥 반복의 \(k\)번째 회차는 학생 정보를 꺼내는 줄과 set_at 줄의 \(O(1)\)에, 안쪽 반복 \(k\)회 \(\times\) \(O(1)\)을 더한 \(O(1) + k \cdot O(1)\)이 든다. 이를 \(k = 0\)부터 \(n-1\)까지 더하면 아래 식이 된다.
바깥 반복은 \(k \in \{0, \ldots, n-1\}\), 안쪽 반복은 \(i \in \{0, \ldots, k-1\}\)을 돈다. 실행 시간은 다음과 같다.
\[O(n) + \sum_{k=0}^{n-1} \bigl( O(1) + k \cdot O(1) \bigr) = O(n^2)\]이차 시간은 다항 시간이다. 그렇다면 효율적인가? 기록부에 다른 자료구조를 쓰면 더 빨라진다. 예를 들어 4강의 해시 테이블을 쓰면 기대 \(O(n)\) 시간이 된다.
알고리즘 문제를 푸는 방법
- 이미 아는 문제로 환원(reduce)한다. 자료구조나 알고리즘을 가져다 쓴다.
| 탐색 문제(자료구조) | 정렬 알고리즘 | 최단 경로 알고리즘 |
|---|---|---|
| 정적 배열 (L01) | 삽입 정렬 (L03) | BFS (L09) |
| 연결 리스트 (L02) | 선택 정렬 (L03) | DAG 완화 (L11) |
| 동적 배열 (L02) | 병합 정렬 (L03) | DFS (L10) |
| 정렬된 배열 (L03) | 계수 정렬 (L05) | 위상 정렬 (L10) |
| 직접 접근 배열 (L04) | 기수 정렬 (L05) | Bellman-Ford (L12) |
| 해시 테이블 (L04) | AVL 정렬 (L07) | Dijkstra (L13) |
| 균형 이진 트리 (L06-L07) | 힙 정렬 (L08) | Johnson (L14) |
| 이진 힙 (L08) | Floyd-Warshall (L17) |
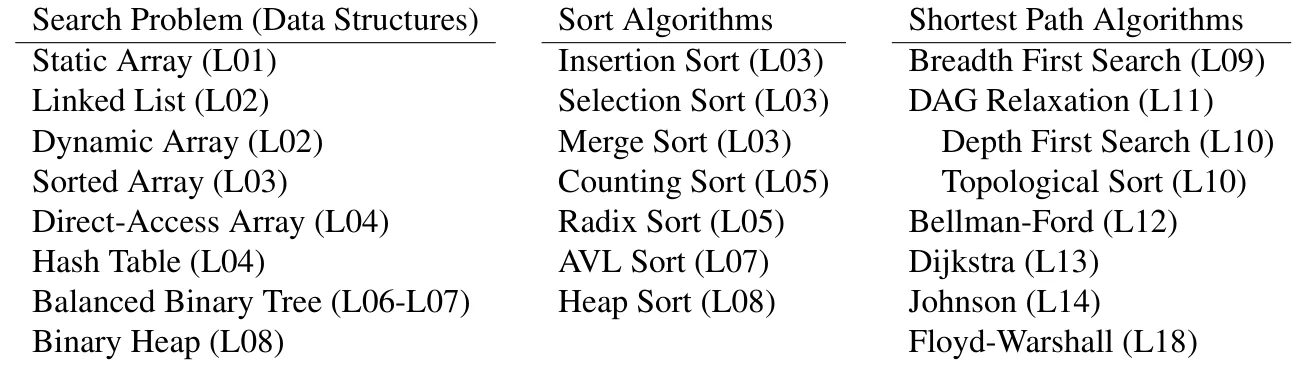 강의 노트의 “이미 아는 문제” 목록. 탐색 문제(자료구조), 정렬, 최단 경로의 세 갈래로 나뉘고 괄호 안은 해당 내용을 다루는 강의 번호다. 출처: MIT 6.006 Lecture 1 notes (CC BY-NC-SA 4.0).
이 목록은 과목 전반부의 지도 역할을 한다. 왼쪽 열은 L01-L08에서 만드는 자료구조로, 정적 배열에서 시작해 연결 리스트, 동적 배열, 정렬된 배열, 해시 테이블, 균형 이진 트리, 이진 힙 순으로 점점 더 많은 연산을 빠르게 지원한다. 가운데 열의 정렬 알고리즘은 상당수가 왼쪽 자료구조에서 나온다. 예를 들어 AVL 정렬은 AVL 트리에, 힙 정렬은 이진 힙에 원소를 넣었다가 순서대로 꺼내는 방식이다.
오른쪽 열은 그래프 단원(L09 이후)의 최단 경로 알고리즘이다. 노트 원문에서 DFS와 위상 정렬이 DAG 완화 아래에 들여쓰기된 것은, DAG 완화가 위상 정렬을 사용하고 위상 정렬이 다시 DFS를 사용한다는 의존 관계를 나타낸다. 새 문제를 만나면 먼저 이 목록 중 하나로 환원할 수 있는지 살펴보는 것이 첫 번째 전략이다.
- 직접 (재귀적) 알고리즘을 설계한다.
- 완전 탐색(brute force)
- 감소 정복(decrease and conquer)
- 분할 정복(divide and conquer)
- 동적 계획법(dynamic programming, L15-L18)
- 탐욕/점진적 방법(greedy / incremental)
정리
- 문제는 입력과 올바른 출력 사이의 관계이고, 알고리즘은 각 입력에 하나의 출력을 주는 함수다. 모든 입력에 올바른 출력을 내면 문제를 푼다.
- 임의 크기 입력을 다루는 알고리즘은 반복이나 재귀를 쓰며, 정확성은 귀납법으로 증명한다.
- 효율은 기계와 무관하게 고정 시간 연산의 수로 재고, \(O\), \(\Omega\), \(\Theta\)로 상수와 낮은 차수 항을 무시한다. 다항 시간이면 효율적이다.
- Word-RAM은 \(w\)비트 워드에 대한 산술, 비교, 비트 연산과 임의 주소 읽기/쓰기를 \(O(1)\)에 하며, \(w \ge \log_2 n\)이다.
- 인터페이스는 연산의 명세이고 자료구조는 그 구현이다. 시퀀스는 외재적 순서, 집합은 키에 따른 내재적 순서를 다룬다.
- 정적 배열을 기록부로 쓴 생일 짝 찾기는 \(O(n^2)\)이며, 더 나은 자료구조로 개선할 수 있다.