- MIT 6.006 Introduction to Algorithms (Spring 2020) 20강 정리
- 강의: Erik Demaine, Jason Ku, Justin Solomon
- MIT OpenCourseWare, CC BY-NC-SA
- ▶ 강의 영상
6.006의 목표
이 과목의 목표는 세 가지였다.
- 어려운 계산 문제(상수 크기가 아닌 입력을 가진 문제)를 푼다.
- 알고리즘이 올바름을 논증한다(귀납법, 재귀).
- 알고리즘이 “좋음”을 논증한다(점근 표기법, 계산 모델).
그리고 이 세 가지를 사람에게든 컴퓨터에게든 효과적으로 전달하는 것까지 포함한다.
“좋은” 알고리즘은 항상 존재하는가?
- 대부분의 문제는 효율적으로 풀 수 없지만, 우리가 떠올리는 문제 중 다수는 풀 수 있다.
- 다항(polynomial) 은 입력 크기에 대한 다항식이라는 뜻이다(18강).
- 의사 다항(pseudopolynomial) 은 입력 크기 그리고 입력에 들어 있는 수의 크기에 대한 다항식이라는 뜻이다(18강).
- NP: 비결정적 다항 시간(nondeterministic polynomial time). 다항 시간에 검사할 수 있는 증명서를 갖는 문제들이다(19강).
- NP-hard: NP의 어떤 문제든 다항 시간에 푸는 데 쓸 수 있는 문제들의 집합이다.
- NP-complete: NP-hard와 NP의 교집합이다.
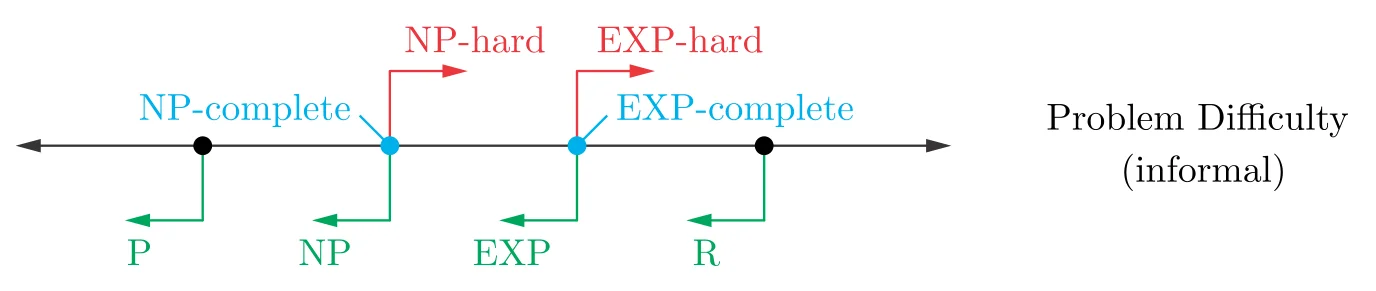 19강의 문제 난이도 그림. 왼쪽이 쉬운 문제, 오른쪽이 어려운 문제이며, 초록은 클래스, 빨강은 hard, 파랑은 complete를 나타낸다. 출처: MIT 6.006 Lecture 19 notes (CC BY-NC-SA 4.0).
이 과목에서 다룬 알고리즘은 거의 모두 맨 왼쪽의 P 구간에 있다. 정렬, 그래프 탐색, 최단 경로, 대부분의 동적 계획법이 다항 시간 알고리즘이다. 18강의 부분집합 합은 의사 다항 시간 알고리즘이 있지만 NP-complete이므로 NP-complete 점 위에 놓이고, 19강의 체스는 EXP-complete 점에 놓인다. 위의 정의들을 이 그림의 위치로 기억해 두면, 새 문제를 만났을 때 “이 문제는 어느 점 근처에 있는가”를 먼저 묻는 습관이 생긴다. 문제가 NP-hard임을 알면 다항 시간 알고리즘을 찾는 대신 의사 다항 알고리즘이나 근사 알고리즘(아래 “다음 단계”)을 찾는 쪽으로 방향을 바꿀 수 있다.
알고리즘 문제를 푸는 법
1. 풀 줄 아는 문제로 환원한다
탐색과 정렬 (퀴즈 1 범위)
- 탐색: 외재적(extrinsic, 시퀀스) 자료구조와 내재적(intrinsic, 집합) 자료구조. 배열, 연결 리스트, 동적 배열(2강), 해시 테이블(4강), 이진 트리와 AVL(6강, 7강), 이진 힙(8강).
- 정렬: 비교 모델(comparison model), 안정성(stability), 제자리(in-place) 정렬. 병합 정렬(3강), 계수/기수 정렬(5강), 힙 정렬, AVL 정렬.
그래프 (퀴즈 2 범위)
- 도달 가능성(reachability), 연결 요소(connected components), 사이클 탐지(cycle detection), 위상 정렬(topological sort): BFS(9강), DFS(10강).
- 단일 출발점 / 전체 쌍 최단 경로: DAG 완화(11강), Bellman-Ford(12강), Dijkstra(13강), Johnson(14강).
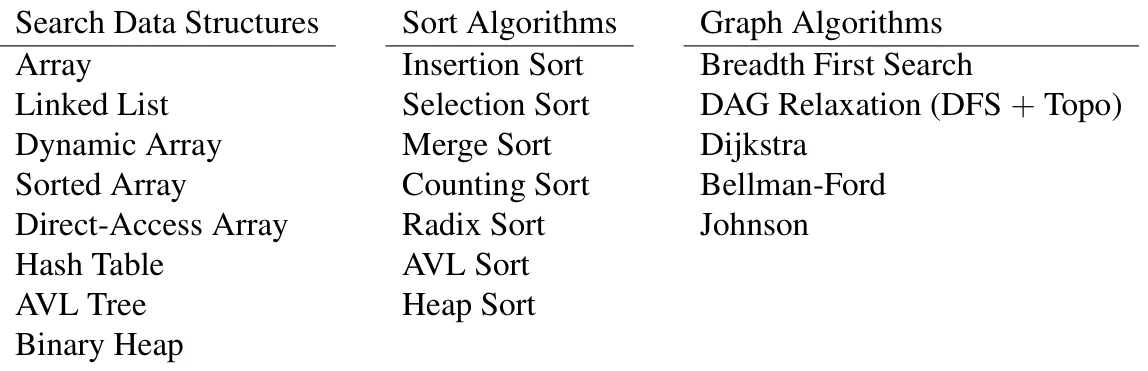 15강 노트에 정리된 도구 상자. 퀴즈 1 범위의 탐색 자료구조와 정렬 알고리즘, 퀴즈 2 범위의 그래프 알고리즘이 한 표에 모여 있다. 출처: MIT 6.006 Lecture 15 notes (CC BY-NC-SA 4.0).
환원으로 문제를 풀 때는 이 표가 후보 목록이다. 먼저 문제가 어느 열에 속하는지 정한다. 원소를 저장하고 찾는 문제는 첫 열, 순서를 매기는 문제는 둘째 열, 관계와 경로에 관한 문제는 셋째 열이다. 그다음 필요한 연산이나 입력 조건에 맞춰 열 안에서 하나를 고른다. 예를 들어 키 범위가 작은 정수 정렬이면 계수 정렬이나 기수 정렬을, 최솟값을 반복해서 꺼내야 하면 이진 힙을, 음수 가중치가 있는 그래프면 Bellman-Ford를 고른다. 표의 각 항목은 앞선 강의에서 연산별 시간까지 정리했으므로, 고른 도구의 시간을 그대로 가져와 전체 시간을 계산하면 된다.
2. 새로운 재귀 알고리즘을 설계한다
- 무차별 대입(brute force)
- 분할 정복(divide & conquer)
- 동적 계획법(dynamic programming, 퀴즈 3 범위): SRTBOT(15강~18강)
- 탐욕/점진(greedy/incremental)
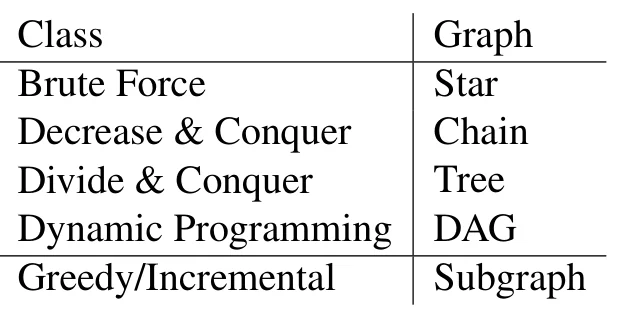 15강의 재귀 알고리즘 분류. 각 설계 기법을 호출 의존 그래프의 모양으로 구분한다. 출처: MIT 6.006 Lecture 15 notes (CC BY-NC-SA 4.0).
위 네 가지 설계 기법은 이 표의 행과 그대로 대응한다. 무차별 대입은 모든 후보를 한 번씩 시도하는 별 모양, 분할 정복은 겹치지 않는 부분 문제로 나누는 트리 모양, 동적 계획법은 부분 문제를 공유하는 DAG 모양이다. 탐욕 알고리즘은 그 DAG에서 매 단계 하나의 선택만 따라가는 부분 그래프에 해당한다. 새 재귀 알고리즘을 설계할 때는 SRTBOT으로 부분 문제와 관계를 먼저 세우고, 그 관계가 만드는 의존 그래프가 어떤 모양인지 보면 어느 기법에 해당하는지, 그리고 메모이제이션이 효과가 있을지 판단할 수 있다.
다음 단계
후속 과목으로는 다음이 있다.
| 과목 | 구분 | 이름 |
|---|---|---|
| 6.046 | 학부 | Design & Analysis of Algorithms |
| 6.851 | 대학원 | Advanced Data Structures |
| 6.854 | 대학원 | Advanced Algorithms |
6.046: 6.006의 확장
- 자료구조: 서로소 집합(union-find), 포텐셜 분석(potential analysis)을 이용한 분할 상환(amortization).
- 그래프: 최소 신장 트리(minimum spanning tree), 네트워크 흐름/절단(network flows/cuts).
- 알고리즘 설계 패러다임: 분할 정복, 동적 계획법, 탐욕 알고리즘.
- 복잡도: 환원.
문제를 완화하기: 올바름이나 효율의 정의를 바꾼다
- 랜덤화 알고리즘(randomized algorithms)
- 6.006은 대부분 결정적이었다(예외는 해싱).
- 라스베이거스(Las Vegas): 항상 옳고, 아마도 빠르다(해싱처럼).
- 몬테카를로(Monte Carlo): 항상 빠르고, 아마도 옳다.
- 구조가 있는 데이터에서는 대개 더 빠른 랜덤화 알고리즘을 얻을 수 있다.
- 수치 알고리즘/연속 최적화(numerical algorithms/continuous optimization)
- 6.006은 정수만 다뤘다.
- 실수를 근사한다. 정밀도의 대가로 시간을 치른다.
- 근사 알고리즘(approximation algorithms)
- 입력은 최적화 문제(가중치가 붙은 출력에 대한 min/max)다.
- 많은 최적화 문제가 NP-hard다.
- 다항 시간 안에 최적해에 얼마나 가까이 갈 수 있는가?
계산 모델을 바꾼다
- 캐시 모델(cache models): 메모리 계층의 비용을 반영하는 모델.
- 양자 컴퓨터(quantum computer): 양자적 성질을 활용한다.
- 병렬 프로세서(parallel processors): CPU 하나 대신 여러 개를 쓴다.
- 멀티코어, 큰 공유 메모리
- 분산 코어, 메시지 전달
후속 과목 목록
| 계산 모델 쪽 | 응용 쪽 |
|---|---|
| 계산/복잡도 (6.045, 6.840, 6.841) | 생물학 (6.047) |
| 무작위성 (6.842) | 게임 이론 (6.853) |
| 양자 (6.845) | 암호학 (6.875) |
| 분산 / 메시지 전달 (6.852) | 비전 (6.819) |
| 멀티코어 / 공유 메모리 (6.816, 6.846) | 그래픽스 (6.837) |
| 그래프와 행렬 (6.890) | 기하 (6.850) |
| 상수 인자 / 성능 (6.172) | 접기(folding) (6.849) |
왼쪽 열은 계산 모델을 바꾸는 방향의 과목이고, 오른쪽 열은 알고리즘을 응용하는 분야의 과목이다. 같은 행의 두 과목은 서로 관련이 없다.
정리
- 6.006의 목표는 문제를 풀고, 올바름(귀납법)과 효율(점근 분석, 계산 모델)을 논증하고, 이를 전달하는 것이다.
- 다항, 의사 다항, NP, NP-hard, NP-complete는 “좋은 알고리즘이 있는가”를 판단하는 기준이다.
- 문제를 푸는 첫 번째 길은 탐색/정렬 자료구조나 그래프 알고리즘 같은 아는 문제로 환원하는 것이다.
- 두 번째 길은 무차별 대입, 분할 정복, 동적 계획법, 탐욕 알고리즘으로 새로운 재귀 알고리즘을 설계하는 것이다.
- 6.046은 union-find, 최소 신장 트리, 네트워크 흐름, 환원 등으로 6.006을 확장한다.
- 랜덤화, 수치, 근사 알고리즘은 올바름이나 효율의 정의를 완화하고, 캐시, 양자, 병렬 모델은 계산 모델 자체를 바꾼다.