- MIT 6.006 Introduction to Algorithms (Spring 2020) 5강 정리
- 강의: Erik Demaine, Jason Ku, Justin Solomon
- MIT OpenCourseWare, CC BY-NC-SA
- ▶ 강의 영상
- Recitation 5 notes (PDF)
복습
- 비교 탐색 하한: 노드가 \(n\)개인 결정 트리의 높이는 \(\lceil \lg(n+1) \rceil - 1\) 이상이다.
- 임의 접근 인덱싱은 선형 분기 계수를 갖는 연산이므로 더 빠를 수 있다.
- 직접 접근 배열은 빠르지만 공간을 많이(\(\Theta(u)\)) 쓸 수 있다.
- 공간 문제는 키 공간 \(u\)를 \(m = \Theta(n)\)으로 사상(해싱)해 해결한다.
- 해시 테이블은 기대 \(O(1)\) 연산을 주며, 동적 연산이면 분할상환이다.
- 기대값은 입력과 무관하다. 범용 해시 함수족에서 해시 함수를 무작위로 고르기 때문이다.
| 자료구조 | build(X) |
find(k) |
insert(x), delete(k) |
find_min(), find_max() |
find_prev(k), find_next(k) |
|---|---|---|---|---|---|
| 배열 | \(n\) | \(n\) | \(n\) | \(n\) | \(n\) |
| 정렬된 배열 | \(n \log n\) | \(\log n\) | \(n\) | \(1\) | \(\log n\) |
| 직접 접근 배열 | \(u\) | \(1\) | \(1\) | \(u\) | \(u\) |
| 해시 테이블 | \(n\) (e) | \(1\) (e) | \(1\) (a)(e) | \(n\) | \(n\) |
지난 강의에서 find를 더 빠르게 했다. 정렬도 더 빠르게 할 수 있을까?
비교 정렬의 하한
- 비교 모델에서는 알고리즘의 결정 트리가 이진(상수 분기 계수)이다.
- 잎의 수 \(L\)은 가능한 출력의 수 이상이어야 한다.
- 트리 높이는 \(\Omega(\log L)\) 이상이므로, 최악 실행 시간은 \(\Omega(\log L)\)이다.
- 원소 \(n\)개를 정렬할 때 가능한 출력은 \(n!\)개의 순열이다.
따라서 높이의 하한은 다음과 같다. \(n!\)의 곱에서 \(n/2\) 이상인 항만 남기면 \(n! \ge (n/2)^{n/2}\)이기 때문이다.
\[\log(n!) \ge \log\bigl( (n/2)^{n/2} \bigr) = \frac{n}{2} \log \frac{n}{2} = \Omega(n \log n)\]그러므로 병합 정렬은 비교 모델에서 최적이다. 직접 접근 배열을 이용해 더 빨리 정렬할 수 있을까?
직접 접근 배열 정렬
모든 키가 \(\{0, \ldots, u-1\}\) 범위의 서로 다른 음이 아닌 정수라고 하자(따라서 \(n \le u\)).
- 각 항목을 크기 \(u\)인 직접 접근 배열에 삽입한다. \(\Theta(n)\)
- 직접 접근 배열에 나타나는 순서대로 항목을 반환한다. \(\Theta(u)\)
- 실행 시간은 \(\Theta(n + u)\)이고, \(u = \Theta(n)\)이면 \(\Theta(n)\)이다.
예: \([5, 2, 7, 0, 4]\)
def direct_access_sort(A):
    "Sort A assuming items have distinct non-negative keys"
    u = 1 + max([x.key for x in A])     # O(n) find maximum key
    D = [None] * u                      # O(u) direct access array
    for x in A:                         # O(n) insert items
        D[x.key] = x
    i = 0
    for key in range(u):                # O(u) read out items in order
        if D[key] is not None:
            A[i] = D[key]
            i += 1
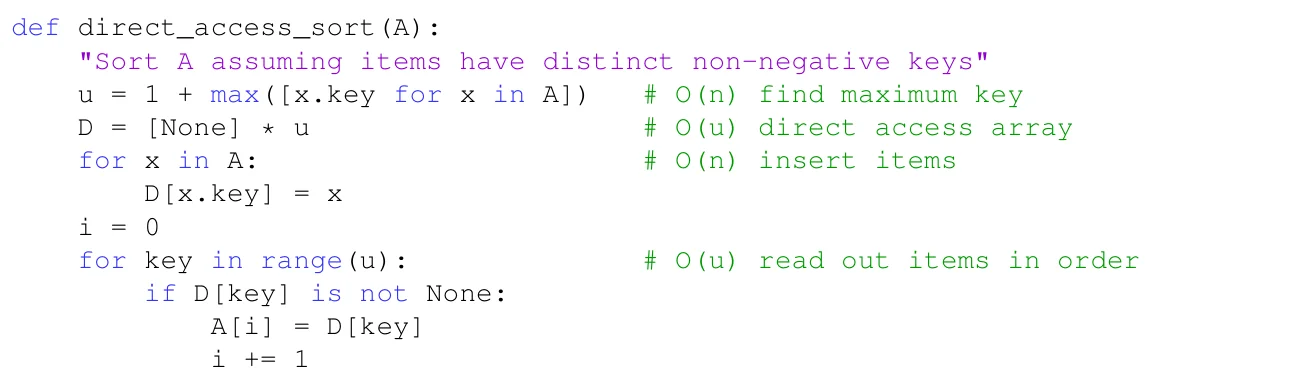 강의 노트의 직접 접근 배열 정렬 코드. 오른쪽 주석이 네 단계(최대 키 찾기, 배열 할당, 삽입, 순서대로 읽기)의 비용을 표시한다. 출처: MIT 6.006 Lecture 5 notes (CC BY-NC-SA 4.0).
예 \([5, 2, 7, 0, 4]\)를 코드에 따라가 보면 다음과 같다. 최대 키가 7이므로 \(u = 8\)이고, 길이 8의 배열 D를 None으로 채운다. 각 항목을 자기 키 위치에 넣으면 D는 인덱스 0, 2, 4, 5, 7만 채워지고 1, 3, 6은 비어 있다. 마지막 반복은 인덱스 0부터 7까지 훑으며 비어 있지 않은 칸만 A의 앞에서부터 채우므로 \([0, 2, 4, 5, 7]\)이 된다.
주석의 비용을 더하면 \(O(n) + O(u) + O(n) + O(u) = O(n + u)\)다. 비교 연산은 한 번도 쓰지 않는다는 점이 핵심이다. 대신 D[x.key] = x라는 인덱싱 한 번이 \(u\)갈래 분기 역할을 하므로 비교 정렬의 \(\Omega(n \log n)\) 하한이 적용되지 않는다. 같은 키가 두 번 나오면 D[x.key]에 나중 항목이 앞 항목을 덮어써 버린다는 것도 코드에서 바로 보인다.
이 방법에는 두 가지 약점이 있다. 중복 키를 다룰 수 없고, 키 범위가 크면 쓸 수 없다.
큰 키를 두 자리로 나누기
키 범위가 더 크면, 예를 들어 \(u = \Omega(n^2)\)이지만 \(u < n^2\)이면 어떻게 할까?
아이디어: 각 키 \(k\)를 \(k = an + b\), \(0 \le b < n\)인 튜플 \((a, b)\)로 나타낸다. 구체적으로 \(a = \lfloor k/n \rfloor < n\), \(b = k \bmod n\)이다. 즉 두 자리 \(n\)진수다. Python에서는 (a, b) = divmod(k, n)이다.
예: \(n = 5\)일 때 \([17, 3, 24, 22, 12] \Rightarrow [(3,2), (0,3), (4,4), (4,2), (2,2)] \Rightarrow [32, 03, 44, 42, 22]\)
이제 튜플을 어떻게 정렬할 것인가?
튜플 정렬
항목의 키가 같은 길이의 튜플 \(x.\text{key} = (x.k_1, x.k_2, x.k_3, \ldots)\)라고 하자. 모든 성분에 대해 사전식(lexicographic)으로 정렬하고 싶다. 첫 키 \(k_1\)이 가장 중요하다.
- 아이디어: 다른 보조 정렬 알고리즘으로 각 키를 따로 정렬한다. 스프레드시트에서 여러 열을 기준으로 행을 정렬하는 것과 같다.
- 어떤 순서로? 가장 덜 중요한 키에서 가장 중요한 키 순서로 정렬한다.
예(\(n = 5\)): 둘째 자리로 정렬한 뒤 첫째 자리로 정렬한다.
\[[32, 03, 44, 42, 22] \Rightarrow [32, 42, 22, 03, 44] \Rightarrow [03, 22, 32, 42, 44]\]튜플 정렬의 보조 정렬로 직접 접근 배열 정렬을 쓰고 싶지만 문제가 있다. 입력 키가 서로 달라도 많은 정수가 같은 \(a\)나 \(b\)를 가질 수 있다. 따라서 중복 키를 허용하면서 입력 순서를 보존하는 정렬이 필요하다.
- 정렬이 안정적(stable) 이라는 것은 같은 키를 가진 항목들이 출력에서 입력과 같은 순서로 나타난다는 뜻이다.
- 튜플 정렬이 옳으려면 보조 정렬이 안정적이어야 한다. 그래야 앞선 라운드의 정렬 결과가 이후 라운드에서 유지된다. 위 예에서 마지막 라운드의 \(42\)와 \(44\)는 첫째 자리가 같으므로, 둘째 자리 라운드에서 정한 순서를 지켜야 한다.
- 직접 접근 배열 정렬은 중복 키를 아예 정렬할 수 없다.
직접 접근 배열 정렬을 고쳐서 중복 키를 안정적으로 다루게 할 수 있을까?
계수 정렬
계수 정렬(counting sort) 은 배열의 각 인덱스에 항목 하나 대신 해싱처럼 체인을 저장한다.
- 안정성을 위해 체인은 항목이 추가된 순서를 기억해야 한다. 삽입 순서를 유지하는 시퀀스 자료구조(큐 인터페이스)를 쓴다.
- 항목 \(x\)를 삽입하려면 인덱스
x.key의 체인 끝에insert_last한다. - 정렬 결과를 얻으려면 모든 체인을 시퀀스 순서대로 읽으며 항목을 하나씩 반환한다.
def counting_sort(A):
    "Sort A assuming items have non-negative keys"
    u = 1 + max([x.key for x in A])     # O(n) find maximum key
    D = [[] for i in range(u)]          # O(u) direct access array of chains
    for x in A:                         # O(n) insert into chain at x.key
        D[x.key].append(x)
    i = 0
    for chain in D:                     # O(u) read out items in order
        for x in chain:
            A[i] = x
            i += 1
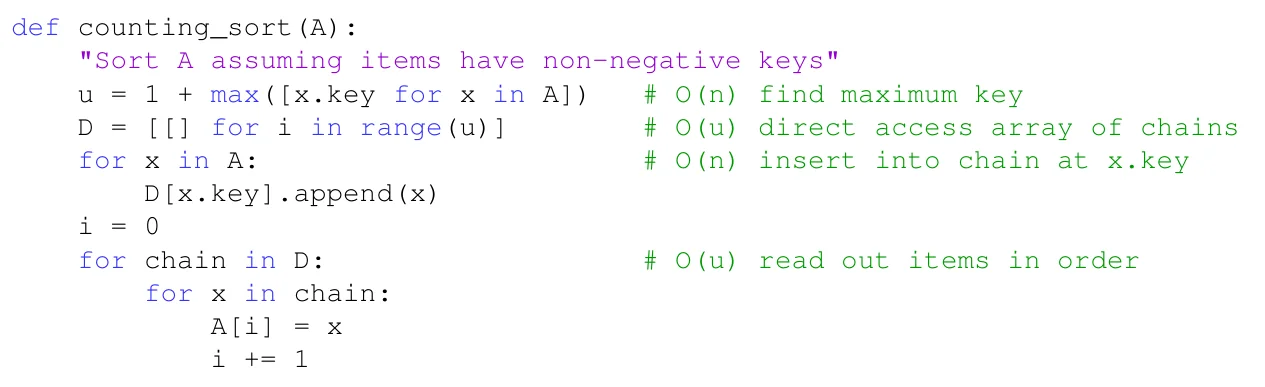 강의 노트의 계수 정렬 코드. 직접 접근 배열 정렬과 구조가 같고, 각 칸에 항목 하나 대신 리스트(체인)를 두어
append로 추가한다는 점만 다르다. 출처: MIT 6.006 Lecture 5 notes (CC BY-NC-SA 4.0).
앞의 direct_access_sort 그림과 줄 단위로 비교하면 바뀐 곳은 두 군데다. D = [None] * u가 D = [[] for i in range(u)]로, D[x.key] = x가 D[x.key].append(x)로 바뀌었다. 읽는 부분은 각 칸의 체인을 다시 앞에서부터 순회하는 이중 반복이 된다.
안정성은 append와 순회 순서에서 나온다. 예를 들어 키가 \((3, a), (1, b), (3, c)\)인 세 항목을 넣으면 D[3]에는 입력 순서대로 \([a, c]\)가 쌓인다. 읽을 때도 체인을 앞에서부터 읽으므로 출력은 \(b, a, c\)가 되어, 같은 키 3을 가진 \(a\)와 \(c\)가 입력 순서를 유지한다. 기수 정렬이 이 성질에 의존한다.
실행 시간은 체인 초기화 \(O(u)\), 삽입 \(O(n)\), 읽기 \(O(u + n)\)이므로 \(O(n + u)\)다. \(u = O(n)\)이면 중복 키를 허용하면서 선형 시간이다.
Recitation에는 각 키의 개수만 세고 누적 합으로 최종 위치를 계산해 각 항목을 한 번만 옮기는 구현도 있다. 뒤에서부터 배치하므로 역시 안정적이다.
def counting_sort(A):
    "Sort A assuming items have non-negative keys"
    u = 1 + max([x.key for x in A])     # O(n) find maximum key
    D = [0] * u                         # O(u) direct access array
    for x in A:                         # O(n) count keys
        D[x.key] += 1
    for k in range(1, u):               # O(u) cumulative sums
        D[k] += D[k - 1]
    for x in list(reversed(A)):         # O(n) move items into place
        A[D[x.key] - 1] = x
        D[x.key] -= 1
기수 정렬
아이디어: \(u < n^2\)이면 보조 정렬로 계수 정렬을 쓰는 튜플 정렬로 튜플 \((a, b)\)를 정렬한다.
- 덜 중요한 키 \(b\)를 먼저 정렬하고, 더 중요한 키 \(a\)를 정렬한다.
- 안정성 덕분에 앞서 정렬한 결과가 유지된다.
- 각 라운드는 \(a, b < n\)이므로 \(O(n)\)이고, 전체 실행 시간은 \(O(2n) = O(n)\)이다.
일반화하면 다음과 같다.
- 모든 키가 양수 \(c = \log_n u\)에 대해 \(n^c\)보다 작으면, 모든 키는 \(n\)진수로 최대 \(c\)자리다.
- \(c\)자리 수는 \(O(c)\) 시간에 \(c\)-원소 튜플로 바꿀 수 있다.
- \(c\)개의 \(n\)진수 자리를 각각 \(O(n)\) 시간에 정렬한다.
- 따라서 계수 정렬을 보조로 쓰는 튜플 정렬은 총 \(O(cn)\) 시간이다.
- \(c\)가 상수이면, 즉 각 키가 \(n^c\) 이하이면 이 정렬은 선형 \(O(n)\)이다.
이 조합이 기수 정렬(radix sort) 이다.
def radix_sort(A):
    "Sort A assuming items have non-negative keys"
    n = len(A)
    u = 1 + max([x.key for x in A])             # O(n) find maximum key
    c = 1 + (u.bit_length() // n.bit_length())
    class Obj: pass
    D = [Obj() for a in A]
    for i in range(n):                          # O(nc) make digit tuples
        D[i].digits = []
        D[i].item = A[i]
        high = A[i].key
        for j in range(c):                      # O(c) make digit tuple
            high, low = divmod(high, n)
            D[i].digits.append(low)
    for i in range(c):                          # O(nc) sort each digit
        for j in range(n):                      # O(n) assign key i to tuples
            D[j].key = D[j].digits[i]
        counting_sort(D)                        # O(n) sort on digit i
    for i in range(n):                          # O(n) output to A
        A[i] = D[i].item
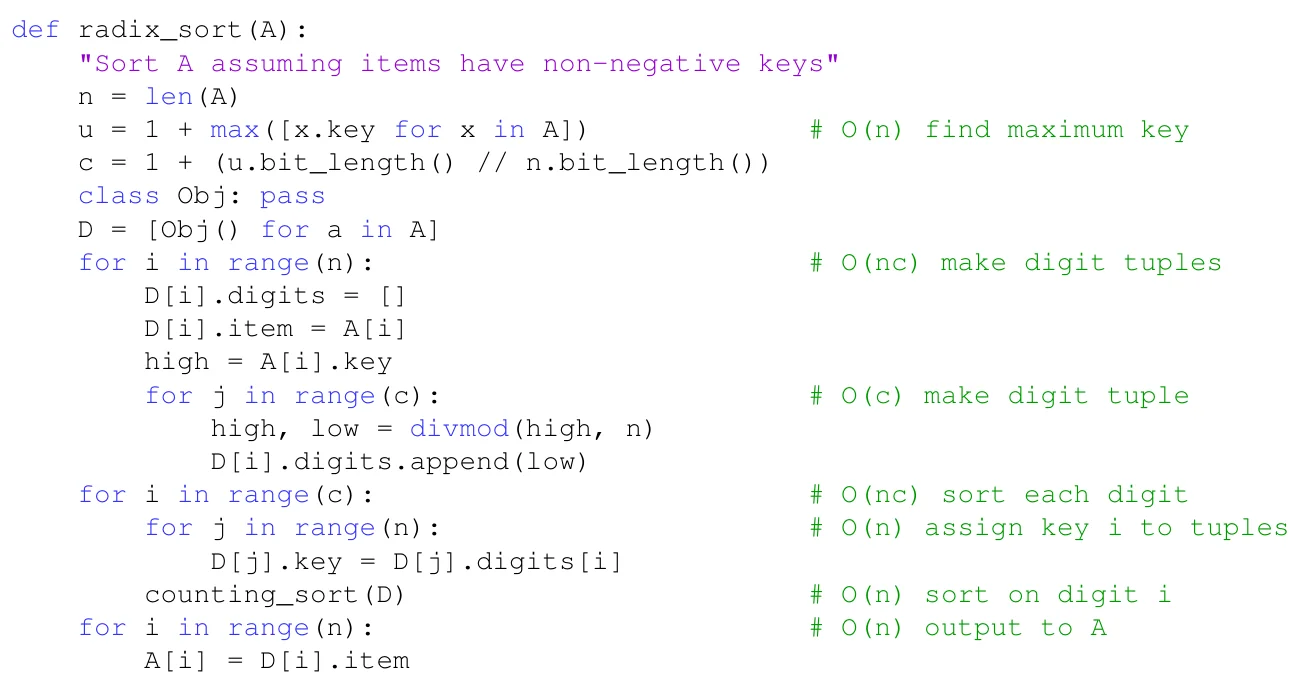 강의 노트의 기수 정렬 코드. 위쪽 반복이 각 키를 \(n\)진수 자릿수 튜플로 바꾸고, 아래쪽 반복이 자리마다 계수 정렬을 한 번씩 한다. 출처: MIT 6.006 Lecture 5 notes (CC BY-NC-SA 4.0).
코드는 세 부분으로 읽는다. 첫째, c = 1 + (u.bit_length() // n.bit_length())는 키를 \(n\)진수로 썼을 때 필요한 자릿수 \(c \approx \log_n u\)를 비트 길이로 근사한 것이다. 둘째, divmod(high, n)을 \(c\)번 반복해 낮은 자리부터 digits에 붙인다. 예를 들어 \(n = 5\), 키가 17이면 divmod(17, 5) = (3, 2)에서 2가, 이어서 divmod(3, 5) = (0, 3)에서 3이 들어가 digits = [2, 3]이 된다. 셋째, 자리 \(i\)마다 D[j].key를 그 자리 숫자로 바꾸고 counting_sort(D)를 부른다. 각 자리 숫자는 \(n\)보다 작으므로 계수 정렬 한 번이 \(O(n)\)이다.
원래 항목은 D[i].item에 보관되어 있다가 마지막 반복에서 A로 옮겨진다. 별도의 래퍼 객체 Obj를 만드는 이유는, 계수 정렬이 .key만 보고 정렬하도록 라운드마다 키를 바꿔 끼우면서도 원래 항목의 키는 건드리지 않기 위해서다.
digits에는 낮은 자리부터 들어가므로, i = 0부터 차례로 정렬하면 가장 덜 중요한 자리부터 정렬하게 된다.
Recitation 예제
- 10진 기수 정렬: \((329, 457, 657, 839, 436, 720, 355) \to (329, 355, 436, 457, 657, 720, 839)\)
- 범위 \([-n^2, \ldots, n^3]\)의 정수 \(n\)개를 선형 시간에 정렬하려면, 모든 수에 \(n^2\)를 더해 음이 아니게 만들고 기수 정렬한 뒤 다시 \(n^2\)를 뺀다. 키가 \(O(n^3)\)이므로 \(c\)가 상수다.
- 영어 소문자 \(k\)개로 된 문자열 \(n\)개는 오른쪽 문자부터 계수 정렬(키 \(\{0, \ldots, 25\}\))을 \(k\)번 하는 튜플 정렬로 \(\Theta(nk)\)에 정렬한다. 입력 크기가 \(\Theta(nk)\)이므로 선형이다.
정렬 알고리즘 비교
| 알고리즘 | 시간 \(O(\cdot)\) | 제자리? | 안정적? | 비고 |
|---|---|---|---|---|
| 삽입 정렬 | \(n^2\) | Y | Y | \(k\)-근접 배열이면 \(O(nk)\) |
| 선택 정렬 | \(n^2\) | Y | N | 교환 \(O(n)\)번 |
| 병합 정렬 | \(n \log n\) | N | Y | 안정적, 비교 정렬 중 최적 |
| 계수 정렬 | \(n + u\) | N | Y | \(u = O(n)\)이면 \(O(n)\) |
| 기수 정렬 | \(n + n \log_n u\) | N | Y | \(u = O(n^c)\)이면 \(O(n)\) |
\(k\)-근접(k-proximate) 배열은 각 원소가 정렬된 위치에서 \(k\)칸 이내에 있는 배열이다.
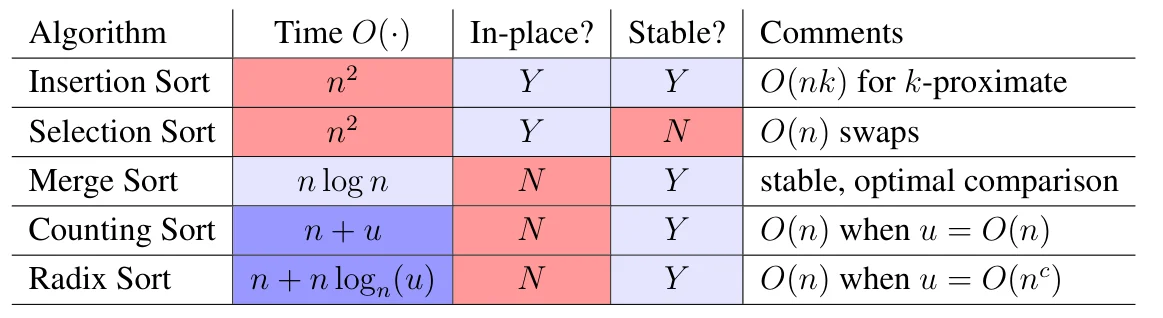 강의 노트의 정렬 알고리즘 비교표. 시간 열의 색은 빠를수록 파랗고 느릴수록 붉으며, 제자리와 안정성 열은 Y가 파란색, N이 붉은색이다. 출처: MIT 6.006 Lecture 5 notes (CC BY-NC-SA 4.0).
표를 열 방향으로 읽으면 어느 알고리즘도 모든 열에서 파랗지 않다는 점이 보인다. 시간 열에서 가장 파란 것은 계수 정렬과 기수 정렬이지만, 둘 다 제자리 열이 N이다. 보조 배열(체인)을 쓰기 때문이다. 반대로 삽입 정렬과 선택 정렬은 제자리 정렬이지만 이차 시간이다.
기수 정렬의 시간 \(n + n \log_n u\)는 “자릿수 \(c = \log_n u\)번의 계수 정렬, 각각 \(O(n)\)“을 그대로 쓴 것이다. \(u = n^c\)이면 \(\log_n u = c\)가 상수가 되어 선형이다. 반면 \(u\)가 \(2^n\)처럼 \(n\)에 대해 지수적으로 크면 \(\log_n u = n / \log n\)이 되어 기수 정렬은 \(n^2 / \log n\)으로 오히려 병합 정렬보다 느려진다. 비교표의 “비고” 열이 각 알고리즘이 빛나는 조건을 적어 둔 이유다.
정리
- 비교 정렬은 출력이 \(n!\)가지이므로 결정 트리 높이가 \(\log(n!) = \Omega(n \log n)\) 이상이다. 병합 정렬은 비교 모델에서 최적이다.
- 직접 접근 배열 정렬은 서로 다른 키에 대해 \(\Theta(n + u)\)이지만, 중복 키와 큰 키 범위를 다루지 못한다.
- 큰 키는 \(k = an + b\)처럼 \(n\)진수 자리로 쪼개 튜플로 보고, 튜플 정렬로 가장 덜 중요한 자리부터 정렬한다.
- 튜플 정렬이 옳으려면 보조 정렬이 안정적이어야 한다. 계수 정렬은 각 키 위치에 삽입 순서를 기억하는 체인을 두어 중복 키를 안정적으로 \(O(n + u)\)에 정렬한다.
- 기수 정렬은 계수 정렬을 보조로 쓰는 튜플 정렬이며, 키가 \(n^c\) 미만이면 \(O(cn)\), \(c\)가 상수이면 \(O(n)\)이다.