- MIT 6.006 Introduction to Algorithms (Spring 2020) 13강 정리
- 강의: Erik Demaine, Jason Ku, Justin Solomon
- MIT OpenCourseWare, CC BY-NC-SA
- ▶ 강의 영상
- Recitation 13 notes (PDF)
복습
- 가중 그래프의 단일 출발점 최단 경로(SSSP)를 다루고 있다.
- 앞에서는 작은 양수 가중치나 DAG에 대한 \(O(\lvert V \rvert + \lvert E \rvert)\) 알고리즘을 보았다.
- 지난 강의의 Bellman-Ford는 음수 가중치가 있는 일반 그래프에서 \(O(\lvert V \rvert\lvert E \rvert)\)에 동작한다.
- 이번 강의에서는 간선 가중치가 음이 아닌, 즉 모든 \(e \in E\)에 대해 \(w(e) \ge 0\)인 일반 그래프에서 더 빠른 알고리즘을 다룬다.
| 그래프 | 가중치 | 알고리즘 | 실행 시간 \(O(\cdot)\) | 강의 |
|---|---|---|---|---|
| 일반 | 가중치 없음 | BFS | \(\lvert V \rvert + \lvert E \rvert\) | 9강 |
| DAG | 임의 | DAG Relaxation | \(\lvert V \rvert + \lvert E \rvert\) | 11강 |
| 일반 | 임의 | Bellman-Ford | \(\lvert V \rvert \cdot \lvert E \rvert\) | 12강 |
| 일반 | 음이 아님 | Dijkstra | \(\lvert V \rvert \log \lvert V \rvert + \lvert E \rvert\) | 13강 (이번 강의) |
음이 아닌 간선 가중치
아이디어. BFS의 방식을 가중 그래프로 일반화한다. 출발점 \(s\)를 중심으로 구를 키워 가며, 가까운 정점을 먼 정점보다 먼저 탐색한다. 하지만 거리를 미리 모르는데 가까운 정점부터 어떻게 탐색할까?
관찰 1. 가중치가 음이 아니면 최단 경로를 따라 거리가 단조 증가한다.
- 즉 \(u\)가 \(s\)에서 \(v\)로 가는 최단 경로 위에 있으면 \(\delta(s, u) \le \delta(s, v)\)다.
- \(V_x \subset V\)를 \(s\)로부터 거리 \(x\) 이하로 도달 가능한 정점의 부분집합이라 하자.
- \(v \in V_x\)이면 \(s\)에서 \(v\)로 가는 모든 최단 경로는 \(V_x\)의 정점만 지난다.
- 그러니 \(V_x\)를 한 정점씩 키워 나가면 될지 모른다. (단, 가중치가 크면 모든 \(x\)에 대해 키우는 것은 느리다.)
관찰 2. \(s\)로부터 거리가 증가하는 순서로 정점이 주어지면 SSSP를 빠르게 풀 수 있다.
- 이 순서를 거스르는 간선은 최단 경로에 쓰일 수 없으므로 지운다.
- 가중치 0인 간선 때문에 사이클이 남을 수 있는데, 이런 사이클은 반복해서 정점 하나로 합친다.
- 그러면 DAG가 되므로 DAG Relaxation으로 모든 \(\delta(s, v)\)를 \(O(\lvert V \rvert + \lvert E \rvert)\)에 계산한다.
Dijkstra 알고리즘
네덜란드의 유명한 컴퓨터 과학자 Edsger Dijkstra의 이름을 땄다.
- 아이디어. 출발점 \(s\)로부터의 거리가 증가하는 순서로 각 정점에서 나가는 간선을 완화한다.
- 아이디어. 순서상 다음 정점을 자료구조로 효율적으로 찾는다.
변경 가능한 우선순위 큐
키와 고유 ID를 가진 항목을 저장하는 변경 가능한 우선순위 큐(changeable priority queue) \(Q\)는 다음 연산을 지원한다.
| 연산 | 의미 |
|---|---|
Q.build(X) |
반복 가능한 X의 항목으로 \(Q\)를 초기화한다 |
Q.delete_min() |
키가 최소인 항목을 제거한다 |
Q.decrease_key(id, k) |
ID가 id인 항목을 찾아 키를 k로 바꾼다 |
우선순위 큐 \(Q'\)와 ID를 \(Q'\) 안의 위치로 대응시키는 사전 \(D\)를 서로 연결(cross-link)해 구현한다. 정점 ID가 \(0\)부터 \(\lvert V \rvert - 1\)까지의 정수라고 가정하면 \(D\)로 직접 접근 배열을 쓸 수 있다. 간단히 항목 \(x\)를 튜플 (x.id, x.key)로 쓴다.
알고리즘
- 모든 \(v \in V\)에 대해 \(d(s, v) = \infty\)로 두고, \(d(s, s) = 0\)으로 둔다.
- 각 정점 \(v \in V\)에 대해 항목 \((v, d(s, v))\)를 가진 변경 가능한 우선순위 큐 \(Q\)를 만든다.
- \(Q\)가 빌 때까지, \(d(s, u)\)가 최소인 항목 \((u, d(s, u))\)를 \(Q\)에서 삭제한다.
- 나가는 이웃 \(v \in \text{Adj}^+(u)\)마다 \(d(s, v) > d(s, u) + w(u, v)\)이면 다음을 한다.
- 간선 \((u, v)\)를 완화한다. 즉 \(d(s, v) = d(s, u) + w(u, v)\)로 둔다.
- \(Q\)에서 \(v\)의 키를 새 추정값 \(d(s, v)\)로 낮춘다.
- 나가는 이웃 \(v \in \text{Adj}^+(u)\)마다 \(d(s, v) > d(s, u) + w(u, v)\)이면 다음을 한다.
Recitation의 구현은 다음과 같다. try_to_relax는 11강의 간선 완화 함수다.
def dijkstra(Adj, w, s):
    d = [float('inf') for _ in Adj]  # 최단 경로 추정값 d(s, v)
    parent = [None for _ in Adj]     # 부모 포인터 초기화
    d[s], parent[s] = 0, s           # 출발점 초기화
    Q = PriorityQueue()              # 빈 우선순위 큐
    V = len(Adj)                     # 정점 수
    for v in range(V):               # 모든 정점을
        Q.insert(v, d[v])            # (정점, 추정값) 쌍으로 삽입
    for _ in range(V):               # 주 반복문
        u = Q.extract_min()          # 추정값이 최소인 정점을 꺼냄
        for v in Adj[u]:             # 나가는 간선 순회
            try_to_relax(Adj, w, d, parent, u, v)
            Q.decrease_key(v, d[v])  # 정점의 키 갱신
    return d, parent
물이 흐르는 관 네트워크로 비유할 수 있다. 각 관의 길이가 음이 아니고 출발점 \(s\)에서 수도꼭지를 틀면, 물은 각 교차점에 최단 거리 순서대로 도착한다. Dijkstra 알고리즘은 이 연속적인 과정을 이산화한 것이다.
예제
정점 \(s, a, b, c, d\)와 간선 \((s, a)\) 10, \((s, c)\) 3, \((a, c)\) 1, \((c, a)\) 4, \((a, b)\) 2, \((c, b)\) 8, \((c, d)\) 2, \((b, d)\) 7, \((d, b)\) 5를 가진 그래프에서 \(s\)부터 Dijkstra를 실행한다.
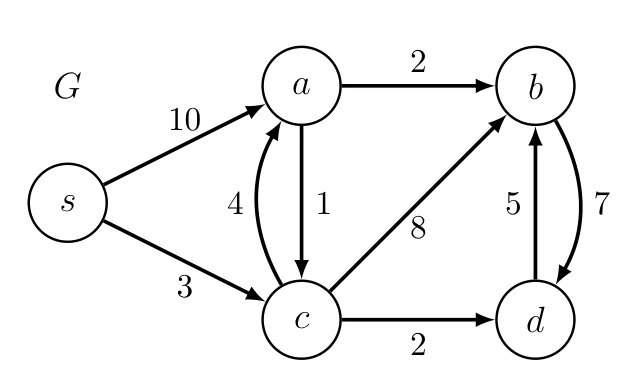 Dijkstra 예제 그래프 \(G\). 모든 간선 가중치가 음이 아니며, \(a\)와 \(c\) 사이, \(b\)와 \(d\) 사이에는 양방향 간선이 있다. 출처: MIT 6.006 Lecture 13 notes (CC BY-NC-SA 4.0).
그림에서 \(s\)의 나가는 간선은 \(a\)로 가는 10과 \(c\)로 가는 3 두 개다. 겉보기에는 \(s \to a\)가 \(a\)로 가는 직행로지만, \(s \to c \to a\)로 돌아가면 \(3 + 4 = 7\)로 더 가볍다. \(b\)도 마찬가지로 \(c \to b\)의 8보다 \(c \to a \to b\)의 \(4 + 2\)가 가볍다. 이처럼 간선 수가 적은 경로가 꼭 최단 경로는 아니라는 점이 BFS를 그대로 쓸 수 없는 이유이고, Dijkstra가 “현재 가장 가까운 정점”을 하나씩 확정해 나가는 이유다.
아래 표의 각 행은 해당 정점을 \(Q\)에서 삭제하는 시점에 \(Q\)에 남아 있는 정점들의 추정값 \(d(s, v)\)다.
| 삭제하는 정점 | \(s\) | \(a\) | \(b\) | \(c\) | \(d\) |
|---|---|---|---|---|---|
| \(s\) | 0 | \(\infty\) | \(\infty\) | \(\infty\) | \(\infty\) |
| \(c\) | \(10\) | \(\infty\) | 3 | \(\infty\) | |
| \(d\) | \(7\) | \(11\) | 5 | ||
| \(a\) | 7 | \(10\) | |||
| \(b\) | 9 | ||||
| \(\delta(s, v)\) | \(0\) | \(7\) | \(9\) | \(3\) | \(5\) |
\(c\)를 처리하면 \(a\)가 \(3 + 4 = 7\), \(b\)가 \(3 + 8 = 11\), \(d\)가 \(3 + 2 = 5\)가 된다. \(d\)를 처리하면 \(b\)가 \(5 + 5 = 10\)이 되고, \(a\)를 처리하면 \(b\)가 \(7 + 2 = 9\)가 된다.
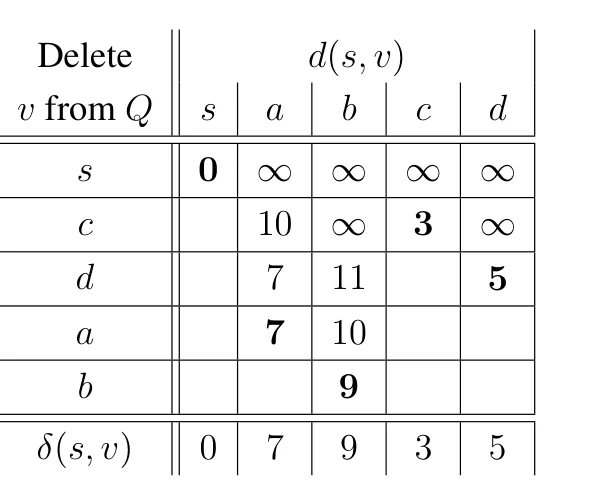 강의 노트의 실행 표. 행은 \(Q\)에서 삭제하는 정점, 열은 각 정점의 추정값 \(d(s, v)\)이며, 굵은 숫자는 그 행에서 삭제되어 값이 확정되는 정점이다. 출처: MIT 6.006 Lecture 13 notes (CC BY-NC-SA 4.0).
표는 대각선 방향으로 읽는다. 각 행에서 굵은 숫자는 그 순간 \(Q\)에 남은 값 가운데 최솟값이고, 그 정점을 꺼낸 뒤에는 열이 비워진다. 꺼낸 정점의 나가는 간선을 완화한 결과는 다음 행에 나타난다. 예를 들어 \(c\) 행에서 3이 확정된 뒤 \(d\) 행을 보면 \(a\)가 10에서 7로, \(b\)가 \(\infty\)에서 11로, \(d\)가 \(\infty\)에서 5로 내려가 있다.
같은 열을 위에서 아래로 따라가면 값이 줄어들기만 한다는 것도 보인다. \(b\) 열은 \(\infty \to 11 \to 10 \to 9\)로 세 번 갱신된다. 완화는 추정값을 낮추기만 하고, 정점이 굵게 확정되는 순간 그 값이 맨 아래 행의 \(\delta(s, v)\)와 일치한다. 정확성 증명이 보이는 내용이 바로 이 “꺼내는 순간 정확하다”는 성질이다. 또 굵은 숫자를 위에서부터 읽으면 \(0, 3, 5, 7, 9\)로 증가하는데, 관찰 1이 말한 거리 순서대로 정점을 처리한다는 뜻이다.
정확성
주장. Dijkstra 알고리즘이 끝나면 모든 \(v \in V\)에 대해 \(d(s, v) = \delta(s, v)\)다.
증명. 완화가 \(d(s, v)\)를 \(\delta(s, v)\)로 만들면 알고리즘이 끝날 때까지 \(d(s, v) = \delta(s, v)\)다. 완화는 추정값을 줄이기만 하고, 안전하므로(각 \(d(s, v)\)는 항상 \(v\)로 가는 어떤 경로의 가중치이거나 \(\infty\)) \(\delta(s, v)\) 아래로 내려가지 않기 때문이다. 따라서 정점 \(v\)를 \(Q\)에서 삭제할 때 \(d(s, v) = \delta(s, v)\)임을 보이면 충분하다. \(Q\)에서 삭제된 처음 \(k\)개 정점에 대한 귀납법을 쓴다.
- 기저(\(k = 1\)): \(s\)가 \(Q\)에서 처음 삭제되며 \(d(s, s) = 0 = \delta(s, s)\)다.
- 귀납: \(k < k'\)에서 성립한다고 하고, \(Q\)에서 \(k'\)번째로 삭제되는 정점 \(v'\)를 생각한다. \(w(\pi) = \delta(s, v')\)인 \(s\)에서 \(v'\)로의 최단 경로 \(\pi\)를 잡는다. \(\pi\)에서 \(y\)가 처음 \(k' - 1\)개 정점에 속하지 않는 첫 간선을 \((x, y)\)라 하자(\(y = v'\)일 수도 있다). \(x\)를 \(Q\)에서 삭제할 때 귀납 가정에 의해 \(d(s, x) = \delta(s, x)\)였으므로 다음이 성립한다.
양 끝이 같으므로 모든 부등식이 등식이 되고, \(d(s, v') = \delta(s, v')\)다.
음이 아닌 가중치 가정은 셋째 줄에서 쓰인다. \(y\) 이후의 경로 가중치가 음수일 수 있다면 \(\delta(s, y) \le \delta(s, v')\)가 성립하지 않는다.
실행 시간
\(Q\)에 \(n\)개 항목이 있을 때 각 연산의 시간과 Dijkstra에서의 호출 횟수를 센다.
| 연산 | 시간 | Dijkstra에서의 횟수 |
|---|---|---|
Q.build(X) (\(n = \lvert X \rvert\)) |
\(B_n\) | \(1\) |
Q.delete_min() |
\(M_n\) | \(\lvert V \rvert\) |
Q.decrease_key(id, k) |
\(D_n\) | \(\lvert E \rvert\) |
전체 실행 시간은 다음과 같다.
\[O(B_{\lvert V \rvert} + \lvert V \rvert \cdot M_{\lvert V \rvert} + \lvert E \rvert \cdot D_{\lvert V \rvert})\]출발점에서 도달 가능한 정점만 남기도록 그래프를 줄였다고 가정하면 \(\lvert V \rvert = O(\lvert E \rvert)\)다. 우선순위 큐 \(Q'\)의 선택에 따라 다음과 같다(\(n = \lvert V \rvert = O(\lvert E \rvert)\), (a)는 분할 상환).
| \(Q'\) | build(X) |
delete_min() |
decrease_key(id, k) |
Dijkstra |
|---|---|---|---|---|
| 배열 | \(n\) | \(n\) | \(1\) | \(\lvert V \rvert^2\) |
| 이진 힙 | \(n\) | \(\log n\) (a) | \(\log n\) | \(\lvert E \rvert \log \lvert V \rvert\) |
| 피보나치 힙 | \(n\) | \(\log n\) (a) | \(1\) (a) | \(\lvert E \rvert + \lvert V \rvert \log \lvert V \rvert\) |
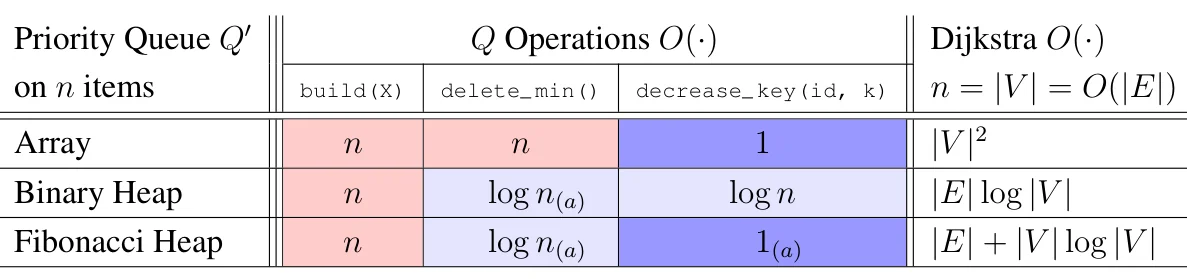 우선순위 큐 구현별 연산 시간과 Dijkstra 실행 시간. 진한 파랑이 가장 빠르고 분홍이 가장 느린 연산이며, 아래 첨자 (a)는 분할 상환 시간이다. 출처: MIT 6.006 Lecture 13 notes (CC BY-NC-SA 4.0).
표의 각 행에 \(B_n\), \(M_n\), \(D_n\)을 대입하면 오른쪽 열이 나온다. 배열은 \(n + \lvert V \rvert \cdot n + \lvert E \rvert \cdot 1 = O(\lvert V \rvert^2)\)이고, 이진 힙은 \(n + \lvert V \rvert \log n + \lvert E \rvert \log n = O(\lvert E \rvert \log \lvert V \rvert)\), 피보나치 힙은 \(n + \lvert V \rvert \log n + \lvert E \rvert \cdot 1 = O(\lvert E \rvert + \lvert V \rvert \log \lvert V \rvert)\)다.
색을 보면 교환 관계가 드러난다. 배열은 decrease_key가 가장 빠른 대신 delete_min이 느리고, 이진 힙은 두 연산을 모두 \(\log n\)으로 맞춘다. Dijkstra에서 delete_min은 \(\lvert V \rvert\)번, decrease_key는 \(\lvert E \rvert\)번 호출되므로, 간선이 많을수록 decrease_key가 싼 구조가 유리하다. 피보나치 힙은 두 연산 모두에서 좋은 쪽을 취해 모든 밀도에서 최선의 점근 시간을 낸다.
- 그래프가 밀집(dense)해서 \(\lvert E \rvert = \Theta(\lvert V \rvert^2)\)이면, \(Q'\)로 배열을 쓰면 \(O(\lvert V \rvert^2)\), 곧 입력 크기에 선형이다.
- 그래프가 희소(sparse)해서 \(\lvert E \rvert = \Theta(\lvert V \rvert)\)이면, 이진 힙을 쓰면 \(O(\lvert V \rvert \log \lvert V \rvert)\)다.
- 피보나치 힙(Fibonacci heap) 은 이론적으로 모든 경우에 좋지만 구현이 복잡하고 상수 인자가 커서 실제로는 잘 쓰이지 않는다. 6.006에서는 다루지 않는다(6.854나 CLRS 19장 참고).
- 이론 문제에서는 Dijkstra가 \(O(\lvert E \rvert + \lvert V \rvert \log \lvert V \rvert)\)에 동작한다고 가정하면 된다.
우선순위 큐 구현 (Recitation)
Recitation은 Dijkstra용 우선순위 큐를 키-값 쌍(값은 정점 \(v\), 키는 \(d(s, v)\))으로 보고 insert(val, key), extract_min(), decrease_key(val, new_key)를 쓴다. 각 연산의 시간을 \(T_i\), \(T_e\), \(T_d\)라 하면 다음과 같다.
사전으로 구현
가장 단순한 구현은 모든 정점과 현재 추정값을 사전(해시 테이블이나 직접 접근 배열)에 저장하는 것이다. 삽입과 키 감소는 \(O(1)\)이지만 최솟값을 찾아 꺼내는 데 \(O(\lvert V \rvert)\)가 든다. 따라서 \(O(\lvert V \rvert^2 + \lvert E \rvert)\)이며, 밀집 그래프에서는 입력 크기에 선형이다.
class PriorityQueue:                 # 해시 테이블 구현
    def __init__(self):
        self.A = {}                  # 라벨 -> 키

    def insert(self, label, key):
        self.A[label] = key

    def extract_min(self):           # 키가 최소인 라벨을 꺼낸다: O(n)
        min_label = None
        for label in self.A:
            if (min_label is None) or (self.A[label] < self.A[min_label]):
                min_label = label
        del self.A[min_label]
        return min_label

    def decrease_key(self, label, key):  # 아직 큐에 있으면 키를 낮춘다: O(1)
        if (label in self.A) and (key < self.A[label]):
            self.A[label] = key
이진 힙으로 구현
이진 최소 힙은 삽입과 최솟값 추출을 \(O(\log n)\)에 한다. 키 감소는 힙에서 해당 값을 먼저 찾아야 하는데, 각 라벨의 힙 내 위치를 사전 label2idx로 유지하면 \(O(1)\)에 찾는다. 키를 낮춘 뒤 min_heapify_up으로 힙 성질을 \(O(\log n)\)에 복구한다. 교환할 때마다 label2idx도 갱신한다. 실행 시간은 \(O((\lvert V \rvert + \lvert E \rvert) \log \lvert V \rvert)\)이고, 희소 그래프에서는 \(O(\lvert V \rvert \log \lvert V \rvert)\)다.
class Item:
    def __init__(self, label, key):
        self.label, self.key = label, key

class PriorityQueue:                 # 이진 힙 구현
    def __init__(self):
        self.A = []
        self.label2idx = {}          # 라벨 -> 힙 배열의 인덱스

    def _swap(self, i, j):
        self.A[i], self.A[j] = self.A[j], self.A[i]
        self.label2idx[self.A[i].label] = i
        self.label2idx[self.A[j].label] = j

    def min_heapify_up(self, c):
        if c == 0: return
        p = (c - 1) // 2
        if self.A[p].key > self.A[c].key:
            self._swap(c, p)
            self.min_heapify_up(p)

    def min_heapify_down(self, p):
        if p >= len(self.A): return
        l, r = 2 * p + 1, 2 * p + 2
        if l >= len(self.A): l = p
        if r >= len(self.A): r = p
        c = l if self.A[r].key > self.A[l].key else r
        if self.A[p].key > self.A[c].key:
            self._swap(c, p)
            self.min_heapify_down(c)

    def insert(self, label, key):
        self.A.append(Item(label, key))
        idx = len(self.A) - 1
        self.label2idx[label] = idx
        self.min_heapify_up(idx)

    def extract_min(self):
        self._swap(0, len(self.A) - 1)
        del self.label2idx[self.A[-1].label]
        min_label = self.A.pop().label
        self.min_heapify_down(0)
        return min_label

    def decrease_key(self, label, key):
        if label in self.label2idx:
            idx = self.label2idx[label]
            if key < self.A[idx].key:
                self.A[idx].key = key
                self.min_heapify_up(idx)
간선 수가 정점 수에 선형 이하(평면 그래프, 차수가 유계인 그래프)이거나 제곱 이상(완전 그래프)으로 알려져 있으면, 각각 이진 힙이나 사전을 써도 점근적으로 피보나치 힙만큼 좋다.
SSSP 요약과 다음 주제
| 그래프 | 가중치 | 알고리즘 | 실행 시간 \(O(\cdot)\) |
|---|---|---|---|
| 일반 | 가중치 없음 | BFS | \(\lvert V \rvert + \lvert E \rvert\) |
| DAG | 임의 | DAG Relaxation | \(\lvert V \rvert + \lvert E \rvert\) |
| 일반 | 음이 아님 | Dijkstra | \(\lvert V \rvert \log \lvert V \rvert + \lvert E \rvert\) |
| 일반 | 임의 | Bellman-Ford | \(\lvert V \rvert \cdot \lvert E \rvert\) |
모든 쌍 최단 경로(All-Pairs Shortest Paths)는 어떨까? 출력 크기가 \(O(\lvert V \rvert^2)\)이므로 SSSP 알고리즘을 \(\lvert V \rvert\)번 실행하는 것도 꽤 좋다. 음수 가중치가 있는 일반 그래프에서는 \(\lvert V \rvert \cdot O(\lvert V \rvert \cdot \lvert E \rvert)\)보다 잘할 수 있는데, 이것이 다음 강의의 주제다.
Recitation 연습: 감시 카메라
문제. 요원이 도시를 가로질러 정보원을 만나러 간다. 일부 도로에는 감시 카메라가 있고, 두 개 이상의 도로에서 카메라에 찍히면 붙잡힌다. 카메라에 많아야 한 번 찍히는 최단 경로를 구한다.
풀이. 교차로 \(v\)마다 정점 \((v, 0)\), \((v, 1)\)을 둔다. \((v, i)\)는 이미 \(i\)번 찍힌 상태로 \(v\)에 도착했음을 나타낸다. \(u\)에서 \(v\)로 가는 도로가 카메라에 보이지 않으면 \((u, 0) \to (v, 0)\)과 \((u, 1) \to (v, 1)\)을, 보이면 \((u, 0) \to (v, 1)\)만 넣는다. 가중치는 도로 길이(양수)다. \((s, 0)\)에서 Dijkstra를 실행해 \((t, 0)\) 또는 \((t, 1)\)까지의 최단 경로를 고른다. 교차로가 \(n\)개, 도로가 \(m\)개면 피보나치 힙으로 \(O(m + n \log n)\)이다. 도로망은 대개 평면적이거나 차수가 유계이므로 \(m = O(n)\)으로 보고 이진 힙으로 \(O(n \log n)\)에 풀어도 된다.
정리
- 간선 가중치가 음이 아니면 최단 경로를 따라 거리가 단조 증가하므로, 거리 순서대로 정점을 처리할 수 있다.
- Dijkstra는 \(d(s, u)\)가 최소인 정점 \(u\)를 꺼내 나가는 간선을 완화하고, 바뀐 추정값을
decrease_key로 반영하는 일을 반복한다. - 정점을 꺼내는 순간 \(d(s, v) = \delta(s, v)\)임을 귀납법으로 보이며, 이 증명에서 음이 아닌 가중치 가정이 핵심이다.
- 실행 시간은 \(O(B_{\lvert V \rvert} + \lvert V \rvert \cdot M_{\lvert V \rvert} + \lvert E \rvert \cdot D_{\lvert V \rvert})\)로, 배열이면 \(O(\lvert V \rvert^2)\), 이진 힙이면 \(O(\lvert E \rvert \log \lvert V \rvert)\), 피보나치 힙이면 \(O(\lvert E \rvert + \lvert V \rvert \log \lvert V \rvert)\)이다.
- 밀집 그래프에서는 배열, 희소 그래프에서는 이진 힙이 피보나치 힙만큼 좋으며, 이론 문제에서는 \(O(\lvert E \rvert + \lvert V \rvert \log \lvert V \rvert)\)를 쓴다.