- MIT 6.006 Introduction to Algorithms (Spring 2020) 9강 정리
- 강의: Erik Demaine, Jason Ku, Justin Solomon
- MIT OpenCourseWare, CC BY-NC-SA
- ▶ 강의 영상
- Recitation 9 notes (PDF)
새 단원: 그래프
1강부터 8강까지는 자료구조와 정렬을 다뤘다. 이번 강의부터 14강까지는 그래프 알고리즘을 다룬다.
그래프는 어디에나 있다. 도로망, 컴퓨터 네트워크, 소셜 네트워크처럼 연결로 이루어진 시스템은 곧바로 그래프가 된다. 또 이산 시스템의 상태 공간은 전이 그래프(transition graph)로 나타낼 수 있다. 체스, 테트리스, 루빅스 큐브 같은 퍼즐과 게임, 애플리케이션 작업 흐름과 명세 등이 그렇다.
그래프의 정의
그래프(graph) \(G = (V, E)\)는 정점(vertex) 집합 \(V\)와 정점 쌍의 집합 \(E \subseteq V \times V\)로 이루어진다.
- 방향 간선(directed edge) 은 순서쌍 \((u, v)\)다.
- 무방향 간선(undirected edge) 은 순서 없는 쌍 \(\{u, v\}\), 곧 \((u, v)\)와 \((v, u)\) 둘 다다.
이 수업에서는 모든 그래프가 단순(simple) 하다고 가정한다.
- 간선은 서로 다르다. 예를 들어 \((u, v)\)는 \(E\)에 한 번만 나온다(단, \((v, u)\)는 따로 있을 수 있다).
- 간선은 서로 다른 두 정점의 쌍이다. 모든 \((u, v) \in E\)에 대해 \(u \ne v\)다.
단순 그래프에서는 무방향이면 \(\lvert E \rvert \le \binom{\lvert V \rvert}{2}\), 방향이면 \(\lvert E \rvert \le 2\binom{\lvert V \rvert}{2}\)이므로 \(\lvert E \rvert = O(\lvert V \rvert^2)\)다.
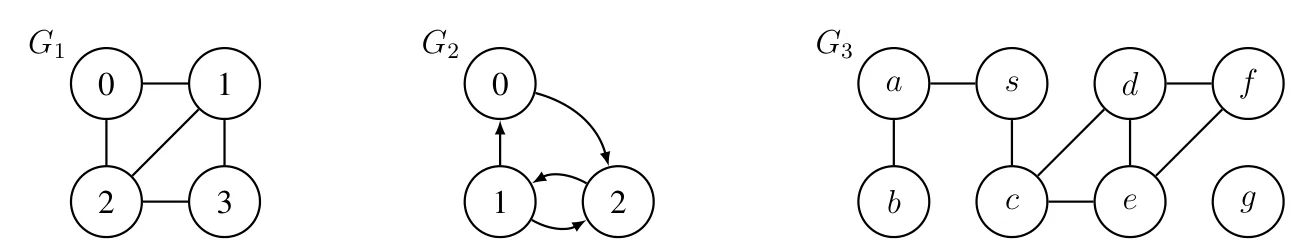 강의 노트의 예제 그래프 세 개. \(G_1\)과 \(G_3\)은 무방향 그래프이고, \(G_2\)는 화살표로 방향을 표시한 방향 그래프다. 출처: MIT 6.006 Lecture 9 notes (CC BY-NC-SA 4.0).
\(G_1\)은 정점 4개, 무방향 간선 5개(\(\{0,1\}, \{0,2\}, \{1,2\}, \{1,3\}, \{2,3\}\))다. 무방향이므로 간선 \(\{0, 1\}\)은 0에서 1로도, 1에서 0으로도 갈 수 있다. \(G_2\)는 정점 3개에 방향 간선 4개 \((0, 2), (1, 0), (1, 2), (2, 1)\)이 있다. 1과 2 사이에는 서로 반대 방향의 간선이 두 개 있는데, \((1, 2)\)와 \((2, 1)\)은 순서쌍으로서 다르므로 단순 그래프 조건(같은 간선이 두 번 나오지 않는다)에 어긋나지 않는다. 0에서는 2로 나가는 간선 하나뿐이므로 \(\deg^+(0) = 1\), 0으로 들어오는 간선은 1에서 오는 하나뿐이므로 \(\deg^-(0) = 1\)이다.
\(G_3\)은 정점에 문자 이름이 붙어 있고, 정점 \(g\)는 간선이 하나도 없다. \(g\)처럼 고립된 정점은 어떤 출발점에서도 도달할 수 없으므로, 뒤의 BFS 예제에서 거리 \(\infty\)로 남는다.
이웃 집합과 차수
- \(u \in V\)의 나가는 이웃 집합(outgoing neighbor set) 은 \(\text{Adj}^+(u) = \{v \in V \mid (u, v) \in E\}\)다.
- 들어오는 이웃 집합(incoming neighbor set) 은 \(\text{Adj}^-(u) = \{v \in V \mid (v, u) \in E\}\)다.
- 나가는 차수(out-degree) 는 \(\deg^+(u) = \lvert \text{Adj}^+(u) \rvert\), 들어오는 차수(in-degree) 는 \(\deg^-(u) = \lvert \text{Adj}^-(u) \rvert\)다.
- 무방향 그래프에서는 \(\text{Adj}^-(u) = \text{Adj}^+(u)\), \(\deg^-(u) = \deg^+(u)\)다.
- 위첨자를 생략하면 나가는 쪽을 뜻한다. 즉 \(\text{Adj}(u) = \text{Adj}^+(u)\), \(\deg(u) = \deg^+(u)\)다.
그래프 표현
그래프 \(G = (V, E)\)를 저장하려면 모든 \(u \in V\)에 대해 나가는 간선 \(\text{Adj}(u)\)를 저장하면 된다.
- 먼저 \(u\)를 \(\text{Adj}(u)\)로 대응시키는 집합 자료구조
Adj가 필요하다. 정점으로 빠르게 찾아야 하므로 보통 직접 접근 배열(direct access array)이나 해시 테이블(hash table)을 쓴다. - 각 \(u\)에 대해 \(\text{Adj}(u)\)를 또 다른 자료구조에 저장한다. 이것을 인접 리스트(adjacency list) 라 한다. 보통 순회만 필요하므로 배열이나 연결 리스트를 쓴다. (\(\text{Adj}(u)\)를 해시 테이블로 두면 간선 \((u, v) \in E\) 확인을 기대 \(O(1)\)에 할 수 있다.)
- 흔한 표현에서
Adj의 크기는 \(\Theta(\lvert V \rvert)\), 각 \(\text{Adj}(u)\)의 크기는 \(\Theta(\deg(u))\)다. - 악수 보조정리(handshaking lemma)에 의해 \(\sum_{u \in V} \deg(u) \le 2\lvert E \rvert\)이므로 그래프를 \(\Theta(\lvert V \rvert + \lvert E \rvert)\) 공간에 저장할 수 있다.
따라서 그래프 알고리즘에서 선형 시간은 그래프 크기에 선형인 \(\Theta(\lvert V \rvert + \lvert E \rvert)\)를 뜻한다.
예제 1, 2는 정점이 \(\{0, 1, \dots, \lvert V \rvert - 1\}\)로 이름 붙어 있어 Adj에 직접 접근 배열을, \(\text{Adj}(u)\)에 배열을 쓴다. 예제 3은 Adj에 해시 테이블을 쓴다.
G1 = [            # 예제 1 (무방향)
    [2, 1],       # 0
    [2, 0, 3],    # 1
    [1, 3, 0],    # 2
    [1, 2],       # 3
]

G2 = [            # 예제 2 (방향)
    [2],          # 0
    [2, 0],       # 1
    [1],          # 2
]

G3 = {            # 예제 3 (무방향)
    'a': ['s', 'b'],      'b': ['a'],
    's': ['a', 'c'],      'c': ['s', 'd', 'e'],
    'd': ['c', 'e', 'f'], 'e': ['c', 'd', 'f'],
    'f': ['d', 'e'],      'g': [],
}
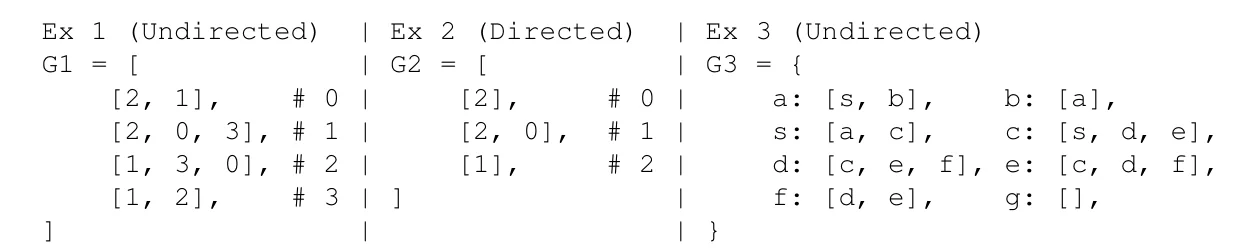 강의 노트의 인접 리스트 예. 세 그래프의 표현을 나란히 놓았고,
# 0, # 1 같은 주석은 그 줄이 어느 정점의 인접 리스트인지 나타낸다. 출처: MIT 6.006 Lecture 9 notes (CC BY-NC-SA 4.0).
앞의 그래프 그림과 맞춰 읽으면 표현 방식이 분명해진다. G1의 0번 줄 [2, 1]은 정점 0의 이웃이 2와 1이라는 뜻이고, 그림에서 0이 1, 2와 연결된 것과 일치한다. 리스트 안의 순서에는 의미가 없다. G2의 1번 줄 [2, 0]은 1에서 나가는 간선 \((1, 2)\), \((1, 0)\)이며, 1로 들어오는 간선 \((2, 1)\)은 2번 줄 [1]에 저장된다. 방향 그래프에서는 나가는 간선만 저장하므로 각 간선이 정확히 한 번 나타난다.
G3은 정점 이름이 문자라서 바깥 자료구조로 리스트 대신 딕셔너리(해시 테이블)를 쓴다. 고립된 정점 g도 빈 리스트 []로 반드시 들어 있어야 한다. 그래야 Adj의 크기가 \(\lvert V \rvert\)가 되고, 모든 정점을 순회할 수 있다. 각 표현의 전체 크기를 세어 보면 G1은 정점 4개와 리스트 원소 10개(\(= 2 \times 5\))로, 공간이 \(\Theta(\lvert V \rvert + \lvert E \rvert)\)임을 확인할 수 있다.
무방향 그래프에서는 연결이 대칭이므로 모든 간선이 나가는 간선으로 두 번 나타난다.
경로와 그래프 경로 문제
- 경로(path) 는 모든 \(1 \le i < k\)에 대해 \((v_i, v_{i+1}) \in E\)인 정점의 수열 \(p = (v_1, v_2, \dots, v_k)\)다.
- 정점을 반복하지 않는 경로를 단순 경로(simple path) 라 한다. (6.006의 “경로”는 6.042의 “walk”이고, 6.042의 “path”는 6.006의 단순 경로다.)
- 경로 \(p\)의 길이 \(\ell(p)\)는 경로에 있는 간선의 수다.
- \(u\)에서 \(v\)까지의 거리(distance) \(\delta(u, v)\)는 \(u\)에서 \(v\)로 가는 경로의 최소 길이, 곧 최단 경로의 길이다. 관례상 \(u\)에서 \(v\)로 갈 수 없으면 \(\delta(u, v) = \infty\)다.
경로에 관해 풀고 싶은 문제는 많다.
SINGLE_PAIR_REACHABILITY(G, s, t): \(G\)에 \(s\)에서 \(t\)로 가는 경로가 있는가?SINGLE_PAIR_SHORTEST_PATH(G, s, t): 거리 \(\delta(s, t)\)와 \(s\)에서 \(t\)로 가는 최단 경로 하나를 반환한다.SINGLE_SOURCE_SHORTEST_PATHS(G, s): 모든 \(v \in V\)에 대해 \(\delta(s, v)\)를 반환하고, \(s\)에서 모든 \(v\)로 가는 최단 경로를 담은 최단 경로 트리를 반환한다.
아래 문제는 위 문제보다 어렵거나 같다. 아래 문제를 푸는 블랙박스로 위 문제를 풀 수 있다. 이 강의에서는 가장 어려운 문제를 \(O(\lvert V \rvert + \lvert E \rvert)\)에 푸는 알고리즘 하나를 보인다.
최단 경로 트리
\(s\)에서 모든 정점으로 가는 최단 경로를 어떻게 반환할까? 많은 경로의 길이가 \(\Omega(\lvert V \rvert)\)일 수 있으므로, 경로를 모두 반환하면 \(\Omega(\lvert V \rvert^2)\) 시간이 들 수 있다.
대신 모든 \(v \in V\)에 대해 부모(parent) \(P(v)\), 곧 \(s\)에서 \(v\)로 가는 최단 경로에서 끝에서 두 번째 정점을 저장한다. \(P(s)\)는 없다(None). 부모들의 집합은 크기가 \(O(\lvert V \rvert)\)인 최단 경로 트리(shortest paths tree) 를 이룬다. \(s\)에서 도달 가능한 모든 정점에서 \(s\)로 거꾸로 돌아가는 최단 경로를 모은 것이다.
너비 우선 탐색 (BFS)
모든 \(v \in V\)에 대해 \(\delta(s, v)\)와 \(P(v)\)를 어떻게 계산할까? 둘 다 정점을 거리와 부모로 대응시키는 집합 자료구조에 저장한다. \(s\)에서 \(v\)로 가는 경로가 없으면 \(v\)를 \(P\)에 넣지 않고 \(\delta(s, v) = \infty\)로 둔다.
아이디어. 그래프의 정점을 거리가 증가하는 순서로 탐색한다.
목표. 거리 \(i\)에 있는 정점의 모임인 레벨 집합(level set) \(L_i = \{v \mid v \in V,\ \delta(s, v) = i\}\)를 계산한다.
- 주장. 모든 \(v \in L_i\)는 어떤 \(u \in L_{i-1}\)에 인접한다(즉 \(v \in \text{Adj}(u)\)). 최단 경로의 끝에서 두 번째 정점이 \(L_{i-1}\)에 있기 때문이다.
- 주장. \(j < i\)인 어떤 \(L_j\)에 있는 정점은 \(L_i\)에 나타나지 않는다.
- 불변식. \(j < i\)인 모든 \(L_j\)의 모든 \(v\)에 대해 \(\delta(s, v)\)와 \(P(v)\)가 올바르게 계산되어 있다.
- 기저. \(L_0 = \{s\}\), \(\delta(s, s) = 0\), \(P(s) = \text{None}\)이다.
- 귀납 단계. \(L_i\)를 계산하려면, \(L_{i-1}\)의 모든 정점 \(u\)에 대해, \(j < i\)인 어떤 \(L_j\)에도 나타나지 않은 모든 \(v \in \text{Adj}(u)\)를 \(L_i\)에 넣고 \(\delta(s, v) = i\), \(P(v) = u\)로 둔다.
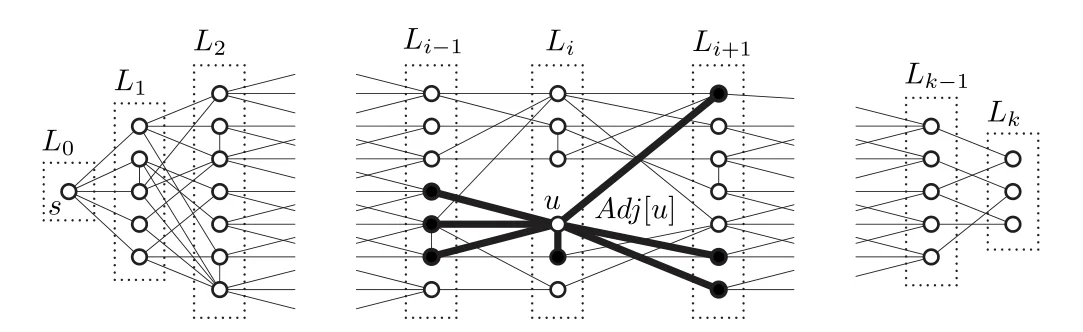 Recitation의 레벨 집합 그림. 점선 상자 하나가 레벨 \(L_i\)이고, 가운데에서는 \(L_i\)의 정점 \(u\)와 그 이웃 \(\text{Adj}[u]\)로 가는 간선을 굵게 표시했다. 출처: MIT 6.006 Recitation 9 notes (CC BY-NC-SA 4.0).
그림은 왼쪽에서 오른쪽으로 거리가 늘어나는 순서다. 맨 왼쪽 \(L_0\)에는 출발점 \(s\) 하나만 있고, \(L_1\)은 \(s\)에 바로 연결된 정점들, \(L_2\)는 \(L_1\)에서 한 걸음 더 간 정점들이다. 간선은 같은 레벨 안이나 이웃한 레벨 사이에만 그려져 있고, 두 레벨 이상 건너뛰는 간선은 없다. 만약 \(L_i\)의 정점에서 \(L_{i+2}\)의 정점으로 가는 간선이 있다면 그 정점의 거리는 \(i + 1\) 이하여야 하므로 모순이기 때문이다.
가운데 굵은 선은 귀납 단계 하나를 확대한 것이다. \(L_i\)의 정점 \(u\)를 처리할 때 \(\text{Adj}[u]\)의 이웃은 세 부류로 나뉜다. \(L_{i-1}\)(왼쪽 검은 점)과 \(L_i\)(같은 열의 검은 점)에 있는 이웃은 이미 레벨이 정해졌으므로 건너뛴다. 아직 레벨이 없는 이웃(오른쪽 \(L_{i+1}\)의 검은 점)만 \(L_{i+1}\)에 들어가고 부모가 \(u\)로 정해진다. 이렇게 레벨 하나를 완성할 때마다 탐색의 경계(frontier)가 한 열씩 오른쪽으로 이동한다.
\(L_i\)가 공집합이 될 때까지 \(i\)를 늘려 가며 \(L_i\)를 계산한다. 끝으로 \(\delta(s, v)\)가 정해지지 않은 모든 \(v\)에 \(\delta(s, v) = \infty\)를 둔다. 귀납법에 의해 BFS는 모든 \(\delta(s, v)\)와 \(P(v)\)를 올바르게 계산한다.
Recitation의 구현은 다음과 같다. 정점이 인덱스로 이름 붙은 인접 리스트를 받아 부모 배열을 반환한다(여기서는 parent[s] = s로 뿌리를 표시한다).
def bfs(Adj, s):                    # Adj: 인접 리스트, s: 출발 정점
    parent = [None for v in Adj]    # O(V) (이름이 없으면 해시 사용)
    parent[s] = s                   # O(1) 뿌리
    level = [[s]]                   # O(1) 레벨 초기화
    while 0 < len(level[-1]):       # 마지막 레벨에 정점이 있는 동안
        level.append([])            # O(1) 분할 상환, 새 레벨
        for u in level[-2]:         # 마지막으로 완성된 레벨을 순회
            for v in Adj[u]:        # O(Adj[u]) 이웃을 순회
                if parent[v] is None:   # 아직 부모가 없으면
                    parent[v] = u       # level[-2]의 u를 부모로
                    level[-1].append(v) # 다음 레벨에 추가
    return parent
실행 시간
- 각 \(L_i\)는 \(\Theta(\lvert L_i \rvert)\) 시간 순회와 \(O(1)\) 시간 삽입을 지원하는 자료구조(동적 배열이나 연결 리스트)에 저장한다.
- 정점 \(v\)가 \(j < i\)인 어떤 \(L_j\)에 있는지는 \(P\)에 \(v\)가 있는지로 확인한다.
- \(\delta\)와 \(P\)는 사전 연산을 \(O(1)\)에 지원하는 집합 자료구조(직접 접근 배열이나 해시 테이블)에 둔다.
- 각 정점 \(u\)는 최대 한 레벨에 추가되고, 각 \(v \in \text{Adj}(u)\)마다 \(O(1)\) 시간을 쓴다.
- 악수 보조정리에 의해 작업량은 \(O(1) \times \sum_{u \in V} \deg(u) = O(\lvert E \rvert)\)이다.
- 마지막에 도달할 수 없는 정점의 \(\delta(s, v)\)를 정하는 데 \(\Theta(\lvert V \rvert)\)가 든다.
따라서 BFS는 선형 시간 \(O(\lvert V \rvert + \lvert E \rvert)\)에 동작한다.
예제
예제 3의 그래프에서 \(s\)부터 BFS를 실행하면(인접 리스트 순서대로 처리) 다음과 같다.
| 레벨 | 정점 | 부모 |
|---|---|---|
| \(L_0\) | \(s\) | 없음 |
| \(L_1\) | \(a, c\) | \(P(a) = s\), \(P(c) = s\) |
| \(L_2\) | \(b, d, e\) | \(P(b) = a\), \(P(d) = c\), \(P(e) = c\) |
| \(L_3\) | \(f\) | \(P(f) = d\) |
| \(L_4\) | (공집합) |
\(g\)는 어느 레벨에도 들어가지 않으므로 \(\delta(s, g) = \infty\)다.
최단 경로 복원
BFS가 반환한 부모 포인터를 \(t\)에서 \(s\)까지 거꾸로 따라가면 \(s\)에서 \(t\)로 가는 최단 경로를 얻는다. 이것도 최악 \(O(\lvert V \rvert + \lvert E \rvert)\) 시간이다.
def unweighted_shortest_path(Adj, s, t):
    parent = bfs(Adj, s)            # O(V + E) s에서의 BFS 트리
    if parent[t] is None:           # t에 도달할 수 있는가?
        return None                 # 경로 없음
    i = t
    path = [t]
    while i != s:                   # O(V) s까지 거슬러 올라간다
        i = parent[i]
        path.append(i)
    return path[::-1]               # O(V) 뒤집어서 반환
Recitation 연습: 홀수 길이 최단 경로
문제. 가중치 없는 그래프 \(G = (V, E)\)에서 간선 수가 홀수인 \(s\)에서 \(t\)로 가는 최단 경로를 찾는다.
풀이. 새 그래프 \(G' = (V', E')\)를 만든다. \(V\)의 각 정점 \(u\)마다 두 정점 \(u_E\), \(u_O\)를 두는데, 각각 \(u\)에 짝수 개, 홀수 개의 간선으로 도달한 상태를 나타낸다. \(E\)의 각 간선 \((u, v)\)마다 \((u_E, v_O)\)와 \((u_O, v_E)\)를 \(E'\)에 넣는다. \(G'\)에서 \(s_E\)부터 BFS를 실행해 \(t_O\)까지의 최단 경로를 찾는다. \(G'\)는 짝수 정점과 홀수 정점 사이의 이분 그래프이므로 \(s_E\)에서 \(t_O\)로 가는 경로는 원래 그래프에서 홀수 길이 경로에 대응한다. \(G'\)는 정점 \(2\lvert V \rvert\)개, 간선 \(2\lvert E \rvert\)개이므로 구성과 BFS 모두 \(O(\lvert V \rvert + \lvert E \rvert)\)다.
이처럼 상태를 정점에 덧붙여 그래프를 복제하는 기법은 이후 강의(Bellman-Ford 등)에서도 반복해서 쓰인다.
정리
- 그래프 \(G = (V, E)\)는 정점과 간선(방향 또는 무방향)으로 이루어지며, 이 수업의 그래프는 단순 그래프라 \(\lvert E \rvert = O(\lvert V \rvert^2)\)다.
- 그래프는 정점을 인접 리스트로 대응시키는 집합
Adj로 저장하며, 크기는 \(\Theta(\lvert V \rvert + \lvert E \rvert)\)이다. 그래프에서 선형 시간은 \(\Theta(\lvert V \rvert + \lvert E \rvert)\)를 뜻한다. - 거리 \(\delta(u, v)\)는 최단 경로의 간선 수이며, 도달할 수 없으면 \(\infty\)다.
- 단일 출발점 최단 경로의 답은 거리와 부모 포인터로 이루어진 크기 \(O(\lvert V \rvert)\)의 최단 경로 트리로 표현한다.
- BFS는 레벨 집합 \(L_0, L_1, \dots\)를 차례로 계산하며, \(L_i\)는 \(L_{i-1}\)의 이웃 중 아직 어느 레벨에도 없는 정점들이다.
- BFS는 각 정점을 한 번, 각 간선을 상수 번 처리하므로 \(O(\lvert V \rvert + \lvert E \rvert)\)에 단일 출발점 최단 경로를 푼다.