- MIT 6.006 Introduction to Algorithms (Spring 2020) 8강 정리
- 강의: Erik Demaine, Jason Ku, Justin Solomon
- MIT OpenCourseWare, CC BY-NC-SA
- ▶ 강의 영상
- Recitation 8 notes (PDF)
우선순위 큐 인터페이스
우선순위 큐(priority queue) 는 많은 항목을 저장하면서 가장 중요한 항목에 빠르게 접근하거나 그것을 꺼내는 자료구조다. 쓰임새는 다양하다.
- 대역폭이 제한된 라우터가 특정 종류의 메시지를 먼저 처리할 때
- 운영체제 커널의 프로세스 스케줄링
- 이산 사건 시뮬레이션(다음에 일어날 사건이 무엇인가)
- 이후 강의에서 볼 그래프 알고리즘
항목은 키(key), 곧 우선순위로 정렬되므로 시퀀스(Sequence) 인터페이스가 아니라 집합(Set) 인터페이스에 속한다. 다만 집합 연산 중 일부에만 최적화되어 있다.
| 연산 | 의미 |
|---|---|
build(X) |
반복 가능한 X로 우선순위 큐를 만든다 |
insert(x) |
항목 x를 추가한다 |
delete_max() |
키가 가장 큰 항목을 제거하고 반환한다 |
find_max() |
키가 가장 큰 항목을 반환한다 |
보통 최댓값과 최솟값 중 하나에만 최적화한다. 핵심은 insert와 delete_max다. build는 insert를 반복하면 되고, find_max()는 delete_max()로 꺼낸 뒤 다시 insert하면 된다.
우선순위 큐 정렬
어떤 우선순위 큐든 정렬 알고리즘으로 바꿀 수 있다.
build(A): 예를 들어 입력 순서대로 항목을 하나씩 삽입한다.delete_max()(또는delete_min())를 반복해 역순(또는 정순)으로 정렬된 순서를 얻는다.
어려운 일은 모두 자료구조 안에서 일어난다. 실행 시간은 다음과 같다.
\[T_{\text{build}} + n \cdot T_{\text{delete\_max}} \le n \cdot T_{\text{insert}} + n \cdot T_{\text{delete\_max}}\]지금까지 본 정렬 알고리즘 상당수가 우선순위 큐 정렬로 볼 수 있다. 표의 (a)는 분할 상환(amortized) 시간이다.
| 자료구조 | build(A) |
insert(x) |
delete_max() |
정렬 시간 | 제자리? | 정렬 알고리즘 |
|---|---|---|---|---|---|---|
| 동적 배열 | \(n\) | \(1\) (a) | \(n\) | \(n^2\) | Y | 선택 정렬 |
| 정렬된 동적 배열 | \(n \log n\) | \(n\) | \(1\) (a) | \(n^2\) | Y | 삽입 정렬 |
| 집합 AVL 트리 | \(n \log n\) | \(\log n\) | \(\log n\) | \(n \log n\) | N | AVL 정렬 |
| 목표 | \(n\) | \(\log n\) (a) | \(\log n\) (a) | \(n \log n\) | Y | 힙 정렬 |
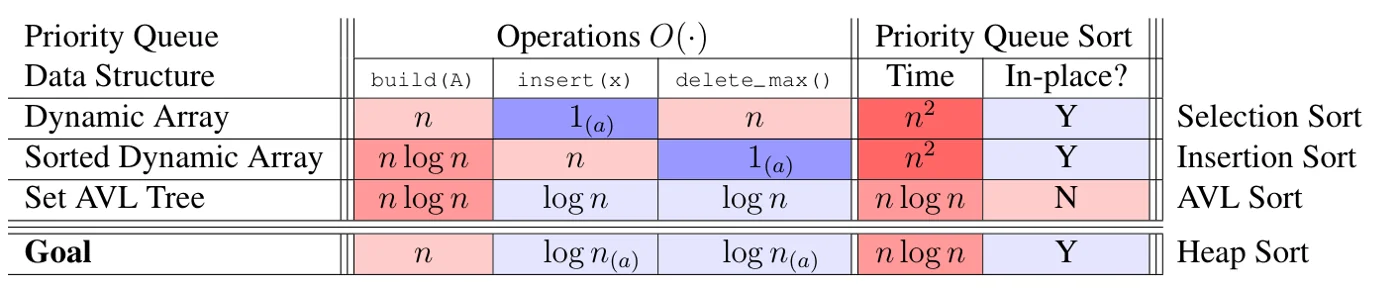 강의 노트의 우선순위 큐 정렬 표. 왼쪽 세 열은 우선순위 큐 연산의 비용, 가운데 두 열은 그것으로 만든 정렬의 시간과 제자리 여부, 오른쪽은 그 정렬의 이름이다. 출처: MIT 6.006 Lecture 8 notes (CC BY-NC-SA 4.0).
표의 각 행은 “연산 비용 → 정렬 시간”의 계산을 그대로 보여 준다. 정렬 시간은 build 한 번에 delete_max \(n\)번을 더한 값이다. 동적 배열 행은 \(n + n \cdot n = n^2\), 정렬된 동적 배열 행은 \(n \log n + n \cdot 1\)이지만 build를 insert 반복으로 하면 \(n \cdot n = n^2\)이 된다. 두 행은 붉은 칸의 위치가 서로 반대다. 앞은 delete_max가, 뒤는 insert가 느리다.
집합 AVL 트리 행은 두 연산이 모두 \(\log n\)이라 \(n \log n\)을 얻지만, 제자리 열이 N이다. 노드마다 포인터와 보강 값을 따로 저장해야 하기 때문이다. 굵은 목표 행은 AVL 트리의 시간을 유지하면서 배열 하나 안에서 모든 일을 끝내자는 것이고, 이를 달성하는 것이 이진 힙과 힙 정렬이다. 목표 행의 build가 \(n\)인 점도 눈여겨볼 만하다. 이는 뒤의 선형 시간 힙 구성에서 나온다.
집합 AVL 트리
집합 AVL 트리는 insert(x), find_min(), find_max(), delete_min(), delete_max()를 연산당 \(O(\log n)\)에 지원한다. 따라서 우선순위 큐 정렬은 \(O(n \log n)\)이고, 이는 사실상 7강의 AVL 정렬이다. 부분 트리 증강(subtree augmentation)으로 find_min()과 find_max()를 \(O(1)\)로 만들 수도 있다. 그러나 자료구조가 복잡하고, 결과 정렬은 제자리(in-place)가 아니다.
우선순위 큐만을 위한 더 단순한 자료구조, 그리고 제자리 \(O(n \log n)\) 정렬이 있을까? 있다. 이진 힙(binary heap) 과 힙 정렬(heap sort) 이다. 핵심은 이진 트리에서 배운 것을 이용해 시퀀스 자료구조(배열) 위에 집합 자료구조를 구현하는 것이다.
배열과 정렬된 배열
먼저 두 극단을 보자.
- 정렬되지 않은 동적 배열:
insert(x)는 끝에 덧붙이므로 분할 상환 \(O(1)\)이다.delete_max()는 최댓값을 \(O(n)\)에 찾아 끝 원소와 바꾼 뒤 제거한다. 삽입은 빠르고 삭제는 느리다. 우선순위 큐 정렬은 (복사를 빼면) 선택 정렬이 된다. - 정렬된 동적 배열:
insert(x)는 끝에 덧붙인 뒤 제자리로 바꿔 내려가므로 \(O(n)\)이다.delete_max()는 끝에서 지우므로 분할 상환 \(O(1)\)이다. 삭제는 빠르고 삽입은 느리다. 우선순위 큐 정렬은 삽입 정렬이 된다.
이 두 극단 사이의 절충안이 이진 힙이다.
배열을 완전 이진 트리로 보기
배열을 완전 이진 트리(complete binary tree) 로 해석한다. 깊이 \(i\)에는 최대 \(2^i\)개의 노드가 있고, 가장 깊은 층만 예외로 노드가 왼쪽부터 채워진다. 같은 말로, 완전 트리는 읽는 순서(뿌리에서 잎으로, 왼쪽에서 오른쪽으로)대로 빽빽하게 채워진다. 따라서 배열과 완전 이진 트리 사이에는 일대일 대응이 있다.
예를 들어 Q = [0, 1, 2, 3, 4, 5, 6, 7, 8, 9]는 다음 트리가 된다.
d0              0
d1        1           2
d2     3     4     5     6
d3    7 8   9
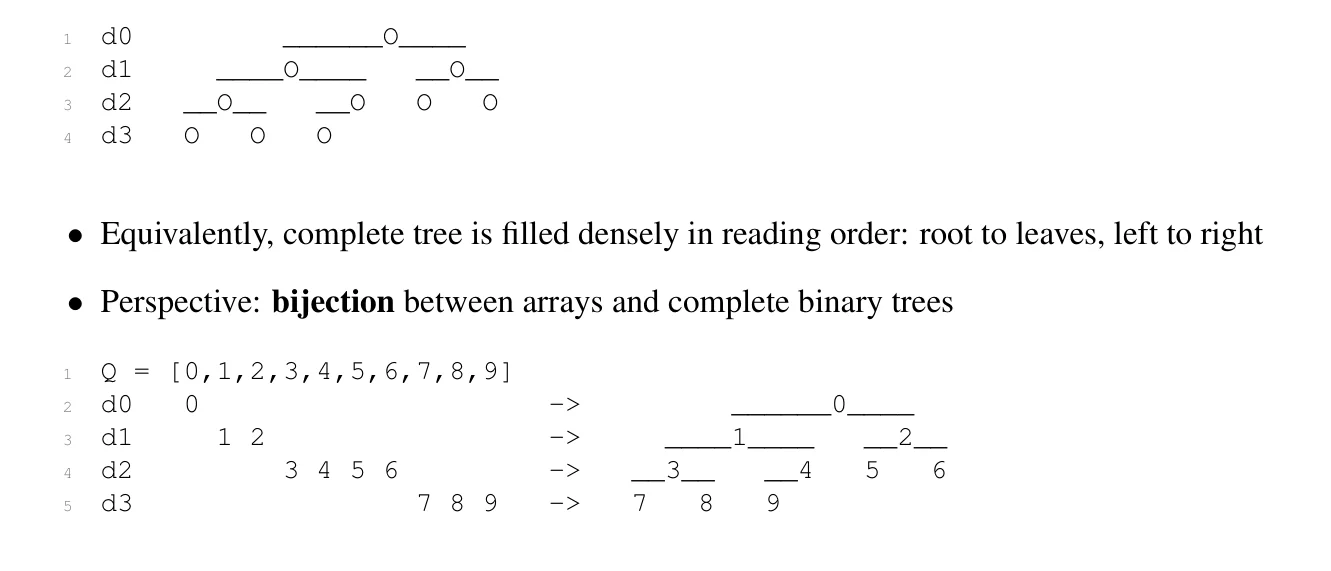 강의 노트의 완전 이진 트리 그림. 위는 깊이 d0부터 d3까지 노드가 채워지는 모양이고, 아래는 배열
Q의 인덱스를 깊이별로 끊어 트리에 대응시킨 것이다. 출처: MIT 6.006 Lecture 8 notes (CC BY-NC-SA 4.0).
위 그림에서 d0부터 d2까지는 노드가 1, 2, 4개로 꽉 차 있고, 마지막 층 d3만 노드 세 개가 왼쪽부터 붙어 있다. 완전 이진 트리라는 조건은 바로 이 모양, 즉 “마지막 층을 빼면 꽉 차 있고 마지막 층은 왼쪽으로 몰려 있다”는 것이다.
아래 그림은 이 모양 덕분에 배열과 트리가 일대일로 대응하는 방식을 보여 준다. 배열을 앞에서부터 길이 1, 2, 4, 8, …인 구간으로 자르면 각 구간이 한 층이 된다. Q[0]이 d0, Q[1..2]가 d1, Q[3..6]이 d2, Q[7..9]가 d3이다. 그림에서 노드 1의 자식이 3과 4, 노드 4의 자식이 9인 것을 보면 아래의 인덱스 공식 \(\text{left}(i) = 2i + 1\), \(\text{right}(i) = 2i + 2\)가 성립함을 바로 확인할 수 있다. 배열에 원소를 하나 덧붙이면 트리에서는 마지막 층의 다음 빈자리에 잎이 하나 생기므로, 모양이 항상 완전 이진 트리로 유지된다.
\(n\)개 항목의 배열을 완전 트리로 보면 높이는 \(\lceil \lg n \rceil\)이므로 균형 이진 트리다.
암묵적 완전 트리
완전 이진 트리 구조는 포인터를 저장하지 않고 암묵적(implicit) 으로 둘 수 있다. 뿌리는 인덱스 0에 있고, 이웃은 인덱스 계산으로 구한다.
\[\text{left}(i) = 2i + 1, \qquad \text{right}(i) = 2i + 2, \qquad \text{parent}(i) = \left\lfloor \frac{i - 1}{2} \right\rfloor\]Recitation의 구현은 계산한 인덱스가 배열 범위를 벗어나면 입력 인덱스를 그대로 돌려준다. 항상 유효한 인덱스를 반환하므로 이후 코드가 단순해진다.
def parent(i):
    p = (i - 1) // 2
    return p if 0 < i else i

def left(i, n):
    l = 2 * i + 1
    return l if l < n else i

def right(i, n):
    r = 2 * i + 2
    return r if r < n else i
이진 힙
아이디어는 큰 원소를 트리의 위쪽에 두되, 국소적으로만 그렇게 하는 것이다.
- 노드 \(i\)에서의 최대 힙 성질(max-heap property): \(j \in \{\text{left}(i), \text{right}(i)\}\)에 대해 \(Q[i] \ge Q[j]\)
- 최대 힙(max-heap) 은 모든 노드에서 최대 힙 성질을 만족하는 배열이다.
주장. 최대 힙에서 모든 노드 \(i\)는 \(\text{subtree}(i)\)의 모든 노드 \(j\)에 대해 \(Q[i] \ge Q[j]\)를 만족한다.
증명. \(d = \text{depth}(j) - \text{depth}(i)\)에 대한 귀납법이다.
- 기저: \(d = 0\)이면 \(i = j\)이므로 \(Q[i] \ge Q[j]\)다(사실 같다).
- 귀납: \(\text{depth}(\text{parent}(j)) - \text{depth}(i) = d - 1 < d\)이므로 귀납 가정에 의해 \(Q[i] \ge Q[\text{parent}(j)]\)다. 또 \(\text{parent}(j)\)에서의 최대 힙 성질에 의해 \(Q[\text{parent}(j)] \ge Q[j]\)다.
특히 최댓값은 최대 힙의 뿌리에 있다.
힙 삽입
- 새 항목 \(x\)를 배열 끝에 분할 상환 \(O(1)\)로 덧붙인다. 이것은 읽는 순서로 다음 잎 \(i\)가 된다.
max_heapify_up(i): 최대 힙 성질이 성립할 때까지 부모와 바꾼다.- \(Q[\text{parent}(i)] \ge Q[i]\)인지 확인한다(\(\text{parent}(i)\)에서의 최대 힙 성질의 일부다).
- 아니라면 \(Q[i]\)와 \(Q[\text{parent}(i)]\)를 바꾸고
max_heapify_up(parent(i))를 재귀 호출한다.
정확성. 최대 힙 성질 덕분에 모든 노드는 자손 이상이다. 단 하나의 예외는 \(Q[i]\)가 일부 조상보다 클 수 있다는 점이다(\(i\)가 뿌리면 끝난다). 교환이 필요하면, 교환 후에는 같은 보장이 \(Q[i]\) 대신 \(Q[\text{parent}(i)]\)에 대해 성립한다.
실행 시간. 트리의 높이만큼이므로 \(\Theta(\log n)\)이다.
힙 최댓값 삭제
동적 배열에서는 마지막 원소만 쉽게 지울 수 있는데, 최대 키는 뿌리에 있다. 그래서 뿌리 \(i = 0\)의 항목과 마지막 노드 \(n - 1\)의 항목을 바꾼 뒤 끝에서 제거한다.
max_heapify_down(i): 최대 힙 성질이 성립할 때까지 더 큰 자식과 바꾼다.
- \(j \in \{\text{left}(i), \text{right}(i)\}\)에 대해 \(Q[i] \ge Q[j]\)인지 확인한다(\(i\)에서의 최대 힙 성질).
- 아니라면 키가 더 큰 자식 \(j\)와 \(Q[i]\)를 바꾸고
max_heapify_down(j)를 재귀 호출한다.
정확성. 모든 노드는 자손 이상이되, \(Q[i]\)만 일부 자손보다 작을 수 있다(\(i\)가 잎이면 끝난다). 교환이 필요하면, 교환 후에는 같은 보장이 \(Q[i]\) 대신 \(Q[j]\)에 대해 성립한다.
실행 시간. 역시 트리 높이만큼이므로 \(\Theta(\log n)\)이다.
Recitation의 구현은 다음과 같다. 두 함수 모두 A[:n]에서 노드 하나를 빼고는 최대 힙 성질이 성립한다고 가정한다.
def max_heapify_up(A, n, c):          # T(c) = O(log c)
    p = parent(c)                     # 부모 인덱스 (뿌리면 c 자신)
    if A[p].key < A[c].key:           # 부모가 더 작으면
        A[c], A[p] = A[p], A[c]       # 부모와 교환
        max_heapify_up(A, n, p)       # 부모에서 재귀

def max_heapify_down(A, n, p):        # T(p) = O(log n - log p)
    l, r = left(p, n), right(p, n)    # 자식 인덱스 (없으면 p 자신)
    c = l if A[r].key < A[l].key else r   # 더 큰 자식
    if A[p].key < A[c].key:           # 자식이 더 크면
        A[c], A[p] = A[p], A[c]       # 자식과 교환
        max_heapify_down(A, n, c)     # 자식에서 재귀
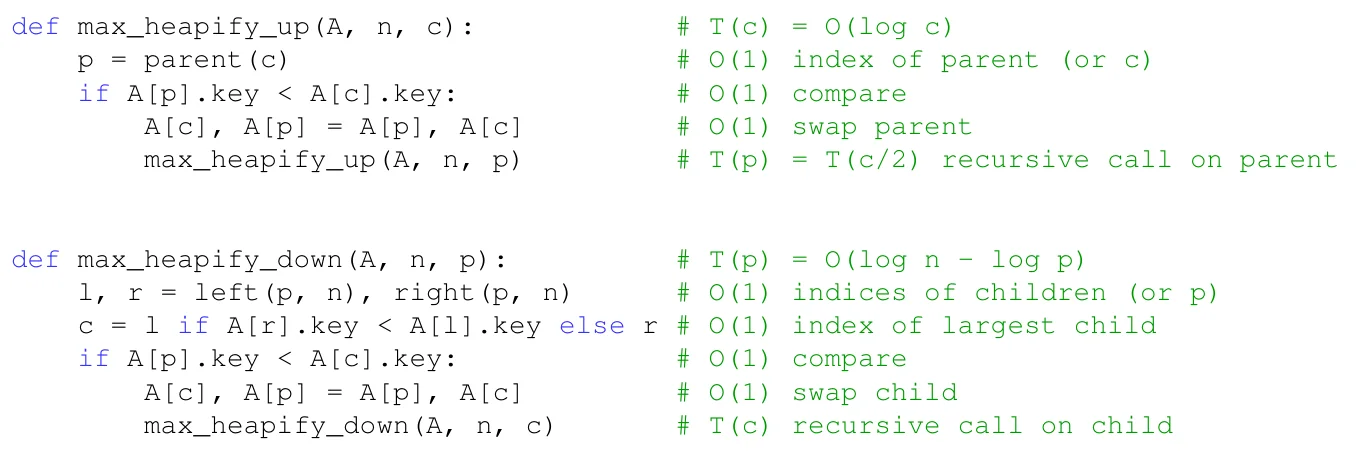 Recitation의
max_heapify_up과 max_heapify_down 원본 코드. 오른쪽 주석이 각 줄의 비용과 역할, 그리고 재귀 호출의 점화식을 적고 있다. 출처: MIT 6.006 Recitation 8 notes (CC BY-NC-SA 4.0).
두 함수의 점화식 주석이 실행 시간을 설명한다. max_heapify_up은 인덱스 \(c\)에서 시작해 부모 \(p \approx c/2\)로 재귀하므로 T(c) = T(c/2) + O(1)이고, 인덱스가 절반씩 줄어 \(O(\log c)\)번 만에 뿌리에 닿는다. max_heapify_down은 반대로 \(p\)에서 자식 \(\approx 2p\)로 내려가며, 인덱스가 \(n\)을 넘으면 멈추므로 \(O(\log n - \log p)\), 즉 노드 \(p\)의 높이만큼이다. 이 차이, 곧 위로 갈 때는 깊이에, 아래로 갈 때는 높이에 비례한다는 점이 뒤의 선형 시간 힙 구성의 열쇠다.
작은 예로 max_heapify_down을 따라가 보자. 키가 [2, 9, 7, 5, 8]이면 뿌리 2만 힙 성질을 어긴다. 자식 9와 7 중 큰 9(인덱스 1)와 바꾸면 [9, 2, 7, 5, 8]이 되고, 인덱스 1에서 다시 자식 5와 8 중 큰 8(인덱스 4)과 바꾸면 [9, 8, 7, 5, 2]가 된다. 인덱스 4는 잎이므로 left와 right가 자기 자신을 돌려주고, 비교가 거짓이 되어 멈춘다.
힙 정렬
최대 힙을 우선순위 큐 정렬에 넣으면 새로운 정렬 알고리즘인 힙 정렬을 얻는다. insert와 delete_max가 각각 \(O(\log n)\)이므로 실행 시간은 \(O(n \log n)\)이다. 여기에 보통 두 가지 개선을 더한다. 제자리 정렬과 선형 시간 힙 구성이다.
제자리 우선순위 큐 정렬
- 최대 힙 \(Q\)를 더 큰 배열 \(A\)의 접두부(prefix)로 두고, 힙에 속한 항목 수 \(\lvert Q \rvert\)만 기억한다.
- \(\lvert Q \rvert\)는 처음에 0이고, 삽입을 마치면 \(\lvert A \rvert\)가 되며, 삭제를 마치면 다시 0이 된다.
insert()는 인덱스 \(\lvert Q \rvert\)에 있는 다음 항목을 힙으로 흡수한다.delete_max()는 최대 항목을 끝으로 옮긴 뒤 \(\lvert Q \rvert\)를 줄여 그 항목을 버린다.
이 틀로 보면 배열을 쓴 제자리 우선순위 큐 정렬은 정확히 선택 정렬이고, 정렬된 배열을 쓰면 정확히 삽입 정렬이며, 이진 최대 힙을 쓰면 힙 정렬이다. 이 방식은 모든 삽입이 모든 삭제보다 먼저 일어나는 우선순위 큐 정렬에서만 통한다.
아래 프로그램은 다음 절의 선형 힙 구성까지 포함한 제자리 힙 정렬이다.
def heap_sort(A):
    n = len(A)
    for i in range(n // 2, -1, -1):   # O(n) 선형 힙 구성 (잎은 건너뜀)
        max_heapify_down(A, n, i)
    for k in range(n - 1, 0, -1):     # delete_max를 n - 1번
        A[0], A[k] = A[k], A[0]       # 최댓값을 힙의 끝으로 보낸다
        max_heapify_down(A, k, 0)     # 크기 k인 접두부에서 힙 성질 복구
    return A
선형 시간 힙 구성
\(n\)개 항목을 힙에 하나씩 삽입하면 \(i = 0\)부터 \(n - 1\)까지(뿌리부터 아래로) max_heapify_up(i)를 부른다. 최악의 교환 횟수는 다음과 같다.
아이디어. 처음부터 배열 전체를 완전 이진 트리로 보고, \(i = n - 1\)부터 \(0\)까지(잎에서 위로) max_heapify_down(i)를 부른다. 그러면 처리한 노드들은 항상 최대 힙 성질을 만족한다. 최악의 교환 횟수는 각 노드의 높이의 합이다. 스털링 근사 \(n! = \Theta(\sqrt{n} (n/e)^n)\)을 쓰면 다음과 같다.
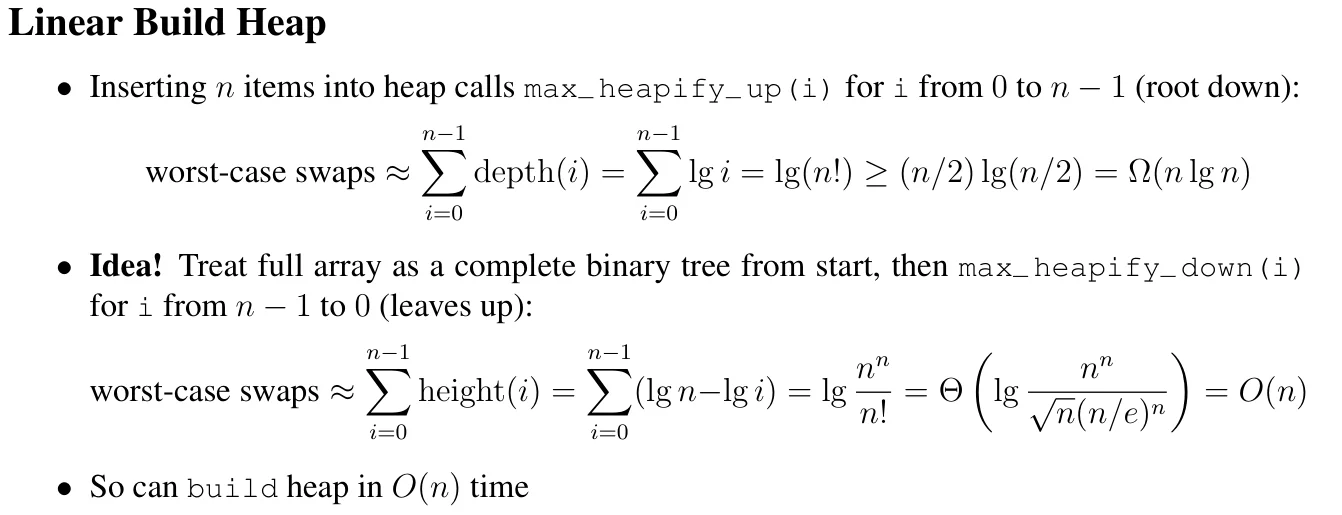 강의 노트의 선형 시간 힙 구성. 위 식은 뿌리부터
max_heapify_up으로 삽입할 때, 아래 식은 잎부터 max_heapify_down을 할 때의 최악 교환 횟수다. 출처: MIT 6.006 Lecture 8 notes (CC BY-NC-SA 4.0).
두 식의 차이는 합하는 대상이 깊이냐 높이냐뿐이다. 완전 이진 트리에서 노드의 대부분은 아래쪽에 있다. 잎이 약 \(n/2\)개, 그 위층이 \(n/4\)개, 이런 식이다. 위에서부터 삽입하면 이 많은 아래쪽 노드가 각각 깊이 \(\approx \lg n\)만큼 올라갈 수 있으므로 합이 \(\Omega(n \lg n)\)이 된다.
아래에서부터 max_heapify_down을 하면 같은 아래쪽 노드들의 비용이 높이, 즉 거의 0이다. 높이 \(k\)인 노드는 약 \(n / 2^{k+1}\)개이므로 합은 \(\sum_k k \cdot n / 2^{k+1} \le n \sum_k k / 2^{k+1} = O(n)\)이다. 노트의 식은 같은 결론을 높이를 \(\lg n - \lg i\)로 근사하고 스털링 근사를 써서 얻은 것이다. 비싼 연산(긴 경로)을 하는 노드가 적은 쪽, 즉 위쪽에 몰리도록 순서를 뒤집은 것이 핵심이다.
따라서 힙은 \(O(n)\)에 만들 수 있다. 배열 뒤쪽 절반은 모두 잎이므로 실제로는 \(\lfloor n/2 \rfloor\)부터 시작하면 된다. 다만 \(n\)번의 delete_max가 여전히 각각 \(O(\log n)\)이므로, 힙 정렬 전체의 \(O(n \lg n)\)은 빨라지지 않는다.
시퀀스 AVL 트리 우선순위 큐
다른 연산은 로그 시간인데 구성만 선형 시간인 자료구조를 어디서 봤을까? 시퀀스 AVL 트리(Sequence AVL Tree)다.
- 우선순위 큐의 항목을 시퀀스 AVL 트리에 임의의 순서(예: 삽입 순서)로 저장한다.
- 최댓값(과/또는 최솟값) 증강을 유지한다.
node.max는 그 노드의 부분 트리에서 키가 가장 큰 노드를 가리킨다. 이는 부분 트리 성질(subtree property)이므로 상수배 비용으로 유지된다. find_min()과find_max()는 \(O(1)\),delete_min()과delete_max()는 \(O(\log n)\),build(A)는 \(O(n)\)이다.
이진 힙과 같은 성능(그리고 그 이상)을 낸다.
집합과 다중집합
지금까지의 집합 인터페이스는 중복 키가 없다고 가정했다. 그래도 이 집합들로 중복 키를 허용하는 다중집합(multiset) 을 구현할 수 있다. 집합의 각 항목을 같은 키를 가진 다중집합 항목들을 담는 시퀀스(예: 연결 리스트)로 만들고, 그 시퀀스의 키를 공통 키로 두면 된다.
사실 이런 환원 없이도, 이진 힙과 AVL 트리는 중복 키 항목에 그대로 쓸 수 있다(예: delete_max는 최대 키를 가진 항목 중 하나를 지운다). 이때 집합 AVL 트리의 \(<\) 대신 \(\le\) 조건을 쓰도록 주의하면 된다.
Recitation 연습 문제
- 최대 힙에서 최솟값 찾기. 최대 힙은 최솟값의 위치에 대해 자식이 없다는 것 외에는 아무것도 보장하지 않는다. 따라서 \(n/2\)개의 잎을 모두 살펴야 하며 \(\Omega(n)\) 시간이 든다.
- 최대 힙을 최소 힙으로 바꾸기. 최소 힙 성질을 강제하도록 바꾼
build_max_heap을 원래 힙에 실행하면 선형 시간이다. 원래 최대 힙이었다는 사실이 시간을 줄여 주지는 않는다. - \(k\)-근접 정렬. 서로 다른 정수 배열의 모든 원소가 정렬 후 위치에서 최대 \(k\)칸 떨어져 있으면 \(k\)-근접(k-proximate)이라 한다. 삽입 정렬은 각 원소를 \(O(k)\)번만 교환하므로 \(O(nk)\)에 정렬한다. 더 나아가 크기 \(k + 1\)의 최소 힙을 쓰면 \(O(n \log k)\)에 정렬할 수 있다.
A[0..k-1]로 최소 힙 \(H\)를 만든 뒤, 다음 항목을 삽입하고H.delete_min()을 출력의 다음 칸에 쓰는 일을 반복한다. \(i\)번째로 작은 원소는A[0..i+k]안에 있으므로, 그 값을 쓸 차례에는 이미 힙에 들어와 있고 더 작은 값은 모두 빠져 있다. 힙 연산은 각각 \(O(\log k)\)다.
정리
- 우선순위 큐는
build,insert,delete_max,find_max를 지원하는 집합 인터페이스이며, 어떤 우선순위 큐든 우선순위 큐 정렬로 정렬 알고리즘이 된다. 배열은 선택 정렬, 정렬된 배열은 삽입 정렬, 집합 AVL 트리는 AVL 정렬에 대응한다. - 배열을 완전 이진 트리로 해석하면 \(\text{left}(i) = 2i + 1\), \(\text{right}(i) = 2i + 2\), \(\text{parent}(i) = \lfloor (i - 1)/2 \rfloor\)로 포인터 없이 탐색하며, 높이는 \(\lceil \lg n \rceil\)이다.
- 최대 힙은 모든 노드에서 \(Q[i] \ge\) 자식 키를 만족하는 배열이며, 이로부터 각 노드가 부분 트리 전체 이상이고 최댓값이 뿌리에 있음이 따른다.
- 삽입은 끝에 붙이고
max_heapify_up, 최댓값 삭제는 뿌리와 끝을 바꾸고max_heapify_down을 하며, 둘 다 \(\Theta(\log n)\)이다. - 힙을 배열의 접두부로 유지하면 힙 정렬은 제자리 \(O(n \log n)\) 정렬이 된다.
- 잎에서 위로
max_heapify_down을 하면 힙을 \(O(n)\)에 구성할 수 있다. 시퀀스 AVL 트리에 최댓값 증강을 더해도 같은 성능을 얻는다.