- MIT 6.006 Introduction to Algorithms (Spring 2020) 4강 정리
- 강의: Erik Demaine, Jason Ku, Justin Solomon
- MIT OpenCourseWare, CC BY-NC-SA
- ▶ 강의 영상
- Recitation 4 notes (PDF)
복습
지금까지의 집합 자료구조는 다음과 같다(\(O(\cdot)\)).
| 자료구조 | build(X) |
find(k) |
insert(x), delete(k) |
find_min(), find_max() |
find_prev(k), find_next(k) |
|---|---|---|---|---|---|
| 배열 | \(n\) | \(n\) | \(n\) | \(n\) | \(n\) |
| 정렬된 배열 | \(n \log n\) | \(\log n\) | \(n\) | \(1\) | \(\log n\) |
탐색과 동적 연산을 더 빠르게 하고 싶다. find(k)를 \(\Theta(\log n)\)보다 빠르게 할 수 있는가? 답은 “아니다”(하한이 있다)이다. 그런데 실제로는 “된다”이기도 하다. 이 모순을 푸는 것이 이번 강의의 내용이다.
비교 모델
비교 모델(comparison model) 에서는 알고리즘이 항목을 비교로만 구별할 수 있다고 가정한다.
- 비교 가능한 항목(comparable items): 두 항목 사이의 비교만 지원하는 블랙박스다.
- 비교는 \(<, \le, >, \ge, =, \ne\)이고, 결과는 True 또는 False의 이진값이다.
- 목표: 비교 가능한 항목 \(n\)개의 집합을 저장하고
find(k)를 지원한다. - 실행 시간은 수행한 비교 횟수 이상이므로, 비교 횟수를 센다.
결정 트리
모든 알고리즘은 수행하는 연산의 결정 트리(decision tree) 로 볼 수 있다.
- 내부 노드는 이진 비교를 나타내고, True 또는 False로 갈라진다.
- 비교 알고리즘이라면 결정 트리는 이진 트리다.
- 잎은 알고리즘의 종료를 나타내며, 알고리즘의 출력이 된다.
- 루트에서 잎까지의 경로 하나는 어떤 입력에 대한 알고리즘의 한 실행이다.
- 가능한 출력마다 잎이 적어도 하나 있어야 한다. 탐색의 출력은 저장된 항목 \(n\)개와 “없음”이므로 잎이 \(n+1\)개 이상 필요하다.
비교 탐색의 하한
비교 탐색 알고리즘의 최악 실행 시간은 얼마인가?
실행 시간은 비교 횟수 이상이고, 비교 횟수는 루트에서 잎까지 가는 경로의 최대 길이 이상이며, 이는 곧 트리의 높이다.
노드가 \(n\)개 이상인 이진 트리의 최소 높이는 얼마인가? 높이가 최소가 되는 것은 트리가 완전할(마지막 층을 빼고 모든 층이 꽉 찰) 때다. 높이 \(h\)인 이진 트리의 노드는 최대 \(2^{h+1} - 1\)개다(높이에 대한 귀납법, \(T(h) = 2T(h-1) + 1\)). 따라서
\[h \ge \lceil \lg(n+1) \rceil - 1 = \Omega(\log n)\]이고, 비교 탐색 알고리즘의 실행 시간은 \(\Omega(\log n)\)이다. 정렬된 배열은 이 하한을 달성한다.
더 일반적으로, 잎이 \(\Theta(n)\)개이고 최대 분기 계수(branching factor)가 \(b\)인 트리의 높이는 \(\Omega(\log_b n)\)이다. 분기 계수가 2가 아니라 어떤 상수여도 \(\Omega(\log n)\)은 그대로다. 더 빨라지려면 상수보다 큰 \(\omega(1)\)의 분기 계수를 갖는 연산이 필요하다. 어떻게?
직접 접근 배열
Word-RAM은 \(O(1)\) 시간의 임의 접근 인덱싱(random access) 을 지원한다. 메모리 주소 하나를 읽는 것은 메모리 크기만큼 분기하는 것과 같으므로, 선형 분기 계수를 얻는다.
아이디어: 각 항목에 \(\{0, \ldots, u-1\}\) 범위의 고유한 정수 키 \(k\)를 주고, 항목을 배열의 인덱스 \(k\)에 저장한다. 배열의 각 인덱스에 의미를 부여하는 것이다. 이를 직접 접근 배열(direct access array) 이라 한다.
class DirectAccessArray:
    def __init__(self, u): self.A = [None] * u     # O(u)
    def find(self, k):     return self.A[k]        # O(1)
    def insert(self, x):   self.A[x.key] = x       # O(1)
    def delete(self, k):   self.A[k] = None        # O(1)
    def find_next(self, k):                        # O(u)
        for i in range(k, len(self.A)):
            if self.A[i] is not None:
                return self.A[i]
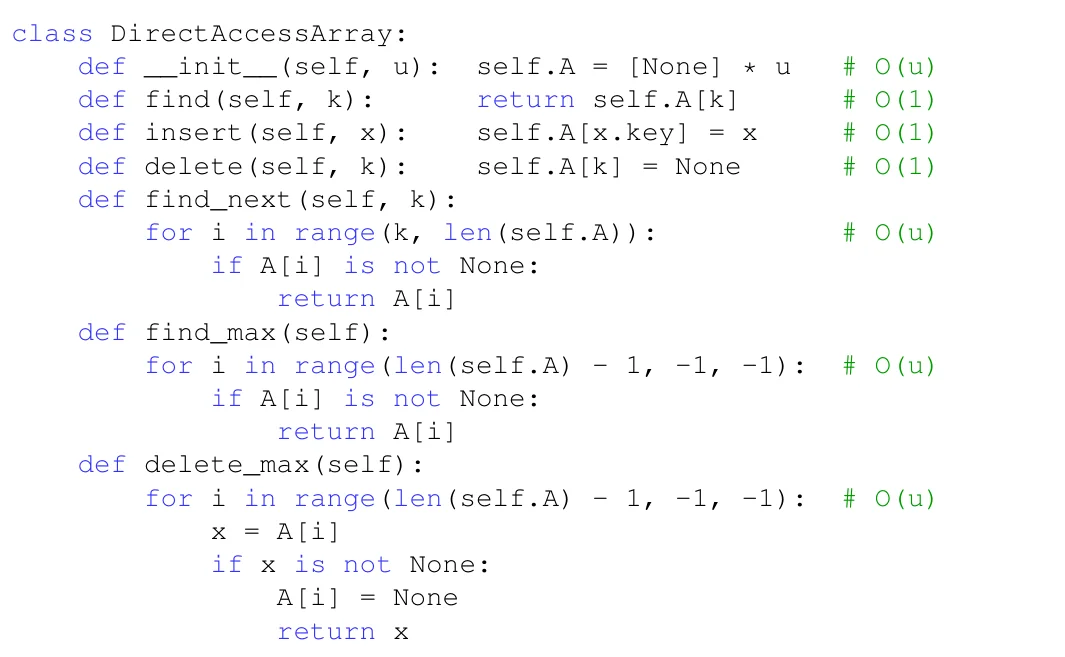 Recitation의 직접 접근 배열 전체 코드. 위 네 줄의 기본 연산은
O(1)이지만, 아래 세 순서 연산은 배열을 훑는 반복문이 있어 O(u)다. 출처: MIT 6.006 Recitation 4 notes (CC BY-NC-SA 4.0).
코드를 두 부분으로 나누어 읽으면 직접 접근 배열의 장단점이 그대로 보인다. 위쪽의 find, insert, delete는 모두 self.A[k]처럼 인덱스 하나를 읽거나 쓰는 한 줄이다. 키가 곧 주소이므로 비교도 탐색도 필요 없다. 생성자 __init__만 크기 \(u\)의 배열을 만드느라 O(u)가 든다.
아래쪽의 find_next(k)는 인덱스 \(k\)부터 끝까지, find_max와 delete_max는 끝에서부터 거꾸로, 처음으로 비어 있지 않은 칸을 만날 때까지 훑는다. 예를 들어 \(u = 1000\)인데 저장된 키가 3과 998뿐이면, find_next(4)는 994칸을 확인한 뒤에야 998을 찾는다. 저장된 항목 수 \(n\)이 아니라 키 범위 \(u\)에 비례하는 이유다.
- 키가 기계 워드에 들어가면, 즉 \(u \le 2^w\)이면
find와 동적 연산이 최악 \(O(1)\)이다. - 6.006에서는 길이가 명시적으로 매개변수화되지 않는 한, 입력 수나 문자열이 워드 하나에 들어간다고 가정한다.
- 컴퓨터 메모리의 모든 것은 이진 정수이므로 정수 키로 볼 수 있다. 아니면 (정적) 64비트 메모리 주소를 써도 된다.
- 순서 연산은 어디에 다음 항목이 있는지 모르므로 \(O(u)\)가 걸린다.
문제는 공간이 \(O(u)\)라는 것이다. \(n \ll u\)이면 아주 나쁘다. 예를 들어 키가 열 글자 이름이면 이름마다 1비트만 써도 \(26^{10}\)비트, 약 17.6 TB가 필요하다. 공간을 어떻게 줄일까?
해싱
아이디어: \(n \ll u\)이면 키를 더 작은 범위 \(m = \Theta(n)\)으로 사상하고, 더 작은 직접 접근 배열을 쓴다.
- 해시 함수(hash function) \(h(k) : \{0, \ldots, u-1\} \to \{0, \ldots, m-1\}\) (hash map이라고도 한다)
- 이때 직접 접근 배열을 해시 테이블(hash table) 이라 하고, \(h(k)\)를 키 \(k\)의 해시(hash) 라 한다.
- \(m \ll u\)이면 비둘기집 원리에 의해 어떤 해시 함수도 단사(injective)가 아니다.
- 따라서 \(h(a) = h(b)\)인 키 \(a, b\)가 항상 존재한다. 이를 충돌(collision) 이라 한다.
같은 인덱스에 두 항목을 저장할 수는 없으니 어디에 저장해야 할까? 두 가지 방법이 있다.
- 배열의 다른 곳에 저장한다(개방 주소법, open addressing). 분석은 복잡하지만 흔하고 실용적이다.
- 동적 집합 인터페이스를 지원하는 다른 자료구조에 저장한다(체이닝, chaining).
체이닝
아이디어: 충돌한 항목을 다른 자료구조, 즉 체인(chain) 에 저장한다. 해시 테이블의 각 인덱스는 체인을 가리킨다. 체인은 find, insert, delete를 지원하면 무엇이든 되고, 보통 연결 리스트나 동적 배열을 쓴다.
- 항목 \(x\)를 삽입하려면 인덱스 \(h(x.\text{key})\)의 체인에 삽입한다.
- 키 \(k\)를 찾거나 삭제하려면 인덱스 \(h(k)\)의 체인에서 찾거나 삭제한다.
키가 인덱스에 대략 고르게 퍼지면 체인 크기는 \(n/m = n/\Omega(n) = O(1)\)이고, 체인이 \(O(1)\) 크기면 모든 연산이 \(O(1)\)이다. 하지만 그렇지 않으면 많은 항목이 같은 위치로 갈 수 있다. 예를 들어 \(h(k)\)가 상수 함수이면 체인 크기가 \(\Theta(n)\)이 된다. 좋은 해시 함수가 필요하다.
해시 함수
나눗셈 방법 (나쁨)
\[h(k) = k \bmod m\]- 휴리스틱이다. 키가 균일하게 분포하면 좋다.
- \(m\)은 저장되는 키의 대칭성(예: 모든 키의 나머지가 같은 경우)을 피해야 한다. 2와 10의 거듭제곱에서 먼 큰 소수가 무난하다.
- Python은 이 방법에 추가적인 섞기(mixing)를 더한 변형을 쓴다.
- 하지만 \(u \gg n\)이면 어떤 고정된 해시 함수든 크기 \(O(n)\) 체인을 만드는 입력 집합이 존재한다. Recitation에 따르면 \(u > nm\)이면 비둘기집 원리에 의해 같은 해시로 가는 키 \(n\)개가 반드시 있다.
아이디어: 해시 함수를 고정하지 말고, 무작위로(하지만 신중하게) 고른다.
범용 해싱 (이론적으로 좋음)
\[h_{ab}(k) = \bigl( (ak + b) \bmod p \bigr) \bmod m\]- 해시 함수족 \(\mathcal{H}(p, m) = \{ h_{ab} \mid a, b \in \{0, \ldots, p-1\},\ a \ne 0 \}\)
- \(p > u\)인 소수 \(p\)를 고정하고, \(a\)와 \(b\)를 \(\{0, \ldots, p-1\}\)에서 고른다.
- \(\mathcal{H}\)는 범용(universal) 함수족이다. 즉 서로 다른 모든 키 쌍에 대해 다음이 성립한다(증명은 6.046에서 다룬다).
여기서 확률은 해시 함수를 무작위로 고르는 것에 대한 것이지, 입력 키의 분포에 대한 것이 아니다. 따라서 성능 보장이 입력과 무관하다.
범용성이 짧은 체인을 보장하는 이유
\(h \in \mathcal{H}\)에 대한 지시 확률 변수(indicator random variable) \(X_{ij}\)를 \(h(k_i) = h(k_j)\)이면 1, 아니면 0으로 정의한다. 인덱스 \(h(k_i)\)의 체인 크기는 확률 변수 \(X_i = \sum_j X_{ij}\)이다. 기대 체인 크기는 기댓값의 선형성에 의해 다음과 같다.
\[\begin{aligned} \mathbb{E}_{h \in \mathcal{H}} \{ X_i \} &= \mathbb{E}_{h \in \mathcal{H}} \Bigl\{ \sum_j X_{ij} \Bigr\} = \sum_j \mathbb{E}_{h \in \mathcal{H}} \{ X_{ij} \} = 1 + \sum_{j \ne i} \mathbb{E}_{h \in \mathcal{H}} \{ X_{ij} \} \\ &= 1 + \sum_{j \ne i} \Bigl[ (1) \Pr_{h \in \mathcal{H}} \{ h(k_i) = h(k_j) \} + (0) \Pr_{h \in \mathcal{H}} \{ h(k_i) \ne h(k_j) \} \Bigr] \\ &\le 1 + \sum_{j \ne i} \frac{1}{m} = 1 + \frac{n-1}{m} \end{aligned}\]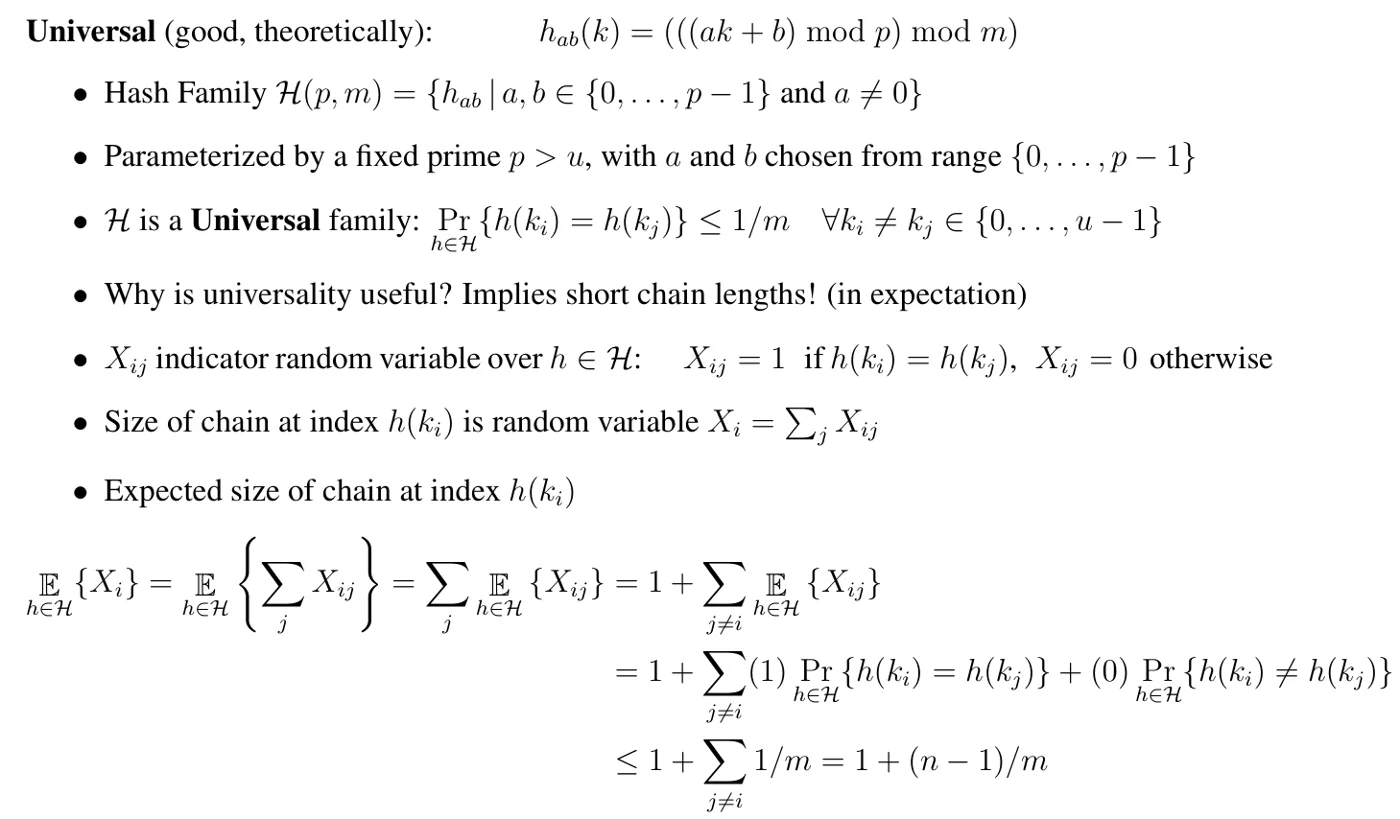 강의 노트의 범용 해싱 부분. 해시 함수족의 정의에서 시작해 지시 변수 \(X_{ij}\)를 정의하고, 기댓값의 선형성으로 기대 체인 길이 \(1 + (n-1)/m\)을 얻는 흐름이 한 화면에 정리되어 있다. 출처: MIT 6.006 Lecture 4 notes (CC BY-NC-SA 4.0).
맨 아래 유도식은 세 단계로 읽는다. 첫 줄은 체인 크기 \(X_i\)를 지시 변수의 합으로 쓰고 기댓값을 합 안으로 넣는다(선형성). 이때 \(j = i\)인 항은 \(k_i\)가 자기 자신과 항상 같은 칸에 가므로 정확히 1이고, 이것이 따로 떨어져 나온 “1 +”다. 둘째 줄은 지시 변수의 기댓값이 “1일 확률 \(\times 1\) + 0일 확률 \(\times 0\)”, 즉 충돌 확률과 같다는 사실을 풀어 쓴 것이다. 셋째 줄에서 범용성 \(\Pr\{h(k_i) = h(k_j)\} \le 1/m\)을 대입하면 \(n - 1\)개의 항이 각각 \(1/m\) 이하가 된다.
구체적인 수로 보면 \(n = 1000\)개를 \(m = 1000\)칸에 넣을 때 기대 체인 크기는 \(1 + 999/1000 < 2\)다. 이 값은 입력 키가 어떻게 생겼든 상관없이 성립한다. 기댓값이 해시 함수의 무작위 선택에 대해서만 취해졌기 때문이다.
\(j = i\)인 항은 항상 1이다. \(m = \Omega(n)\)이면 적재율(load factor) \(\alpha = n/m = O(1)\)이므로, 기대 체인 크기는 \(O(1)\)이다.
동적 해시 테이블
삽입과 삭제로 \(n/m\)이 1에서 멀어지면, 새 크기 \(m\)에 맞춰 새 해시 함수를 무작위로 골라 테이블을 다시 만든다(모든 항목을 다시 삽입). 동적 배열과 같은 분석으로, 재구성 비용은 많은 동적 연산에 분할상환된다. 따라서 해시 테이블은 동적 집합 연산을 기대 분할상환 \(O(1)\) 에 지원한다.
Recitation 구현의 핵심 부분은 다음과 같다. 체인으로는 연결 리스트 위에 만든 집합을 쓴다.
def _hash(self, k, m):                       # O(1)
    return ((self.a * k) % self.p) % m

def find(self, k):                           # O(1) expected
    h = self._hash(k, len(self.A))
    return self.A[h].find(k)

def insert(self, x):                         # O(1) amortized expected
    self._resize(self.size + 1)              # rebuild with new size if needed
    h = self._hash(x.key, len(self.A))
    added = self.A[h].insert(x)
    if added:
        self.size += 1
    return added
순서 연산은 모든 항목을 훑어야 하므로 \(O(n)\)이다.
비교
\(O(\cdot)\) 실행 시간이다. (a)는 분할상환, (e)는 기대값을 뜻한다.
| 자료구조 | build(X) |
find(k) |
insert(x), delete(k) |
find_min(), find_max() |
find_prev(k), find_next(k) |
|---|---|---|---|---|---|
| 배열 | \(n\) | \(n\) | \(n\) | \(n\) | \(n\) |
| 정렬된 배열 | \(n \log n\) | \(\log n\) | \(n\) | \(1\) | \(\log n\) |
| 직접 접근 배열 | \(u\) | \(1\) | \(1\) | \(u\) | \(u\) |
| 해시 테이블 | \(n\) (e) | \(1\) (e) | \(1\) (a)(e) | \(n\) | \(n\) |
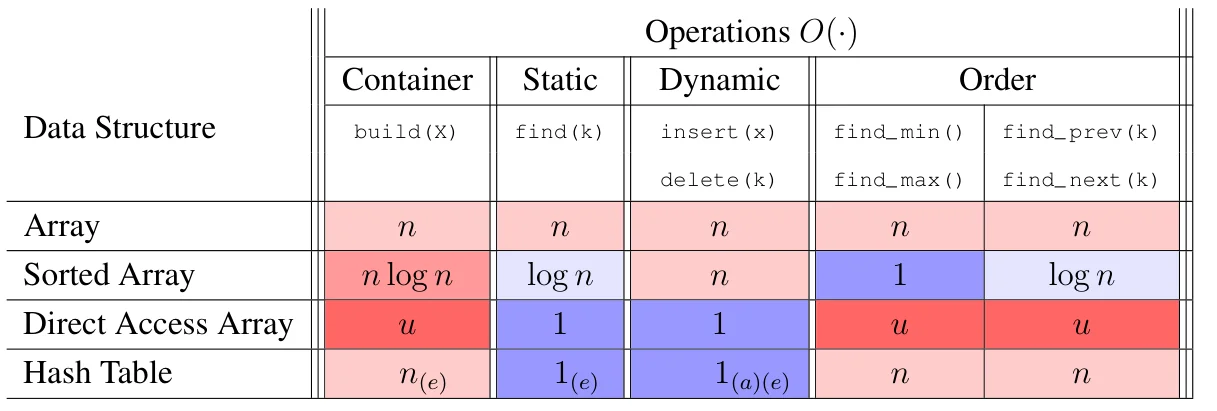 강의 노트의 집합 비용표. 진한 붉은 칸 \(u\)는 키 범위에 비례하는 비용이고, 아래첨자 (a)는 분할상환, (e)는 기대값이다. 출처: MIT 6.006 Lecture 4 notes (CC BY-NC-SA 4.0).
표의 아래 두 행이 이번 강의의 결과다. 직접 접근 배열은 find와 동적 연산 칸이 최악 \(1\)로 가장 좋지만, build와 순서 연산 칸이 \(u\)로 가장 나쁘다. 해시 테이블은 공간을 \(\Theta(n)\)으로 줄이는 대신 무작위성을 받아들여, 같은 칸들이 기대값 \(1\)이 된다. 순서 연산은 해시가 키의 대소 관계를 뒤섞기 때문에 모든 항목을 훑어야 하므로 \(n\)이다.
결국 어느 한 자료구조가 모든 열에서 이기지는 않는다. 순서 연산이 필요 없는 사전 문제에는 해시 테이블이, 순서 연산이 자주 필요하면 정렬된 배열(또는 이후 강의의 AVL 트리)이 알맞다.
예제: 중복 찾기
Recitation의 연습 문제다. 양의 정수 \(n\)개의 정렬되지 않은 배열에 같은 값이 두 번 나오는지 판정한다.
- 완전 탐색: \(\binom{n}{2} = O(n^2)\)개 쌍을 모두 비교한다.
- 정렬: 병합 정렬로 \(O(n \log n)\)에 정렬하고 인접한 쌍만 비교한다.
- 해싱: 각 정수를 해시 테이블에 넣으며 같은 체인에 같은 값이 있는지 확인한다. 기대 \(O(n)\)이다.
- 모든 값이 \(k\) 이하이고 \(k < n\)이면 비둘기집 원리로 항상 중복이 있으므로 \(O(1)\)이다.
- \(n \le k\)이면 길이 \(k\)의 직접 접근 배열을 써서 최악 \(O(k)\)에 판정한다.
정리
- 비교 모델의 알고리즘은 이진 결정 트리로 볼 수 있다. 탐색은 출력이 \(n+1\)가지이므로 높이가 \(\lceil \lg(n+1) \rceil - 1 = \Omega(\log n)\)이고, 정렬된 배열이 이 하한을 달성한다.
- 상수 분기 계수로는 \(\Omega(\log n)\)을 넘을 수 없다. Word-RAM의 임의 접근 인덱싱은 선형 분기 계수를 주어 이 한계를 넘는다.
- 직접 접근 배열은 키 \(k\)를 인덱스 \(k\)에 두어 최악 \(O(1)\) 연산을 하지만 공간이 \(\Theta(u)\)다.
- 해싱은 키를 \(m = \Theta(n)\) 범위로 사상하고, 피할 수 없는 충돌은 체이닝으로 처리한다.
- 고정된 해시 함수는 나쁜 입력이 반드시 있으므로, 범용 함수족 \(h_{ab}(k) = ((ak+b) \bmod p) \bmod m\)에서 무작위로 고른다. 그러면 기대 체인 크기가 \(1 + (n-1)/m = O(1)\)이다.
- 크기가 바뀌면 다시 만들어, 해시 테이블은
find를 기대 \(O(1)\)에,insert/delete를 기대 분할상환 \(O(1)\)에 지원한다. 순서 연산은 \(O(n)\)이다.