- MIT 6.006 Introduction to Algorithms (Spring 2020) 6강 정리
- 강의: Erik Demaine, Jason Ku, Justin Solomon
- MIT OpenCourseWare, CC BY-NC-SA
- ▶ 강의 영상
- Recitation 6 notes (PDF)
지금까지와 새 목표
지금까지 본 시퀀스 자료구조와 목표는 다음과 같다(\(O(\cdot)\), (a)는 분할상환).
| 자료구조 | build(X) |
get_at(i), set_at(i, x) |
insert_first(x), delete_first() |
insert_last(x), delete_last() |
insert_at(i, x), delete_at(i) |
|---|---|---|---|---|---|
| 배열 | \(n\) | \(1\) | \(n\) | \(n\) | \(n\) |
| 연결 리스트 | \(n\) | \(n\) | \(1\) | \(n\) | \(n\) |
| 동적 배열 | \(n\) | \(1\) | \(n\) | \(1\) (a) | \(n\) |
| 목표 | \(n\) | \(\log n\) | \(\log n\) | \(\log n\) | \(\log n\) |
집합 자료구조와 목표는 다음과 같다((e)는 기대값).
| 자료구조 | build(X) |
find(k) |
insert(x), delete(k) |
find_min(), find_max() |
find_prev(k), find_next(k) |
|---|---|---|---|---|---|
| 배열 | \(n\) | \(n\) | \(n\) | \(n\) | \(n\) |
| 정렬된 배열 | \(n \log n\) | \(\log n\) | \(n\) | \(1\) | \(\log n\) |
| 직접 접근 배열 | \(u\) | \(1\) | \(1\) | \(u\) | \(u\) |
| 해시 테이블 | \(n\) (e) | \(1\) (e) | \(1\) (a)(e) | \(n\) | \(n\) |
| 목표 | \(n \log n\) | \(\log n\) | \(\log n\) | \(\log n\) | \(\log n\) |
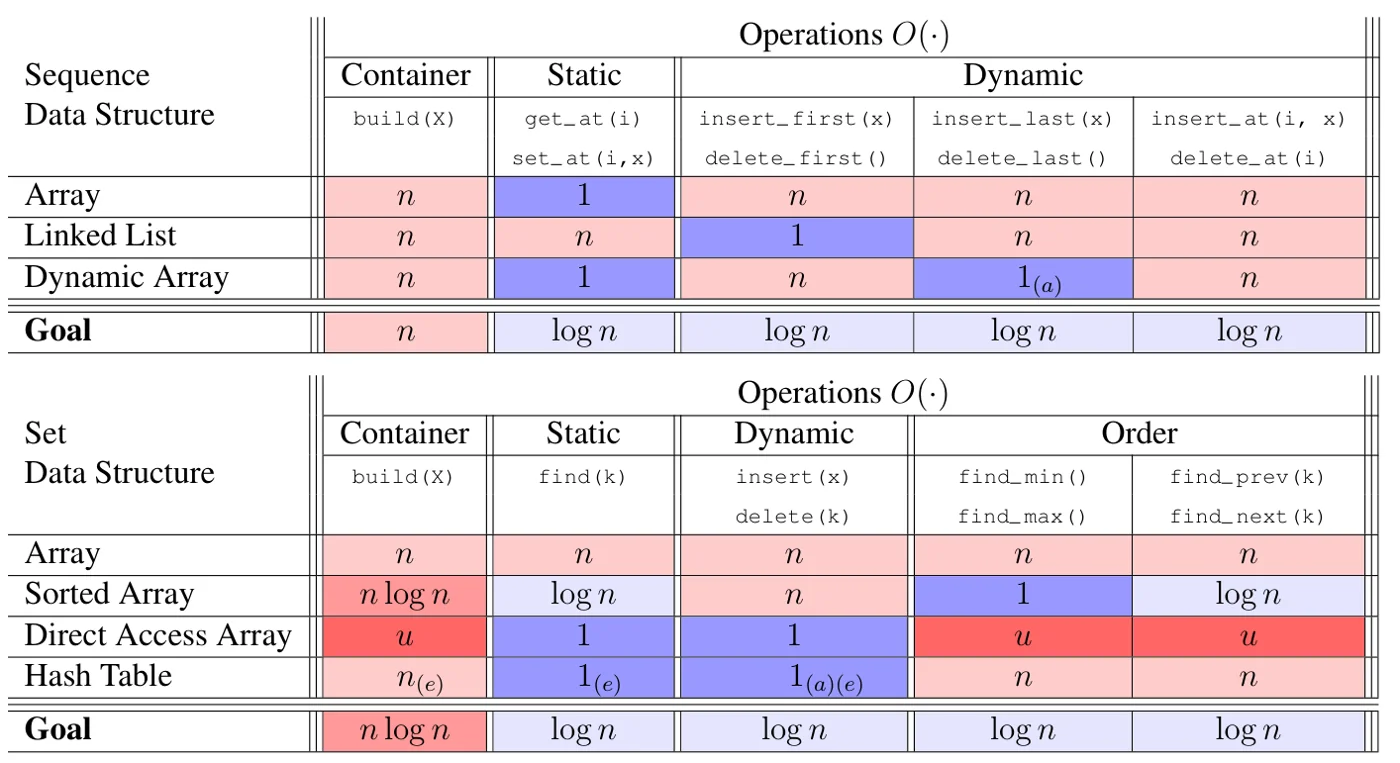 강의 노트의 “지난 시간과 새 목표” 표. 위는 시퀀스, 아래는 집합 자료구조이며, 굵은 Goal 행이 이번 두 강의에서 달성하려는 비용이다. 출처: MIT 6.006 Lecture 6 notes (CC BY-NC-SA 4.0).
두 표의 Goal 행은 열 하나하나가 기존 자료구조 중 최선과 같거나 더 좋으면서, 붉은 칸(\(n\)이나 \(u\))이 하나도 없도록 정해져 있다. 시퀀스 표에서 기존 자료구조는 어느 열에서는 파랗지만 다른 열에서는 붉다. 배열은 인덱스 접근이, 연결 리스트는 앞쪽 동적 연산이, 동적 배열은 뒤쪽 동적 연산이 빠르다. 목표는 이 모든 열을 동시에 \(\log n\)으로 만드는 것이다. 특히 맨 오른쪽 insert_at/delete_at 열은 지금까지 모두 \(n\)이었으므로 가장 큰 개선이다.
집합 표에서 Goal 행의 build는 \(n \log n\)으로 남아 있다. 정렬된 순서를 유지하는 자료구조를 만들면 그 결과를 순서대로 읽는 것만으로 정렬이 되므로, 비교 정렬 하한 \(\Omega(n \log n)\)보다 빠를 수 없기 때문이다. 해시 테이블보다 find는 느리지만(\(\log n\) 대 기대 \(1\)), 순서 연산까지 \(\log n\)에 최악 경우로 보장한다는 점이 다르다.
어떻게? 이진 트리(binary tree) 로 한다.
이진 트리
연결 리스트 같은 포인터 기반 자료구조는 (분할상환이나 기대값이 아닌) 최악 경우 성능을 낼 수 있다. 이진 트리는 노드마다 포인터가 세 개인 포인터 기반 자료구조다. 노드는 node.{item, parent, left, right}로 표현한다.
class Binary_Node:
    def __init__(A, x):                     # O(1)
        A.item   = x
        A.left   = None
        A.right  = None
        A.parent = None
강의 노트의 예시 트리는 다음과 같다.
          ________<A>_____
     __<B>_____          <C>
  __<D>      <E>
<F>
| 노드 | item | parent | left | right |
|---|---|---|---|---|
<A> |
A | - | <B> |
<C> |
<B> |
B | <A> |
<D> |
<E> |
<C> |
C | <A> |
- | - |
<D> |
D | <B> |
<F> |
- |
<E> |
E | <B> |
- | - |
<F> |
F | <D> |
- | - |
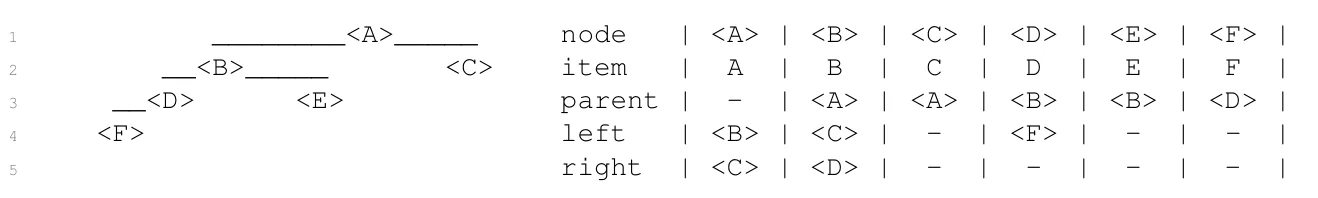 강의 노트의 예시 트리. 왼쪽은 노드 여섯 개짜리 이진 트리를 글자로 그린 것이고, 오른쪽 표는 각 노드의 item과 세 포인터(parent, left, right)를 나열한 것이다. 출처: MIT 6.006 Lecture 6 notes (CC BY-NC-SA 4.0).
그림에서 밑줄 __은 간선을 나타낸다. 노드 이름의 왼쪽으로 뻗은 밑줄은 왼쪽 자식으로, 오른쪽으로 뻗은 밑줄은 오른쪽 자식으로 이어진다. 예를 들어 <A>의 양쪽 밑줄은 <B>와 <C>로, <D>의 왼쪽 밑줄은 <F>로 이어진다. 오른쪽 표는 이 그림을 메모리에 저장된 모습으로 옮긴 것이다. 각 열이 노드 객체 하나이고, -는 None 포인터다.
표를 세로로 읽으면 트리 연산이 무엇을 하는지 감이 온다. 위로 올라가려면 parent 행을, 아래로 내려가려면 left와 right 행을 본다. 예를 들어 <F>에서 루트까지 가려면 parent를 따라 <D>, <B>, <A>로 세 번 이동한다. 이 이동 횟수가 <F>의 깊이 3이며, 이 트리에서 가장 깊으므로 트리의 높이도 3이다.
연결 리스트에서는 많은 노드가 헤드에서 \(O(n)\) 포인터만큼 떨어져 있지만, 이진 트리는 어떤 노드도 루트에서 \(O(\log n)\) 포인터 이상 떨어지지 않게 만들 수 있다.
용어
- 루트(root): 부모가 없는 노드다(예:
<A>). - 잎(leaf): 자식이 없는 노드다(예:
<C>,<E>,<F>). - 루트에서 부모 포인터를 따라 올라가며 지나는 노드들을 조상(ancestor) 이라 한다.
<R>을 루트로 하는 트리에서 노드<X>의 깊이(depth) 는<X>에서<R>까지 경로의 길이다.- 노드
<X>의 높이(height) 는<X>를 루트로 하는 서브트리에 있는 노드의 깊이 중 최댓값이다.
아이디어: 연산을 루트의 높이 \(h\)에 대해 \(O(h)\) 시간에 동작하도록 설계하고, \(h = O(\log n)\)을 유지한다(다음 강의).
순회 순서
이진 트리에는 고유한 순서가 있다. 순회 순서(traversal order) 다.
- 노드
<X>의 왼쪽 서브트리의 모든 노드는<X>보다 앞에 온다. - 노드
<X>의 오른쪽 서브트리의 모든 노드는<X>보다 뒤에 온다.
루트에서 시작하는 재귀 알고리즘으로 노드를 순회 순서대로 나열할 수 있다. 왼쪽 서브트리를 재귀적으로 나열하고, 자신을 나열한 뒤, 오른쪽 서브트리를 재귀적으로 나열한다. 노드마다 \(O(1)\) 일을 하므로 \(O(n)\) 시간이다.
def subtree_iter(A):                        # O(n)
    if A.left:  yield from A.left.subtree_iter()
    yield A
    if A.right: yield from A.right.subtree_iter()
예시 트리의 순회 순서는 (<F>, <D>, <B>, <E>, <A>, <C>)이다.
지금은 순회 순서가 저장된 항목과 아무 관계가 없다. 나중에 순회 순서에 의미를 부여해 시퀀스와 집합 인터페이스를 구현한다. 그때까지는 트리를 조작해도 순회 순서를 보존하는 것만 신경 쓴다.
트리 탐색
서브트리의 첫 노드
노드 <X>의 서브트리에서 순회 순서상 첫 노드를 찾는다(마지막은 대칭이다).
<X>에 왼쪽 자식이 있으면, 왼쪽 서브트리의 첫 노드를 재귀적으로 반환한다.- 없으면
<X>가 첫 노드이므로 그것을 반환한다. - 아래로만 내려가므로 실행 시간은 \(O(h)\)다.
- 예:
<A>의 서브트리의 첫 노드는<F>다.
다음 노드
노드 <X>의 순회 순서상 다음 노드(successor) 를 찾는다(이전 노드(predecessor) 는 대칭이다).
<X>에 오른쪽 자식이 있으면, 오른쪽 서브트리의 첫 노드를 반환한다.- 없으면,
<X>가 왼쪽 서브트리에 속하는 가장 낮은 조상을 반환한다. - 첫째 경우는 아래로만, 둘째 경우는 위로만 움직이므로 실행 시간은 \(O(h)\)다.
- 예:
<B>의 다음 노드는<E>,<E>의 다음 노드는<A>,<C>의 다음 노드는 None이다.
def subtree_first(A):                       # O(h)
    if A.left: return A.left.subtree_first()
    else:      return A

def successor(A):                           # O(h)
    if A.right: return A.right.subtree_first()
    while A.parent and (A is A.parent.right):
        A = A.parent
    return A.parent
subtree_last와 predecessor는 left와 right를 바꾸면 된다.
동적 연산
트리를 항목 하나만큼 바꾼다. 잎만 추가하거나 제거한다.
- 순회 순서에서 어떤 노드 뒤에(앞은 대칭) 노드를 추가한다.
- 트리에서 항목을 제거한다.
삽입
순회 순서에서 노드 <X> 뒤에 노드 <Y>를 삽입한다.
<X>에 오른쪽 자식이 없으면,<Y>를<X>의 오른쪽 자식으로 만든다.- 그렇지 않으면,
<Y>를<X>의 다음 노드의 왼쪽 자식으로 만든다. 그 다음 노드는 오른쪽 서브트리의 첫 노드이므로 왼쪽 자식이 없다. - 실행 시간은 \(O(h)\)다.
def subtree_insert_after(A, B):             # O(h)
    if A.right:
        A = A.right.subtree_first()
        A.left, B.parent = B, A
    else:
        A.right, B.parent = B, A
예: <E> 앞에 <G>를 삽입한다. <E>에 왼쪽 자식이 없으므로 <G>는 <E>의 왼쪽 자식이 된다.
          ________<A>_____                       ________<A>_____
     __<B>_____          <C>      =>        __<B>_____          <C>
  __<D>      <E>                         __<D>      __<E>
<F>                                    <F>        <G>
예: <A> 뒤에 <H>를 삽입한다. <A>에 오른쪽 자식 <C>가 있으므로, <A>의 다음 노드인 <C>의 왼쪽 자식이 된다.
          ________<A>_____                       ________<A>_____
     __<B>_____          <C>      =>        __<B>_____        __<C>
  __<D>      __<E>                       __<D>      __<E>    <H>
<F>        <G>                         <F>        <G>
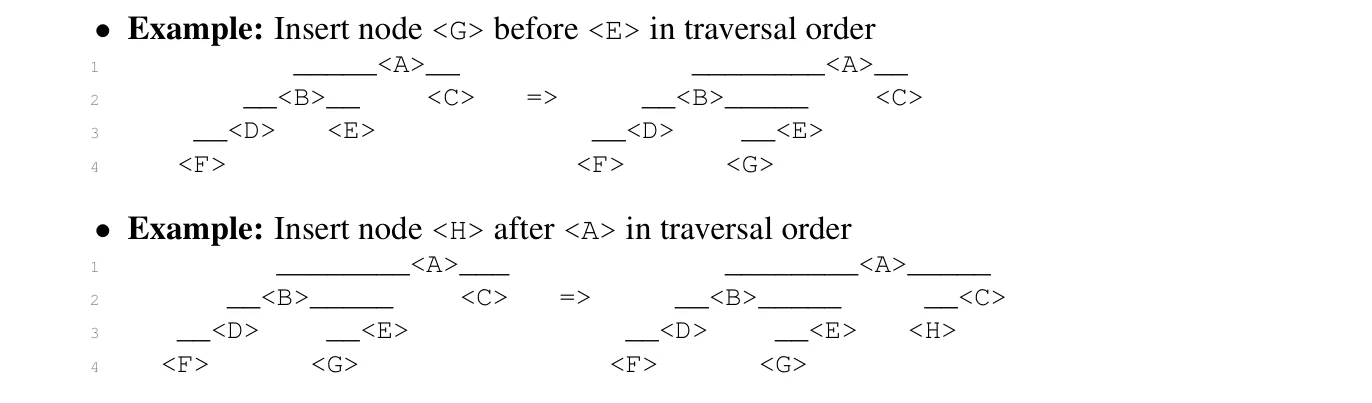 강의 노트의 삽입 예. 위는
<E> 앞에 <G>를, 아래는 이어서 <A> 뒤에 <H>를 넣는 과정이며, 각각 => 왼쪽이 전, 오른쪽이 후다. 출처: MIT 6.006 Lecture 6 notes (CC BY-NC-SA 4.0).
두 예는 삽입 규칙의 두 경우를 하나씩 보여 준다. 위의 예는 “앞에 삽입”이므로 대칭 규칙을 쓴다. <E>에 왼쪽 자식이 없으므로 <G>를 바로 <E>의 왼쪽 자식으로 붙인다. 순회 순서는 (<F>, <D>, <B>, <E>, <A>, <C>)에서 (<F>, <D>, <B>, <G>, <E>, <A>, <C>)로 바뀌어, 정확히 <E> 바로 앞에 <G>가 끼어든다.
아래 예는 “뒤에 삽입”이고 <A>에 이미 오른쪽 자식 <C>가 있는 경우다. 이때 <A>의 다음 노드는 오른쪽 서브트리의 첫 노드, 즉 <C>다. <C>는 서브트리의 첫 노드이므로 왼쪽 자식이 비어 있고, 그 자리에 <H>를 붙인다. 결과 순회 순서에서 <H>는 <A>와 <C> 사이에 온다. 어느 경우든 새 노드는 항상 잎으로 붙고, 다른 노드의 위치는 하나도 바뀌지 않는다.
삭제
노드 <X>의 항목을 <X>의 서브트리에서 삭제한다.
<X>가 잎이면, 부모에서 떼어 내고 반환한다.- 그렇지 않으면
<X>에 자식이 있다.- 왼쪽 자식이 있으면,
<X>의 이전 노드와 항목을 맞바꾸고 재귀한다. - 그렇지 않으면 오른쪽 자식이 있으므로,
<X>의 다음 노드와 항목을 맞바꾸고 재귀한다.
- 왼쪽 자식이 있으면,
- 이전/다음 노드는 왼쪽/오른쪽 서브트리 안에 있으므로 항목은 아래로만 내려간다. 실행 시간은 \(O(h)\)다.
<X>에서 이전 노드와 항목을 맞바꾸면 두 항목의 순회 순서가 바뀌지만, <X>의 항목은 결국 삭제되므로 나머지 항목의 순서는 그대로다.
def subtree_delete(A):                      # O(h)
    if A.left or A.right:                   # A is not a leaf
        if A.left: B = A.predecessor()
        else:      B = A.successor()
        A.item, B.item = B.item, A.item
        return B.subtree_delete()
    if A.parent:                            # A is a leaf
        if A.parent.left is A: A.parent.left  = None
        else:                  A.parent.right = None
    return A
예: 잎인 <F>를 제거한다.
          ________<A>_____                     ________<A>_____
     __<B>_____        __<C>      =>      __<B>_____        __<C>
  __<D>      __<E>    <H>                <D>      __<E>    <H>
<F>        <G>                                  <G>
예: <A>를 제거한다. 잎이 아니므로 먼저 잎까지 맞바꾸며 내려간다. <A>의 이전 노드는 <E>이므로 항목을 맞바꾸고, 다시 그 위치의 이전 노드 <G>와 맞바꾼 뒤, 잎이 된 위치를 떼어 낸다.
       ________<A>_____             ________<E>_____             _____<E>_____
  __<B>_____        __<C>   =>  __<B>_____        __<C>   =>  __<B>__      __<C>
<D>      __<E>    <H>         <D>      __<G>    <H>         <D>     <G>   <H>
       <G>                           <A>
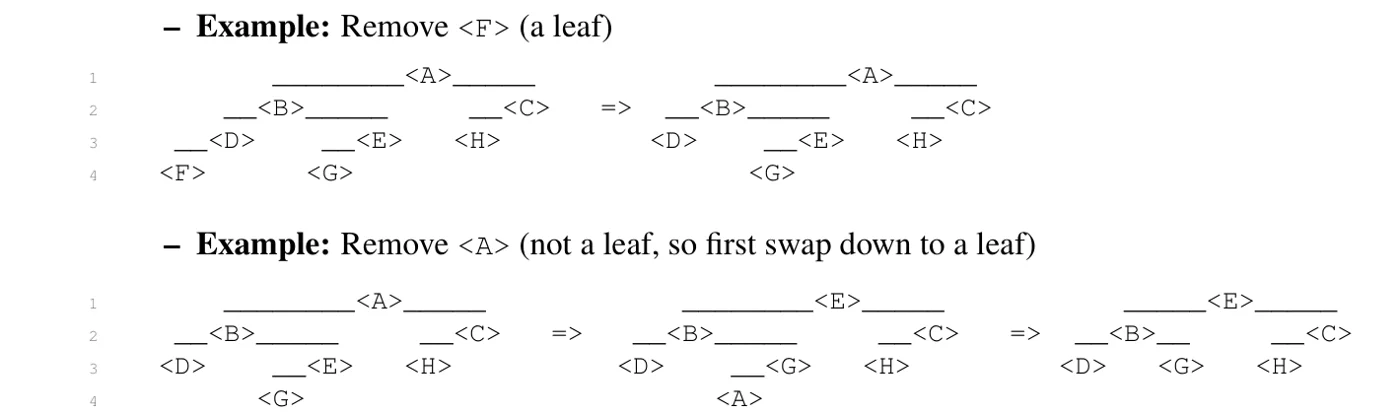 강의 노트의 삭제 예. 위는 잎
<F>를 바로 떼어 내는 경우, 아래는 잎이 아닌 <A>를 이전 노드와 두 번 맞바꿔 잎까지 내린 뒤 떼어 내는 경우다. 출처: MIT 6.006 Lecture 6 notes (CC BY-NC-SA 4.0).
위의 예는 가장 쉬운 경우다. <F>는 자식이 없으므로 부모 <D>의 left 포인터만 None으로 바꾸면 끝난다.
아래 예는 세 단계로 읽는다. 첫 화살표에서 <A>는 왼쪽 자식이 있으므로 이전 노드를 찾는다. 이전 노드는 왼쪽 서브트리의 마지막 노드, 즉 <B>에서 오른쪽으로 끝까지 내려간 <E>다. 두 노드의 항목을 맞바꾸면 루트 자리에 E가, 원래 <E> 자리에 A가 놓인다. 그런데 그 자리에는 왼쪽 자식 <G>가 있어 아직 잎이 아니다. 둘째 화살표에서 같은 규칙을 다시 적용해 이전 노드 <G>와 맞바꾸면 A가 잎 자리로 내려간다. 마지막으로 그 잎을 떼어 내면 셋째 그림이 된다.
맞바꾸는 동안 A는 잠시 순회 순서상 엉뚱한 자리에 있지만, 결국 삭제되므로 문제되지 않는다. 남은 노드들의 순회 순서 (<D>, <B>, <G>, <E>, <H>, <C>)는 원래 순서에서 A만 뺀 것과 같다. 항목이 매번 한 레벨 이상 아래로 내려가므로 맞바꾸기는 최대 \(h\)번이다.
응용: 집합
아이디어: 집합 이진 트리(Set Binary Tree), 즉 이진 탐색 트리(Binary Search Tree, BST) 는 순회 순서가 키의 오름차순인 이진 트리다.
이는 BST 성질과 동치다. 모든 노드에 대해, 왼쪽 서브트리의 모든 키 \(\le\) 노드의 키 \(\le\) 오른쪽 서브트리의 모든 키다.
그러면 노드 <X>의 서브트리에서 키가 \(k\)인 노드를 이진 탐색처럼 \(O(h)\)에 찾을 수 있다.
- \(k\)가
<X>의 키보다 작으면, 왼쪽 서브트리에서 재귀한다(없으면 None을 반환한다). - \(k\)가
<X>의 키보다 크면, 오른쪽 서브트리에서 재귀한다(없으면 None을 반환한다). - 그렇지 않으면
<X>에 저장된 항목을 반환한다.
def subtree_find(A, k):                     # O(h)
    if k < A.item.key:
        if A.left:  return A.left.subtree_find(k)
    elif k > A.item.key:
        if A.right: return A.right.subtree_find(k)
    else:           return A
    return None
다른 집합 연산도 비슷한 패턴을 따른다. 예를 들어 insert는 같은 방식으로 내려가다가 빈 자리에서 subtree_insert_before/subtree_insert_after를 호출하고, find_min/find_max는 루트의 subtree_first/subtree_last다. find_next(k)는 다음과 같다.
def subtree_find_next(A, k):                # O(h)
    if A.item.key <= k:
        if A.right: return A.right.subtree_find_next(k)
        else:       return None
    elif A.left:
        B = A.left.subtree_find_next(k)
        if B: return B
    return A
응용: 시퀀스
아이디어: 시퀀스 이진 트리(Sequence Binary Tree) 는 순회 순서가 시퀀스 순서인 이진 트리다.
서브트리의 순회 순서에서 \(i\)번째 노드를 어떻게 찾을까? 이 연산을 subtree_at(i)라 하자. 순회 순서 전체를 훑을 수도 있지만 \(O(n)\)으로 나쁘다. 그런데 서브트리의 크기를 \(O(1)\)에 알 수 있다면 \(O(h)\)에 풀 수 있다.
- 왼쪽 서브트리의 크기 \(n_L\)을 \(i\)와 비교한다.
- \(i < n_L\)이면, 왼쪽 서브트리에서 재귀한다.
- \(i > n_L\)이면, 오른쪽 서브트리에서 \(i' = i - n_L - 1\)로 재귀한다.
- 그렇지 않으면 \(i = n_L\)이고, 찾는 노드에 도달했다.
def subtree_at(A, i):                       # O(h)
    assert 0 <= i
    if A.left: L_size = A.left.size
    else:      L_size = 0
    if i < L_size:   return A.left.subtree_at(i)
    elif i > L_size: return A.right.subtree_at(i - L_size - 1)
    else:            return A
각 노드에 서브트리 크기를 보강(augmentation) 으로 저장한다.
- 각 노드에
node.size필드를 추가한다. - 새 잎을 추가하면, 모든 조상 \(a\)의
a.size에 \(+1\)을 \(O(h)\) 시간에 더한다. - 잎을 삭제하면, 모든 조상 \(a\)의
a.size에 \(-1\)을 \(O(h)\) 시간에 더한다.
시퀀스 연산은 빠른 subtree_at(i)에서 바로 나온다. get_at(i)/set_at(i, x)는 \(i\)번째 노드의 항목을 읽거나 쓰고, insert_at(i, x)는 \((i-1)\)번째 노드 뒤에 삽입하며, delete_at(i)는 \(i\)번째 노드를 삭제한다.
build(X)를 단순하게 하면 \(O(nh)\)이지만, \(O(n)\)에 할 수 있다(recitation). 가운데 항목을 루트에 두고 왼쪽 절반과 오른쪽 절반을 재귀적으로 각 서브트리로 만들면 된다. 노드마다 상수 일을 하므로 \(O(n)\)이고, 높이는 \(H(n) = 1 + H(n/2)\)를 따르므로 \(O(\log n)\)이다.
def build_subtree(A, i, j):                 # build A[i..j], O(j - i + 1)
    c = (i + j) // 2
    root = Node_Type(A[c])
    if i < c:
        root.left = build_subtree(A, i, c - 1)
        root.left.parent = root
    if c < j:
        root.right = build_subtree(A, c + 1, j)
        root.right.parent = root
    return root
지금까지
| 집합 | build(X) |
find(k) |
insert(x), delete(k) |
find_min(), find_max() |
find_prev(k), find_next(k) |
|---|---|---|---|---|---|
| 이진 트리 | \(n \log n\) | \(h\) | \(h\) | \(h\) | \(h\) |
| 목표 | \(n \log n\) | \(\log n\) | \(\log n\) | \(\log n\) | \(\log n\) |
| 시퀀스 | build(X) |
get_at(i), set_at(i, x) |
insert_first(x), delete_first() |
insert_last(x), delete_last() |
insert_at(i, x), delete_at(i) |
|---|---|---|---|---|---|
| 이진 트리 | \(n\) | \(h\) | \(h\) | \(h\) | \(h\) |
| 목표 | \(n\) | \(\log n\) | \(\log n\) | \(\log n\) | \(\log n\) |
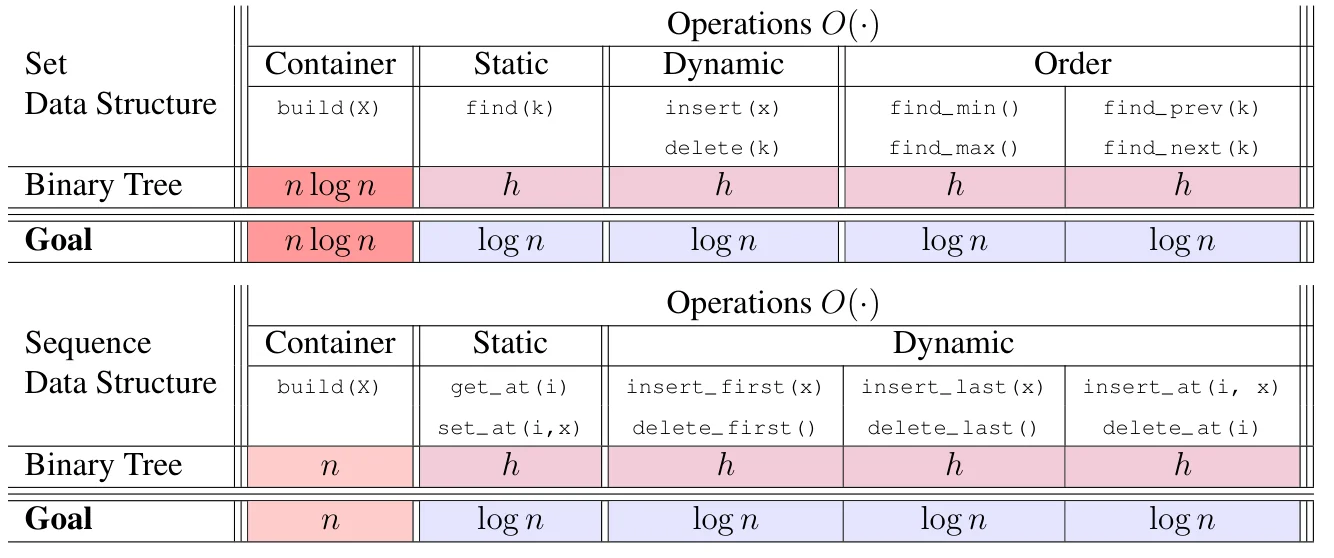 강의 노트의 “지금까지” 표. 이진 트리 행의 칸 대부분이 트리 높이 \(h\)로 표시되어 있고, 바로 아래 Goal 행과 비교하면 남은 과제가 \(h\)를 \(\log n\)으로 바꾸는 것뿐임을 알 수 있다. 출처: MIT 6.006 Lecture 6 notes (CC BY-NC-SA 4.0).
이 표는 이번 강의의 결론을 요약한다. build 열은 이미 목표와 같다. 집합은 정렬 후 가운데를 루트로 하는 재귀로 \(n \log n\), 시퀀스는 정렬 없이 같은 재귀로 \(n\)이다. 나머지 모든 열은 \(h\)인데, 이 칸이 연한 붉은색인 이유는 \(h\)가 트리 모양에 따라 \(\log n\)부터 \(n\)까지 될 수 있기 때문이다. 키를 오름차순으로 하나씩 삽입하면 트리가 오른쪽으로만 길게 늘어진 사슬이 되어 \(h = n - 1\)이 된다.
따라서 남은 일은 모든 연산이 끝난 뒤에도 \(h = O(\log n)\)이 유지되도록 트리 모양을 고치는 방법이다. 이것이 다음 강의의 AVL 트리다.
다음 강의에서는 삽입이나 삭제 후에도 이진 트리의 균형을 유지해 \(h = O(\log n)\)을 지킴으로써, \(O(h)\) 실행 시간을 \(O(\log n)\)으로 줄인다.
정리
- 이진 트리는 노드마다 item, parent, left, right를 가진 포인터 기반 자료구조이며, 연산을 높이 \(h\)에 대해 \(O(h)\)로 설계한다.
- 순회 순서는 “왼쪽 서브트리, 자신, 오른쪽 서브트리”이며 \(O(n)\)에 나열할 수 있다.
- 서브트리의 첫/마지막 노드와 다음/이전 노드는 아래로만 또는 위로만 움직여 \(O(h)\)에 찾는다.
- 삽입은 잎을 붙이는 것으로, 삭제는 이전/다음 노드와 항목을 바꿔 잎까지 내린 뒤 떼어 내는 것으로 \(O(h)\)에 한다. 둘 다 나머지 항목의 순회 순서를 보존한다.
- 순회 순서를 키 순서로 두면 이진 탐색 트리(집합)가, 시퀀스 순서로 두면 시퀀스 이진 트리가 된다.
- 시퀀스 트리는 서브트리 크기를 보강해
subtree_at(i)를 \(O(h)\)에 하며,build는 가운데를 루트로 하는 재귀로 \(O(n)\)이다.