- 임커밋의 딥러닝 / 머신러닝 강의 정리
CNN이 다루는 데이터: 나열된 벡터
합성곱 신경망(convolutional neural network, CNN)은 딥러닝 모듈의 한 종류이다. PyTorch에는 데이터가 늘어선 차원의 수에 따라 nn.Conv1d, nn.Conv2d, nn.Conv3d가 따로 있고, 각각 음성이나 시계열, 이미지, 비디오를 분석할 때 주로 쓴다.
CNN을 이해하려면 먼저 입력 데이터의 모양을 알아야 한다. CNN의 입력은 여러 숫자로 이루어진 벡터가 나열된 데이터이다. 여기서 “나열되어 있다”는 것은 벡터들이 시간적으로 또는 공간적으로 인접하게 늘어서 있다는 뜻이고, 이 인접성이 CNN의 핵심이다.
- 이미지. 벡터 하나는 픽셀이다. RGB로 색을 표현하면 픽셀 하나는 빨강, 초록, 파랑의 세기를 나타내는 숫자 3개이다. 이 픽셀들이 위아래, 양옆의 2차원으로 나열되어 있다.
- 시계열. 1초마다 기압과 온도를 재서 1분간 기록했다고 하자. 벡터 하나는 (기압, 온도)라는 숫자 2개이고, 이것이 시간 축을 따라 60개 나열되어 있다.
CNN에서는 각 위치의 벡터를 이루는 숫자들을 채널(channel)이라고 부른다. 그래서 이미지는 “3채널 벡터가 2D로 나열된 데이터”, 기압·온도 기록은 “2채널 벡터가 1D로 60개 나열된 데이터”라고 말할 수 있다. PyTorch에서는 이것을 각각 \((3, H, W)\), \((2, 60)\) 모양의 텐서로 표현한다.
확장된 범위의 행렬곱
CNN도 nn.Linear처럼 weight와 bias, 즉 행렬곱과 벡터합으로 이루어져 있다. 차이는 그 행렬곱이 kernel size만큼 인접한 위치까지 확장된 범위에서 이루어진다는 점이다.
Linear: 위치마다 따로
nn.Linear의 행렬곱은 곱하고 더하는 단위 계산으로 입력 벡터를 분석해서, 모델이 풀 task에 도움이 되는 정보를 출력 벡터로 만든다. 기압·온도 데이터의 모든 시점에 \(5 \times 2\) 행렬 \(W\)를 곱하면
이고, 결과는 5채널 벡터 60개이다. 각 \(\mathbf{y}_t\)는 시점 \(t\)의 기압과 온도만 분석한 정보이다. 이것은 아직 CNN이 아니다.
Convolution: 이웃까지 한꺼번에
같은 데이터에 kernel size가 2인 CNN을 적용하면, 곱하고 더하는 작업이 한 시점의 두 채널에서 끝나지 않고 바로 다음 시점의 두 채널까지 함께 이루어진다.
\[\mathbf{y}_t = W_0\mathbf{x}_t + W_1\mathbf{x}_{t+1} + \mathbf{b}, \qquad W_0, W_1 \in \mathbb{R}^{5 \times 2}\]일반적으로 입력 채널 수가 \(C_\text{in}\), 출력 채널 수가 \(C_\text{out}\), kernel size가 \(k\)인 1D convolution은
\[y_t[o] = b[o] + \sum_{c=1}^{C_\text{in}} \sum_{j=0}^{k-1} W[o, c, j]\, x_{t+j}[c], \qquad o = 1, \dots, C_\text{out}\]이다. \(x_{t}[c]\)는 위치 \(t\)의 \(c\)번째 채널 값이고, 가중치 \(W\)는 \(C_\text{out} \times C_\text{in} \times k\) 모양의 텐서이다. 같은 \(W\)를 모든 위치 \(t\)에서 재사용하며 창(window)을 한 칸씩 밀어 가는 것이 convolution이다. \(k = 1\)이면 위치마다 따로 하는 nn.Linear와 같아진다. (엄밀히는 커널을 뒤집지 않는 상호상관(cross-correlation)이지만, 커널이 학습되므로 딥러닝에서는 구별하지 않고 convolution이라고 부른다.)
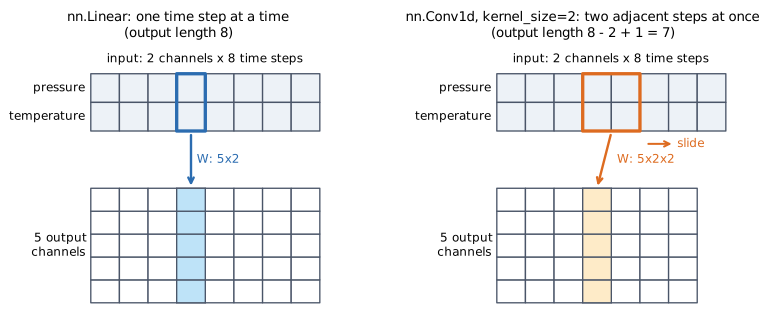 기압·온도 2채널 데이터에 대한
nn.Linear(왼쪽)와 kernel size 2인 nn.Conv1d(오른쪽). Linear는 한 시점(파란 칸)만 보고 5채널을 만들고, Conv1d는 인접한 두 시점(주황 칸)을 한꺼번에 보고 5채널을 만든 뒤 창을 한 칸씩 민다. padding이 없으면 출력 길이는 \(8 - 2 + 1 = 7\)이다.
무엇이 달라지는가: 인접한 위치 사이의 정보
가장 큰 차이는 CNN 모듈 하나만으로 나열된 차원에서의 공간적, 시간적 정보를 얻을 수 있다는 것이다. 예를 들어 출력 채널 하나의 커널을 다음과 같이 두자.
\[W_0 = \begin{bmatrix} -1 & 0 \end{bmatrix}, \quad W_1 = \begin{bmatrix} 1 & 0 \end{bmatrix} \quad\Longrightarrow\quad y_t = p_{t+1} - p_t\](\(p_t\)는 시점 \(t\)의 기압이다.) 온도에는 0이 곱해져 사라지고, 현재 기압은 부호가 바뀌고, 다음 시점 기압은 그대로 더해진다. 결과는 기압의 시간에 따른 변화량이다. 기압이 \((1013, 1012, 1015, 1015, 1014)\)이면 출력은 \((-1, 3, 0, -1)\)이다. 위치마다 따로 계산하는 Linear로는 이런 변화량을 절대 만들 수 없다.
고전적인 영상 처리에서 사진을 흐리게 하거나 윤곽선을 따는 것도 같은 계산이다. \(3 \times 3\) 패치(예: 흐림은 모든 값이 \(1/9\)인 패치)를 이미지 위에서 밀며 곱하고 더한다. 차이는 영상 처리에서는 패치 값을 사람이 정해 두지만, 딥러닝에서는 이 패치(필터(filter) 또는 커널)를 분류나 생성 같은 목적에 맞는 특징이 나오도록 미분을 이용해 학습한다는 것이다.
Kernel size와 receptive field
확장된 범위의 크기를 kernel size라고 하고, PyTorch에서는 kernel_size 인자로 지정한다. kernel size가 클수록 출력 하나가 더 넓은 구간의 입력을 보고 분석한다. 이를 수용 영역(receptive field)이 크다고 표현한다.
import torch
import torch.nn as nn

x = torch.randn(1, 2, 60)                    # (batch, channel=기압·온도, length=60초)
conv = nn.Conv1d(in_channels=2, out_channels=5, kernel_size=2)
print(conv.weight.shape, conv(x).shape)      # [5, 2, 2], [1, 5, 59]

# 기압 변화량만 뽑는 커널을 직접 넣어 보기
diff = nn.Conv1d(2, 1, kernel_size=2, bias=False)
with torch.no_grad():
    diff.weight[:] = torch.tensor([[[-1., 1.],    # 기압 채널: 현재 -1, 다음 +1
                                    [ 0., 0.]]])  # 온도 채널: 무시
p = torch.tensor([1013., 1012., 1015., 1015., 1014.])
t = torch.tensor([20., 21., 21., 22., 22.])
print(diff(torch.stack([p, t]).unsqueeze(0)))  # [[[-1., 3., 0., -1.]]]
PyTorch에서 Conv2d 쓰기
입력 shape 맞추기
이미지 파일을 불러오면 보통 (높이, 너비, 채널) 순서이다. 예를 들어 높이 559, 너비 583인 RGB 이미지는 \((559, 583, 3)\)이다. PyTorch의 convolution은 입력이 다음 순서여야 한다.
| 모듈 | 입력 shape |
|---|---|
nn.Conv1d |
(batch, channel, length) |
nn.Conv2d |
(batch, channel, height, width) |
nn.Conv3d |
(batch, channel, depth, height, width) |
학습 때는 여러 샘플을 한꺼번에 쓴다고 가정하므로 맨 앞에 배치 크기(batch size) 차원이 있다. 이미지 한 장이면 차원을 하나 늘려 배치 크기 1로 만들고, permute(0, 3, 1, 2)로 채널 차원을 두 번째로 옮긴다. (TensorFlow나 JAX/Flax는 채널을 마지막에 두는 등 규칙이 다를 수 있다.)
필수 인자 세 개
nn.Conv2d(3, 16, (3, 3))의 세 인자는 차례로 입력 채널 수, 출력 채널 수, kernel size이다.
- 입력 채널 수는 데이터의 채널 수와 맞아야 한다. 3채널 이미지에 입력 채널이 4인 conv를 쓰면 오류가 난다.
- 출력 채널 수를 17로 바꾸면 출력의 두 번째 차원이 17이 된다. RGB 3채널이 17채널 특징(feature)으로 바뀌는 것이다.
- padding이 없으면 높이와 너비가 각각 kernel size \(- 1\)만큼, 여기서는 2씩 줄어든다. 너비 10인 입력에 너비 3인 커널을 밀면, 커널이 들어갈 수 있는 시작 위치가 0부터 7까지 8개뿐이기 때문이다.
img = torch.rand(559, 583, 3)             # (H, W, C), 불러온 이미지라고 가정
x = img.unsqueeze(0).permute(0, 3, 1, 2)  # (1, 3, 559, 583)
w = nn.Conv2d(3, 16, (3, 3))
print(w(x).shape)                         # torch.Size([1, 16, 557, 581])
print(sum(p.numel() for p in w.parameters()))  # 16*3*3*3 + 16 = 448
나머지 옵션
그 뒤의 인자들은 논문에서 다양한 목적으로 convolution을 변형할 때 쓰는 장치이다. stride, padding, dilation은 아래에서 하나씩 자세히 보고, 나머지 둘만 여기서 정리한다.
groups: 채널을 쪼개서 따로 계산한다. 입력 3채널, 출력 21채널이면 기본값groups=1에서는 \(3 \times 3\) 패치가 입력 3 × 출력 21개 있다.groups=3이면 입력과 출력 채널을 세 묶음으로 나누어, 입력 1채널 → 출력 7채널 conv를 묶음마다 따로 한 뒤 결과를 이어 붙인다. 가중치 shape는 \((21, 3, 3, 3)\)에서 \((21, 1, 3, 3)\)으로 줄어든다.bias: 곱하고 더한 직후에 상수를 더할지 정한다. 출력이 입력에 온전히 비례하기를 원하면bias=False로 둔다.
Padding: shape 유지하기
kernel size \(k\)와 padding \(p\)에는 자주 쓰는 숫자 패턴이 있다.
\[k = 2p + 1\]이 식에는 두 가지 메시지가 담겨 있다.
첫째, kernel size는 홀수로 둔다. \(p = 0, 1, 2, 3, \dots\)이면 \(k = 1, 3, 5, 7, \dots\)로 항상 홀수이다. 홀수여야 가운데 샘플 하나를 두고 양쪽을 대칭으로 볼 수 있어서, 출력이 어느 입력 위치에 대응하는지(중심 픽셀)가 분명해진다. 짝수이면 가운데를 하나 빼고 나면 양쪽이 비대칭이라 중심이 정의되지 않는다. 짝수를 쓰면 안 된다는 규칙은 없지만 대부분 홀수로 쓴다.
둘째, padding은 kernel size를 2로 나눈 몫으로 둔다. padding은 계산할 때만 나열된 데이터의 양 끝에 임시 숫자(보통 0)를 붙이는 것이다. padding이 없으면 중심이 가장자리에 왔을 때 커널의 날개가 데이터 밖으로 나가 곱할 숫자가 없으므로, 커널 전체가 데이터 안에 들어가는 안쪽에서부터 계산을 시작해야 한다. 그러면
\[L_\text{out} = L_\text{in} - (k - 1)\]이 되어, 레이어를 쌓을수록 shape가 쪼그라든다. 커널의 가운데 1칸을 뺀 양 날개 \(k - 1\)만큼이 깎이는 것이다. 양쪽에 \(p\)개씩 붙이면 \(2p\)만큼 보충되므로, 깎이는 양 \(k - 1\)과 보충하는 양 \(2p\)를 같게 하면 shape가 그대로 유지된다. 그것이 \(k - 1 = 2p\), 즉 \(k = 2p + 1\)이다. kernel size 3이면 padding 1, kernel size 5이면 padding 2이다.
nn.Conv2d에서 padding=(2, 1)처럼 튜플로 주면 위아래에는 0을 두 개씩, 양옆에는 한 개씩 붙인다. kernel size \((5, 3)\)과 짝을 지으면 높이와 너비가 모두 유지된다.
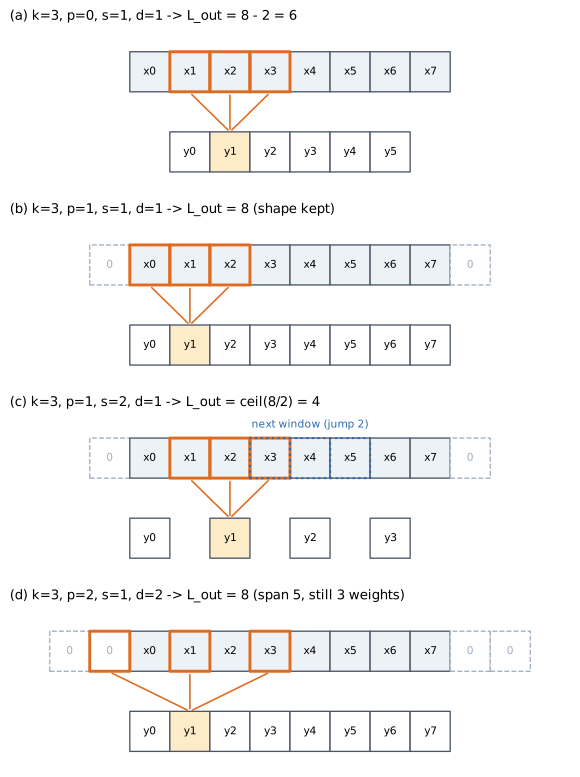 길이 8인 입력에 kernel size 3을 적용한 네 경우. 주황 테두리는 출력 \(y_1\)을 만드는 데 쓰인 입력 칸, 점선 칸은 0 padding이다. (a) padding이 없으면 2칸이 깎여 6이 된다. (b) 양쪽에 1칸씩 붙이면 8이 유지된다. (c) stride 2이면 창이 두 칸씩 뛰어 4가 된다. (d) dilation 2이면 같은 가중치 3개가 한 칸씩 건너 5칸 범위를 보고, padding 2로 8이 유지된다.
Stride: 비율로 줄이기
U-Net 같은 모델은 이미지나 시퀀스의 길이를 줄여 가며 분석한다. 길이를 줄이는 한 가지 방법은 padding을 빼는 것이다. 그러면 \(k - 1\)만큼 줄어든다. 문제는 이것이 상수만큼 줄어든다는 점이다. 길이 64를 32로 줄이려면 \(k = 33\)인 conv 하나나 \(k = 5\)인 conv 여덟 개(\(64 - 8 \times 4 = 32\))를 쓰면 되지만, 같은 모델에 길이 96이 들어오면 48이 아니라 64가 된다. “절반으로” 같은 비율로 줄이기는 kernel size로는 어렵다.
비율로 줄이는 도구가 stride이다. stride는 반복 계산의 간격, 즉 창을 한 번에 몇 칸씩 옮길지를 정한다. 기본값은 1이다. stride를 2로 두면 한 번 계산하고 두 칸 옮겨 다음 계산을 하므로 shape가 \(1/2\)로, \(s\)로 두면 \(1/s\)로 줄어든다. 출력 칸의 일부를 건너뛰는 셈이다.
나누어떨어지지 않으면 어떻게 될까? PyTorch 문서는 출력 길이를 다음과 같이 적는다.
\[L_\text{out} = \left\lfloor \frac{L_\text{in} + 2p - d(k - 1) - 1}{s} + 1 \right\rfloor\]\(s\)는 stride, \(d\)는 dilation(다음 절)이다. 복잡해 보이지만 실제로 쓰는 패턴만 남기면 단순해진다. \(d = 1\)이고 \(k = 2p + 1\)이면 \(2p - (k - 1) = 0\)이 되어 padding과 kernel size가 식에서 사라지고,
\[L_\text{out} = \left\lfloor \frac{L_\text{in} - 1}{s} \right\rfloor + 1 = \left\lceil \frac{L_\text{in}}{s} \right\rceil\]이 남는다. 즉 stride로 나누고, 나머지가 있으면 올림하면 된다. 길이 64에 stride 3이면 \(\lceil 64/3 \rceil = 22\)이다.
Dilation: 적은 파라미터로 넓게 보기
지금까지를 정리하면, 일반적인 CNN은 padding으로 kernel이 깎는 만큼을 막고, 필요하면 stride로 비율에 맞게 줄인다. dilation은 이 둘만큼 자주 쓰이지는 않지만, 학습 가능한 파라미터 수를 늘리지 않고 넓은 범위를 보게 해 주는 기법이다.
stride가 창을 띄엄띄엄 옮기는 것이라면, dilation은 창 안에서 입력을 띄엄띄엄 집는 것이다. dilation이 2이면 커널의 가중치들이 입력을 2칸 간격으로, 3이면 3칸 간격으로 곱한다.
\[y_t[o] = b[o] + \sum_{c=1}^{C_\text{in}} \sum_{j=0}^{k-1} W[o, c, j]\, x_{t + dj}[c]\]가중치는 여전히 \(k\)개인데 창이 덮는 범위는 \(d(k - 1) + 1\)로 넓어진다. 그래서 같은 파라미터 수로 더 넓은 receptive field를 확보할 수 있다.
shape 유지 공식
넓게 보는 대가로 깎이는 양도 커지므로 \(k = 2p + 1\)로는 shape가 유지되지 않는다. 앞의 원리를 다시 쓰면 된다. dilation이 없을 때 깎이는 양은 양 날개 \(k - 1\)이었다. dilation \(d\)이면 날개의 길이가 \(d\)배가 되어 \(d(k - 1)\)만큼 깎인다. 이것을 양쪽 padding \(2p\)로 보충하면
\[d(k - 1) = 2p\]이다. 예를 들어 \(k = 3\), \(d = 2\)이면 \(p = 2\), \(k = 3\), \(d = 4\)이면 \(p = 4\)이다. \(k\)가 홀수이면 \(k - 1\)이 짝수라서 어떤 \(d\)에도 정수 \(p\)가 나온다. 이렇게 맞추면 앞의 출력 길이 식에서도 \(2p - d(k - 1) = 0\)이 되어 역시 \(\lceil L_\text{in}/s \rceil\)이 된다.
쌓았을 때의 효과: WaveNet
dilation을 대표적으로 쓰는 모델이 음성 생성 모델 WaveNet이다. 첫 레이어는 dilation 1, 그 위는 2, 4, 8, 16, …처럼 2의 거듭제곱으로 키우며 쌓는다. stride 1인 conv를 \(L\)층 쌓으면 receptive field는
\[R = 1 + \sum_{l=1}^{L} d_l (k_l - 1)\]이다. 층마다 receptive field가 \(d_l(k_l - 1)\)씩 늘어나기 때문이다. kernel size 2를 4층 쌓을 때, dilation이 모두 1이면 \(R = 5\)이지만 1, 2, 4, 8이면 \(R = 16\)이다. kernel size 3, dilation 1, 2, 4, 8, 16인 5층이면 \(R = 1 + 2 \times 31 = 63\)으로, dilation 없는 5층의 \(R = 11\)보다 훨씬 넓다. 파라미터 수와 메모리는 그대로이다.
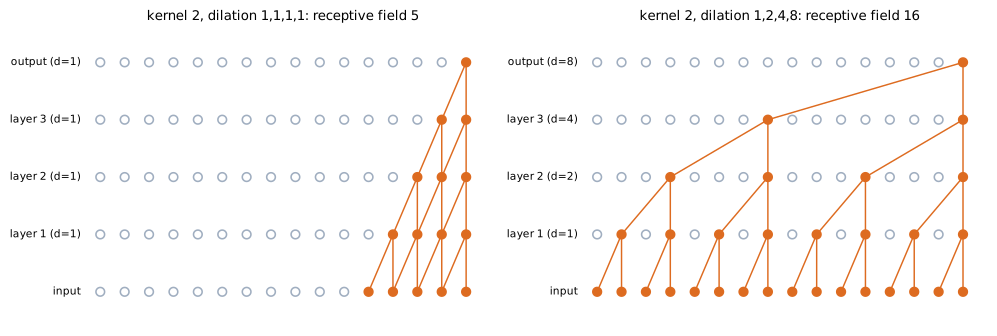 kernel size 2인 conv 4층(WaveNet처럼 과거 쪽만 보는 형태). 주황 점과 선은 맨 위 출력 하나에 영향을 주는 경로이다. dilation이 모두 1이면 입력 5개만 보지만(왼쪽), 1, 2, 4, 8로 키우면 같은 파라미터 수로 입력 16개 전체를 본다(오른쪽).
직접 확인하기
x = torch.randn(1, 3, 64)
for k, p, s, d in [(3, 0, 1, 1), (3, 1, 1, 1), (5, 2, 1, 1),
                   (3, 1, 2, 1), (3, 1, 3, 1), (3, 2, 1, 2), (3, 4, 2, 4)]:
    y = nn.Conv1d(3, 8, k, stride=s, padding=p, dilation=d)(x)
    print(f"k={k} p={p} s={s} d={d} -> {y.shape[-1]}")
# k=3 p=0 s=1 d=1 -> 62   (64 - 2)
# k=3 p=1 s=1 d=1 -> 64   (k = 2p + 1)
# k=5 p=2 s=1 d=1 -> 64
# k=3 p=1 s=2 d=1 -> 32   (ceil(64/2))
# k=3 p=1 s=3 d=1 -> 22   (ceil(64/3))
# k=3 p=2 s=1 d=2 -> 64   (d(k-1) = 2p)
# k=3 p=4 s=2 d=4 -> 32
이 규칙대로 kernel size, dilation, padding을 맞춰 두면, 효율적으로 넓은 receptive field를 가지면서 shape가 일정한 특징을 뽑는 모듈을 설계할 수 있다.
정리
| 인자 | 하는 일 | 자주 쓰는 규칙 | 출력 길이에 미치는 영향 |
|---|---|---|---|
| kernel size \(k\) | 한 번에 보는 인접 범위 | 홀수 | padding 없으면 \(k - 1\)만큼 감소 |
| padding \(p\) | 양 끝에 임시로 0을 붙임 | \(p = \lfloor k/2 \rfloor\), 즉 \(k = 2p + 1\) | 깎이는 양을 보충해 유지 |
| stride \(s\) | 창을 옮기는 간격 | 1 또는 2 | \(\lceil L/s \rceil\)로 비율 감소 |
| dilation \(d\) | 창 안에서 입력을 집는 간격 | 층마다 1, 2, 4, 8, … | \(2p = d(k - 1)\)이면 유지 |
- CNN은 인접한 위치까지 확장된 범위의 행렬곱이다. 같은 가중치를 모든 위치에서 재사용하며, 위치마다 따로 계산하는 Linear와 달리 이웃 사이의 관계(변화량, 윤곽 등)를 정보로 뽑을 수 있다.
- 입력 shape는 (batch, channel, 나열된 차원들) 순서이고,
Conv2d(in, out, k)의 가중치는 \((C_\text{out}, C_\text{in}, k_h, k_w)\)이다. - 일반 출력 길이: \(L_\text{out} = \lfloor (L_\text{in} + 2p - d(k - 1) - 1)/s + 1 \rfloor\). 위 규칙대로 쓰면 \(\lceil L_\text{in}/s \rceil\)로 단순해진다.