- 임커밋의 딥러닝 / 머신러닝 강의 정리
준비: 텐서의 세 가지 성질
▶ Attention/Transformer 시각화로 설명
attention을 보기 전에, 정보를 담은 텐서(벡터)에 대해 세 가지 성질을 직관적으로 정리해 둔다.
1. weight 행렬을 통과해도 정보는 남는다. 어떤 정보를 나타내는 벡터 \(\mathbf{x}\)에 행렬 \(W\)를 곱한 \(W\mathbf{x}\)에도 원래 \(\mathbf{x}\)의 정보가 (다른 좌표계로 표현되어) 남아 있다.
2. 가중치 합(weighted sum)은 정보를 섞는다. 서로 다른 정보 \(\mathbf{v}_1, \dots, \mathbf{v}_n\)을 가중치 \(a_i\)로 더한다. 여기서는 가중치가 모두 양수이고 합이 1인 경우만 생각한다.
\[\mathbf{o} = \sum_{i=1}^{n} a_i \mathbf{v}_i, \qquad a_i \ge 0, \quad \sum_{i=1}^{n} a_i = 1\]결과 \(\mathbf{o}\)는 가중치가 큰 쪽의 정보를 더 많이 담는다. 합이 1로 고정되어 있으므로 한 가중치가 커지면 나머지는 작아질 수밖에 없다. 즉 “어떤 정보를 많이 담는다”는 것은 “나머지 정보는 그만큼 덜 담는다”는 뜻이다. 가중치가 모두 같으면(\(a_i = 1/n\)) 결과는 모든 정보의 중간 지점, 즉 평균이 된다.
3. 내적(dot product)은 유사도를 잰다. 같은 차원의 두 벡터의 성분끼리 곱해서 더한 \(\mathbf{q} \cdot \mathbf{k} = \sum_j q_j k_j\)는 두 벡터가 같은 방향일수록 크다. 약간의 비약을 허용하면, 서로 관련된 정보끼리는 내적이 크고 관련 없는 정보끼리는 상대적으로 작다고 볼 수 있다.
Attention은 가중치 합이다
계산 과정
query 벡터 하나 \(\mathbf{x}\)와, 서로 다른 정보를 가진 벡터 \(n\)개 \(\mathbf{y}_1, \dots, \mathbf{y}_n\)이 있다고 하자. (여러 query를 한꺼번에 다루는 것은 이것을 query마다 반복한 것이다.) 먼저 각각을 weight 행렬에 통과시킨다.
\[\mathbf{q} = W_Q \mathbf{x}, \qquad \mathbf{k}_i = W_K \mathbf{y}_i, \qquad \mathbf{v}_i = W_V \mathbf{y}_i\]query \(\mathbf{q}\)와 key \(\mathbf{k}_i\)는 \(d_k\)차원, value \(\mathbf{v}_i\)는 \(d_v\)차원이다. key와 value는 같은 \(\mathbf{y}_i\)에서 나온다는 점에 주의한다. 이제 세 단계를 거친다.
- 내적으로 유사도 구하기. query와 각 key를 내적해 점수 \(s_i = \mathbf{q} \cdot \mathbf{k}_i\)를 얻는다. key마다 query와 얼마나 비슷한 방향인지를 잰 것이다.
- 점수를 가중치로 바꾸기. 점수는 음수일 수도 있고 합이 1도 아니다. 가중치 합에 쓰려면 “클수록 관련이 크다”는 순서를 유지하면서 모두 양수로, 합은 1로 만들어야 한다. 지수 함수 \(e^{s}\)는 음수를 포함한 모든 값을 양수로 올리면서 순서를 보존한다. 그다음 전체 합으로 나누면 합이 1이 된다. 이 두 단계를 합친 것이 softmax이다.
- value를 가중치 합하기.
예를 들어 key 네 개와의 점수가 \((1.7, -1.3, 3.9, 0.3)\)이면 \(\exp\)는 \((5.47, 0.27, 49.40, 1.35)\), 합은 \(56.50\)이고, 가중치는 \((0.097, 0.005, 0.874, 0.024)\)이다. 결과는 세 번째 value를 대부분 담고, 첫 번째를 조금, 나머지는 거의 담지 않은 벡터가 된다.
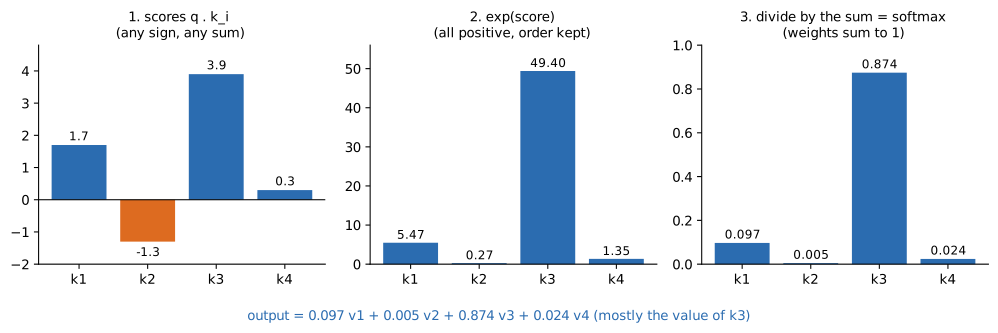 점수가 attention 가중치가 되는 과정. 음수 점수(주황)도 \(\exp\)를 거치면 양수가 되고, 큰 점수는 더 크게 벌어진다. 합으로 나누면 가중치의 합이 1이 되고, 출력은 가중치가 큰 \(\mathbf{v}_3\)에 가깝다.
실제 Transformer에서는 점수를 \(\sqrt{d_k}\)로 나눈 scaled dot-product를 쓴다. \(\mathbf{q}\)와 \(\mathbf{k}\)의 성분이 서로 독립이고 평균 0, 분산 1이면 내적 \(\sum_{j=1}^{d_k} q_j k_j\)의 분산은 \(d_k\)이다. 차원이 크면 점수의 크기가 커져 softmax가 한 key에만 거의 1을 주는 포화 상태가 되고 gradient가 작아지므로, \(\sqrt{d_k}\)로 나누어 분산을 1로 맞춘다. query가 여러 개이면 행렬로 한꺼번에 쓸 수 있다.
\[\operatorname{Attention}(Q, K, V) = \operatorname{softmax}\!\left(\frac{QK^\top}{\sqrt{d_k}}\right) V\]\(Q \in \mathbb{R}^{n_q \times d_k}\), \(K \in \mathbb{R}^{n \times d_k}\), \(V \in \mathbb{R}^{n \times d_v}\)의 각 행이 query, key, value이고, softmax는 행마다(각 query마다 key 방향으로) 적용한다. 결과는 \(n_q \times d_v\), 즉 query 하나당 벡터 하나이다.
결과는 누구의 정보인가
attention의 결과는 본질적으로 query의 정보일까, key들의 정보일까? 영어 단어 “orange”의 벡터가 query이고, 한국어 단어 네 개의 벡터가 key라고 하자. 가중치가 (오렌지 0.7, 주황 0.25, 나머지 합 0.05)로 나왔다면, 결과는 “오렌지”를 0.7, “주황”을 0.25만큼 담은 벡터이다. query는 영어의 정보 공간에 있었지만, 결과는 한국어 정보 공간에 있다. 결과가 value의 가중치 합이고, value는 key와 같은 쪽(\(\mathbf{y}_i\))에서 왔기 때문이다.
정리하면 attention의 결과는 key 쪽 정보를 섞은 것이고, query는 섞는 비율을 통해서만 간접적으로 반영된다. 섞는 비율은 query가 각 key와 얼마나 비슷한지로 정해진다.
이름이 query인 이유도 여기서 보인다. IT에서 query는 정보를 요청하는 것, 좁게는 검색어이다. 검색 엔진은 query를 받아 저장된 페이지들 중 관련된 것을 찾아 보여 준다. attention도 query를 넣으면 key들 중 관련된 것의 정도(가중치)를 구하고, 그 value들을 결과로 내놓는다. 차이는 검색 엔진은 관련도 순서대로 결과를 나열하고, attention은 관련도를 비율로 해서 value를 섞는다는 점이다.
import math
import torch
import torch.nn.functional as F

def attention(q, k, v, mask=None):
    """q: (..., n_q, d_k), k: (..., n, d_k), v: (..., n, d_v)"""
    scores = q @ k.transpose(-2, -1) / math.sqrt(q.size(-1))   # (..., n_q, n)
    if mask is not None:                                        # mask: True = 볼 수 있음
        scores = scores.masked_fill(~mask, float("-inf"))
    w = scores.softmax(dim=-1)                                  # 각 행의 합 = 1
    return w @ v, w

torch.manual_seed(0)
d_model, d_k = 8, 4
W_Q, W_K, W_V = (torch.nn.Linear(d_model, d_k, bias=False) for _ in range(3))
x = torch.randn(1, d_model)       # query 쪽 벡터 1개
y = torch.randn(4, d_model)       # key/value 쪽 벡터 4개
out, w = attention(W_Q(x), W_K(y), W_V(y))
print(w, w.sum())                 # 가중치 4개, 합 1
print(torch.allclose(out, F.scaled_dot_product_attention(W_Q(x), W_K(y), W_V(y))))  # True
순서와 맥락 정보 넣기
지금까지의 attention 계산에는 두 가지 구멍이 있다. 둘 다 같은 원인에서 나온다. 가중치를 구할 때 query와 각 key를 하나씩 따로 내적한다는 점이다.
순서를 모른다: positional encoding
“인도 카레 가게에 갔다”를 번역한다고 하자. key는 각 단어의 벡터이다. 그런데 “인도”를 첫 번째에 놓고 내적하든 네 번째에 놓고 내적하든 내적 값은 똑같다. key와 value를 같은 순서로 섞어도 가중치 합의 각 항은 그대로이므로 결과가 변하지 않는다. 식으로 쓰면, 임의의 순열(permutation) \(\pi\)에 대해
\[\sum_{i=1}^{n} a_{\pi(i)} \mathbf{v}_{\pi(i)} = \sum_{i=1}^{n} a_i \mathbf{v}_i\]이다. 즉 attention만으로는 “첫 번째 단어가 인도이다”라는 정보가 사라진다. 어순이 바뀌면 강조점이 달라지는 문장도 attention에게는 똑같아 보인다.
그래서 Transformer는 입력의 맨 처음에 positional encoding을 더한다. 위치마다 정해진 “위치 표시용 벡터”가 있어서, 문장의 첫 번째 단어 벡터에는 항상 1번 벡터를, 두 번째 단어에는 항상 2번 벡터를 더하는 식이다. 그러면 같은 “인도”라도 첫 번째에 있을 때와 네 번째에 있을 때 벡터가 달라져 순서 정보가 들어간다. (구체적으로 어떤 벡터를 쓰는지는 다음 강의의 주제이다.)
perm = torch.tensor([2, 0, 3, 1])
k, v = W_K(y), W_V(y)
out_perm, _ = attention(W_Q(x), k[perm], v[perm])
print(torch.allclose(out, out_perm, atol=1e-6))   # True: key 순서를 섞어도 결과가 같다
맥락을 모른다: self-attention
순서 정보를 넣어도 해결되지 않는 문제가 있다. 다음 두 문장을 보자.
- “인도 카레 가게에 갔다” — 인도는 나라 이름(India)이다.
- “인도 위로만 걸어 다녔다” — 인도는 보행로(sidewalk)이다.
두 “인도”는 글자도 같고 위치도 둘 다 첫 번째이다. 내적은 주변 단어를 보지 않고 개별 단어 벡터끼리만 계산하므로, 내적과 positional encoding만으로는 두 “인도”가 다르게 번역되어야 한다는 것을 반영할 수 없다. 단어를 해석할 때 주변 단어로 맥락을 살피는 장치가 필요하다.
그 장치가 self-attention이다. query와 key/value로 같은 시퀀스를 쓰는 attention을 self-attention이라고 한다. “인도 카레 가게에 갔다”의 단어 각각이 query가 되어, 같은 문장의 모든 단어(자기 자신 포함)를 key/value로 삼아 가중치 합을 구한다. 이 레이어를 한 번 지나고 나면 “인도” 자리의 벡터는 더 이상 “인도”라는 한 단어의 정보만이 아니라, 문장 속 다른 단어들과의 관련도가 반영된 정보, 예를 들어 “카레”의 정보가 섞인 “인도”가 된다.
Transformer의 encoder 레이어는 self-attention과 FFN(feed-forward network)으로 이루어져 있다. FFN은 위치마다 따로 적용하는 Linear와 활성화 함수의 조합이다. 이 레이어를 여러 번 쌓으면 각 단어 벡터에 문장 전체의 맥락이 점점 더 반영된다. 번역할 때 decoder가 encoder 출력 중 “인도” 자리를 본다는 것은, “인도”라는 단어 하나가 아니라 바로 뒤에 “카레 가게”가 따라온다는 맥락까지 담긴 벡터를 본다는 뜻이다.
요약하면 attention 자체는 위치 정보도, 주변 맥락 정보도 없는 가중치 합이다. Transformer는 위치 정보를 넣으려고 처음에 positional encoding을 더하고, 맥락 정보를 넣으려고 self-attention이 들어간 레이어를 쌓는다.
Transformer의 번역 방식과 masking
▶ Masked attention 쉽게 설명하기.. 쉽지 않네
Transformer를 처음 공부할 때는 원래의 기본 구조를 잘 알아 두는 것이 중요하다. 이후의 많은 변형은 기본 구조에 무엇을 더한 것이 아니라 무엇을 뺀 것이라서, 원래 구조를 알면 무엇을 왜 뺐는지 쉽게 파악할 수 있다.
번역을 어떤 순서로 할까
Transformer의 기본 task는 번역, 즉 A 언어의 문장을 B 언어의 문장으로 바꾸는 것이다. “나는 학생이다”를 영어로 번역하는 과정을 학습은 잊고 생각해 보자. 번역 전에는 영어 문장을 모르지만 한국어 문장의 정보는 전부 가지고 있다. 이때 영어 문장의 세 번째 단어부터 맞히라고 하면, 앞 단어도 모르는 채로 맞혀야 하므로 어렵다. 반면 첫 단어는 “I”일 것이라고 합리적으로 추측할 수 있고, 그다음은 “I” 뒤에 올 동사를 추측하면 된다. 이렇게 첫 단어부터 순서대로 예측하는 것이 자연스럽다.
Transformer도 그렇게 번역한다.
- 번역할 한국어 문장은 encoder에 넣어 전부 사용한다. encoder 출력은 decoder 중간에 있는 attention(cross-attention)의 key와 value로 들어가 한국어 문장의 정보를 전달한다.
- 영어 문장의 \(n\)번째 단어를 예측할 때는 \(n-1\)번째 단어까지를 decoder에 입력하고, 그 마지막 위치의 출력으로 \(n\)번째 단어를 예측한다. 이렇게 앞의 출력을 다음 입력으로 다시 넣으며 하나씩 생성하는 방식을 자기회귀(autoregressive) 생성이라고 한다.
- 첫 단어를 예측할 때는 넣을 단어가 없으므로, 실제 언어에는 없는 문장 시작 토큰
<bos>를 넣는다. 마찬가지로 문장 끝 토큰<eos>를 정해 두고, 이것이 예측되면 생성을 멈춘다. 두 토큰은 완성된 문장에서 뺀다.
한 번에 학습하기: 오른쪽으로 한 칸 밀기
학습도 같은 방식으로 “\(n-1\)번째까지 넣고 \(n\)번째를 정답으로” 주면 된다. 그런데 정답 문장이 “I am a student”이면 이것을 네 번 따로 돌릴 필요 없이 한 번에 병렬로 학습하는 방법이 있다. decoder 입력은 앞에 <bos>를 붙여 한 칸 오른쪽으로 밀고, 정답은 끝에 <eos>를 붙인다.
| 위치 | 1 | 2 | 3 | 4 | 5 |
|---|---|---|---|---|---|
| decoder 입력 | <bos> |
I | am | a | student |
| 정답 | I | am | a | student | <eos> |
decoder 출력은 입력 길이만큼 나오므로, 위치 \(n\)의 출력에 정답 \(n\)을 주면 다섯 개의 “다음 단어 예측” 문제를 한 번에 학습하는 셈이다. 학습 때 정답 문장을 입력으로 넣어 주는 이 방식을 teacher forcing이라고 한다.
문제: 미래 단어를 엿본다
이대로 학습하면 심각한 문제가 생긴다. decoder 안에도 self-attention이 있어서, 각 위치의 출력은 decoder 입력 전체의 가중치 합을 거쳐 나온다. 예를 들어 “am”을 정답으로 받는 위치 2의 출력에도 <bos>, I, am, a, student 다섯 단어의 정보가 모두 섞여 있다. 정답 “am”이 입력에 그대로 들어 있으니 그냥 베끼면 된다.
맥락을 반영하는 것은 문장 분석에 도움이 되지만, 학습할 때 미래 단어의 정보를 맥락으로 쓰는 것은 명백히 문제이다. 실제로 번역할 때는 번역 결과인 영어 문장을 미리 알 수 없기 때문이다. 영어 문장을 예측하는 재료로 그 영어 문장을 주는 것은 모순이다. 위치 \(n\)의 query는 위치 \(1, \dots, n\)의 key/value만 써야 한다. “am”을 예측하는 위치 2는 <bos>와 I만, “a”를 예측하는 위치 3은 <bos>, I, am만 보아야 한다.
해결: causal mask
이렇게 미래 단어를 가리는 가림막이 masking이다. 내적은 일단 모든 key와 다 계산하되, query 위치 \(i\)보다 뒤에 있는 key(\(j > i\))의 점수를 절댓값이 아주 큰 음수(이론적으로 \(-\infty\))로 바꾼다. 그러면 \(\exp\)를 거친 값이 사실상 0이 되어, 미래 단어의 가중치는 0이 되고 앞 단어들의 가중치는 자기들끼리 합이 1이 되도록 다시 나누어진다.
\[M_{ij} = \begin{cases} 0 & j \le i \\ -\infty & j > i \end{cases}, \qquad \operatorname{softmax}\!\left(\frac{QK^\top}{\sqrt{d_k}} + M\right) V\]마스크가 하삼각(lower-triangular) 모양이라서 causal mask라고도 부른다. 그 결과, 한 번에 문장 전체를 넣더라도 각 위치는 마치 자기까지의 단어들만으로 self-attention을 한 것처럼 계산된다.
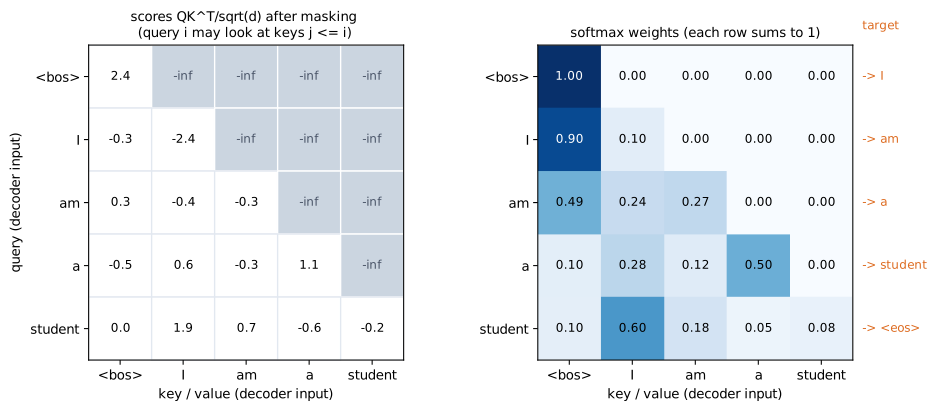 decoder self-attention의 점수(왼쪽)와 가중치(오른쪽). 대각선 위의 미래 위치는 \(-\infty\)로 가려져 가중치가 0이 된다. 각 행(query)은 자기 위치까지의 단어만 섞고, 오른쪽에 적힌 다음 단어를 예측한다. 점수 값은 예시용 난수이다.
n = 5
causal = torch.tril(torch.ones(n, n, dtype=torch.bool))    # j <= i 만 True
q = k = v = torch.randn(n, d_k)                            # self-attention: 같은 시퀀스
out, w = attention(q, k, v, mask=causal)
print(w.triu(diagonal=1).abs().max())                      # 0: 미래 위치의 가중치
print(torch.allclose(out, F.scaled_dot_product_attention(q, k, v, is_causal=True), atol=1e-6))  # True
정리하면, encoder는 번역할 문장 전체를 보고, decoder는 masking 덕분에 학습할 때나 실제로 번역할 때나 \(n-1\)번째까지의 단어만으로 \(n\)번째 단어를 예측한다. masking의 역할은 학습할 때의 정보 상황을 실제 사용할 때와 똑같이 맞추는 것이다.
Query, key, value 중 성질이 다른 하나는?
“query, key, value 중 성질이 가장 다른 것은 무엇이고, 왜 그런가?”라는 질문에는 정답이 하나로 정해져 있지 않지만, 근거를 대며 답할 수 있는 관점이 두 가지 있다.
관점 1: query가 다르다 (역할과 도메인). key와 value는 정보를 찾을 후보이고, query는 정보를 찾는 주체이다. 검색에 비유하면 우리가 입력하는 검색어가 query이고, 이미 인터넷에 자리 잡은 정보들이 key와 value이다. Transformer의 cross-attention에서 이 차이가 분명하다. key와 value는 encoder 출력이고, query는 decoder 쪽 시퀀스이다. 한국어를 영어로 번역하면, <bos>가 query가 되어 한국어 토큰들(key/value) 중 무엇과 관련 있는지 계산하고, 그 가중치 합으로 첫 단어를 예측한다. 예측된 단어가 다시 다음 query가 된다. 이때 query는 영어 도메인, key와 value는 한국어 도메인이다.
관점 2: value가 다르다 (학습되는 의미). attention의 출력은 value의 가중치 합이다. 식 \(\sum_i a_i \mathbf{v}_i\)에 value는 직접 나타나지만, query와 key는 가중치 \(a_i\) 안에 녹아 있을 뿐이다. 즉 query와 key는 두 정보가 얼마나 관련되어 있는지에 대응하는 가중치를 만들도록 학습되고, value는 학습 중인 task 자체에 필요한 정보(번역이라면 번역에 필요한 정보)를 담도록 학습된다. 학습되는 의미가 다르다는 점에서 value를 고를 수 있다.
정리
| 구성 요소 | 하는 일 |
|---|---|
| query, key | 내적으로 관련도를 재서 가중치를 만든다 |
| softmax | 점수를 양수로, 합이 1이 되도록 바꾼다 (순서 유지) |
| value | 가중치 합으로 섞이는 실제 정보이다 |
| positional encoding | attention에 없는 순서 정보를 입력에 더한다 |
| self-attention | 같은 시퀀스끼리 attention해서 맥락 정보를 넣는다 |
| cross-attention | decoder의 query로 encoder 출력(key/value)에서 정보를 가져온다 |
| causal mask | decoder가 미래 단어를 보지 못하게 해서 학습과 추론의 조건을 맞춘다 |
- attention은 query와 key의 유사도를 비율로 해서 value를 섞는 가중치 합이다. 결과는 key/value 쪽 정보 공간에 있다.
- query와 각 key를 따로 내적하기 때문에 attention만으로는 순서와 맥락을 모른다. Transformer는 이를 positional encoding과 self-attention 레이어로 보완한다.
- decoder는
<bos>로 한 칸 민 입력과<eos>를 붙인 정답으로 모든 위치를 병렬로 학습하고, causal mask로 미래 정보를 차단한다.