- 임커밋의 딥러닝 / 머신러닝 강의 정리
생성이란 확률 분포에서 샘플링하는 것
생성 모델 논문에는 “정답 분포 \(p\)는 다루기 어려우므로(intractable) 샘플링하기 쉬운 분포 \(q\)를 만들어 \(p\)에 근사(approximate)한다”는 문장이 자주 나온다. 아는 단어로만 이루어져 있는데 논리가 잘 이해되지 않는다. 모른다는 \(p\)에 어떻게 근사한다는 것일까? 이 문장을 이해하려면 먼저 이미지 생성에서 분포(distribution)와 샘플링(sampling)이 무슨 뜻인지 정리해야 한다.
균등 분포(uniform distribution) \(U(0, 1)\)은 0과 1 사이의 실수가 뽑힐 확률이 모두 같은 분포이다. 여기서 한 번 샘플링하면 숫자 하나가 나온다. 분포의 식을 알면 그 분포대로 샘플링할 수 있다는 사실을 깔고 시작한다.
- 독립인 \(U(0, 1)\) 세 개에서 하나씩 뽑으면 숫자 세 개가 나온다. 이것을 RGB로 읽으면 샘플링할 때마다 아무 색이나 하나 나온다.
- \(32 \times 32\) 픽셀 각각에 대해 이렇게 하면, 즉 독립인 균등 분포 \(32 \times 32 \times 3 = 3072\)개에서 뽑으면 \(32 \times 32\) 이미지가 하나 생성된다. 하지만 그것은 의미 없는 노이즈이다. 몇 년을 뽑아도 고양이처럼 패턴이 있는 그림이 나올 확률은 사실상 0이다.
분포에 정보를 조금 넣으면 의도한 그림에 조금 가까워진다.
- 모든 픽셀의 파란 성분을 \(U(0.9, 1)\)에서 뽑으면 매번 전체적으로 파란 이미지가 나온다.
- 위쪽 절반은 \(U(0.5, 1)\), 아래쪽 절반은 \(U(0, 0.5)\)에서 뽑으면 매번 위가 밝고 아래가 어두운 이미지가 나온다.
그렇다면 “고양이 모양 이미지가 나오는 분포” \(p_{\text{data}}(\mathbf{x})\)가 있다면 거기서 샘플링해서 고양이 그림을 얻을 수 있을 것이다. 세상에 고양이 그림이 많으니 그런 분포는 어딘가 존재하겠지만, 3072개 숫자에 대한 그 분포의 식은 알 수 없고, 식을 모르니 샘플링도 할 수 없다. 이것이 “intractable하다”는 말의 뜻이다.
실마리는 데이터이다. 우리가 가진 고양이 이미지들 \(\mathbf{x}^{(1)}, \dots, \mathbf{x}^{(N)}\)이 \(p_{\text{data}}\)에서 뽑힌 샘플이라고 가정한다. 식은 몰라도 샘플은 있으므로, 샘플링하기 쉬운 분포에서 출발해 이 샘플들을 잘 만들어 내도록 모델 \(p_\theta\)를 학습시키면 \(p_\theta \approx p_{\text{data}}\)가 된다. 완벽하지 않아도 고양이 그림을 잔뜩 뽑을 수 있으면 충분하다. “모르는 \(p\)에 근사한다”는 말은 이렇게 샘플을 통해 간접적으로 근사한다는 뜻이다. VAE, flow, diffusion은 이 근사를 하는 서로 다른 방법이다.
인코더: 가정을 이용한 압축
VAE(variational autoencoder)를 알려면 오토인코더(autoencoder, AE)를 알아야 하고, 오토인코더를 알려면 encoder를 알아야 한다.
버튼 열 개
0번부터 9번까지 버튼이 10개 있고, 어떤 버튼이 눌렸는지 저장하려 한다. 그대로 저장하면 버튼마다 눌림(1)/안 눌림(0)으로 비트 10개가 필요하다. 그런데 “항상 정확히 하나만 눌린다”는 가정이 있으면 가능한 경우는 10가지뿐이므로, 이진수로 0000(0번)부터 1001(9번)까지 비트 4개면 충분하다(\(2^4 = 16 \ge 10\)).
- 이렇게 정보를 더 적은 숫자로 표현하는 것이 인코딩(encoding)이고, 이를 수행하는 회로나 알고리즘, 모델이 encoder이다.
- 인코딩은 원래 정보로 되돌릴 수 있어야 의미가 있다.
0011을 보고 “3번 버튼”이라고 복원하는 것이 디코딩(decoding)이고, 그 주체가 decoder이다.
이미지도 같다. \(32 \times 32\) RGB 이미지는 숫자 3072개이다. 이를 512개 숫자로 나타내고, 그 512개에서 원래의 3072개를 되살릴 수 있으면 인코딩과 디코딩을 한 것이다.
인코더에 대해 기억할 두 가지
1. 더 적은 숫자로 줄이려면 가정이 필요하다. 버튼 여러 개를 동시에 누를 수 있다면 가능한 경우가 \(2^{10} = 1024\)가지이므로 비트 4개로는 구별할 수 없다. 숫자 3072개가 가질 수 있는 모든 경우를 512개로 표현하는 것도 원리적으로 불가능하다. 하지만 고양이 이미지에는 패턴이 있다. 예를 들어 “인접한 픽셀은 RGB 값이 거의 같다”, “가운데에 둥근 물체가 있다” 같은 가정이 있으면 실제로 나타나는 경우의 수가 크게 줄어, 더 적은 숫자로도 표현할 수 있다. 데이터가 실제로 갖는 경우의 수를 줄여 주는 가정이 인코딩을 가능하게 한다.
2. 인코딩 공식은 하나가 아니다. 버튼 번호를 차례대로 이진수에 대응시킬 필요는 없다. 0번을 0100, 1번을 0011처럼 무작위로 대응시켜도 서로 겹치지만 않으면, 그에 맞는 decoder를 만들 수 있다. 꼭 4비트일 필요도 없어서 5비트로 대응시켜도 된다. 같은 데이터에 대해 유효한 encoder–decoder 쌍은 많다.
오토인코더: 규칙을 자동으로 찾기
손으로 설계한 인코더
숫자 두 개 \((x, y)\)로 이루어진 데이터 100개를 숫자 하나로 인코딩해 보자. 숫자만 들여다보면 규칙이 보이지 않지만 평면에 점으로 찍어 보면 보인다. 점들이 두 개의 곡선 위에 놓여 있다.
곡선의 식을 알면 \(x\)만 저장해도 \(y\)를 복원할 수 있다. 다만 두 곡선이 겹치는 \(x\) 구간에서는 어느 곡선인지 알 수 없으므로, 위 곡선의 점은 왼쪽으로, 아래 곡선의 점은 오른쪽으로 치우쳐 저장하면 된다. 이를 위해 두 영역을 가르는 경계가 필요하다. 사인 함수의 진폭, 주기, 위치를 손으로 맞춰서 경계를 만들고, 다음 규칙으로 인코딩한다.
\[\text{code}(x, y) = \begin{cases} x - 2 & y > 0.2\sin(3x + 0.5) \\ x + 1 & \text{otherwise} \end{cases}\]디코딩은 반대로 한다. code가 음수면 위 곡선의 점이므로 \(x = \text{code} + 2\), 양수면 아래 곡선의 점이므로 \(x = \text{code} - 1\)로 되돌린다. 그런데 \(y\)를 계산하려면 곡선의 식이 필요한데, 정확한 식은 모른다. 그래서 가장 익숙한 2차 함수로 적당히 흉내 낸다.
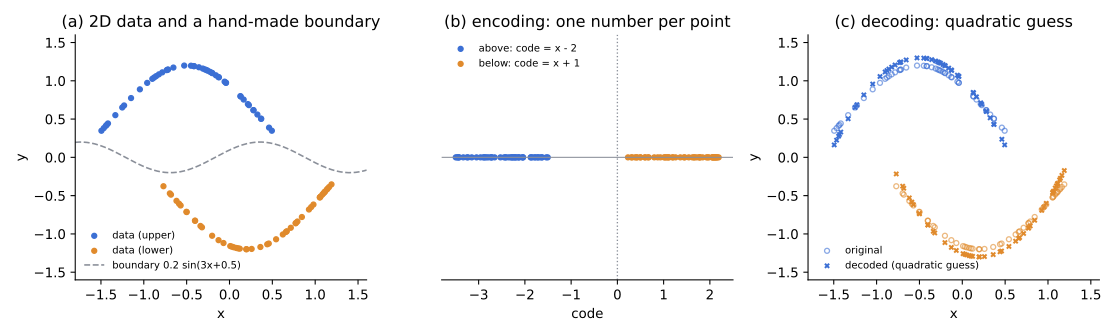 (a) 두 곡선 위의 2차원 데이터와 손으로 맞춘 사인 경계. (b) 경계 위쪽 점은 \(x - 2\), 아래쪽 점은 \(x + 1\)로 보내 숫자 하나로 인코딩한다. (c) 2차 함수라는 가정으로 디코딩하면(×) 원래 점(○)과 비슷하지만, 실제 곡선은 2차 함수가 아니므로 양 끝과 꼭대기에서 어긋난다.
수동 설계에는 두 가지 단점이 있다.
- 복잡하고 귀찮다. 2차원 데이터에도 사인 함수와 2차 함수를 직접 맞춰야 했다. 3072차원 이미지의 규칙을 사람이 찾는 것은 사실상 불가능하고, 데이터가 “만화 스타일 고양이”로 바뀌면 처음부터 다시 찾아야 한다.
- 가정이 틀리면 오차가 크다. 이것이 더 중요하다. “곡선은 2차 함수”라는 가정이 틀렸기 때문에 그림 (c)처럼 복원이 정확하지 않다.
오토인코더
오토인코더의 “오토(auto)”는 규칙, 즉 가정을 찾아 공식을 만드는 과정을 자동으로 한다는 뜻이다. 구조는 다음과 같다.
- 입력과 출력의 차원은 같다.
- 중간에 입력보다 차원이 작은 층, 병목(bottleneck)이 있다. 여기의 값이 잠재 변수(latent variable) 또는 인코딩 \(\mathbf{z}\)이다.
- 학습 목표는 출력이 입력과 같아지는 것이다.
Encoder \(E_\phi\)와 decoder \(D_\theta\)의 파라미터를 \(\phi, \theta\)라 하면
\[\mathbf{z} = E_\phi(\mathbf{x}), \qquad \hat{\mathbf{x}} = D_\theta(\mathbf{z}), \qquad \mathcal{L}_{\text{AE}} = \lVert \mathbf{x} - \hat{\mathbf{x}} \rVert^2\]이다. 이 손실을 재구성 손실(reconstruction loss)이라 한다.
병목이 핵심이다. 위의 2차원 예에서 모든 층의 너비가 2 이상이면, 네트워크는 두 숫자를 그대로 통과시키는 항등 함수를 배우면 된다. 손실은 0이 되지만 인코딩은 입력 자신이므로 의미가 없다. 중간에 너비가 1인 층이 있으면 그럴 수 없으므로, 네트워크는 데이터가 따르는 규칙을 찾아 경우의 수를 줄이고, 그 하나의 숫자에서 최대한 복원하는 decoder를 함께 학습한다. 사람이 운전하는 수동 변속기는 설명할 것이 많지만 자동 변속기는 “엑셀을 밟으면 간다”로 충분한 것처럼, “자동”에 대해서는 이 이상 설명할 것이 많지 않다.
오토인코더는 생성 모델인가
생성은 쉬운 분포에서 샘플링하는 것이었다. 데이터 \(\mathbf{x}\)의 분포는 너무 복잡해서 직접 샘플링할 수 없다. 하지만 인코딩 \(\mathbf{z}\)를 쉬운 분포에서 뽑을 수 있다면, 그것을 decoder에 통과시켜 고양이 이미지를 얻을 수 있을 것이다.
문제는 \(\mathbf{z}\)가 어떤 분포를 따르는지 모른다는 것이다. 인코딩 규칙은 모델이 알아서 학습했으므로, \(\mathbf{z}\)가 균등 분포나 0 근처의 가우시안처럼 샘플링하기 좋게 모여 있다는 보장이 없다. 그래서 오토인코더만으로는 생성 모델이라 하기 어렵다. VAE는 여기에 “variational”이라는 기술을 더해 이 문제를 푼다.
오토인코더에 시련 주기: VAE
첫 시도: 인코딩을 0 근처로 모으기
단순하게, \(\mathbf{z}\)를 0 근처로 모으는 손실을 추가해 보자.
\[\mathcal{L} = \lVert \mathbf{x} - D_\theta(E_\phi(\mathbf{x})) \rVert^2 + \lambda \lVert E_\phi(\mathbf{x}) \rVert^2\]두 번째 항만 있으면 모든 \(\mathbf{z}\)가 0이 되어 버리지만, 그러면 복원이 불가능해 첫 번째 항이 커진다. 두 항이 균형을 이루는 선에서 \(\mathbf{z}\)의 크기가 작아진다.
학습 후 \(\mathbf{z}\)가 대충 0 근처에 모였으니, 평균 0인 가우시안 \(\mathcal{N}(\mathbf{0}, I)\)에서 \(\mathbf{z}\)를 뽑아 encoder를 건너뛰고 decoder에 넣어 보자. MNIST에서 해 보면 숫자 비슷한 것이 나오기도 하지만, 숫자가 아닌 것도 많이 나온다.
근본적인 이유는 학습과 생성의 불일치이다. 생성은 확률적으로 뽑은 \(\mathbf{z}\)에서 출발하는데, 학습에는 확률적으로 무언가를 뽑는 단계가 전혀 없다. decoder는 데이터셋의 이미지가 인코딩된 바로 그 점들에서만 복원을 잘하면 손실이 최소가 된다. 샘플링될 수 있는 나머지 수많은 점에서 무엇이 나올지는 학습 목표에 없다. 아래 그림 (a), (b)처럼, 인코딩들은 가늘고 띄엄띄엄 모여 있어서 \(\mathcal{N}(\mathbf{0}, I)\)에서 뽑은 점(×)은 대부분 decoder가 한 번도 본 적 없는 빈 공간에 떨어진다.
인코딩에 노이즈를 섞는다
VAE의 해법은 용어(variational Bayes, variational inference)만 보면 어지럽지만, 적용 방식은 단순하다. 인코딩에 노이즈를 섞어서 decoder에 넣는다. 그러면 decoder는 인코딩 점 하나가 아니라 그 근처의 점들에서도 자기 자신을 복원하도록 학습된다.
이것의 의미는 다음과 같다. 가우시안에서 샘플링한 \(\mathbf{z}\)가 어떤 이미지의 인코딩과 정확히 일치하기를 바라는 것은 욕심이다. 하지만 “섞은 노이즈 정도만큼은 틀려도 된다”는 정도의 욕심은 부려도 되게 만드는 것이 노이즈의 역할이다. 노이즈 덩어리들이 \(\mathcal{N}(\mathbf{0}, I)\) 영역을 빈틈없이 덮으면, 거기서 뽑은 어떤 점도 decoder가 학습 중에 본 적 있는 점이 된다.
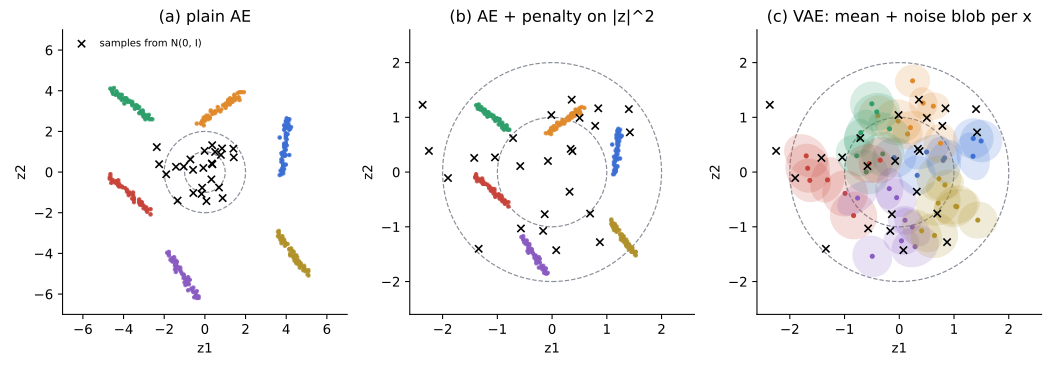 점의 색은 데이터의 종류(예: 숫자 클래스), 점선 원은 \(\mathcal{N}(\mathbf{0}, I)\)의 1σ, 2σ 범위, ×는 \(\mathcal{N}(\mathbf{0}, I)\)에서 뽑은 샘플이다. (a) 일반 오토인코더: 인코딩이 어디에 어떤 모양으로 놓일지 아무 제약이 없다. (b) \(\lVert\mathbf{z}\rVert^2\) 벌점: 0 근처로 모이지만 여전히 가늘고 틈이 많다. (c) VAE: 각 데이터가 평균 주변의 노이즈 덩어리로 인코딩되고, 덩어리들이 prior 영역을 덮는다.
수식으로: encoder는 평균과 분산을 낸다
VAE의 encoder는 \(\mathbf{z}\) 하나가 아니라, 노이즈를 얼마나 섞을지까지 정하는 가우시안의 평균 \(\boldsymbol{\mu}_\phi(\mathbf{x})\)와 표준편차 \(\boldsymbol{\sigma}_\phi(\mathbf{x})\)를 낸다. 이것이 근사 사후 분포(approximate posterior)이다.
\[q_\phi(\mathbf{z} \mid \mathbf{x}) = \mathcal{N}\big(\mathbf{z};\ \boldsymbol{\mu}_\phi(\mathbf{x}),\ \operatorname{diag}(\boldsymbol{\sigma}_\phi^2(\mathbf{x}))\big)\]생성할 때 뽑을 분포, 즉 사전 분포(prior)는 \(p(\mathbf{z}) = \mathcal{N}(\mathbf{0}, I)\)이고, decoder는 \(\mathbf{z}\)가 주어졌을 때 \(\mathbf{x}\)의 분포 \(p_\theta(\mathbf{x} \mid \mathbf{z})\)를 정한다. 학습은 다음 손실을 최소화한다.
\[\mathcal{L}_{\text{VAE}}(\mathbf{x}) = \underbrace{-\,\mathbb{E}_{\mathbf{z} \sim q_\phi(\mathbf{z} \mid \mathbf{x})}\big[\log p_\theta(\mathbf{x} \mid \mathbf{z})\big]}_{\text{reconstruction}} + \underbrace{D_{\mathrm{KL}}\big(q_\phi(\mathbf{z} \mid \mathbf{x}) \,\Vert\, p(\mathbf{z})\big)}_{\text{regularization}}\]- 첫 항은 노이즈가 섞인 \(\mathbf{z}\)에서도 \(\mathbf{x}\)를 잘 복원하라는 재구성 손실이다. decoder 출력을 평균으로 하고 분산이 고정된 가우시안을 쓰면 \(-\log p_\theta(\mathbf{x} \mid \mathbf{z})\)는 상수배와 상수항을 빼면 \(\lVert \mathbf{x} - D_\theta(\mathbf{z}) \rVert^2\)이고, 픽셀 값이 \([0, 1]\)인 이미지에 베르누이 분포를 쓰면 binary cross-entropy이다.
- 둘째 항 KL 발산(KL divergence)은 각 데이터의 노이즈 덩어리 \(q_\phi(\mathbf{z} \mid \mathbf{x})\)가 prior \(\mathcal{N}(\mathbf{0}, I)\)와 비슷해지도록 한다. 가우시안끼리라 닫힌 형태로 계산된다. 잠재 차원 \(d\), 각 차원의 평균 \(\mu_j\), 표준편차 \(\sigma_j\)에 대해
이다.
KL 항은 두 가지 일을 한다. \(\mu_j^2\) 항은 앞의 “0 근처로 모으기” 벌점과 같은 역할이다. \(\sigma_j^2 - 1 - \log\sigma_j^2\) 항은 \(\sigma_j = 1\)에서 최소(0)이고, \(\sigma_j \to 0\)이면 \(-\log\sigma_j^2\) 때문에 커진다. 즉 노이즈를 줄여서 시련을 피하는 것을 막는다. 이 항이 없으면 encoder는 \(\sigma \to 0\)으로 노이즈를 없애고 일반 오토인코더로 돌아갈 것이다.
숫자 예시(1차원). \(\mu = 1, \sigma = 0.5\)이면 \(\tfrac{1}{2}(1 + 0.25 - 1 - \log 0.25) = \tfrac{1}{2}(0.25 + 1.386) \approx 0.818\)이다. \(\mu = 0, \sigma = 1\)이면 정확히 0이다. 평균이 0이어도 \(\sigma = 0.1\)로 노이즈를 거의 없애면 \(\tfrac{1}{2}(0.01 - 1 + 4.605) \approx 1.81\)로, 평균을 1만큼 옮긴 것보다 더 큰 벌점을 받는다.
이 손실은 어디서 오는가: ELBO
이 손실은 임의로 만든 것이 아니라 로그 우도(log-likelihood) \(\log p_\theta(\mathbf{x})\)를 키우려는 목표에서 나온다. \(p_\theta(\mathbf{x}) = \int p_\theta(\mathbf{x} \mid \mathbf{z})\,p(\mathbf{z})\,d\mathbf{z}\)는 적분 때문에 직접 계산할 수 없다(intractable). 임의의 \(q_\phi(\mathbf{z} \mid \mathbf{x})\)에 대해 다음 항등식이 성립한다.
\[\log p_\theta(\mathbf{x}) = \underbrace{\mathbb{E}_{q_\phi}\big[\log p_\theta(\mathbf{x} \mid \mathbf{z})\big] - D_{\mathrm{KL}}\big(q_\phi(\mathbf{z} \mid \mathbf{x}) \,\Vert\, p(\mathbf{z})\big)}_{\text{ELBO}} + D_{\mathrm{KL}}\big(q_\phi(\mathbf{z} \mid \mathbf{x}) \,\Vert\, p_\theta(\mathbf{z} \mid \mathbf{x})\big)\]마지막 KL은 항상 0 이상이므로 앞의 두 항은 \(\log p_\theta(\mathbf{x})\)의 하한, ELBO(evidence lower bound)이다. \(\mathcal{L}_{\text{VAE}} = -\text{ELBO}\)이므로 손실을 줄이는 것은 하한을 올려 데이터의 우도를 키우는 것이다. 동시에 마지막 KL이 줄어들면서 \(q_\phi\)가 계산할 수 없는 진짜 사후 분포 \(p_\theta(\mathbf{z} \mid \mathbf{x})\)에 가까워진다. “다루기 어려운 분포를 다루기 쉬운 분포 \(q\)로 근사한다”는 첫 절의 문장이 바로 이것이고, 분포 \(q\)를 최적화해서 근사하는 방법을 변분 추론(variational inference)이라고 부른다.
Reparameterization trick
\(\mathbf{z}\)를 \(q_\phi\)에서 “뽑는” 연산은 그대로는 미분할 수 없다. 그래서 노이즈를 파라미터 밖으로 빼낸다.
\[\mathbf{z} = \boldsymbol{\mu}_\phi(\mathbf{x}) + \boldsymbol{\sigma}_\phi(\mathbf{x}) \odot \boldsymbol{\epsilon}, \qquad \boldsymbol{\epsilon} \sim \mathcal{N}(\mathbf{0}, I)\]\(\odot\)는 원소별 곱이다. 이제 무작위성은 \(\boldsymbol{\epsilon}\)에만 있고, \(\mathbf{z}\)는 \(\boldsymbol{\mu}, \boldsymbol{\sigma}\)의 미분 가능한 함수이므로 재구성 손실의 gradient가 encoder까지 흐른다. 이것이 재매개변수화 기법(reparameterization trick)이고, “인코딩에 노이즈를 섞는다”를 정확히 쓴 식이다.
코드
Encoder는 \(\boldsymbol{\mu}\)와 \(\log\boldsymbol{\sigma}^2\)(양수 제약을 피하려고 로그 분산을 출력한다)를 내고, reparameterization으로 \(\mathbf{z}\)를 만든 뒤 decoder에 넣는다. 생성할 때는 encoder를 건너뛰고 \(\mathcal{N}(\mathbf{0}, I)\)에서 뽑은 \(\mathbf{z}\)를 decoder에 넣는다.
import torch
import torch.nn as nn
import torch.nn.functional as F

class VAE(nn.Module):
    def __init__(self, x_dim=784, h_dim=256, z_dim=2):
        super().__init__()
        self.enc = nn.Sequential(nn.Linear(x_dim, h_dim), nn.ReLU())
        self.to_mu = nn.Linear(h_dim, z_dim)
        self.to_logvar = nn.Linear(h_dim, z_dim)   # log sigma^2
        self.dec = nn.Sequential(nn.Linear(z_dim, h_dim), nn.ReLU(),
                                 nn.Linear(h_dim, x_dim))  # logits

    def forward(self, x):
        h = self.enc(x)
        mu, logvar = self.to_mu(h), self.to_logvar(h)
        eps = torch.randn_like(mu)                   # noise from N(0, I)
        z = mu + torch.exp(0.5 * logvar) * eps       # reparameterization
        return self.dec(z), mu, logvar

def vae_loss(x, logits, mu, logvar):
    # reconstruction: -log p(x|z) for pixel values in [0, 1]
    rec = F.binary_cross_entropy_with_logits(logits, x, reduction="sum")
    # KL( N(mu, sigma^2) || N(0, I) ), closed form
    kl = 0.5 * torch.sum(mu.pow(2) + logvar.exp() - 1 - logvar)
    return (rec + kl) / x.shape[0]

model = VAE()
opt = torch.optim.Adam(model.parameters(), lr=1e-3)
x = torch.rand(64, 784)            # stand-in for a batch of MNIST images
logits, mu, logvar = model(x)
loss = vae_loss(x, logits, mu, logvar)
opt.zero_grad(); loss.backward(); opt.step()

# generation: skip the encoder, sample z from the prior
with torch.no_grad():
    z = torch.randn(16, 2)
    samples = torch.sigmoid(model.dec(z))   # 16 generated images
영상의 설명은 VAE의 감을 빨리 잡기 위해 일부러 단순화한 것이다. “노이즈를 섞는다”는 비유는 reparameterization과 KL 항의 역할을 직관적으로 보여 주지만, 왜 하필 이 손실이어야 학습이 안정적인지는 위의 ELBO 유도에서 나온다. 원 논문은 Kingma & Welling, Auto-Encoding Variational Bayes (2013)이다.
VAE의 인코딩을 유한한 개수의 벡터로 제한하면 VQ-VAE가 된다. 다른 방식으로 \(p_{\text{data}}\)에 근사하는 생성 모델로는 Flow와 Diffusion이 있다.
정리
| 단계 | 하는 일 | 한계 또는 핵심 |
|---|---|---|
| 생성 | 쉬운 분포에서 샘플링 | 데이터 분포 \(p_{\text{data}}\)는 식을 몰라 직접 못 뽑음 |
| Encoder | 가정을 이용해 더 적은 숫자로 표현 | 디코딩 가능해야 의미, 공식은 여러 개 |
| 수동 설계 | 사람이 규칙(사인 경계, 2차 함수)을 찾음 | 고차원에서 불가능, 가정이 틀리면 오차 |
| 오토인코더 | 병목 + 재구성 손실로 규칙을 자동 학습 | \(\mathbf{z}\)의 분포를 몰라 샘플링 불가 |
| AE + \(\lVert\mathbf{z}\rVert^2\) 벌점 | \(\mathbf{z}\)를 0 근처로 모음 | 학습에 샘플링이 없어 빈 공간에서 생성 실패 |
| VAE | \(\mathbf{z} = \boldsymbol{\mu} + \boldsymbol{\sigma} \odot \boldsymbol{\epsilon}\), 재구성 + KL | 노이즈 덩어리가 prior를 덮어 \(\mathcal{N}(\mathbf{0}, I)\)에서 생성 가능 |
- VAE 손실은 \(-\text{ELBO}\) = 재구성 손실 + \(D_{\mathrm{KL}}(q_\phi(\mathbf{z} \mid \mathbf{x}) \Vert \mathcal{N}(\mathbf{0}, I))\)이다.
- KL 항은 평균을 0 쪽으로 당기고, 표준편차가 0으로 줄어 노이즈를 피하는 것을 막는다.