- 임커밋의 딥러닝 / 머신러닝 강의 정리
생성은 샘플링이다
▶ 【 Flow based model 시각화로 설명 】
생성 모델이 무언가를 “생성한다”는 것은 어떤 확률 분포에서 샘플링(sampling)한다는 뜻이다. 문제는 우리가 원하는 분포, 예를 들어 고양이 사진이 나오는 분포 \(p_X(x)\)의 공식을 모른다는 것이다. 반대로 가우시안처럼 공식이 쉬운 분포에서는 샘플링이 쉽지만, 거기서 뽑은 값을 그대로 이미지로 보면 의미 없는 노이즈일 뿐이다. 손글씨 숫자처럼 비교적 단순한 이미지조차 분포를 직접 설계하기는 어렵다.
그래서 생성 모델들은 대부분 같은 전략을 쓴다.
- 샘플링이 쉬운 분포 하나를 정해 둔다. 보통 표준 정규분포 \(p_Z(z) = \mathcal{N}(z; 0, I)\)이다.
- 거기서 뽑은 \(z\)를 신경망 \(f\)에 통과시켜 \(x = f(z)\)가 원하는 데이터처럼 보이게 만든다.
VAE도, 뒤에 나올 diffusion이나 flow matching도 이 틀 안에 있다. Normalizing flow(flow-based model)는 이 틀을 가장 정직하게 구현한 모델이다. 분포의 공식은 모르지만 샘플(데이터)은 있다는 점에서 출발한다.
공간을 비튼다
Flow의 핵심 아이디어는 데이터가 놓인 \(D\)차원 숫자 공간 자체를 비트는(warp) 것이다. 데이터 점들이 흩어져 있는 공간을 잘 구부리고 늘이고 당겨서, 변환된 점들이 마치 가우시안에서 뽑은 것처럼 원점 주위에 둥글게 모이도록 만드는 변환을 학습한다.
신경망의 연산은 모두 공간을 비트는 연산으로 볼 수 있다.
- 스칼라 곱: 원점을 기준으로 공간을 늘이거나 줄인다.
- 벡터 덧셈: 공간을 평행이동한다.
- 행렬 곱: 공간 전체를 균일하게 기울이고 늘이고 돌린다(선형 변환).
Flow가 쓰는 변환은 위치마다 비트는 정도가 다른, 균일하지 않은 비틀기이다. 그래도 이 비틀기가 매끄럽고 되돌릴 수 있는 변환이라는 점이 중요하다.
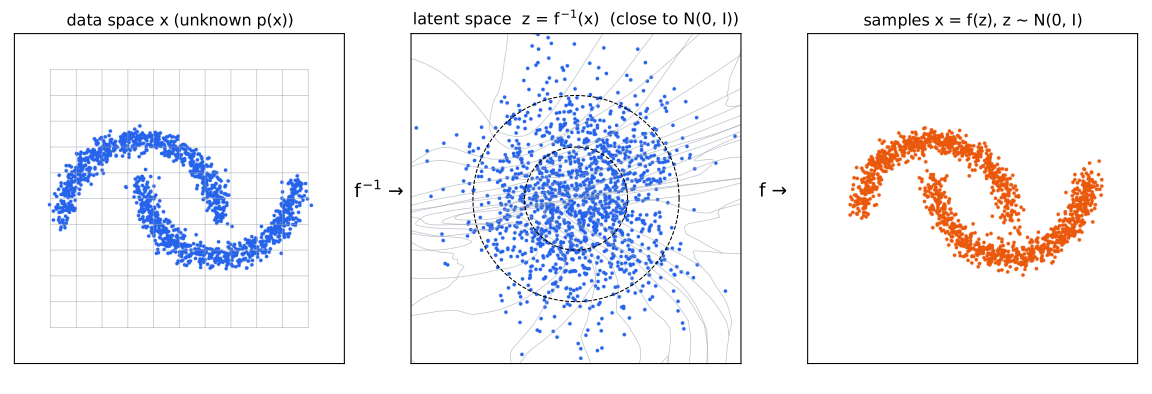 학습된 flow의 예. 왼쪽: 두 개의 초승달 모양 데이터와 격자. 가운데: \(f^{-1}\)로 비튼 공간. 데이터는 원점 주위에 가우시안처럼 모이고(점선은 반지름 1, 2), 원래의 곧은 격자는 심하게 휘어진다. 오른쪽: \(\mathcal{N}(0, I)\)에서 새로 뽑은 점을 \(f\)로 되돌리면 데이터와 같은 모양이 나온다.
여기서 방향을 정리해 두자. 이 글에서는 생성 방향을 \(f\)로 쓴다.
\[x = f(z), \qquad z = f^{-1}(x)\]학습할 때는 데이터 \(x\)를 \(f^{-1}\)로 보내 \(z\)가 가우시안처럼 보이게 하고, 생성할 때는 가우시안에서 뽑은 \(z\)를 \(f\)로 보낸다. 따라서 flow에는 두 가지 조건이 필요하다.
- 역변환이 가능해야 한다. 학습은 \(x \to z\) 방향으로 하지만, 생성에 필요한 것은 \(z \to x\) 방향이다.
- 우도(likelihood)를 빠르게 계산할 수 있어야 한다. 이 조건은 아래의 변수 변환 공식에서 나온다.
역변환이 가능한 비틀기: coupling layer
▶ [ Flow based model ] 1. 개념 설명
일반적인 신경망은 역함수를 구할 수 없다. Flow는 차원을 둘로 나눠 번갈아 비트는 방법으로 이 문제를 피한다. 이것이 affine coupling layer(RealNVP)이다.
입력 \(x \in \mathbb{R}^D\)의 차원을 두 묶음 \(x_A\), \(x_B\)로 나눈다. 한 층에서는 \(x_B\)를 그대로 두고, \(x_A\)만 비튼다. 비트는 양(scale \(s\), shift \(t\))은 바뀌지 않는 쪽 \(x_B\)로부터 신경망이 계산한다.
\[z_A = x_A \odot \exp\big(s(x_B)\big) + t(x_B), \qquad z_B = x_B\]\(\odot\)은 성분별 곱(element-wise product)이고, \(s\)와 \(t\)는 임의의 신경망이다. 영상은 배율을 그냥 \(s\)로 곱하는 형태(\(s \cdot x_A + t\))로 설명하는데, 실제 구현에서는 배율이 항상 양수가 되도록 \(\exp(s)\)를 쓰는 것이 표준이다.
역변환은 간단하다. \(z_B = x_B\)이므로 \(z_B\)만 보고도 \(s\)와 \(t\)를 똑같이 다시 계산할 수 있고, 그러면 덧셈과 곱셈을 거꾸로 하면 된다.
\[x_B = z_B, \qquad x_A = \big(z_A - t(z_B)\big) \odot \exp\big(-s(z_B)\big)\]\(s\), \(t\) 자체는 역함수를 구할 필요가 없다는 점이 핵심이다. 신경망은 아무리 복잡해도 되고, 역변환에서도 정방향으로만 한 번 더 돌리면 된다.
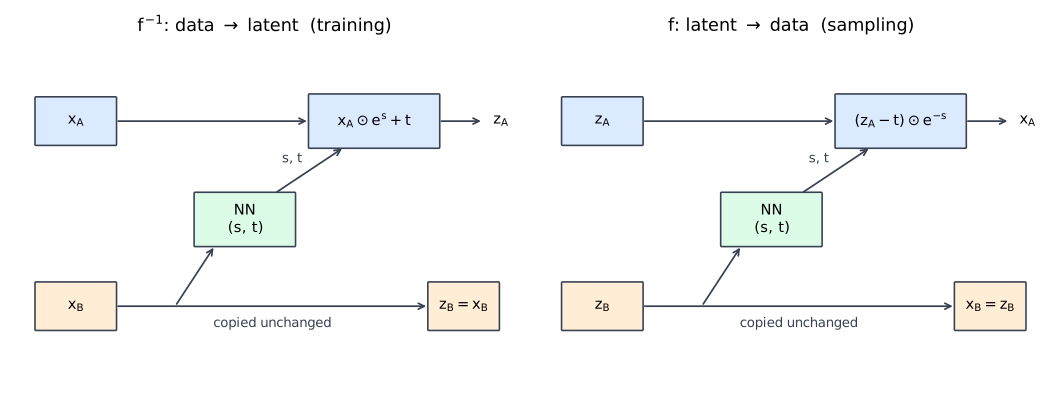 Affine coupling layer. 주황 묶음은 그대로 통과하고, 그 값으로 신경망이 \(s, t\)를 만든다. 파란 묶음만 그 \(s, t\)로 비틀어진다. 역방향(오른쪽)에서도 주황 묶음이 그대로이므로 같은 \(s, t\)를 얻는다.
한 층에서는 \(x_A\)만 비틀리므로, 다음 층에서는 역할을 바꿔 \(x_A\)를 고정하고 \(x_B\)를 비튼다. 이렇게 번갈아 여러 층을 쌓으면 모든 차원이 충분히 섞인다. 2차원 예제라면 \(x_A\), \(x_B\)가 각각 한 좌표이고, \(28 \times 28\) MNIST 이미지라면 784차원을 적당히(예: 체커보드 무늬나 채널 단위로) 반씩 나누면 된다.
손실 함수: 원점으로 뭉치는 문제
변환된 \(z\)가 가우시안처럼 보이게 하려면 음의 로그 우도(negative log-likelihood, NLL)를 줄이면 될 것 같다. 표준 정규분포의 로그 밀도는
\[\log p_Z(z) = -\frac{1}{2}\lVert z \rVert^2 - \frac{D}{2}\log 2\pi\]이므로, \(-\log p_Z(f^{-1}(x))\)만 손실로 쓰면 어떻게 될까? 이 값은 \(z = 0\)에서 가장 작다. 그러면 모델은 모든 점을 원점으로 뭉개는 쪽으로 학습한다. 공간을 무한히 줄여 버리면 정보가 사라지고, 역변환도 의미가 없어진다.
그래서 실제 flow의 손실에는 항이 하나 더 붙는다. 각 층의 \(s\)를 모두 더한 값(배율을 모두 곱한 값의 로그)을 빼는 것이다. \(s\)가 크다는 것은 공간을 원점에서 멀어지게 늘인다는 뜻이므로, 이 항은 \(z\)가 원점으로 뭉치는 것을 막는 역할을 한다. 두 힘이 균형을 이룬 결과가 “적당히 퍼진” 가우시안 모양이다.
이 직관은 맞지만 왜 하필 \(\sum s\)인지는 설명하지 못한다. 그 답이 변수 변환 공식이다.
변수 변환 공식과 log-determinant
▶ [ Flow based model ] 2. 예제 코드 설명
순진한 출발점은 이렇다. \(z \sim p_Z\)를 뽑아 \(x = f(z)\)를 만들었으니, \(p_X(x)\)는 \(p_Z\)에 \(f^{-1}(x)\)를 대입하면 되지 않을까? 즉 \(p_X(x) = p_Z(f^{-1}(x))\)일까? 아니다. 공간을 늘이면 같은 확률 질량이 더 넓은 부피에 퍼지므로 밀도는 낮아지고, 줄이면 밀도는 높아진다. 이 부피 변화를 보정해야 한다. 그것이 변수 변환 공식(change of variables formula)이다.
\[p_X(x) = p_Z\big(f^{-1}(x)\big)\,\left|\det \frac{\partial f^{-1}(x)}{\partial x}\right|\]- \(\frac{\partial f^{-1}(x)}{\partial x}\): \(f^{-1}\)의 야코비 행렬(Jacobian matrix), \(D \times D\)이다.
- \(\lvert\det(\cdot)\rvert\): 그 점 근처에서 \(f^{-1}\)이 부피를 몇 배로 바꾸는지를 나타낸다.
1차원 예. \(z \sim \mathcal{N}(0, 1)\)이고 \(x = f(z) = 2z + 1\)이라 하자. \(f^{-1}(x) = (x - 1)/2\)이고 도함수는 \(1/2\)이다. \(x = 1\)에서
\[p_X(1) = p_Z(0) \cdot \frac{1}{2} = 0.3989 \times 0.5 = 0.1995\]공간을 2배로 늘였으므로 밀도는 절반이 된다. 실제로 \(x \sim \mathcal{N}(1, 2^2)\)의 \(x = 1\)에서의 밀도가 \(0.1995\)이다.
로그를 취하고 \(f^{-1}\)이 \(K\)개 층 \(g_K \circ \cdots \circ g_1\)의 합성이면, 행렬식의 곱이 로그의 합이 되어 손실은 다음과 같다.
\[-\log p_X(x) = -\log p_Z(z) - \sum_{k=1}^{K} \log\left|\det \frac{\partial g_k}{\partial h_{k-1}}\right|, \qquad z = f^{-1}(x)\]여기서 \(h_0 = x\), \(h_k = g_k(h_{k-1})\)이고 \(z = h_K\)이다.
행렬식을 싸게 만드는 구조
\(D \times D\) 행렬의 행렬식은 일반적으로 \(O(D^3)\)의 계산이 든다. 이미지처럼 \(D\)가 수천, 수만이면 매 학습 스텝마다 계산하기에는 너무 비싸다. Coupling layer는 이 문제도 해결한다. \(z_B = x_B\)이고 \(z_A\)는 \(x_A\)에 대해 성분별 곱이므로 야코비 행렬이 삼각 행렬이 된다.
\[\frac{\partial z}{\partial x} = \begin{bmatrix} \operatorname{diag}\big(\exp(s(x_B))\big) & \dfrac{\partial z_A}{\partial x_B} \\ 0 & I \end{bmatrix}\]삼각 행렬의 행렬식은 대각 성분의 곱이므로
\[\log\left|\det \frac{\partial z}{\partial x}\right| = \sum_j s_j(x_B)\]이다. 오른쪽 위 블록 \(\partial z_A / \partial x_B\)는 신경망 \(s, t\)의 미분이라 복잡하지만, 행렬식에는 전혀 영향을 주지 않는다. 계산량은 \(O(D)\)로 줄어든다. 앞 절에서 손실에 붙어 있던 “\(s\)를 모두 더한 항”의 정체가 바로 이 log-determinant이다.
2차원 예. \(s(b) = 0.5b\), \(t(b) = -b\)인 coupling 한 층과 \(x = (x_A, x_B) = (1, 2)\)를 생각하자. \(s = 1\), \(t = -2\)이므로
\[z_A = 1 \cdot e^{1} - 2 = 0.718, \qquad z_B = 2\]야코비 행렬식은 \(e^1 = 2.718\)이고 로그로는 정확히 \(s = 1\)이다. 따라서
\[\log p_X(x) = \underbrace{-\tfrac{1}{2}(0.718^2 + 2^2) - \log 2\pi}_{\log p_Z(z) \,=\, -4.096} + \underbrace{1}_{\log\lvert\det\rvert} = -3.096\]정리하면 flow는 두 가지 장치로 두 조건을 해결한다.
| 조건 | 장치 |
|---|---|
| 역변환이 가능해야 한다 | 차원을 나눠 번갈아 비틀기(coupling) |
| 행렬식 계산이 빨라야 한다 | 행렬 곱 대신 성분별 곱 → 삼각 야코비, \(\log\lvert\det\rvert = \sum s\) |
PyTorch로 구현하기
아래 코드는 2차원 two-moons 데이터에 coupling layer 8개짜리 flow를 학습시킨다. encode가 \(f^{-1}\)(학습 방향), decode가 \(f\)(생성 방향)이다. 위의 첫 그림이 이 코드의 결과이다.
import math
import torch
import torch.nn as nn

class Coupling(nn.Module):
    """Affine coupling: keep 차원은 그대로 두고, 그 값으로 warp 차원을 비튼다."""
    def __init__(self, keep, hidden=64):
        super().__init__()
        self.keep, self.warp = keep, 1 - keep
        self.net = nn.Sequential(nn.Linear(1, hidden), nn.ReLU(),
                                 nn.Linear(hidden, hidden), nn.ReLU(),
                                 nn.Linear(hidden, 2))

    def st(self, cond):
        s, t = self.net(cond).chunk(2, dim=1)
        return torch.tanh(s), t                # s를 [-1, 1]로 묶어 학습을 안정화

    def encode(self, x):                       # f^{-1}: data -> latent
        s, t = self.st(x[:, [self.keep]])
        z = x.clone()
        z[:, [self.warp]] = x[:, [self.warp]] * torch.exp(s) + t
        return z, s.sum(dim=1)                 # log|det J| = s의 합

    def decode(self, z):                       # f: latent -> data
        s, t = self.st(z[:, [self.keep]])      # keep 쪽은 그대로이므로 같은 s, t
        x = z.clone()
        x[:, [self.warp]] = (z[:, [self.warp]] - t) * torch.exp(-s)
        return x

class Flow(nn.Module):
    def __init__(self, n_layers=8):
        super().__init__()
        # keep을 0, 1, 0, 1, ...로 번갈아 두 좌표를 교대로 비튼다
        self.layers = nn.ModuleList([Coupling(keep=i % 2) for i in range(n_layers)])

    def encode(self, x):
        logdet = torch.zeros(x.shape[0])
        for layer in self.layers:
            x, ld = layer.encode(x)
            logdet = logdet + ld
        return x, logdet

    def decode(self, z):
        for layer in reversed(self.layers):
            z = layer.decode(z)
        return z

def nll(x, flow):
    z, logdet = flow.encode(x)
    log_pz = -0.5 * (z ** 2).sum(1) - 0.5 * z.shape[1] * math.log(2 * math.pi)
    return -(log_pz + logdet).mean()           # -log p_X(x)

def two_moons(n, noise=0.08):
    a, b = torch.rand(n // 2) * math.pi, torch.rand(n - n // 2) * math.pi
    up = torch.stack([torch.cos(a), torch.sin(a)], 1)
    down = torch.stack([1 - torch.cos(b), 0.5 - torch.sin(b)], 1)
    x = torch.cat([up, down]) + noise * torch.randn(n, 2)
    return (x - torch.tensor([0.5, 0.25])) * 1.5

torch.manual_seed(0)
flow = Flow()
opt = torch.optim.Adam(flow.parameters(), lr=1e-3)
for step in range(3001):
    loss = nll(two_moons(512), flow)
    opt.zero_grad(); loss.backward(); opt.step()

with torch.no_grad():
    x = two_moons(5)
    z, _ = flow.encode(x)
    print((flow.decode(z) - x).abs().max())    # 역변환 오차: 1e-7 수준
    samples = flow.decode(torch.randn(1000, 2))  # 생성: z ~ N(0, I) -> x
nll의 두 항이 앞에서 본 두 힘이다. 0.5 * (z ** 2).sum(1)은 \(z\)를 원점으로 당기고, - logdet(즉 \(-\sum s\))은 공간이 뭉개지지 않도록 밀어낸다. 학습이 끝나면 decode로 가우시안 노이즈를 데이터로 바꿀 수 있고, 역변환 오차는 부동소수점 오차 수준이다.
실제 flow 모델(RealNVP, Glow 등)에는 차원을 섞는 \(1 \times 1\) 합성곱, 정규화 층, 다중 스케일 구조 같은 장치가 더 들어가지만, “가역이고 야코비 행렬식이 싼 층을 쌓는다”는 골격은 같다.
정리
| 개념 | 내용 |
|---|---|
| Normalizing flow | 데이터 공간을 가우시안처럼 보이는 공간으로 비트는 가역 변환 \(f^{-1}\)을 학습한다. 생성은 \(x = f(z)\), \(z \sim \mathcal{N}(0, I)\) |
| 변수 변환 공식 | \(p_X(x) = p_Z(f^{-1}(x))\,\lvert\det \partial f^{-1}/\partial x\rvert\), 공간의 부피 변화만큼 밀도를 보정한다 |
| 손실 | \(-\log p_X(x) = \tfrac{1}{2}\lVert z\rVert^2 - \sum \log\lvert\det\rvert + \text{const}\). 첫 항은 원점으로 당기고, 둘째 항은 뭉치는 것을 막는다 |
| Coupling layer | 반은 그대로, 반은 \(x_A \odot e^{s(x_B)} + t(x_B)\). \(s, t\)는 임의의 신경망이어도 역변환이 쉽다 |
| 빠른 행렬식 | 삼각 야코비이므로 \(\log\lvert\det\rvert = \sum s\), \(O(D^3) \to O(D)\) |
같은 “가우시안을 데이터로 옮기는 변환”을 층을 쌓는 대신 연속 시간의 미분 방정식으로 표현하면 Neural ODE의 continuous normalizing flow가 되고, 그 벡터장을 직접 회귀하는 것이 Flow Matching이다.