- 임커밋의 딥러닝 / 머신러닝 강의 정리
복습: 인코더와 오토인코더
임커밋 6에서 본 두 개념을 짧게 다시 정리한다.
- Encoder는 데이터에 어떤 가정을 두고, 그 가정이 허락하는 선에서 원래 데이터를 더 적은 숫자로 나타낸다. 그 적은 숫자에서 원래 정보로 되돌릴 수 있어야 의미가 있다. 여기서 encoder는 신경망이다.
- 오토인코더(autoencoder)는 그 가정을 신경망이 자동으로 찾게 한다. 예를 들어 숫자 16개를 2개로 줄였다가 다시 16개로 복원하는 구조를 만들고, 출력이 입력과 같아지도록 학습시킨다. 정보를 2개에 우겨넣어야 하므로 데이터의 규칙을 찾아야만 복원이 잘 된다.
잘 학습된 오토인코더의 encoder는 데이터의 특성을 담은 저차원 feature를 내고, decoder는 그 feature에서 원본을 복원한다. VQ-VAE의 VQ 부분을 이해할 때는 VAE의 “V”(노이즈를 섞는 부분)는 일단 잊어도 된다.
벡터 양자화: 유한한 후보 중 가장 가까운 것으로 퉁치기
숫자 16개를 실수 2개로 줄였다고 하자. 숫자 개수는 줄었지만, 실수 두 개가 가질 수 있는 값의 경우의 수는 여전히 무한하다. 범위를 \([-1, 1]\)로 제한해도 무한하다.
벡터 양자화(vector quantization, VQ)는 여기에 가정을 하나 더 건다. 인코딩은 미리 정해 둔 \(K\)가지(예: 10가지, 16가지) 중 하나뿐이다. 그 \(K\)개의 벡터 \(\mathbf{e}_1, \dots, \mathbf{e}_K \in \mathbb{R}^D\)를 코드북(codebook)이라 하고, 각 벡터를 코드(code) 또는 codeword라 한다. Encoder 출력 \(\mathbf{z}_e(\mathbf{x}) \in \mathbb{R}^D\)가 나오면, 가장 가까운 코드로 대충 퉁친다.
\[k^* = \operatorname*{arg\,min}_{k \in \{1, \dots, K\}} \lVert \mathbf{z}_e(\mathbf{x}) - \mathbf{e}_k \rVert_2, \qquad \mathbf{z}_q(\mathbf{x}) = \mathbf{e}_{k^*}\]Decoder는 \(\mathbf{z}_e\) 대신 \(\mathbf{z}_q\)를 받는다.
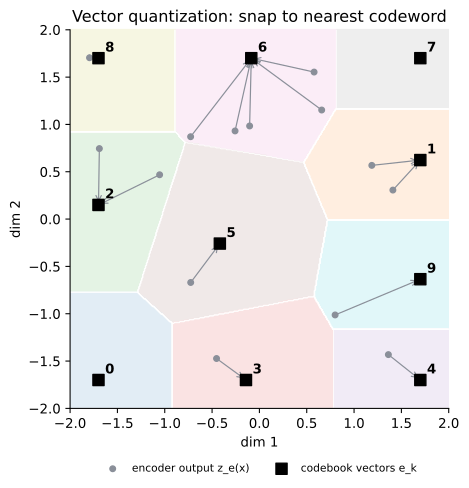 \(D = 2\), \(K = 10\)인 코드북(검은 사각형, 번호 0–9). 색칠된 영역은 각 코드가 “가장 가까운” 점들의 집합이다. 회색 점(encoder 출력)은 그것이 속한 영역의 코드로 바뀐다.
이것은 encoder의 역할인 “정보를 표현하는 숫자를 줄인다”를 극한까지 밀어붙인 것이다. 숫자 개수를 16에서 2로 줄이는 것도 모자라, 그 2개의 실수가 가질 수 있는 무한한 경우의 수를 10가지로 제한한다. 그러면 세 가지 의문이 생긴다.
- 이렇게까지 줄여서 무엇을 하려는가?
- Decoder가 받는 값이 원래 인코딩과 달라졌으니 복원이 나빠지지 않는가?
- 가장 가까운 것을 고르는 연산이 들어 있는데 어떻게 학습시키는가?
차례로 답한다.
왜 일부러 왜곡하는가: 이미지를 정수 문장으로
▶ 【 VQ-VAE 】2. 딥러닝에서 VQ를 쓰는 이유
VQ로 퉁친 인코딩은 원래 인코딩이 왜곡된 값이다. 인코딩은 원래도 정보를 줄인 것이라 너무 많이 줄이면 복원하기에 숫자가 부족할 수 있는데, 여기에 근처 코드로 퉁치는 왜곡까지 더한다. 인코딩의 본래 목적을 조금 희생하면서까지 VQ를 쓰는 이유는 인코딩 덩어리를 만들어 내기 좋게 하기 위해서이다.
인코딩 덩어리
숫자 16개를 2개로 줄이는 encoder로 \(28 \times 28 = 784\) 픽셀 이미지를 줄여 보자. 이미지를 \(4 \times 4\) 패치로 나누면 패치는 \(7 \times 7 = 49\)개이고, 각 패치(숫자 16개)를 숫자 2개로 줄이면 이미지 전체는 숫자 98개, 즉 높이·너비가 \(7 \times 7\)이고 각 위치에 2차원 벡터가 놓인 인코딩 덩어리가 된다. 이 덩어리만 있으면 decoder로 원본 그림을 만들 수 있으므로, 인코딩 덩어리를 잘 만드는 것은 그림을 잘 만드는 것과 같다. 생성 모델을 이 덩어리 위에서 만들면 된다.
유한하면 번호를 붙일 수 있다
VQ의 장점은 인코딩의 경우의 수가 유한하다는 것이다. 유한하면 각 코드에 정수 번호(index) \(0, 1, \dots, K-1\)을 붙일 수 있다. 그러면 VQ를 거친 인코딩 덩어리는 \(7 \times 7\)개의 정수 배열이 되고, 이를 한 줄로 펴면 길이 49의 정수 나열이 된다.
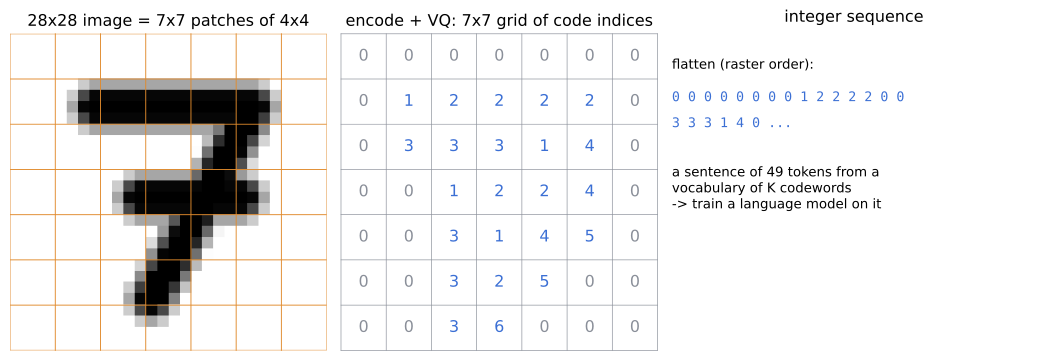 \(28 \times 28\) 이미지를 \(4 \times 4\) 패치 49개로 나누고(왼쪽), 각 패치를 코드 번호 하나로 바꾸면 \(7 \times 7\) 정수 격자가 된다(가운데). 배경 패치는 모두 같은 코드 0이다. 이를 펴면 어휘 크기 \(K\)의 토큰 49개로 된 “문장”이 된다(오른쪽). 그림의 번호는 설명용으로 이 이미지의 패치만 군집화해 붙인 것이다.
정수 나열을 잘 만드는 일은 바로 언어 모델이 하는 일이다. 이미지 생성 모델도 Transformer 같은 언어 모델로 만들 수 있게 된다. 정수 토큰 \(k_1, \dots, k_{49}\)의 분포를 autoregressive하게
\[p(k_1, \dots, k_{N}) = \prod_{i=1}^{N} p(k_i \mid k_1, \dots, k_{i-1})\]로 학습시키고, 생성할 때는 토큰을 하나씩 샘플링한 뒤 코드북 벡터로 바꿔 decoder에 넣는다. VQ-VAE 원 논문(van den Oord et al., Neural Discrete Representation Learning, 2017)은 이 prior로 PixelCNN을 썼고, 이후 같은 아이디어가 Transformer로 이어졌다. Transformer의 구조는 임커밋 3에 정리되어 있다.
연속 인코딩을 바로 예측하면 안 되는가
VQ 없이 연속 인코딩 숫자를 직접 예측하는 모델을 MSE나 L1 손실로 학습시키는 것도 불가능하지는 않다. 하지만 문제가 있다. 예측에는 오차가 생길 수밖에 없는데, MSE나 L1은 모든 차원, 모든 위치에서 같은 거리면 같은 오차라고 가정한다. 그런데 encoder는 원본을 비선형으로 변환해 두 숫자로 만들었으므로, 인코딩 공간의 축은 비선형으로 비틀려 있다. 같은 0.1의 오차라도 어느 차원, 어느 위치냐에 따라 복원 결과에 주는 의미가 다르다. 결국 피할 수 없는 예측 오차가 비선형 왜곡으로 이어진다.
정수 나열로 바꾸면 예측 모델은 각 번호가 원래 어떤 벡터였는지 모르고, 번호들의 패턴만 보고 학습한다. “이런 정수 나열은 이런 숫자 그림”을 분류 문제(cross-entropy)로 배우므로, 인코딩 축의 거리 왜곡이 끼어들 여지가 없다. 대신 번호 사이의 기하학적 관계(3번과 5번이 가까운 벡터라는 것)를 기본적으로는 주지 않으므로, 이를 데이터에서 스스로 배워야 하고 그만큼 데이터가 더 필요할 수 있다는 점은 염두에 둔다.
참고로 정보량으로 보면, \(K = 10\)일 때 이 이미지 하나는 \(49 \log_2 10 \approx 162.8\)비트로 표현된다.
Residual VQ: 유효 숫자를 여러 자리 쓰기
VQ를 쓰는 이유는 알았지만, 퉁칠 때 생기는 오차는 여전히 껄끄럽다. 이미지를 만드는 언어 모델이 아무리 좋아도, 퉁친 오차 때문에 원본으로 잘 돌아가지 못하면 의미가 없다. Residual VQ(RVQ)는 이 성능 희생을 줄인다. 핵심 개념은 유효 숫자이다.
원주율 \(\pi = 3.14159\ldots\)를 \(\{0, 1, \dots, 9\}\) 중 하나로 양자화하면 3이다. 대충은 맞지만 원의 넓이를 구하면 오차가 꽤 크다. 더 정확하게 하려면 나머지 \(\pi - 3 = 0.14159\ldots\)를 \(\{0.0, 0.1, \dots, 0.9\}\) 중 가장 가까운 0.1로 한 번 더 양자화한다. 그러면 \(\pi \approx 3.1\)이고, 오차는 \(0.1416\)에서 \(0.0416\)으로 줄어든다.
RVQ도 같다. 처음 퉁친 벡터와 원래 벡터의 차이(residual)를, 별도로 정해 둔 두 번째 코드북에서 가장 가까운 벡터로 다시 퉁친다. 이를 \(M\)번 반복한다. \(Q_m\)을 \(m\)번째 코드북에 대한 VQ라 하면
\[\mathbf{r}_0 = \mathbf{z}_e, \qquad \mathbf{q}_m = Q_m(\mathbf{r}_{m-1}), \qquad \mathbf{r}_m = \mathbf{r}_{m-1} - \mathbf{q}_m \quad (m = 1, \dots, M), \qquad \mathbf{z}_q = \sum_{m=1}^{M} \mathbf{q}_m\]이다. \(\pi\) 예에서 첫 단계 후보(0–9)와 둘째 단계 후보(0.0–0.9)가 일부러 다른 크기였듯이, 각 단계의 코드북도 별개의 벡터들이다. 꼭 달라야 한다는 규칙은 없지만, 학습시키면 자연스럽게 서로 다른 벡터들이 된다.
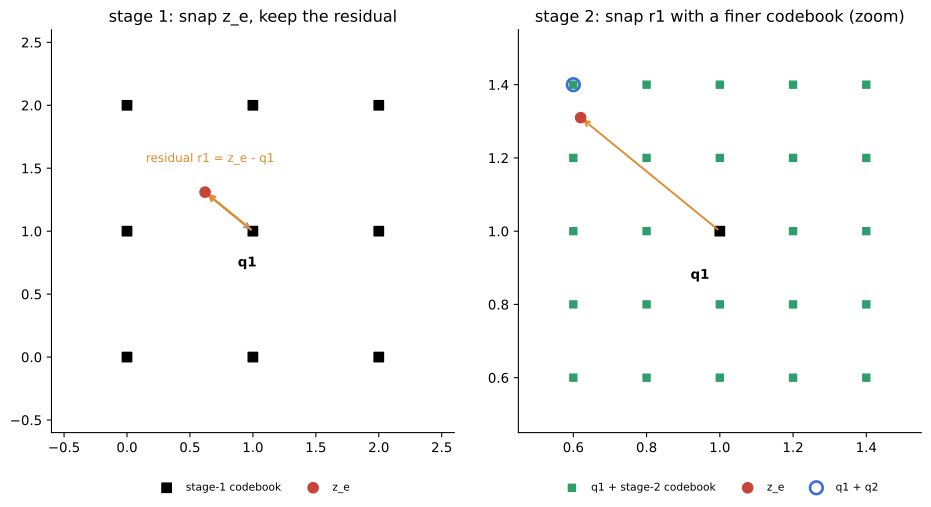 \(\mathbf{z}_e = (0.62, 1.31)\)을 간격 1인 코드북으로 퉁치면 \(\mathbf{q}_1 = (1, 1)\)이고 오차는 \(0.490\)이다(왼쪽). 잔차 \(\mathbf{r}_1 = (-0.38, 0.31)\)을 간격 0.2인 두 번째 코드북으로 퉁치면 \(\mathbf{q}_2 = (-0.4, 0.4)\)이고, \(\mathbf{q}_1 + \mathbf{q}_2 = (0.6, 1.4)\)의 오차는 \(0.092\)로 줄어든다(오른쪽, 확대).
보통 4번, 6번, 8번 정도 퉁친다. 코드북 크기가 \(K\)이면 표현할 수 있는 조합은 \(K^M\)가지로 늘어난다(\(K = 512\), \(M = 4\)이면 약 \(6.9 \times 10^{10}\)). 대신 단점도 있다. VQ를 쓴 목적이 언어 모델 방식의 생성이었는데, RVQ를 쓰면 한 위치의 인코딩이 정수 1개가 아니라 \(M\)개가 되어 생성 모델이 배워야 할 토큰이 \(M\)배로 늘어난다. 그만큼 더 큰 언어 모델이 필요하다. RVQ는 SoundStream, EnCodec 같은 신경망 오디오 코덱에서 널리 쓰인다.
def residual_vq(z, codebooks):
    out, codes, r = torch.zeros_like(z), [], z
    for cb in codebooks:                       # each cb: (K, D)
        i = torch.cdist(r, cb).argmin(dim=1)   # nearest codeword to the residual
        q = cb[i]
        out, r = out + q, r - q
        codes.append(i)
    return out, torch.stack(codes, dim=1)      # (N, D), (N, M) integer codes
학습: 세 개의 손실
딥러닝은 곱하고 더하는 미분 가능한 연산으로 학습하는데, 중간에 “가장 가까운 것으로 퉁치기”가 끼어 있다. 그래도 학습이 되는 이유를 손실 함수부터 보자. VQ-VAE 논문의 손실은 다음과 같다.
\[\mathcal{L} = \underbrace{\lVert \mathbf{x} - D(\mathbf{z}_q(\mathbf{x})) \rVert_2^2}_{\text{reconstruction}} + \underbrace{\lVert \operatorname{sg}[\mathbf{z}_e(\mathbf{x})] - \mathbf{e} \rVert_2^2}_{\text{codebook}} + \beta\, \underbrace{\lVert \mathbf{z}_e(\mathbf{x}) - \operatorname{sg}[\mathbf{e}] \rVert_2^2}_{\text{commitment}}\]여기서 \(\mathbf{e} = \mathbf{e}_{k^*}\)는 \(\mathbf{z}_e(\mathbf{x})\)에 가장 가까운 코드이고, \(D\)는 decoder, \(\beta\)는 계수이다. (논문은 첫 항을 \(\log p(\mathbf{x} \mid \mathbf{z}_q(\mathbf{x}))\)로 쓰는데, 가우시안 decoder라면 위의 제곱 오차와 같다.)
- 첫 항은 오토인코더의 재구성 손실 그대로이다. 입력과 출력이 같아지게 한다.
- 둘째, 셋째 항은 VQ가 들어가서 새로 필요해진 손실로, 목적은 하나이다. 퉁친 차이가 크면 그로 인한 왜곡이 크고, 작으면 왜곡도 작다. 그래서 encoder 출력과 퉁친 코드를 서로 달라붙게 해서 왜곡을 줄인다.
\(\operatorname{sg}\)는 stop-gradient로, forward 계산에서는 항등 함수이고 backward에서는 gradient를 0으로 만든다. 값만 보면 \(\operatorname{sg}\)를 지워도 되므로, 둘째와 셋째 항은 모두 \(\lVert \mathbf{z}_e - \mathbf{e} \rVert^2\), 즉 encoder 출력과 코드가 같아지라는 뜻이다.
그러면 왜 굳이 둘로 나눴을까? 실제로 \(\beta = 1\)이면 나누지 않은 것과 gradient가 완전히 같다. \(\mathbf{z}_e\)는 셋째 항에서만, \(\mathbf{e}\)는 둘째 항에서만 gradient를 받는데, 각각이 \(\lVert \mathbf{z}_e - \mathbf{e} \rVert^2\)를 그 변수로 미분한 것과 같기 때문이다. 그래서 .detach()를 떼고 하나의 항으로 합쳐 학습해도 손실이 같은 궤적으로 떨어진다. 실제로 VQ-VAE 학습은 SG를 쓰지 않아도 잘 된다. 논문도 결과가 \(\beta\)에 둔감해서 0.1부터 2.0까지 결과가 거의 같았다고 하고, 실험에는 \(\beta = 0.25\)를 썼다. 나누는 진짜 이유는 다음 절에서 본다.
detach로 구현하는 STE와 SG
▶ 【 VQ-VAE 】5. 학습 코드: detach 서커스
손실에는 사실 하나 빠진 것이 있다. 재구성 손실의 gradient가 퉁치기를 어떻게 건너 encoder까지 가는가 하는 문제이고, 그 답이 straight-through estimator(STE)이다. STE와 SG 모두 PyTorch의 .detach() 하나로 구현된다.
.detach()
PyTorch는 forward 계산을 하면서 내부적으로 역전파 경로(computational graph)를 몰래 걸어 두고, loss.backward() 때 그 경로를 forward의 반대 방향으로 따라가며 미분한다. 텐서에 .detach()를 하면 값은 그대로인 채 이 경로만 끊는다. 그래서 끊은 지점보다 앞쪽(입력 쪽)의 weight는 그 경로로는 업데이트되지 않고, 끊은 지점부터 출력까지만 업데이트된다.
STE: 값은 \(\mathbf{z}_q\), gradient는 \(\mathbf{z}_e\)로
Encoder 출력을 quant_in(\(\mathbf{z}_e\)), 가장 가까운 코드로 퉁친 벡터를 quant_out(\(\mathbf{z}_q\))이라 하자. Decoder에는 다음 값을 넣는다.
quant_out = quant_in + (quant_out - quant_in).detach()
- 값: detach는 값을 바꾸지 않으므로 \(\mathbf{z}_e + (\mathbf{z}_q - \mathbf{z}_e) = \mathbf{z}_q\)이다. Decoder는 퉁친 벡터를 받는다.
- gradient: 괄호 부분은 끊겼고
quant_in만 연결되어 있으므로, decoder 입력에 도착한 gradient가 그대로 \(\mathbf{z}_e\)로 넘어간다. 즉 \(\partial\mathcal{L}/\partial\mathbf{z}_e := \partial\mathcal{L}/\partial\mathbf{z}_q\)이다.
값은 quant_out으로 쓰고, 역전파는 quant_in에 바톤 터치하는 것이다. 왜 이렇게 할까? quant_out으로 이어진 역전파 경로는 썩은 동아줄이기 때문이다. quant_out은 argmin으로 번호를 고른 뒤 코드북에서 꺼낸 값인데, argmin은 미분할 수 없다(정수 출력이라 gradient가 정의되지 않는다). 그래서 detach가 없어도 어차피 그 경로로는 encoder까지 gradient가 가지 못한다. 썩은 줄을 끊고 quant_in에 새 줄을 걸면, 재구성 손실을 줄이는 방향으로 encoder가 학습될 수 있다. \(\mathbf{z}_e\)와 \(\mathbf{z}_q\)가 가까울수록 이 근사는 정확해지므로, 둘을 붙여 두는 둘째·셋째 항이 STE를 받쳐 준다.
SG: 누가 무엇을 학습하는가
손실의 \(\operatorname{sg}\)는 코드로는 그냥 .detach()이다.
- 둘째 항(codebook loss)
mse(quant_out, quant_in.detach()): encoder 출력을 고정하고 코드북을 encoder 출력 쪽으로 옮긴다. STE 때문에 재구성 손실의 gradient는 코드북에 닿지 않으므로, 코드북은 이 항으로만 학습된다. - 셋째 항(commitment loss)
mse(quant_in, quant_out.detach()): 코드를 고정하고 encoder가 출력을 코드 쪽에 붙이도록(commit) 학습시킨다.
이제 나누는 이유가 보인다. VQ-VAE의 1순위 목적은 오토인코더로서 재구성을 잘하는 것이다. 재구성 손실은 encoder와 decoder를 학습시킨다. 둘째 항은 encoder도 decoder도 아닌 코드북만 학습시키므로 재구성과 경쟁하지 않는다. 그런데 셋째 항은 encoder를 학습시키므로, encoder는 “복원에 유리한 출력”과 “코드에 붙는 출력”을 동시에 배워야 한다. 그래서 셋째 항에만 작은 계수 \(\beta\)(예: 0.25)를 붙여 재구성 쪽에 힘을 실어 주고, 둘째 항은 그대로 둔다. 논문은 또 다른 이유로, 코드북이 encoder만큼 빨리 학습되지 않으면 encoder 출력이 코드들 사이를 오가거나 크기가 계속 커질 수 있는데 commitment 손실이 이를 막는다고 설명한다.
전체 코드
import torch
import torch.nn as nn
import torch.nn.functional as F

class VectorQuantizer(nn.Module):
    def __init__(self, K=512, D=64, beta=0.25):
        super().__init__()
        self.codebook = nn.Embedding(K, D)            # e_1, ..., e_K
        self.codebook.weight.data.uniform_(-1 / K, 1 / K)
        self.beta = beta

    def forward(self, quant_in):                      # (N, D) encoder outputs z_e
        d = torch.cdist(quant_in, self.codebook.weight)   # (N, K) distances
        idx = d.argmin(dim=1)                         # integer codes (not differentiable)
        quant_out = self.codebook(idx)                # z_q = e_idx

        codebook_loss = F.mse_loss(quant_out, quant_in.detach())   # || sg[z_e] - e ||^2
        commit_loss = F.mse_loss(quant_in, quant_out.detach())     # || z_e - sg[e] ||^2
        vq_loss = codebook_loss + self.beta * commit_loss

        # straight-through estimator: value = quant_out, gradient -> quant_in
        quant_out = quant_in + (quant_out - quant_in).detach()
        return quant_out, idx, vq_loss

enc = nn.Linear(16, 2)     # toy: 16 numbers -> 2 numbers
dec = nn.Linear(2, 16)
vq = VectorQuantizer(K=10, D=2)
opt = torch.optim.Adam([*enc.parameters(), *dec.parameters(), *vq.parameters()], lr=1e-3)

x = torch.randn(32, 16)
z_q, idx, vq_loss = vq(enc(x))
x_hat = dec(z_q)
loss = F.mse_loss(x_hat, x) + vq_loss
opt.zero_grad(); loss.backward(); opt.step()
idx가 위에서 말한 정수 토큰이다. 이미지라면 encoder를 CNN으로 바꾸고 각 위치의 \(D\)차원 벡터에 같은 양자화를 적용하면 \(H' \times W'\) 정수 격자가 나온다. (코드북을 손실 대신 encoder 출력의 지수 이동 평균으로 업데이트하는 변형도 논문 부록에 있다.)
VQ-VAE의 “VAE”
VQ-VAE를 VAE의 틀로 보면, 사후 분포 \(q(z = k \mid \mathbf{x})\)는 \(k = k^*\)에서 1인 원-핫 분포이고 prior는 \(K\)개 코드 위의 균등 분포이다. 그러면 ELBO의 KL 항은 \(\log K\)라는 상수가 되어 학습에 영향을 주지 않는다. 그래서 VQ 부분을 이해할 때 “V”를 잊어도 되었던 것이다. 생성 능력은 KL 항이 아니라, 학습이 끝난 뒤 정수 토큰 위에 따로 학습하는 autoregressive prior에서 나온다.
정리
| 질문 | 답 |
|---|---|
| VQ란? | encoder 출력을 코드북 \(K\)개 중 가장 가까운 벡터로 퉁치는 것 |
| 왜 쓰나? | 인코딩이 유한해져 정수 번호를 붙일 수 있고, 이미지가 정수 문장이 되어 언어 모델로 생성 가능 |
| 연속 인코딩 회귀의 문제 | 비선형으로 비틀린 인코딩 공간에서 MSE/L1 오차가 비선형 왜곡을 만듦 |
| Residual VQ | 잔차를 다른 코드북으로 다시 퉁치는 것을 \(M\)번 반복, 오차는 줄고 토큰 수는 \(M\)배 |
| 손실 | 재구성 + codebook(\(\operatorname{sg}\) on \(\mathbf{z}_e\)) + \(\beta \cdot\)commitment(\(\operatorname{sg}\) on \(\mathbf{e}\)) |
| STE | z_e + (z_q - z_e).detach(): 값은 \(\mathbf{z}_q\), gradient는 \(\mathbf{z}_e\)로 |
| SG로 나누는 이유 | commitment만 encoder를 학습시키므로 작은 \(\beta\)로 재구성에 힘을 실음, \(\beta = 1\)이면 나누지 않은 것과 gradient 동일 |